引言
2026年2月,AI领域迎来了一场真正的范式革命!北京智源人工智能研究院在《自然》正刊上发表了Emu3系列研究成果,标志着多模态AI正式从"分领域专精"迈入"跨模态通用"的新时代。这项突破性的技术不仅实现了文本、图像、视频的统一建模,更为我们打开了通往通用人工智能的全新路径。
什么是多模态AI?
简单来说,多模态AI就是能够让机器同时理解和处理文字、图像、音频、视频等多种类型数据的技术。想象一下,一个AI助手不仅能听懂你的话,还能看懂你上传的图片,分析其中的内容,甚至为图片配上合适的音乐和解说——这就是多模态AI的魅力所在。
为什么Emu3如此重要?
传统的多模态AI像是"分科考试",文字、图片、视频各用各的模型,组合起来复杂臃肿。而Emu3采用"统一token化+单一预测目标"的极简架构,将所有模态数据转化为统一的token序列,仅通过"预测下一个token"这一个目标,就实现了跨模态的深度理解和生成能力。这不仅在技术上实现了突破,更在哲学层面上验证了"大道至简"的智能本质。
扣子平台的多模态革命
作为国内领先的AI应用开发平台,扣子2.0早已深度集成了多模态AI能力。今天,我将带你从零开始,在扣子平台上创建一个能够融合处理文字、图像、音频的多模态SKILL,让你亲身感受这场技术变革的力量!
准备工作
在开始创建多模态SKILL之前,我们需要了解扣子平台的多模态功能基础:
1. 理解扣子的多模态架构
扣子平台的多模态能力建立在三大核心支柱上:
- 统一理解引擎:底层采用类似Emu3的统一架构,能够将不同模态的数据转化为统一的语义表示
- 插件生态系统:拥有超过1万个插件,涵盖图像处理、语音识别、文字分析等多个领域
- 可视化工作流:通过拖拽式界面,轻松构建复杂的多模态处理流程
2. 了解多模态SKILL的应用场景
多模态SKILL可以应用于各种实际场景:
- 内容创作:自动为文章配图、为图片配文、为视频配音
- 智能客服:同时处理用户文字提问、上传的图片和语音消息
- 数据分析:从图表、文字报告、音频录音中提取综合信息
- 教育培训:创建交互式的多模态学习材料
3. 创建个人工作空间
登录扣子官网(https://www.coze.cn/),进入个人工作空间。所有创建的多模态SKILL都会存储在这个项目中。
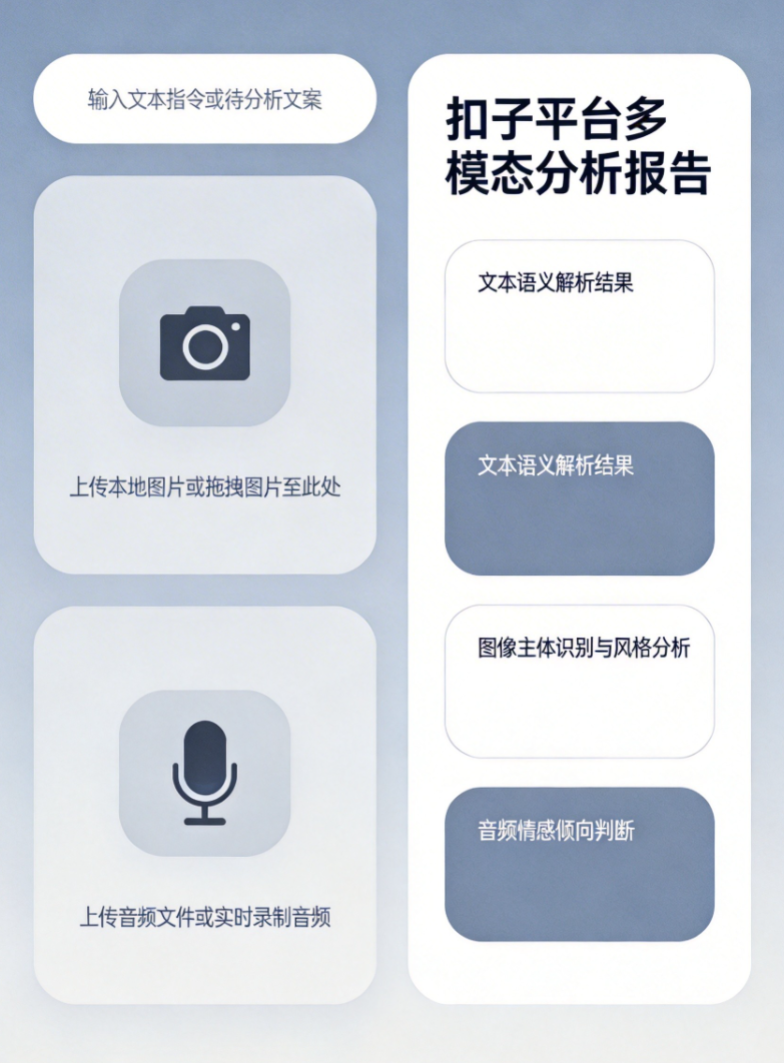
图为扣子平台多模态处理界面示意图
步骤详解:创建你的第一个多模态SKILL
我们将创建一个"智能内容分析SKILL",它能同时处理用户上传的文字、图片和音频,进行综合分析和生成报告。
步骤1:进入SKILL创建页面
在扣子工作台左侧菜单栏,点击「技能」→「创建技能」。今天我们选择"手动创建",因为多模态SKILL需要更精细的控制。
步骤2:设置SKILL基本信息
填写SKILL的基础信息:
- 技能名称:智能多模态内容分析助手
- 技能描述:统一处理文字、图像、音频数据,进行综合分析、内容提取和报告生成
- 适用场景:内容创作辅助、数据分析、教育培训、智能客服
步骤3:设计多模态输入接口
多模态SKILL的关键在于能够同时接收多种类型的数据输入。我们需要设置三种输入通道:
在扣子的技能编辑器中,可以通过"添加输入参数"功能来设置这些通道。
步骤4:配置多模态处理核心逻辑
这是多模态SKILL的核心部分,我们将设计四个处理模块:
模块1:跨模态统一理解
这一模块模仿Emu3的"预测下一个token"思想,对所有输入数据进行统一理解:
python
def multimodal_understanding(text_input, image_input, audio_input):
"""
多模态统一理解模块
将文字、图像、音频数据转化为统一的语义表示
"""
# 文字特征提取
text_features = extract_text_features(text_input)
# 图像特征提取(基于视觉理解API)
image_features = extract_image_features(image_input)
# 音频特征提取(基于语音识别API)
audio_features = extract_audio_features(audio_input)
# 多模态特征融合
unified_representation = fuse_multimodal_features(
text_features, image_features, audio_features
)
return unified_representation
模块2:内容关联分析
基于统一的理解结果,分析不同模态数据之间的关联:
python
def cross_modal_analysis(unified_representation):
"""
跨模态关联分析
发现文字、图像、音频之间的语义联系
"""
# 图像-文字关联度计算
image_text_correlation = calculate_correlation(
unified_representation['image'],
unified_representation['text']
)
# 音频-文字情感一致性分析
audio_text_sentiment = analyze_sentiment_consistency(
unified_representation['audio'],
unified_representation['text']
)
# 多模态主题一致性评估
theme_consistency = assess_theme_consistency(
unified_representation['text'],
unified_representation['image'],
unified_representation['audio']
)
return {
'correlations': image_text_correlation,
'sentiment_consistency': audio_text_sentiment,
'theme_consistency': theme_consistency
}
模块3:综合分析报告生成
基于分析结果,生成综合报告:
python
def generate_comprehensive_report(analysis_results):
"""
生成多模态综合分析报告
"""
report_template = """
# 多模态内容分析报告
## 1. 整体评估
– **主题一致性**:{theme_score}/10
– **内容相关性**:{correlation_score}/10
– **情感匹配度**:{sentiment_score}/10
## 2. 详细分析
### 文字内容
{text_summary}
### 图像内容
{image_summary}
### 音频内容
{audio_summary}
## 3. 改进建议
{improvement_suggestions}
## 4. 衍生创作建议
{creative_suggestions}
"""
# 填充报告模板
filled_report = report_template.format(
theme_score=analysis_results['theme_consistency']['score'],
correlation_score=analysis_results['correlations']['score'],
sentiment_score=analysis_results['sentiment_consistency']['score'],
text_summary=generate_text_summary(analysis_results),
image_summary=generate_image_summary(analysis_results),
audio_summary=generate_audio_summary(analysis_results),
improvement_suggestions=generate_suggestions(analysis_results),
creative_suggestions=generate_creative_ideas(analysis_results)
)
return filled_report
模块4:多格式输出适配
根据不同场景,生成不同格式的输出:
python
def adapt_output_format(report_content, output_format="markdown"):
"""
多格式输出适配
支持Markdown、JSON、HTML、可视化图表等多种格式
"""
if output_format == "markdown":
return format_as_markdown(report_content)
elif output_format == "json":
return format_as_json(report_content)
elif output_format == "html":
return format_as_html(report_content)
elif output_format == "visualization":
return generate_visualization(report_content)
else:
return format_as_markdown(report_content)
步骤5:关联知识库(增强上下文理解)
为了让SKILL具备更强的专业理解能力,我们可以关联相关的知识库:
创建多模态知识库:
- 上传行业术语解释文档
- 添加图像分析专业知识
- 整理音频处理技术资料
配置知识库调用策略:
- 根据用户问题的专业程度,自动调用相应深度的知识
- 实时更新知识库内容,保持信息的时效性
步骤6:添加插件支持(扩展功能边界)
扣子平台的插件生态系统为多模态SKILL提供了强大的扩展能力:
图像处理插件:
- 图像识别与分析
- 风格迁移与编辑
- 文字提取(OCR)
音频处理插件:
- 语音转文字(支持多语言)
- 情感分析
- 音频增强与剪辑
文字处理插件:
- 文本摘要与提取
- 关键词分析
- 情感与主题识别
步骤7:进行全面测试
点击技能页面的「测试」按钮,进入对话界面:
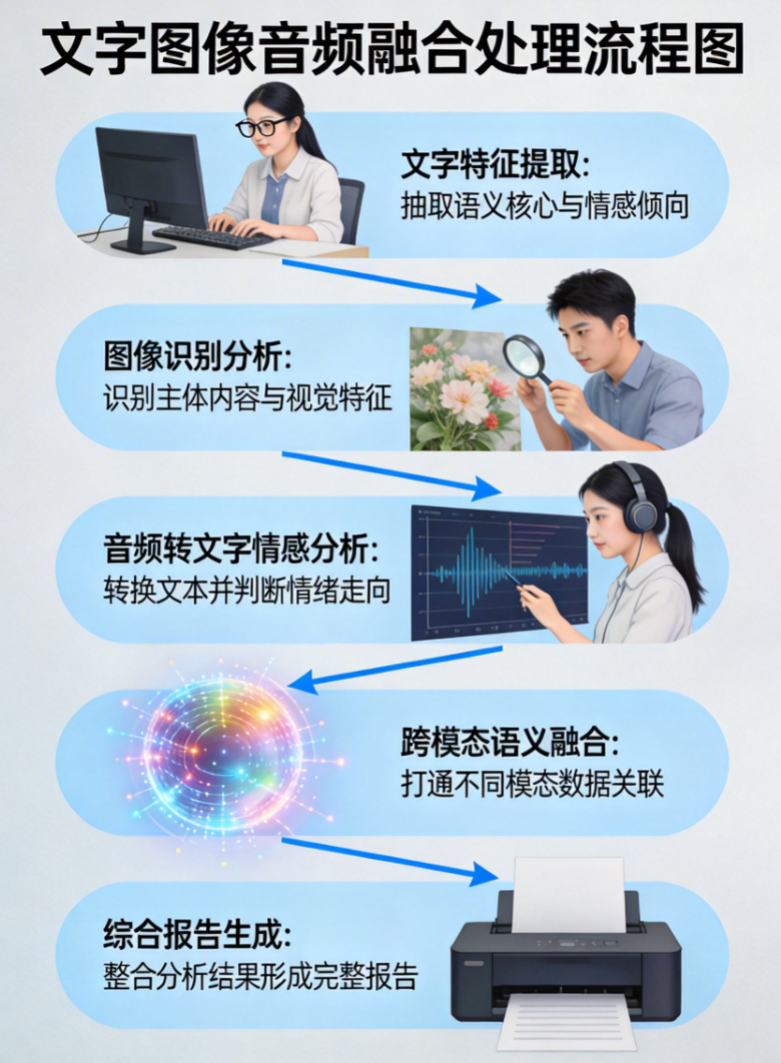
图为多模态数据处理流程图示意图
测试用例1:教育内容分析
plaintext
输入文字:"请分析这张物理示意图和讲解音频"
输入图像:上传一张电路图
输入音频:上传一段物理老师讲解电路原理的录音
预期输出:
– 综合报告:电路图与讲解内容的一致性分析
– 关键知识点提取:欧姆定律、串联电路特性等
– 学习建议:针对理解难点提供补充资源
测试用例2:商业演示材料分析
plaintext
输入文字:"请评估这份产品介绍材料的表现力"
输入图像:上传产品宣传海报
输入音频:上传产品发布会片段录音
预期输出:
– 视觉吸引力评分:色彩搭配、构图布局等
– 内容传达效果:核心卖点突出程度
– 整体协调性:图像、文字、音频的一致性与互补性
步骤8:优化与调整
根据测试结果,可能需要进行以下优化:
步骤9:部署上线
测试通过后,点击「部署」→「开始部署」,将SKILL发布到云端。
步骤10:集成应用
部署成功后,可以在扣子对话框中输入「@」,选择"智能多模态内容分析助手",按提示输入文字描述、上传图片和音频文件即可使用。
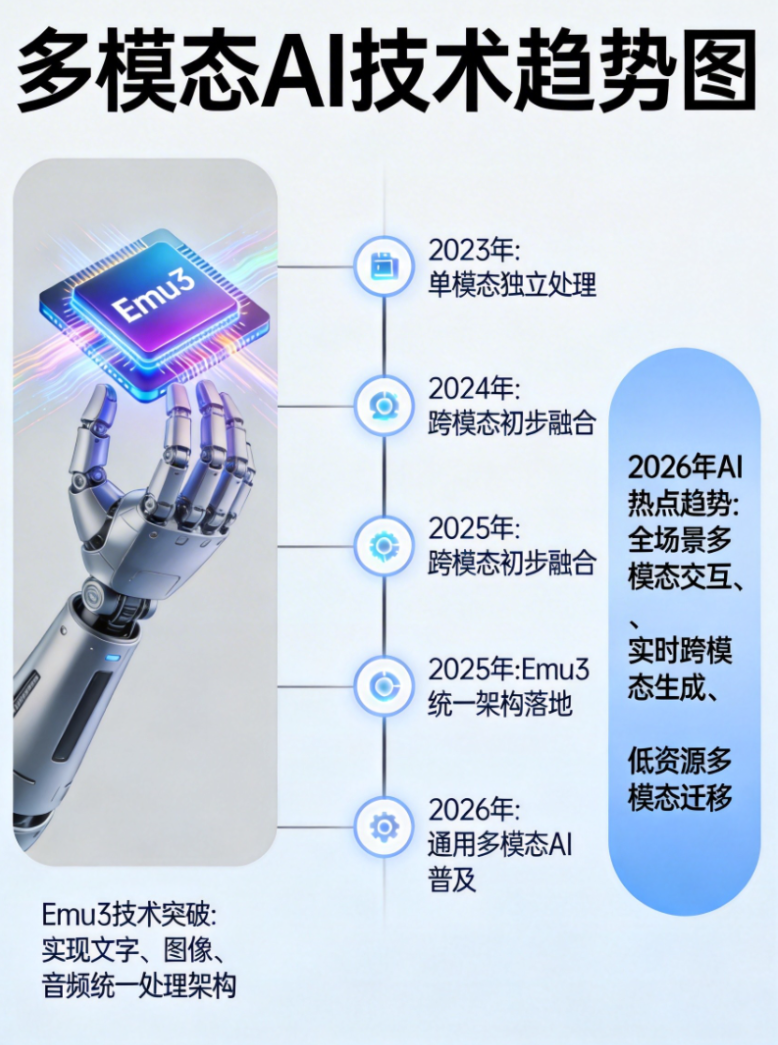
图为多模态AI技术发展趋势图
代码示例:完整的多模态SKILL结构
下面是一个完整的多模态SKILL代码结构,展示了各个模块的协同工作:
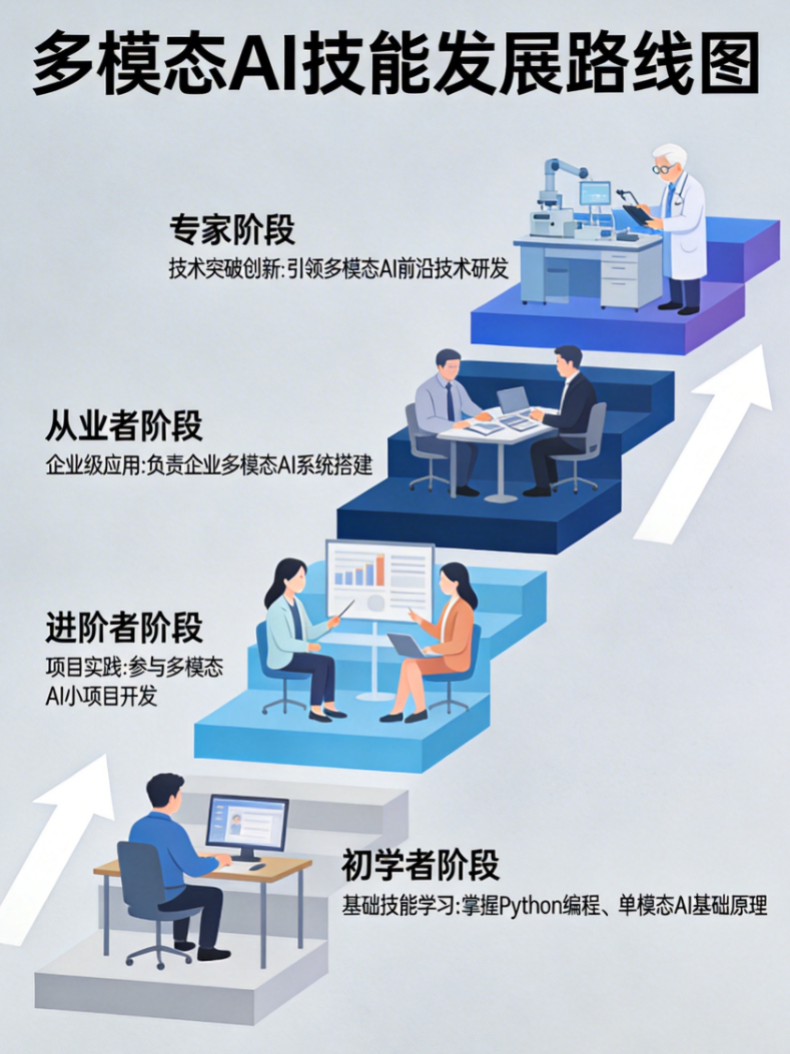
图为多模态AI技能发展成长路线图
skill_main.py(主处理模块)
python
class MultimodalContentAnalyzer:
"""
多模态内容分析器主类
统一处理文字、图像、音频输入,生成综合分析报告
"""
def __init__(self):
self.text_processor = TextProcessor()
self.image_analyzer = ImageAnalyzer()
self.audio_processor = AudioProcessor()
self.report_generator = ReportGenerator()
def process(self, text_input, image_files, audio_files, output_format="markdown"):
"""
主处理流程
"""
# 1. 多模态数据理解
text_features = self.text_processor.extract_features(text_input)
image_features = self.image_analyzer.analyze_images(image_files)
audio_features = self.audio_processor.process_audio(audio_files)
# 2. 特征统一表示
unified_features = self._fuse_features(
text_features, image_features, audio_features
)
# 3. 跨模态分析
analysis_results = self._perform_cross_modal_analysis(unified_features)
# 4. 报告生成
report_content = self.report_generator.generate(analysis_results)
# 5. 格式适配
formatted_output = self.report_generator.format(
report_content, output_format
)
return formatted_output
def _fuse_features(self, text_features, image_features, audio_features):
"""
多模态特征融合
"""
# 实现特征对齐和融合算法
pass
def _perform_cross_modal_analysis(self, unified_features):
"""
执行跨模态分析
"""
# 实现语义关联分析、一致性评估等
pass
modules/text_processor.py(文字处理模块)
python
class TextProcessor:
"""
文字内容处理模块
负责文字特征提取、关键词分析、情感识别等
"""
def extract_features(self, text):
"""
提取文字特征
"""
features = {
'keywords': self.extract_keywords(text),
'entities': self.recognize_entities(text),
'sentiment': self.analyze_sentiment(text),
'topics': self.identify_topics(text),
'summary': self.generate_summary(text)
}
return features
def extract_keywords(self, text):
"""提取关键词"""
# 实现关键词提取算法
pass
def recognize_entities(self, text):
"""实体识别"""
# 实现命名实体识别
pass
def analyze_sentiment(self, text):
"""情感分析"""
# 实现情感分析算法
pass
modules/image_analyzer.py(图像分析模块)
python
class ImageAnalyzer:
"""
图像内容分析模块
负责图像识别、特征提取、内容描述等
"""
def analyze_images(self, image_files):
"""
分析图像文件
"""
results = []
for image_file in image_files:
analysis = {
'objects': self.detect_objects(image_file),
'texts': self.extract_text(image_file),
'colors': self.analyze_colors(image_file),
'composition': self.analyze_composition(image_file),
'description': self.generate_description(image_file)
}
results.append(analysis)
return results
def detect_objects(self, image):
"""检测物体"""
# 实现物体检测算法
pass
def extract_text(self, image):
"""提取文字(OCR)"""
# 实现OCR文字提取
pass
def generate_description(self, image):
"""生成图像描述"""
# 实现图像描述生成
pass
modules/audio_processor.py(音频处理模块)
python
class AudioProcessor:
"""
音频内容处理模块
负责语音识别、情感分析、内容提取等
"""
def process_audio(self, audio_files):
"""
处理音频文件
"""
results = []
for audio_file in audio_files:
analysis = {
'transcription': self.transcribe_speech(audio_file),
'sentiment': self.analyze_audio_sentiment(audio_file),
'key_phrases': self.extract_key_phrases(audio_file),
'duration': self.get_duration(audio_file),
'quality': self.assess_quality(audio_file)
}
results.append(analysis)
return results
def transcribe_speech(self, audio):
"""语音转文字"""
# 实现语音识别算法
pass
def analyze_audio_sentiment(self, audio):
"""音频情感分析"""
# 实现基于音频的情感分析
pass
def extract_key_phrases(self, audio):
"""提取关键短语"""
# 实现音频关键内容提取
pass
modules/report_generator.py(报告生成模块)
python
class ReportGenerator:
"""
综合分析报告生成模块
负责整合分析结果,生成结构化的报告
"""
def generate(self, analysis_results):
"""
生成综合分析报告
"""
report = {
'executive_summary': self._generate_executive_summary(analysis_results),
'detailed_analysis': self._generate_detailed_analysis(analysis_results),
'recommendations': self._generate_recommendations(analysis_results),
'appendix': self._generate_appendix(analysis_results)
}
return report
def format(self, report_content, output_format):
"""
格式化输出
"""
if output_format == "markdown":
return self._format_as_markdown(report_content)
elif output_format == "html":
return self._format_as_html(report_content)
elif output_format == "json":
return json.dumps(report_content, ensure_ascii=False, indent=2)
else:
return self._format_as_markdown(report_content)
def _generate_executive_summary(self, analysis_results):
"""生成执行摘要"""
# 实现摘要生成逻辑
pass
def _generate_detailed_analysis(self, analysis_results):
"""生成详细分析"""
# 实现详细分析生成
pass
常见问题解答
Q1:创建多模态SKILL需要什么技术基础?
A:扣子平台的多模态SKILL创建采用了低代码/零代码模式,你不需要深厚的编程基础。但是,了解以下概念会更有帮助:
- 基本的Python语法(理解代码示例)
- 多模态AI的基本概念(如特征提取、语义理解)
- 扣子平台的基本操作(技能创建、测试、部署)
如果你完全没有技术背景,也可以直接使用扣子提供的可视化界面进行配置,系统会自动生成底层代码。
Q2:多模态SKILL能处理哪些具体业务场景?
A:多模态SKILL的应用场景非常广泛:
教育领域:
- 智能课件分析:同时分析PPT内容、讲解音频、学生反馈
- 互动学习材料:生成图文音结合的学习资料
企业应用:
- 商业智能分析:从市场报告、产品图片、会议录音中提取关键信息
- 品牌内容审核:评估宣传材料的视觉、文字、音频一致性
个人创作:
- 社交媒体内容优化:分析图片质量、文字表达、背景音乐搭配
- 短视频脚本生成:基于主题自动生成多模态创作方案
Q3:如何保证多模态分析的准确性?
A:提高多模态分析准确性的方法包括:
数据质量保证:
- 使用清晰、高质量的输入数据
- 避免模糊、噪音严重的图像和音频
算法优化:
- 定期更新知识库和算法模型
- 根据具体场景调整分析参数
人工校验:
- 对于重要决策,建议进行人工审核
- 建立反馈机制,持续优化算法表现
多模型融合:
- 结合多个专业模型的结果进行综合判断
- 设置置信度阈值,对低置信度结果进行标注
Q4:多模态SKILL的处理速度如何?
A:处理速度取决于多个因素:
- 数据规模:图像分辨率、音频时长、文字长度
- 处理复杂度:分析的深度和广度
- 服务器负载:平台当前的资源使用情况
一般来说:
- 单张图像分析:2-5秒
- 1分钟音频处理:3-8秒
- 500字文字分析:1-3秒
- 综合报告生成:5-15秒
对于实时性要求较高的场景,建议:
Q5:多模态SKILL的成本如何?
A:扣子平台的多模态SKILL使用遵循以下成本结构:
基础费用:
- SKILL创建、测试:免费
- 基础处理额度:每月免费提供一定量的处理配额
资源费用(根据实际使用量计费):
- 图像分析:按处理数量计费
- 音频处理:按时长计费
- 复杂计算:按计算资源使用量计费
成本优化建议:
Q6:如何将多模态SKILL集成到现有系统中?
A:扣子平台提供了多种集成方式:
API接口调用:
- 通过RESTful API直接调用SKILL功能
- 支持JSON格式的数据传输和结果返回
Webhook集成:
- 配置Webhook实现自动化触发
- 支持与其他系统的实时数据同步
SDK集成:
- 提供Python、Java、JavaScript等语言的SDK
- 支持在现有代码中直接调用SKILL功能
平台原生集成:
- 与微信、飞书、钉钉等平台无缝对接
- 支持通过机器人服务直接调用
总结与进阶建议
恭喜你!通过本教程,你已经掌握了在扣子平台上创建多模态SKILL的核心技能。现在你已经能够:
下一步学习建议:
深入研究Emu3架构
- 学习统一token化的原理和实现
- 理解自回归预测在多模态领域的应用
- 探索从"下一个token预测"到"下一个状态预测"的演进
拓展多模态应用场景
- 医疗影像分析:结合CT图像、诊断报告、患者口述
- 智能家居系统:统一处理语音指令、环境图像、传感器数据
- 数字营销优化:分析广告素材、用户反馈、市场数据
优化多模态SKILL性能
- 模型融合策略:结合不同模型的优势,提高分析准确性
- 分布式处理架构:设计可扩展的多模态数据处理流程
- 实时性优化:针对不同场景的需求,平衡准确性和响应速度
探索多模态AI的前沿方向
- 具身智能:结合视觉、语言、动作的多模态智能体
- 跨模态生成:文字生成图像、图像生成音乐、音频生成视频
- 多模态推理:基于多种证据的综合判断和决策
实战项目建议:
教育内容智能分析系统
- 功能:同时分析教材文字、示意图、讲解音频
- 输出:知识点总结、学习难点识别、个性化学习建议
商业演示智能评估工具
- 功能:分析PPT内容、设计风格、演讲效果
- 输出:内容优化建议、视觉设计评分、演讲技巧反馈
社交媒体内容优化助手
- 功能:统一分析帖子文字、配图质量、背景音乐
- 输出:内容吸引力评估、多平台适配建议、爆款潜力预测
职业发展路径:
初级阶段(0-6个月) :
- 掌握扣子平台多模态SKILL的基本创建方法
- 完成3-5个不同类型的多模态应用项目
- 理解Emu3等前沿技术的基本原理
中级阶段(6-18个月) :
- 设计复杂的企业级多模态解决方案
- 优化多模态算法的性能和准确性
- 建立多模态AI应用的最佳实践框架
高级阶段(18个月以上) :
- 领导大型多模态AI项目的研发和实施
- 推动多模态AI技术的创新和突破
- 建立行业级的多模态AI标准和生态
最后的话
Emu3技术的突破向我们展示了多模态AI的无限可能,而扣子平台则为我们提供了实现这些可能性的强大工具。从今天开始,尝试将多模态思维应用到你的实际工作中:
多模态AI的时代已经来临,它不仅仅是技术的进步,更是一种思维方式的变革。学会从统一的视角看待和处理不同模态的数据,你将在AI时代获得独特的竞争优势。
记住:最大的限制不是技术的能力,而是我们的想象力。当文字、图像、音频在AI的统一下不再割裂,我们能创造的将远超想象。
如果你在创建多模态SKILL的过程中有任何问题,或者有创新的多模态应用想法,欢迎在评论区分享讨论。让我们一起,在多模态AI的浪潮中,成为真正的创造者和引领者!
作者:[阿Lee_]
更新日期:2026年2月13日
版权声明:本文为原创内容,转载请注明出处




