下面用“结巴说话 vs 正常说话”的比喻,带你一次性搞懂离散有记忆信源的信息测度——熵率和冗余度。
1. 场景设定 —— 两个说话风格不同的人
-
正常人(无记忆信源):每次随机从字典里挑一个词,前后毫无关联。
你永远猜不到他下一句说什么,每句话都是“惊喜”。 -
结巴/有习惯的人(有记忆信源):说话有规律,前后依赖。
比如他一开口“我…”,下一词很可能就是“觉得”、“想”、“是”之类。
他昨天说了“天气不错”,今天可能还会聊天气。
有记忆信源 = 符号序列内部存在统计依赖,不是独立同分布。
2. 核心问题 —— 平均每个符号到底带来多少“新信息”?
对无记忆信源,每个符号的“惊讶度”一样,熵 H(X) 就是答案。
对有记忆信源,前后重复、关联,后面的符号会泄露前面符号的信息,所以每个新符号的平均新信息量 < 单符号熵。
我们需要一个新的测度:熵率(Entropy Rate)。
3. 熵率 —— 平均每步新增多少惊讶
通俗定义:
当你已经知道前面所有历史,再看到下一个符号时,平均新增加的惊讶度。
-
如果序列完全独立(无记忆),熵率 = 单符号熵。
-
如果序列完全确定(如 1,1,1,1,…),熵率 = 0(一点都不惊讶)。
-
如果序列有规律但不确定(如天气预报),熵率介于两者之间。
例子:
-
自然语言文本:字母之间高度相关,熵率 ≈ 1–1.5 比特/字母,远小于 26 个字母等概时的熵(≈ 4.7 比特/字母)。
4. 冗余度 —— 可压缩的比例
冗余度 = 1 – (熵率 / 最大可能熵)
它衡量由于记忆(依赖)而产生的可压缩空间。
-
无记忆独立等概信源:冗余度 = 0%(完全不可压缩)。
-
英文文本:冗余度 ≈ 50%~70%(因为字母分布不均 + 前后依赖)。
白话:
如果一段话 70% 都是废话或规律,那就可以压缩掉 70% 的大小。
5. 有记忆信源的“信息测度全家桶”
| 单符号熵 H(X) | 每个符号的平均信息量 | 仍可算,但高估了真实信息率 | |
| 联合熵 H(X₁…Xₙ) | n·H(X) | < n·H(X)(依赖越强,越小) | |
| 熵率 h∞ | = H(X) | = lim_{n→∞} H(Xₙ | X₁…Xₙ₋₁) |
| 冗余度 γ | = 0(独立等概时) | = 1 – h∞ / H₀(H₀ 为最大熵) |
6. 一个具体模型:k 阶马尔可夫信源
比喻:天气预报有“状态”——今天晴/雨,影响明天的概率。
-
当前符号只依赖最近 k 个历史符号,与更早无关。
-
熵率 = 条件熵 H(Xₙ | Xₙ₋₁, …, Xₙ₋ₖ)。
例子:一阶马尔可夫(依赖前一个符号)
已知今天下雨,明天下雨概率 0.7,晴天 0.3;已知今天晴天,明天晴天 0.8,下雨 0.2。
熵率 = 从每个状态出发的条件熵的平均值。
7. ASCII 总结框图
┌─────────────────────────────────────────────────────────────┐
│ 离散有记忆信源的信息测度 │
├─────────────────────────────────────────────────────────────┤
│ │
│ 🗣️ 生活比喻: │
│ 无记忆 → 每次独立掷骰子,无规律 │
│ 有记忆 → 说话有口癖、天气有持续性 │
│ │
├─────────────────────────────────────────────────────────────┤
│ │
│ 📏 核心测度:熵率 (Entropy Rate) │
│ │
│ ┌─────────────────────────────────┐ │
│ │ h = lim H( Xₙ | X₁,…,Xₙ₋₁ ) │ │
│ │ n→∞ │ │
│ └─────────────────────────────────┘ │
│ │
│ = 平均每新增一个符号,真正新带来的信息量(比特) │
│ │
├─────────────────────────────────────────────────────────────┤
│ │
│ 🗜️ 衍生测度:冗余度 (Redundancy) │
│ │
│ γ = 1 – h / h₀ │
│ (h₀ = 等概独立时的最大熵,如 log|𝒳|) │
│ │
│ → 冗余度越大,可压缩空间越大 │
│ │
├─────────────────────────────────────────────────────────────┤
│ │
│ 🧩 典型模型:k阶马尔可夫信源 │
│ │
│ 下一符号只取决于最近 k 个历史 │
│ 熵率 = 条件熵 H( Xₙ | Xₙ₋₁,…,Xₙ₋ₖ ) │
│ │
├─────────────────────────────────────────────────────────────┤
│ │
│ 🎯 为什么重要? │
│ • 更真实刻画语言、视频、生物信号等 │
│ • 数据压缩的理论极限 = 熵率 │
│ • 预测、模式识别的基础 │
│ │
└─────────────────────────────────────────────────────────────┘
📊 Mermaid 总结框图
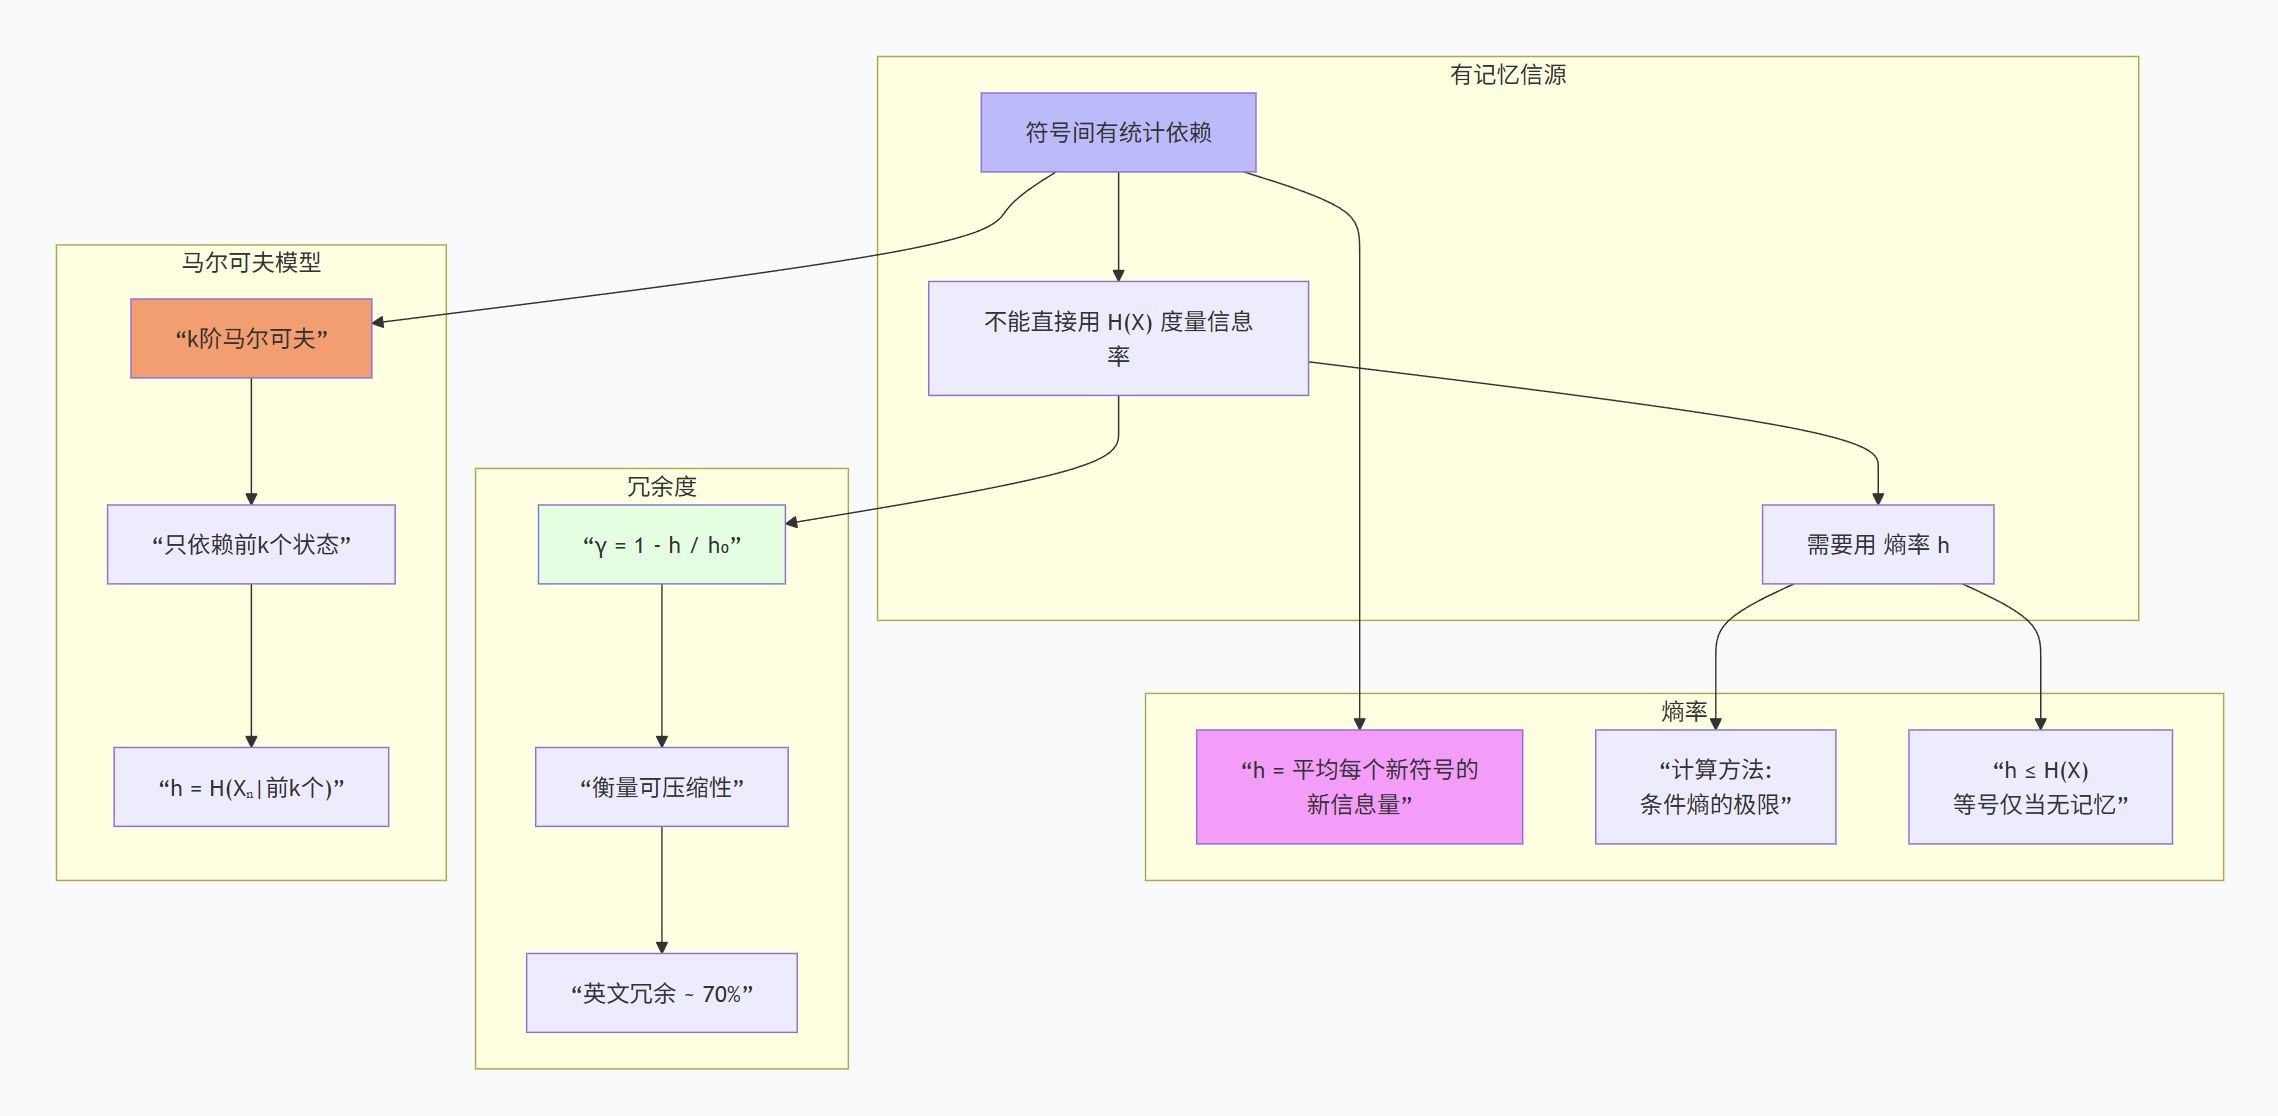
🧠 一句终极总结
离散有记忆信源的信息测度,核心是熵率——它回答“知道了全部历史,下一符号平均还能带来多少惊喜”;冗余度则告诉你“这信源有多啰嗦,能压缩掉多少水分”。
有记忆信源的信息测度 = 熵率(平均每步真新信息) + 冗余度(可压缩水分),马尔可夫模型是常用计算工具,压缩和预测是两大应用。