/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
📝 摘要:后台上传一个 20MB 视频要 11 分钟,nginx 日志显示 655 秒全耗在「收 body」。顺着「先把服务端从等式里拿掉」的思路,用 /_uploadtest 黑洞接口测纯上行、networkQuality 测本地基准、mtr 看逐跳延迟丢包,最后定位真凶:本地上行有 33Mbps,但跨境国际出口 227ms 延迟 + 26% 丢包,把单条 TCP 上传打到了 1~2Mbps。解法不在 nginx 而在客户端——分片并发上传,实测从 2Mbps 拉到 9.4Mbps。
上传慢,第一反应总是「nginx 缓冲是不是没调好」「后端是不是处理慢」。这篇我从一条 11 分钟的上传日志查下去,把 nginx、CDN、网关、后端一个个洗清,最后真凶是它们之间那条看不见的网络。如果你也遇到「上传/下载慢、各方都说不是自己的锅」,这套排查路径可以照抄。
一、问题现象
后台有同事反馈:上传一个视频,转圈转了好几分钟,慢到怀疑人生。
翻 nginx access log,捞到这条(已脱敏):
{
"request_uri": "/common/upload/video",
"request_length": "21296132",
"status": "200",
"request_time": "697.337",
"upstream_response_time": "42.260",
"http_host": "upload.example.com",
"request_method": "POST"
}
一个 20MB(request_length ≈ 21296132 字节)的上传,request_time 是 697 秒——11 分多钟。而后端处理(upstream_response_time)只占 42 秒(那 42 秒还是 ffmpeg 在压视频,属于正常)。
掐指一算:
697s 总耗时 − 42s 后端处理 ≈ 655s 几乎全花在「nginx 接收这个 20MB 上传体」上
655 秒收 20MB,折算吞吐只有 ~31 KB/s。这速度,拨号上网都嫌它慢。
这里先拆掉一个常见误解:不是「文件传了 11 分钟才到达 nginx」,而是 nginx 从头到尾花了 11 分钟,在慢慢把这个 body 一点点读进来。 为什么是「慢慢读进来」,得先搞清楚 nginx 处理上传的姿势。
二、排查现场:先把「是哪一段慢」分清楚
2.1 知识点一:nginx 默认是「收完整个 body 才转后端」
很多人以为上传是流式的——客户端传一点、nginx 转一点给后端、后端边收边处理。默认情况下并不是。
nginx 有个指令 proxy_request_buffering,默认值是 on,含义是:
nginx 先把整个请求体缓冲下来(内存放不下就落磁盘临时文件),全部收完之后,才向后端发起请求、转发数据。
对照这次的配置,能直接排除一批嫌疑:
| client_max_body_size | 100m | 20MB 没超限,不是被限制 |
| client_body_buffer_size | 30M | body < 30M,全在内存,没落盘 → 排除磁盘 IO |
| proxy_request_buffering | 默认 on | 证实「收完才转后端」,655s 全耗在收 body |
| proxy_read_timeout | 90s | 本次压缩 42s 没事,但压缩一旦超 90s 就会 504,是隐患 |
方向锁定:问题在「客户端 → nginx 这一段,body 送得慢」,跟磁盘、超时、体积限制都无关。
顺带一提:如果你确实想要「边传边到后端」(后端要做流式处理、或不想让大文件全缓存在 nginx),可以对该 location 关掉缓冲——proxy_request_buffering off;。但这次的瓶颈不在这,关了也没用。
2.2 知识点二:用「黑洞接口」测纯上行带宽
要证明是「客户端 → nginx」这段慢,得把后端彻底从等式里拿掉(这次后端还会跑 ffmpeg,更得排除)。办法是给 nginx 加一个黑洞 location:收完 body 直接返回 204,不转后端、不落盘:
# 上传带宽测速:收完整个请求体后直接返回 204,不转后端、不落盘。测完即删。
location = /_uploadtest {
client_max_body_size 500m;
return 204;
}
然后用 curl 上传测试文件,读 speed_upload 字段:
# 造一个 50MB 测试文件
dd if=/dev/zero of=/tmp/upload-test.bin bs=1m count=50
# 上传并读上行速率(先直连源站 IP、手动带 Host 头,绕过 CDN 单独量这一段)
curl -s -o /dev/null -X POST –data-binary @/tmp/upload-test.bin \\
-H "Host: upload.example.com" \\
-w "状态:%{http_code} 上行:%{speed_upload} B/s 耗时:%{time_total}s\\n" \\
http://203.0.113.10:90/_uploadtest
# 执行结果:
# 状态:204 上行:265385 B/s 耗时:30.753220s
curl 的 -w 是接口调试和性能排查的瑞士军刀,speed_upload、time_* 这些变量能把一次请求拆得明明白白。不熟的可以看这篇:curl 实战:程序员必备的接口调试与性能排查利器。
测出来,纯上行稳定在 ~250 KB/s ≈ 2 Mbps。果然慢,但慢在哪还没定位。
⚠️ 踩坑:return 204 会提前截断上传
第一次测我看到一个怪现象:状态:204 上行:265385 B/s 耗时:30.7s。但 265385 × 30.7 ≈ 8MB,根本不是 50MB——只传了 8MB 就返回了。
原因:return 204 在 nginx 的 rewrite 阶段就把响应发了、连接提前关闭,没等客户端传完。这对「测速率」没影响(速率是准的),但「测完整上传总耗时」就不准了。 想要完整读完 body 再返回,return 204 不行(后面在网关层我换了招)。
2.3 知识点三:链路里藏着 CDN 和网关
测的过程中发现,走 https:// 域名那条和直连源站那条行为不一样。查响应头:
curl -sD – -o /dev/null -X POST –data-binary "x" https://upload.example.com/_uploadtest
HTTP/2 302
location: https://upload.example.com/login
server: php
x-cache: Miss from cloudfront
via: 1.1 xxxxx.cloudfront.net (CloudFront)
几个信息一下子全抖出来了:
- via / x-cache → 这条走了 CloudFront(CDN),回源到了某台机器。
- server: php + location: /login → 返回 302 的是后端应用(没登录态、跳登录页),不是我加的 /_uploadtest。
- 说明经 CDN 这条根本没命中我在源站加的 location——CDN 的回源目标,和我直连的那台机器不是同一套。
完整链路其实长这样:
客户端 → CloudFront(CDN,终止 TLS) → APISIX 网关 → 后端
CDN「帮倒忙」、把链路搅复杂的故事,我在另一篇里也踩过一次:后端 2ms,页面 7 秒:一次 CDN"帮倒忙"的排查实录。
我的黑洞 location 加在源站 nginx 上,而 CDN 这条走的是网关,自然命中不到。于是要在网关层也放一个黑洞。
在 APISIX 网关上放黑洞路由
APISIX 加一条 route 匹配 /_uploadtest,用 serverless-pre-function 插件——它能先读完整个 body,再返回 204,正好补上 return 204 截断的坑:
{
"uri": "/_uploadtest",
"host": "upload.example.com",
"methods": ["POST"],
"priority": 100,
"plugins": {
"serverless-pre-function": {
"phase": "rewrite",
"functions": [
"return function() ngx.req.read_body(); ngx.exit(204) end"
]
}
}
}
对比一下两个能「直接返回固定状态」的插件:
| fault-injection | 声明式 {"abort":{"http_status":204}},access 阶段直接中止 | 不读完,会截断 | 只测速率 |
| serverless-pre-function | 一行 Lua:read_body() 后 exit(204) | 完整读完再返回 | 测完整上传 |
两个二选一,别同时配——我就被这坑过:俩都开着,结果只传了 64KB 就返回了。
加完再测完整 50MB:
curl -s -o /dev/null -X POST –data-binary @/tmp/upload-test.bin \\
-w "状态:%{http_code} 上行:%{speed_upload} B/s 耗时:%{time_total}s\\n" \\
https://upload.example.com/_uploadtest
# 状态:204 上行:158827 B/s 耗时:330s (158827×330 ≈ 52MB,完整 50MB)
完整传完 50MB 用了 330 秒,速率 ~1.27 Mbps。到这里,服务端(nginx、CDN、网关、后端)全部洗清了——黑洞接口压根不碰后端,速率还是这么慢。
三、分析原因:真凶在哪一跳
3.1 关键转折:本地上行明明有 33Mbps
几组速率攒下来,而且抖得厉害:
| 直连源站(8MB,截断) | ~2.1 Mbps |
| 走 CDN 完整 50MB(第一次) | ~1.76 Mbps |
| 走 CDN 完整 50MB(第二次) | ~1.27 Mbps |
同一条链路,速率在 1.3~2.1 Mbps 之间来回飘——这种忽高忽低的抖动本身,就是链路拥塞的指纹(物理专线一般很稳)。
那是不是我本地上行就这么菜?用 macOS 自带的 networkQuality 测一下本地真实上行:
networkQuality -v
Uplink: capacity 33.766 Mbps …
Uplink: capacity 33.766 Mbps …
Uplink: capacity 23.947 Mbps …
本地上行有 33Mbps,但传到对端只有 1.3Mbps——差了 25 倍。 本地、家宽、最后一公里全部排除。问题就卡在中间那段「跨境」。
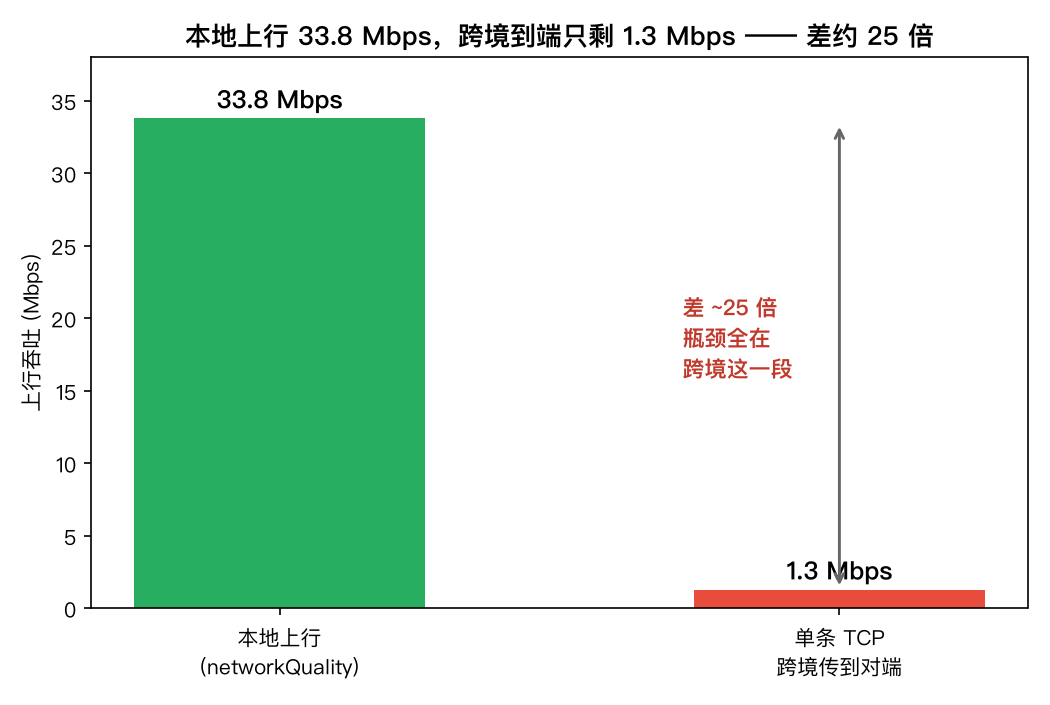
补一句背景:这次的对端是部署在海外 AWS 的服务,客户端在国内。国内 → 海外这条路,才是嫌疑最大的一段。
3.2 mtr 逐跳定位:但别被「假丢包」骗了
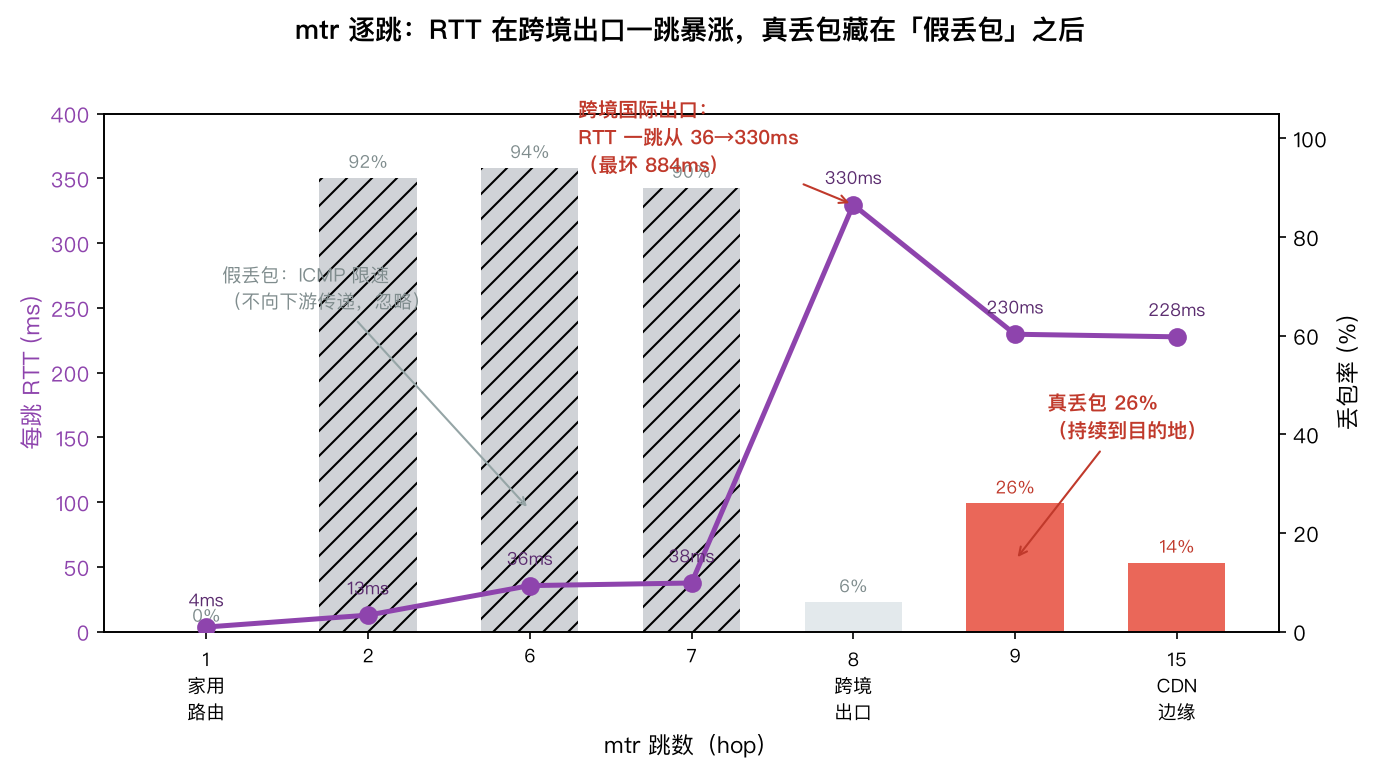
mtr 是定位「慢在哪一跳」最直接的工具,能看出哪一跳延迟突然飙高、哪一跳开始丢包:
sudo mtr -rwzbc 50 upload.example.com
HOST Loss% Snt Last Avg Best Wrst StDev
1. 192.168.x.x (家用路由器) 0.0% 50 3.8 3.5 2.3 13.4 1.9
2. 100.64.0.1 92.0% 50 7.4 12.7 7.4 24.9 8.3
…
6. 202.97.94.142 94.0% 50 35.1 35.5 33.2 38.3 2.6
7. 202.97.12.37 90.0% 50 36.4 37.5 36.2 38.7 1.1
8. 202.97.76.34 6.0% 50 228.8 329.6 226.6 884.8 193.0
9. xx.xx.xx.xx 26.0% 50 227.0 229.6 226.1 246.6 5.5
…
15. …cloudfront.net(边缘节点) 14.0% 50 227.2 227.6 225.8 246.6 3.1
坑:中间那些 90% 丢包是假的
hop 2/6/7 显示 90%+ 丢包,别慌,这是假象。这些路由器对 ICMP 探测包做了限速 / 降优先级,不代表真实丢包。判断依据很简单:
如果某一跳真丢 90%,它后面的跳不可能只丢 6%。丢包不向下游传递 = ICMP 限速,忽略它。
这个误读几乎人人踩过:看到一片红就以为线路烂穿了,其实大多是中间路由器懒得回 ICMP 而已。只有**「丢包一直持续到目的地」**的那种,才是真丢包。
真正的信号在 hop 8、9
- hop 8(202.97.x 是中国电信 163 骨干网的国际出口):RTT 从上一跳的 ~36ms 一跳暴涨到 ~228ms,最坏到 884ms、StDev 193——剧烈抖动,典型的国际出口拥塞排队。
- hop 9:RTT 227ms,丢包 26%——这是真实丢包。
- hop 15:CloudFront 边缘节点,延迟 227ms。
227ms 高延迟 + 26% 真实丢包,这俩凑一起,就是单条 TCP 连接的「天花板封印」。
3.3 为什么高延迟 + 丢包,能把上传打到 2Mbps
单条 TCP 的吞吐,受「往返延迟(RTT)」和「丢包率」双重压制。有个经典的近似公式(Mathis 公式):
吞吐 ≈ MSS / (RTT × √丢包率)
直觉理解:TCP 每遇到一次丢包,就以为网络拥塞了,把发送窗口砍半、再慢慢爬回来;RTT 越大,「爬回来」越慢。227ms 的 RTT 配上 26% 的丢包,窗口根本涨不起来,吞吐被死死摁在 1~2Mbps,而且每次丢包都抖一下——和我们看到的现象严丝合缝。
这也是 带宽时延积(Bandwidth-delay product) 的现实版:长肥管道(高带宽 × 高延迟)里,单条连接很难吃满带宽,丢包更是雪上加霜。
附带两个发现
定性结论:瓶颈 100% 在「客户端 → 跨境国际出口」这一段(高延迟 + 严重丢包),与 nginx、CDN、网关、后端全部无关——这跟开头 nginx 日志「655s 全耗在收 body、吞吐仅 31KB/s」完全互相印证:nginx 不是慢,是 body 在跨境链路上爬得慢。
四、解决方案
既然瓶颈在跨境链路、又一时改不了物理线路,那就从「绕开单条 TCP 的封印」入手。按性价比排序:
4.1 分片并发上传(主菜,收益最大)
核心思路:单条连接被丢包摁在 2Mbps,但本地上行有 33Mbps 富余——多开几条连接并发,每条各自爬,加起来就快了。
对端是 AWS,最自然的就是 S3 Multipart Upload(分片上传):把大文件切成多个 part(每片 ≥5MB,末片除外),多线程并发上传,单个 part 失败只重传那一片(对丢包友好),并发度 6~16 就能把本地上行喂饱、逼近国际出口的真实上限。
但具体怎么落地,取决于「谁手里攥着 AWS 凭证」——这里有个最容易踩空的认知。
情况一:上传方持有 AWS 凭证(后端 / 服务器直传)
直接用 AWS SDK,自动分片并发,一行搞定。以 Java SDK v2 的 S3TransferManager 为例:
S3TransferManager tm = S3TransferManager.create();
FileUpload upload = tm.uploadFile(b -> b
.source(Paths.get("big.mp4"))
.putObjectRequest(req -> req.bucket("my-bucket").key("big.mp4")));
upload.completionFuture().join();
// TransferManager 默认对大文件自动分片 + 并发上传,单片失败自动重试
情况二:浏览器直传 S3,但浏览器不该拿凭证(更常见,也正是本次的坑)
生产上更常见的姿势是浏览器拿一个后端签好的预签名 URL、直传 S3——绝不能把 AWS 凭证下发到浏览器。这时有个反直觉的事实,绕不过去:
一个预签名 PUT 只能把整个对象整体传一次,没有任何「S3 桶开关」能把它变成浏览器端并行分片。 Transfer Acceleration 只加速传输、不提供分片能力。
S3 分片是三步——createMultipartUpload(init)→ uploadPart × N → completeMultipartUpload——每一步都要凭证签名。浏览器没凭证,所以这三步的签名必须由后端来做:
三方交互画成时序图就一目了然——签名全在后端,数据全走浏览器直传 S3,自家后端不碰文件字节:
AWS S3
后端(持 AWS 凭证)
浏览器
AWS S3
后端(持 AWS 凭证)
浏览器
#mermaid-svg-m2vfeKPWZGOoNDfb{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-m2vfeKPWZGOoNDfb .error-icon{fill:#552222;}#mermaid-svg-m2vfeKPWZGOoNDfb .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-m2vfeKPWZGOoNDfb .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-m2vfeKPWZGOoNDfb .marker{fill:#333333;stroke:#333333;}#mermaid-svg-m2vfeKPWZGOoNDfb .marker.cross{stroke:#333333;}#mermaid-svg-m2vfeKPWZGOoNDfb svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-m2vfeKPWZGOoNDfb p{margin:0;}#mermaid-svg-m2vfeKPWZGOoNDfb .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-m2vfeKPWZGOoNDfb text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-m2vfeKPWZGOoNDfb .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-m2vfeKPWZGOoNDfb .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-m2vfeKPWZGOoNDfb #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-m2vfeKPWZGOoNDfb .sequenceNumber{fill:white;}#mermaid-svg-m2vfeKPWZGOoNDfb #sequencenumber{fill:#333;}#mermaid-svg-m2vfeKPWZGOoNDfb #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-m2vfeKPWZGOoNDfb .messageText{fill:#333;stroke:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-m2vfeKPWZGOoNDfb .labelText,#mermaid-svg-m2vfeKPWZGOoNDfb .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .loopText,#mermaid-svg-m2vfeKPWZGOoNDfb .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-m2vfeKPWZGOoNDfb .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-m2vfeKPWZGOoNDfb .noteText,#mermaid-svg-m2vfeKPWZGOoNDfb .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-m2vfeKPWZGOoNDfb .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-m2vfeKPWZGOoNDfb .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-m2vfeKPWZGOoNDfb .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-m2vfeKPWZGOoNDfb .actorPopupMenu{position:absolute;}#mermaid-svg-m2vfeKPWZGOoNDfb .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-m2vfeKPWZGOoNDfb .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-m2vfeKPWZGOoNDfb .actor-man circle,#mermaid-svg-m2vfeKPWZGOoNDfb line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-m2vfeKPWZGOoNDfb :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
par
[并发直传(绕开后端)]
CORS 需 ExposeHeaders:["ETag"],
否则浏览器读不到 ETag,下一步必挂
init(文件名 / 大小 / 分几片)
createMultipartUpload
uploadId
为每一片 presign uploadPart
各片预签名 URL
uploadId + 各片预签名 URL
PUT part 1(预签名 URL)
200 + ETag1
PUT part N(预签名 URL)
200 + ETagN
complete(各片 partNumber + ETag)
completeMultipartUpload
合并完成
上传成功
图:S3 分片上传三方交互时序——签名全在后端(createMultipartUpload / presign / complete),浏览器拿预签名 URL 并发直传 S3、收各片 ETag,最后交回后端合并;CORS 需 ExposeHeaders:[“ETag”] 否则 complete 必挂。
前端切片 + 并发的骨架:
const CHUNK = 5 * 1024 * 1024; // 5MB 一片(S3 要求每片 ≥5MB,末片除外)
// partUrls:后端 init 时为每一片签好的预签名 uploadPart URL
const parts = await Promise.all(partUrls.map(async ({ url, partNumber }, i) => {
const blob = file.slice(i * CHUNK, (i + 1) * CHUNK);
const res = await fetch(url, { method: 'PUT', body: blob }); // 并发直传 S3
return { partNumber, eTag: res.headers.get('ETag') }; // 收下每片 ETag
}));
await fetch('/upload/complete', { method: 'POST', body: JSON.stringify(parts) }); // 交回后端合并
⚠️ 头号坑:S3 桶 CORS 必须 ExposeHeaders: ["ETag"]
complete 那步要把每片的 ETag 交回去合并。而浏览器出于 CORS 安全策略,默认读不到跨域响应的自定义头——桶 CORS 里不显式声明 ExposeHeaders: ["ETag"],res.headers.get('ETag') 拿到的就是 null,complete 百分百失败。偏偏报错完全不提 CORS,极难往这上面联想。这是方案落地的第一个坑。
一个工程实践:按大小分流,别一刀切
分片不是免费的——多了 init + N 次签名 + complete 的往返开销,小文件走分片反而更慢。实际策略是按体积分流:
文件 ≤ 5MB(一片)→ 预签名单 PUT (图片走这,占大头,零额外开销)
文件 > 5MB → 分片并发上传 (大视频走这,专治跨境慢)
另外别忘了给桶配一条生命周期规则 AbortIncompleteMultipartUpload(如 7 天),自动清理上传中断的残片——否则没 complete 的分片会一直躺在桶里持续计费。
4.2 前端上传前压缩 / 限制分辨率
减小上传体积,治标但立竿见影。20MB 原视频直传偏大,压到 5MB 以内,体验立刻不一样。
4.3 优化跨境线路
让流量走更优质的国际线路(优质中转 / 专线),别走电信 163 直连。如果有路由器级的代理,确认它的分流规则真的接管了对端网段、且出口线路够好。
4.4 CDN 边缘优化
别让 CDN 边缘飘到很远的节点。检查 CloudFront distribution 的 Price Class,限制到就近区域,缩短「客户端 → 边缘」这一跳。
4.5 注意超时隐患
proxy_read_timeout = 90s:如果后端要做大文件压缩(ffmpeg),压缩一旦超 90s 就触发 504。大文件场景要么调大超时,要么把压缩改成异步任务。
关于 nginx 超时配置怎么把后端拖下水,这篇有更深的一个案例:AI 服务 502 雪崩排查:从 Nginx 超时到连接池耗尽,查了两次才找到真凶。
五、解决(验证):并发实测 5 倍提速
光说不练假把式。把黑洞接口当靶子,6 条连接同时传 1MB:
for i in 1 2 3 4 5 6; do
curl -s -o /dev/null -X POST –data-binary @/tmp/up1m.bin \\
-w "conn$i:%{speed_upload}B/s\\n" \\
https://upload.example.com/_uploadtest &
done; wait
conn5:248661B/s
conn2:224303B/s
conn6:205638B/s
conn1:196186B/s
conn4:185850B/s
conn3:115474B/s
合计 ≈ 1176 KB/s ≈ 9.4 Mbps,是单条(~2Mbps)的 ~5 倍。而且本地还有 33Mbps 没吃满,加大并发还能更快。

分片并发能解,实锤。 落地就是把上传客户端从「单条 POST 一个大文件」改成「切片 + 并发」,方案见第四节。
六、举一反三:一套可复用的「传输慢」排查 SOP
把这次的路径抽出来,遇到任何「上传/下载慢、各方都甩锅」都能套:
最后一句话总结:「上传慢」十有八九不是 nginx 或后端的问题,而是它们之间那条网络路径的问题。把服务端用数据一个个洗清、再让 mtr 指向真凶,远比埋头一通乱调 nginx 参数有用。
七、延伸阅读
- curl 实战:程序员必备的接口调试与性能排查利器
- 后端 2ms,页面 7 秒:一次 CDN"帮倒忙"的排查实录
- AI 服务 502 雪崩排查:从 Nginx 超时到连接池耗尽,查了两次才找到真凶
- nginx 官方文档:proxy_request_buffering
- AWS 官方文档:Uploading and copying objects using multipart upload
- Wikipedia:Bandwidth-delay product
🏷️ 标签:Nginx 线上排障 跨境网络 TCP 丢包 分片上传 CDN