一、演示数据构造
为了在后续的例子中对ST_Union和ST_Collect这两个函数进行具体的介绍。因此首先需要设计一张空间表来存储相关数据。这里我们以两个存在重叠面的场景为例来进行讲解。
1、PostGIS空间表准备 首先创建一张用于测试空间面数据的空间表,表结构如下:
CREATE TABLE china_regions (
id SERIAL PRIMARY KEY,
region_name VARCHAR(50),
geom GEOMETRY(POLYGON, 4326)
);
为了演示方便,这里暂不设计复杂的空间字段,geom空间属性列中专门用于保存Polygon面数据。
1、测试数据准备
接下来准备两个存在重叠的区域的边界坐标,然后使用标准SQL插入到PostGIS空间数据库中。插入的标准SQL语句如下:
— 插入区域一(简化版)
INSERT INTO china_regions (region_name, geom) VALUES (
'模拟区域一',
ST_GeomFromText(
'POLYGON((112.879114 28.18866, 112.882333 28.181397, 112.890959 28.186125, 112.888813 28.192518, 112.881432 28.190967, 112.879114 28.18866))',
4326
)
);
— 插入区域二(简化版)
INSERT INTO china_regions (region_name, geom) VALUES (
'模拟区域二',
ST_GeomFromText(
'POLYGON((112.886152 28.186882, 112.89053 28.181473, 112.899714 28.186428, 112.898769 28.193047, 112.886367 28.193766, 112.886152 28.186882))',
4326
)
);
为了验证是否成功将这两条SQL插入到空间数据库中,需要注意的是,在插入数据时,首尾的坐标一定要闭合,否则会报错。数据新增成功后可以使用下面SQL来进行查询验证:
select t.*,st_asgeojson(t.geom) from china_regions t;
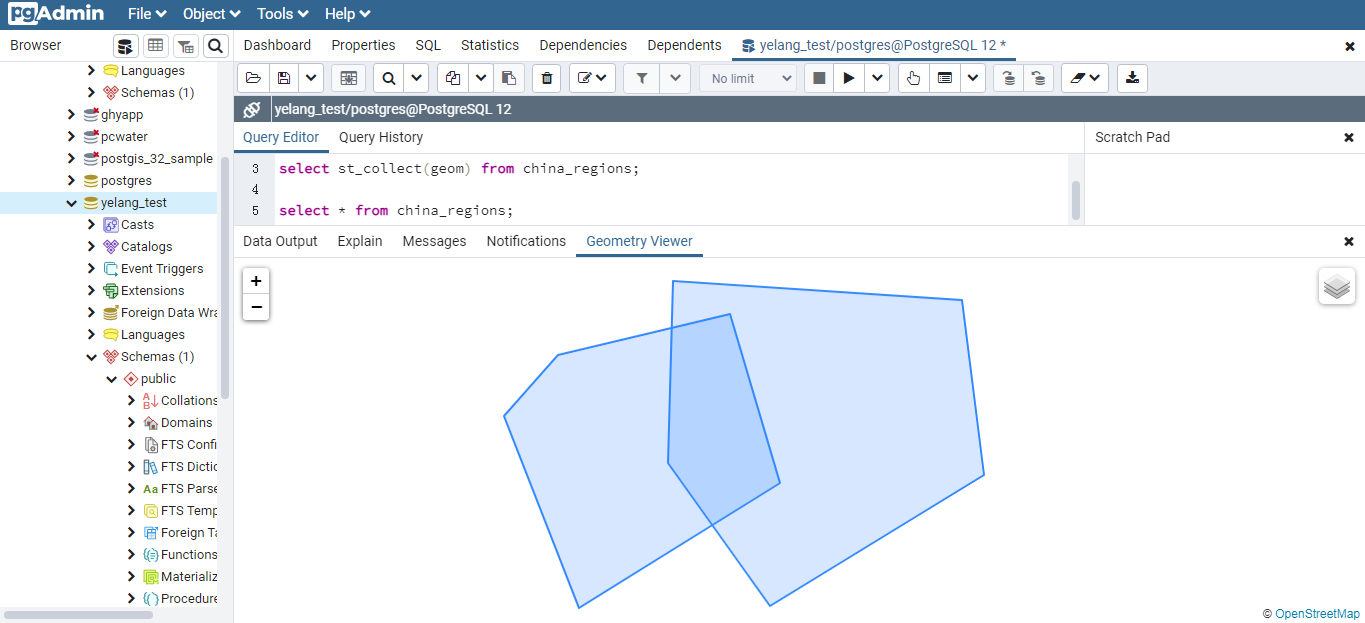
从上图中可以明显得看到,两个面的中间有一块明显重叠的区域。到此,空间物理表及两个模拟面的数据基本准备完毕,接下来可以进入正式的两个函数对比阶段。
2、两个函数融合展示
本节将使用实例对两个函数的融合展示进行深入介绍,通过详细的介绍。让大家了解这两个函数的具体区别,让大家在实际工作中可以有针对性的选择。
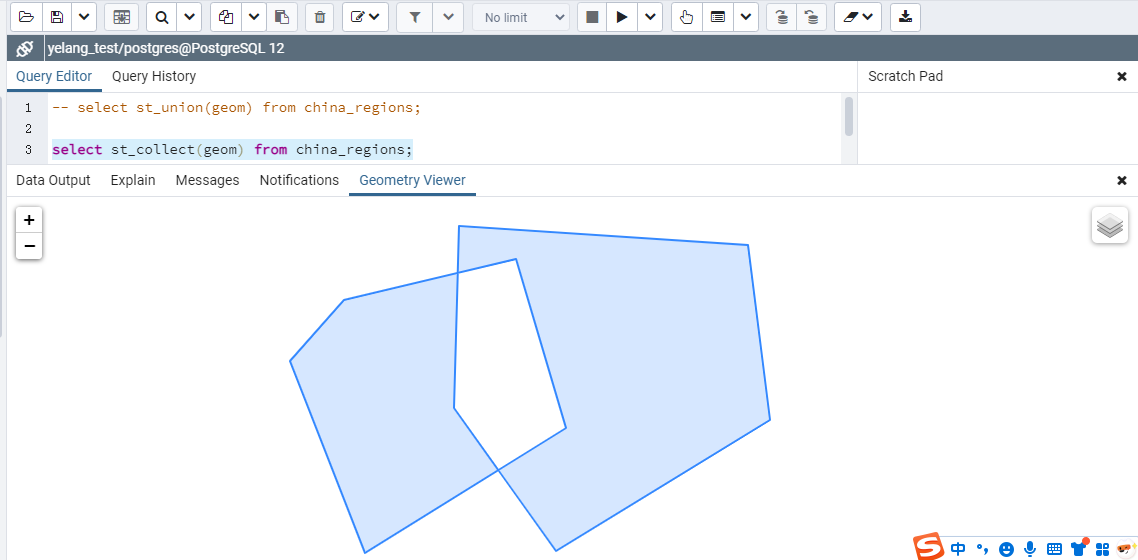
1、ST_Collect融合 首先来介绍ST_Collect,ST_Collect就像给你的地理数据准备的一个"收集盒"或"文件夹"。它把多个地理对象放在一起,但不改变它们本身。每个对象还是独立存在的,只是现在它们在一个容器里。st_collect的特点如下:
✅ 只收集,不改变:原封不动地把数据放一起
✅ 保留所有:重复的部分、重叠的区域都保留
✅ 速度快:因为没有复杂的计算
✅ 适合显示和传输:把所有数据打包,方便一次性显示或导出
下面来看看它的使用查询SQL,下面是对它的查询结果进行可视化:
select st_collect(geom) from china_regions;
ST_Collect的 实际应用场景:
批量导出数据:把所有选定区域的地理数据打包
一次性显示:在地图上同时显示多个独立要素
中间步骤:先收集数据,后续再做其他处理
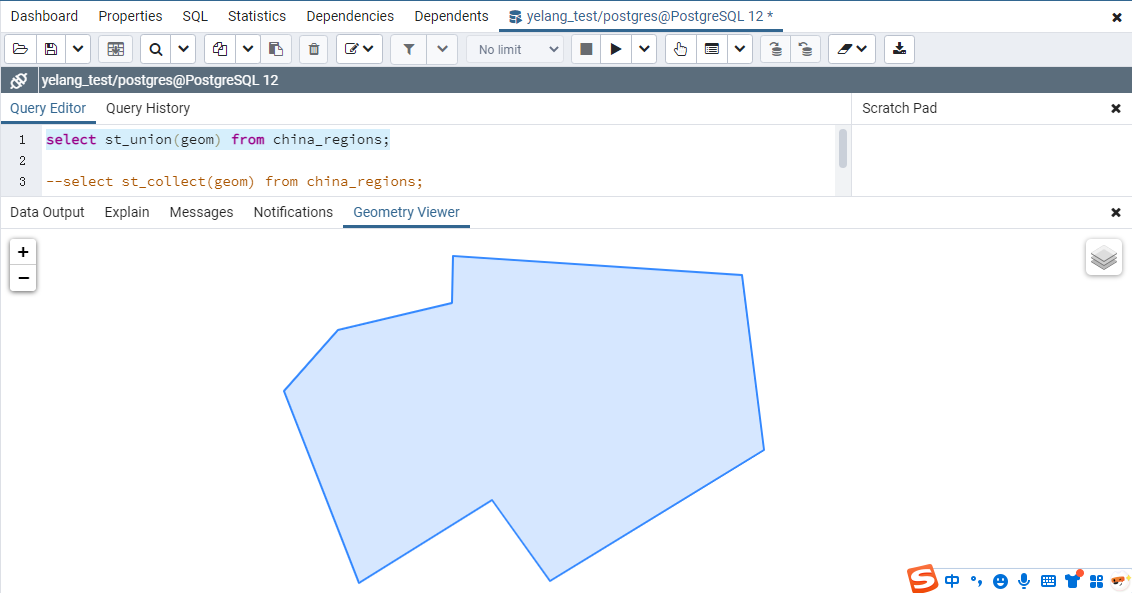
2、ST_Union融合 下面来说说st_union这个函数。ST_Union是一个真正的"融合器"。它不仅把数据放在一起,还会进行智能融合:消除重复边界、合并重叠区域。想象一下把几个相邻的土地合并成一块大土地。ST_Union的核心特点:
✅ 融合计算:进行空间计算,合并几何
✅ 消除重叠:重叠的部分只计算一次
✅ 创建新形状:可能生成全新的几何
✅ 计算精确:适合面积计算等需要精确性的场景
st_union的查询sql如下:
select st_union(geom) from china_regions;
st_union的实际应用场景:
计算总面积:多个区域有重叠时,避免重复计算
创建连续区域:把相邻的小区域合并成大区域
数据清理:消除小缝隙和重叠
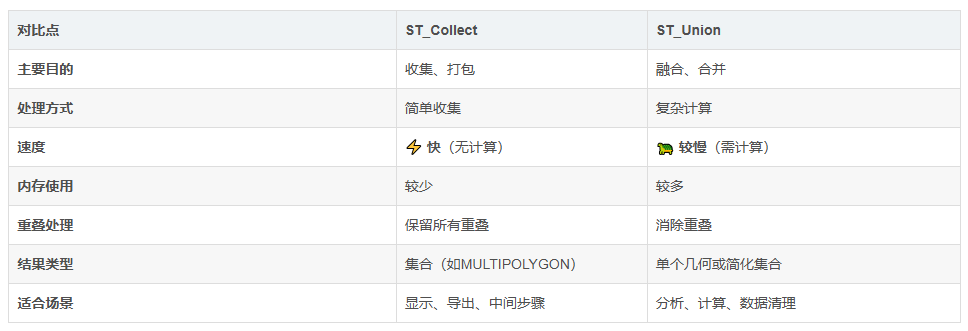
3、结果对比 下面针对数据融合方面对这两个函数进行一个简单的对比: