引言:从RNN到Transformer的演进之路
在深度学习的发展历程中,序列数据处理一直是一个核心挑战。在Transformer出现之前,循环神经网络(RNN)及其变体LSTM、GRU主导了这一领域。然而,这些架构存在一个根本性限制:它们的顺序处理特性使得并行计算变得困难,训练速度受限,且难以捕捉长距离依赖关系。
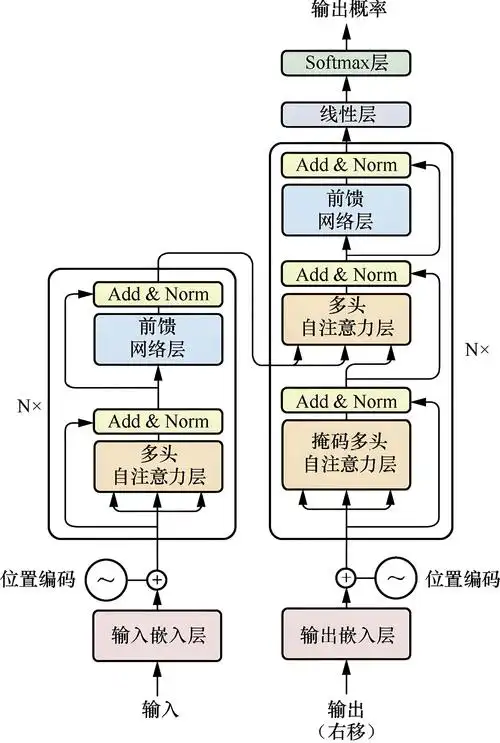
2017年,谷歌研究团队在论文《Attention Is All You Need》中提出了Transformer模型,这一创新彻底改变了自然语言处理乃至整个AI领域的格局。Transformer摒弃了循环结构,完全基于注意力机制构建,不仅大幅提升了训练效率,还在多项任务中取得了突破性表现。
Transformer的核心原理
自注意力机制:理解上下文的关键
自注意力机制是Transformer的核心创新,它使模型能够在处理序列时直接关注到所有位置的信息,无论它们之间的距离有多远。
自注意力的数学表达:
text
Attention(Q, K, V) = softmax(QK^T/√d_k)V
其中Q(查询)、K(键)、V(值)都是从同一输入通过不同线性变换得到的矩阵。这种设计允许模型在编码每个词时,考虑输入序列中所有词的重要性。
多头注意力: Transformer将注意力机制扩展到多个“头”,每个头学习不同表示子空间中的注意力模式,从而捕捉不同类型的依赖关系。
python
# 简化的多头注意力实现示意
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super().__init__()
self.d_model = d_model
self.num_heads = num_heads
self.d_k = d_model // num_heads
self.W_q = nn.Linear(d_model, d_model)
self.W_k = nn.Linear(d_model, d_model)
self.W_v = nn.Linear(d_model, d_model)
self.W_o = nn.Linear(d_model, d_model)
def forward(self, query, key, value, mask=None):
# 线性变换并分割为多个头
Q = self.W_q(query).view(batch_size, -1, self.num_heads, self.d_k)
K = self.W_k(key).view(batch_size, -1, self.num_heads, self.d_k)
V = self.W_v(value).view(batch_size, -1, self.num_heads, self.d_k)