📋 Research Summary
迁移学习是机器学习中最重要的技术之一,其核心思想是"将从一个任务学到的知识,迁移到另一个相关任务"。预训练+微调是迁移学习的典型实现方式。这一技术使得我们可以利用在大数据上学到的知识,来解决数据稀缺的新问题,是现代深度学习的基石。
🌱 逻辑原点
如果让机器从零开始学习一个新任务太慢,能否让它"借用"之前学到的知识?
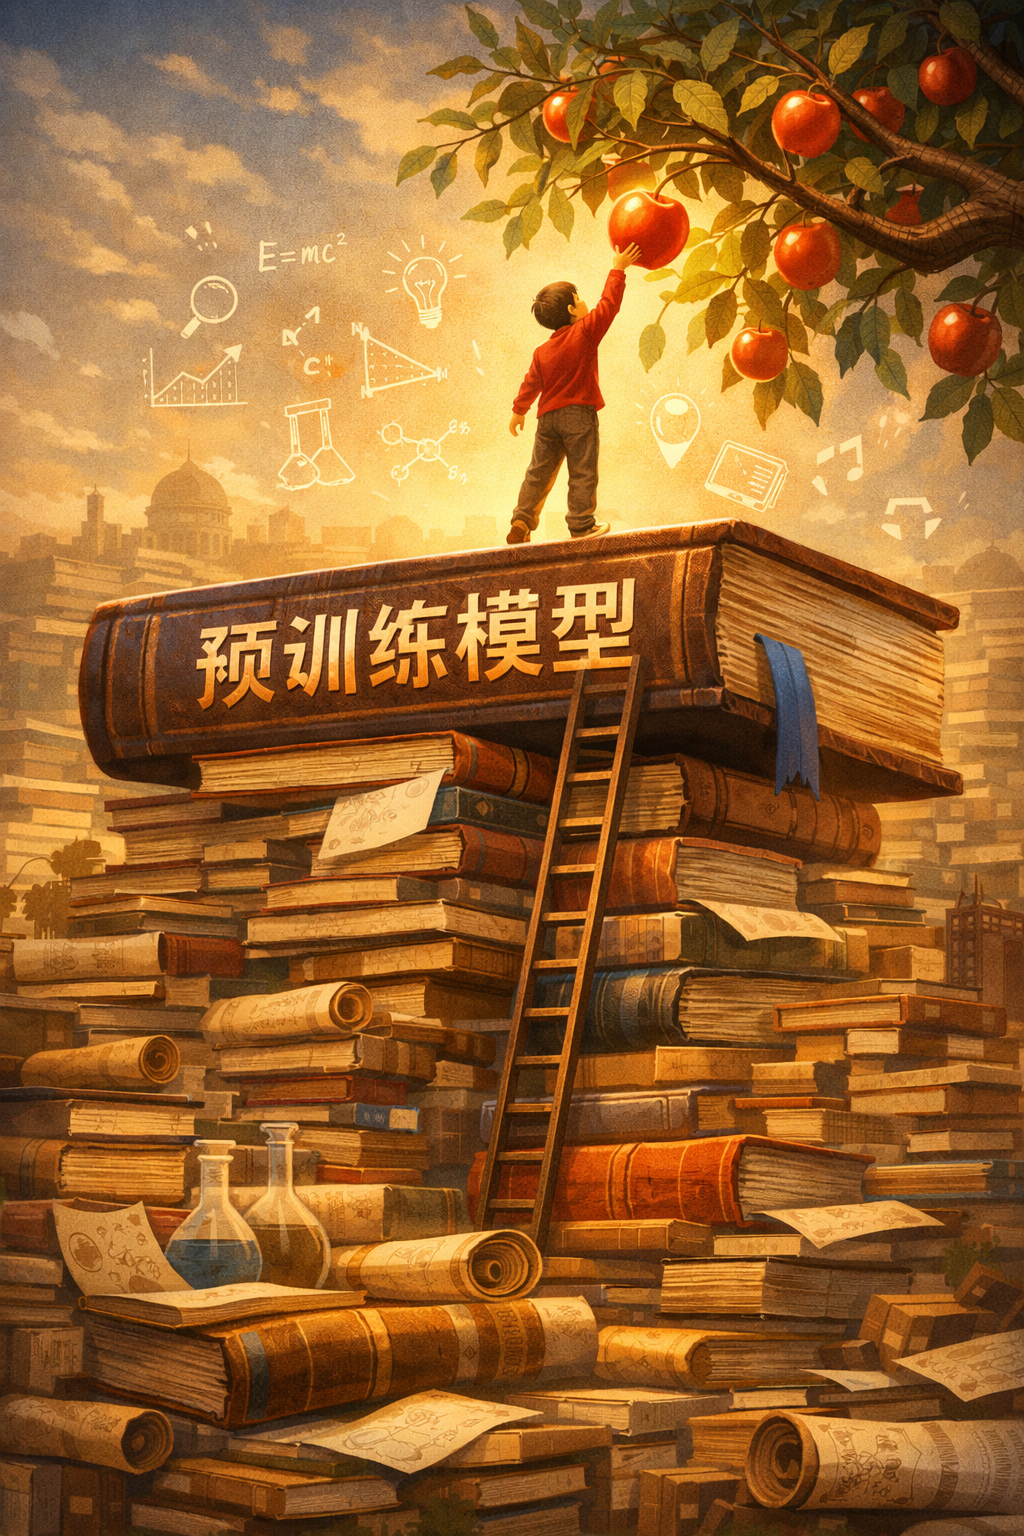
这就像一个已经学会骑自行车的人,学习骑摩托车会更快——知识是可以迁移的。迁移学习正是基于这个直觉。
🧠 苏格拉底式对话
1️⃣ 现状:最原始的解法是什么?
如果不使用任何迁移学习,每个任务怎么训练?
最朴素的方法是从零训练(Training from Scratch):
- 对于每个新任务,完全随机初始化模型参数
- 从头开始训练,不使用任何先验知识
- 每个任务都是独立的"从零开始"
这就像一个人每次学习新技能都忘记之前所有技能——效率极低,无法利用之前的积累。
2️⃣ 瓶颈:规模扩大100倍时会在哪里崩溃?
当需要学习100个不同但相关的任务时,从零训练会怎样?
答案是:每个任务都需要大量数据和计算资源,无法承受。
- 如果有100个任务,每个都从零训练,需要100倍的数据和计算
- 很多实际任务根本没有足够的标注数据
- 重复训练相同的底层特征,浪费严重
从零训练在多任务场景下成本爆炸,且效果不佳。
3️⃣ 突破:必须引入什么新维度?
如何让知识在任务之间"流动"起来?
答案:预训练 + 微调。
迁移学习的核心思想:
不是每个任务从零学 -> 而是先学通用知识,再适应特定任务
不是"从零开始" -> 而是"站在巨人的肩膀上"
两步走策略:
预训练(Pretraining):在大规模通用数据上训练,学到通用特征
- 图像:ImageNet 上训练
- 语言:大规模文本上训练
微调(Fine-tuning):在目标任务数据上调整
- 冻结底层权重,只调整顶层
- 或全部放开,用更小的学习率
📊 视觉骨架
#mermaid-svg-BFZQsqnaka1ebTHB{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-BFZQsqnaka1ebTHB .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-BFZQsqnaka1ebTHB .error-icon{fill:#552222;}#mermaid-svg-BFZQsqnaka1ebTHB .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-BFZQsqnaka1ebTHB .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-BFZQsqnaka1ebTHB .marker{fill:#333333;stroke:#333333;}#mermaid-svg-BFZQsqnaka1ebTHB .marker.cross{stroke:#333333;}#mermaid-svg-BFZQsqnaka1ebTHB svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-BFZQsqnaka1ebTHB p{margin:0;}#mermaid-svg-BFZQsqnaka1ebTHB .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-BFZQsqnaka1ebTHB .cluster-label text{fill:#333;}#mermaid-svg-BFZQsqnaka1ebTHB .cluster-label span{color:#333;}#mermaid-svg-BFZQsqnaka1ebTHB .cluster-label span p{background-color:transparent;}#mermaid-svg-BFZQsqnaka1ebTHB .label text,#mermaid-svg-BFZQsqnaka1ebTHB span{fill:#333;color:#333;}#mermaid-svg-BFZQsqnaka1ebTHB .node rect,#mermaid-svg-BFZQsqnaka1ebTHB .node circle,#mermaid-svg-BFZQsqnaka1ebTHB .node ellipse,#mermaid-svg-BFZQsqnaka1ebTHB .node polygon,#mermaid-svg-BFZQsqnaka1ebTHB .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-BFZQsqnaka1ebTHB .rough-node .label text,#mermaid-svg-BFZQsqnaka1ebTHB .node .label text,#mermaid-svg-BFZQsqnaka1ebTHB .image-shape .label,#mermaid-svg-BFZQsqnaka1ebTHB .icon-shape .label{text-anchor:middle;}#mermaid-svg-BFZQsqnaka1ebTHB .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-BFZQsqnaka1ebTHB .rough-node .label,#mermaid-svg-BFZQsqnaka1ebTHB .node .label,#mermaid-svg-BFZQsqnaka1ebTHB .image-shape .label,#mermaid-svg-BFZQsqnaka1ebTHB .icon-shape .label{text-align:center;}#mermaid-svg-BFZQsqnaka1ebTHB .node.clickable{cursor:pointer;}#mermaid-svg-BFZQsqnaka1ebTHB .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-BFZQsqnaka1ebTHB .arrowheadPath{fill:#333333;}#mermaid-svg-BFZQsqnaka1ebTHB .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-BFZQsqnaka1ebTHB .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-BFZQsqnaka1ebTHB .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BFZQsqnaka1ebTHB .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-BFZQsqnaka1ebTHB .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BFZQsqnaka1ebTHB .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-BFZQsqnaka1ebTHB .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-BFZQsqnaka1ebTHB .cluster text{fill:#333;}#mermaid-svg-BFZQsqnaka1ebTHB .cluster span{color:#333;}#mermaid-svg-BFZQsqnaka1ebTHB div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-BFZQsqnaka1ebTHB .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-BFZQsqnaka1ebTHB rect.text{fill:none;stroke-width:0;}#mermaid-svg-BFZQsqnaka1ebTHB .icon-shape,#mermaid-svg-BFZQsqnaka1ebTHB .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-BFZQsqnaka1ebTHB .icon-shape p,#mermaid-svg-BFZQsqnaka1ebTHB .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-BFZQsqnaka1ebTHB .icon-shape rect,#mermaid-svg-BFZQsqnaka1ebTHB .image-shape rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-BFZQsqnaka1ebTHB .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-BFZQsqnaka1ebTHB .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-BFZQsqnaka1ebTHB :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
大规模通用数据Large Generic Data
预训练Pretraining
预训练模型Pretrained Model
迁移方式
特征提取Feature Extraction
全参数微调Full Fine-tuning
高效微调PEFT LoRA/Adapter
目标任务数据Target Task Data
微调Fine-tuning
目标任务模型
迁移学习流程:在大规模数据上预训练 → 在目标任务上微调 → 获得目标模型
⚖️ 权衡模型
公式:
迁移学习 = 解决了 数据稀缺问题 + 牺牲了 任务特异性 + 增加了 负迁移风险
代价分析:
- ✅ 解决:用少量数据就能训练出好模型,大幅降低数据需求和训练成本
- ❌ 牺牲:预训练任务和目标任务不同时,效果可能下降(负迁移)
- ⚠️ 增加:需要选择合适的预训练模型,微调策略设计有技巧
🔁 记忆锚点
# 迁移学习的本质:知识的迁移
# 传统方式:每个任务从零开始
def train_from_scratch(task_data):
model = random_init()
return train(model, task_data)
# 迁移学习:站在巨人的肩膀上
def transfer_learning(pretrained_model, task_data):
"""
预训练:在大规模数据上学到通用特征
微调:在目标任务上适应
"""
# 方案1:只训练顶层
for param in model.parameters():
param.requires_grad = False
model.last_layer = new_head()
return train(model, task_data)
# 方案2:全参数微调
model.load_state_dict(pretrained_weights)
return fine_tune(model, task_data, lr=1e-5)
一句话本质: 迁移学习是"站在巨人的肩膀上"——先在通用大数据上学到基础能力,再在特定任务上微调,既省数据又省计算。