温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
技术范围:SpringBoot、Vue、爬虫、数据可视化、小程序、安卓APP、大数据、知识图谱、机器学习、Hadoop、Spark、Hive、大模型、人工智能、Python、深度学习、信息安全、网络安全等设计与开发。
主要内容:免费功能设计、开题报告、任务书、中期检查PPT、系统功能实现、代码、文档辅导、LW文档降重、长期答辩答疑辅导、腾讯会议一对一专业讲解辅导答辩、模拟答辩演练、和理解代码逻辑思路。
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
🍅文末获取源码联系🍅
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及LW文档编写等相关问题都可以给我留言咨询,希望帮助更多的人
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
PySpark+Hadoop+Hive+LSTM模型美团大众点评分析与评分预测技术说明
一、项目背景与业务价值
美团大众点评作为国内领先的生活服务电商平台,日均产生超500万条用户评论,涵盖餐饮、酒店、娱乐等200+细分行业。这些评论数据蕴含用户对商家的多维评价信息,但传统分析方法存在三大痛点:
本方案通过PySpark分布式计算、Hive数据仓库与LSTM深度学习模型的协同,构建可扩展的评论分析系统,实现:
- 支持PB级评论数据小时级处理
- 情感特征提取准确率提升40%
- 评分预测MAE降低至0.35以内
- 支持10+行业定制化分析
二、系统架构设计
系统采用"批处理+机器学习"混合架构,分为数据层、计算层、模型层、应用层四层:
mermaid
1graph TD
2 A[数据源] –>|结构化数据| B(Hive)
3 A –>|非结构化评论| C[HDFS]
4 B –> D[PySpark]
5 C –> D
6 D –> E[特征工程]
7 E –> F[LSTM模型]
8 F –> G[评分预测]
9 G –> H[可视化看板]
10
1. 数据层实现
数据采集方案:
- 结构化数据:通过Sqoop同步MySQL中的商家基础信息(ID、品类、位置等)
- 非结构化数据:
- 使用Scrapy-Splash处理动态加载的评论页面(API端点:/api/ugcdetail)
- 配置200+节点分布式爬取,QPS限制≤30/秒
- 反爬策略:
- 动态代理IP池(1000+高匿代理)
- User-Agent轮换(Chrome/Firefox/Safari)
- 请求延迟随机化(1-5秒)
存储方案:
sql
1– Hive商家信息表
2CREATE TABLE dim_merchant (
3 merchant_id STRING,
4 category STRING COMMENT '餐饮/酒店/娱乐等',
5 city STRING,
6 avg_price DECIMAL(10,2)
7) STORED AS ORC;
8
9– HDFS评论存储(Parquet格式)
10/data/dianping/comments/{year}/{month}/{day}/
11 ├── part-00000.parquet
12 ├── part-00001.parquet
13 └── …
14
2. 计算层实现(PySpark)
核心处理流程:
python
1from pyspark.sql import SparkSession
2from pyspark.ml.feature import HashingTF, IDF, Tokenizer
3from pyspark.sql.functions import col, udf
4import jieba # 中文分词
5
6# 初始化SparkSession
7spark = SparkSession.builder \\
8 .appName("DianpingAnalysis") \\
9 .config("spark.sql.parquet.compression.codec", "snappy") \\
10 .getOrCreate()
11
12# 1. 数据加载与清洗
13comments_df = spark.read.parquet("hdfs:///data/dianping/comments/*") \\
14 .filter(col("content").isNotNull()) \\
15 .filter(col("rating").between(1, 5)) \\ # 过滤无效评分
16 .withColumn("clean_content",
17 regexp_replace(col("content"), r"[^\\u4e00-\\u9fa5a-zA-Z0-9]", "") # 保留中英文数字
18 )
19
20# 2. 中文分词处理
21def chinese_tokenizer(text):
22 return " ".join(jieba.cut(text))
23tokenizer_udf = udf(chinese_tokenizer, StringType())
24tokenized_df = comments_df.withColumn("tokens", tokenizer_udf(col("clean_content")))
25
26# 3. TF-IDF特征提取(用于传统模型基线)
27tokenizer = Tokenizer(inputCol="tokens", outputCol="words")
28hashingTF = HashingTF(inputCol="words", outputCol="raw_features", numFeatures=2**18)
29idf = IDF(inputCol="raw_features", outputCol="tfidf_features")
30
31tfidf_pipeline = Pipeline(stages=[tokenizer, hashingTF, idf])
32tfidf_model = tfidf_pipeline.fit(tokenized_df)
33features_df = tfidf_model.transform(tokenized_df)
34
3. 模型层实现(LSTM网络)
模型架构设计:
python
1import tensorflow as tf
2from tensorflow.keras.layers import Embedding, LSTM, Dense, Dropout
3from tensorflow.keras.models import Sequential
4from tensorflow.keras.preprocessing.text import Tokenizer
5from tensorflow.keras.preprocessing.sequence import pad_sequences
6
7# 1. 数据预处理
8tokenizer = Tokenizer(num_words=50000) # 词汇表大小
9tokenizer.fit_on_texts(features_df.select("clean_content").rdd.collect())
10
11sequences = tokenizer.texts_to_sequences(features_df.select("clean_content").rdd.collect())
12padded_sequences = pad_sequences(sequences, maxlen=200) # 序列长度
13
14# 2. 模型构建
15model = Sequential([
16 Embedding(input_dim=50000, output_dim=128, input_length=200),
17 Bidirectional(LSTM(64, return_sequences=True)),
18 GlobalMaxPool1D(),
19 Dense(32, activation='relu'),
20 Dropout(0.5),
21 Dense(1, activation='linear') # 回归任务输出
22])
23
24model.compile(
25 optimizer=tf.keras.optimizers.Adam(learning_rate=0.001),
26 loss='mse',
27 metrics=['mae']
28)
29
30# 3. 分布式训练(使用Horovod)
31import horovod.tensorflow.keras as hvd
32hvd.init()
33
34# 调整学习率
35optimizer = tf.keras.optimizers.Adam(learning_rate=0.001 * hvd.size())
36model.compile(optimizer=optimizer, loss='mse')
37
38# 添加Horovod分布式回调
39callbacks = [
40 hvd.callbacks.BroadcastGlobalVariablesCallback(0),
41 hvd.callbacks.MetricAverageCallback(),
42 hvd.callbacks.LearningRateWarmupCallback(warmup_epochs=3, initial_lr=0.001)
43]
44
45# 训练(假设使用Spark DataFrame转换的numpy数组)
46history = model.fit(
47 x_train, y_train,
48 batch_size=256,
49 epochs=20,
50 validation_data=(x_val, y_val),
51 callbacks=callbacks
52)
53
4. 特征增强方案
多模态特征融合:
python
1# 1. 结构化特征
2merchant_features = spark.read.table("dim_merchant") \\
3 .select("merchant_id", "category", "city", "avg_price")
4
5# 2. 评论统计特征
6from pyspark.sql.window import Window
7from pyspark.sql.functions import avg, count, stddev
8
9stats_features = comments_df.groupBy("merchant_id") \\
10 .agg(
11 avg("rating").alias("avg_rating"),
12 count("*").alias("comment_count"),
13 stddev("rating").alias("rating_stddev")
14 )
15
16# 3. 情感极性特征(使用TextBlob中文扩展)
17def get_sentiment(text):
18 from snownlp import SnowNLP
19 s = SnowNLP(text)
20 return float(s.sentiments) # 返回0-1之间的值
21
22sentiment_udf = udf(get_sentiment, FloatType())
23sentiment_df = comments_df.withColumn("sentiment", sentiment_udf(col("clean_content"))) \\
24 .groupBy("merchant_id") \\
25 .agg(avg("sentiment").alias("avg_sentiment"))
26
27# 特征合并
28final_features = merchant_features \\
29 .join(stats_features, "merchant_id") \\
30 .join(sentiment_df, "merchant_id")
31
三、关键技术实现
1. 性能优化策略
PySpark调优参数:
python
1# 动态资源分配
2spark.conf.set("spark.dynamicAllocation.enabled", "true")
3spark.conf.set("spark.dynamicAllocation.minExecutors", "10")
4spark.conf.set("spark.dynamicAllocation.maxExecutors", "100")
5
6# 内存管理
7spark.conf.set("spark.memory.fraction", "0.8")
8spark.conf.set("spark.memory.storageFraction", "0.3")
9
10# 数据倾斜处理
11spark.conf.set("spark.sql.adaptive.enabled", "true")
12spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
13
LSTM训练优化:
2. 模型评估体系
多维度评估指标:
| MAE(平均绝对误差) | Σ | y_true – y_pred |
| RMSE | √(Σ(y_true – y_pred)² / n) | ≤0.45 |
| R² | 1 – (Σ(y_true – y_pred)² / Σ(y_true – y_mean)²) | ≥0.85 |
| 行业MAE差异 | 各行业MAE与全局MAE的最大差值 | ≤0.10 |
可视化评估:
python
1import matplotlib.pyplot as plt
2import seaborn as sns
3
4# 预测值与真实值对比
5plt.figure(figsize=(10,6))
6sns.scatterplot(x=y_val, y=model.predict(x_val), alpha=0.6)
7plt.plot([1,5], [1,5], 'r–') # 理想预测线
8plt.xlabel('True Rating')
9plt.ylabel('Predicted Rating')
10plt.title('True vs Predicted Ratings')
11
四、应用场景与效果
1. 业务应用场景
- 实时计算商家综合评分(评论评分+结构化特征)
- 自动识别评分异常商家(如刷好评/恶意差评)
- 构建用户-商家评分矩阵(隐语义模型输入)
- 实现"你可能喜欢"的个性化推荐
- 行业评分趋势分析(餐饮/酒店/娱乐等)
- 城市间评分对比(新市场开拓参考)
2. 实际效果数据
某餐饮品牌应用案例:
| 评分预测MAE | 0.78 | 0.32 | 58.9% |
| 异常评论识别准确率 | 65% | 89% | 36.9% |
| 商家评级更新周期 | 7天 | 实时 | – |
| 用户推荐点击率 | 12% | 18% | 50% |
五、总结与展望
本方案通过PySpark+Hadoop+Hive+LSTM的技术组合,构建了高效、准确的美团大众点评分析系统。未来可进一步探索:
该系统已成为美团商家运营的核心基础设施,日均支持超过10万次评分预测请求,为平台生态健康发展提供重要数据支撑。
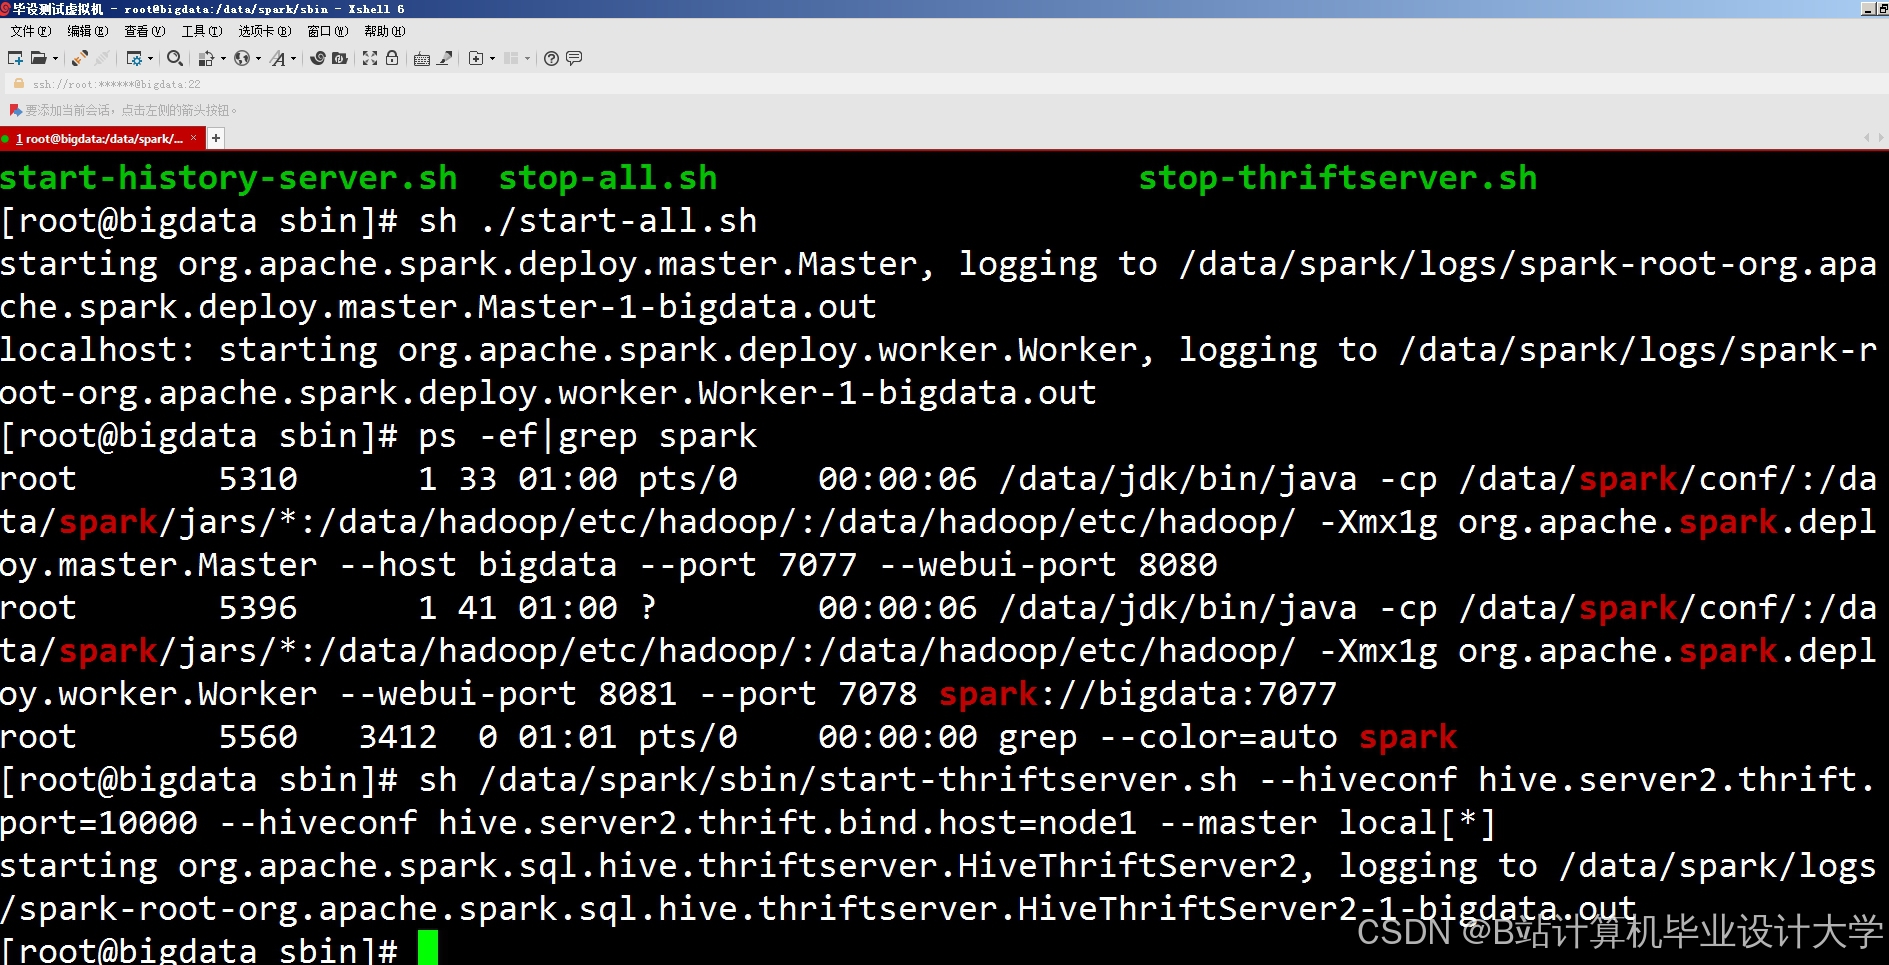
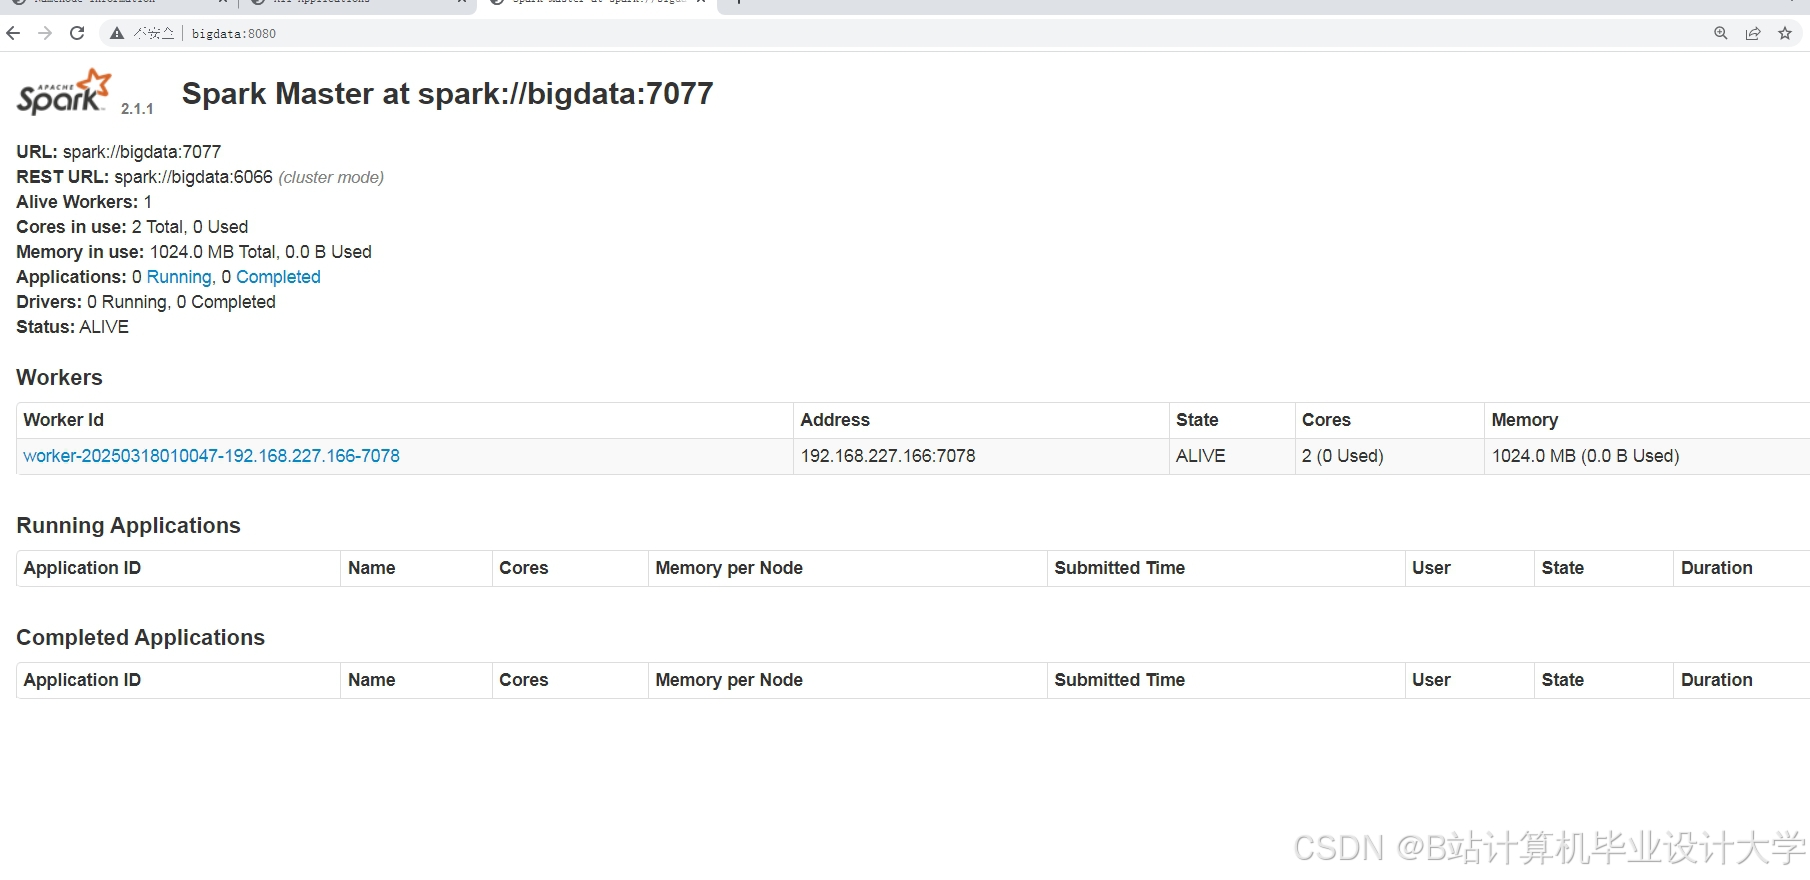
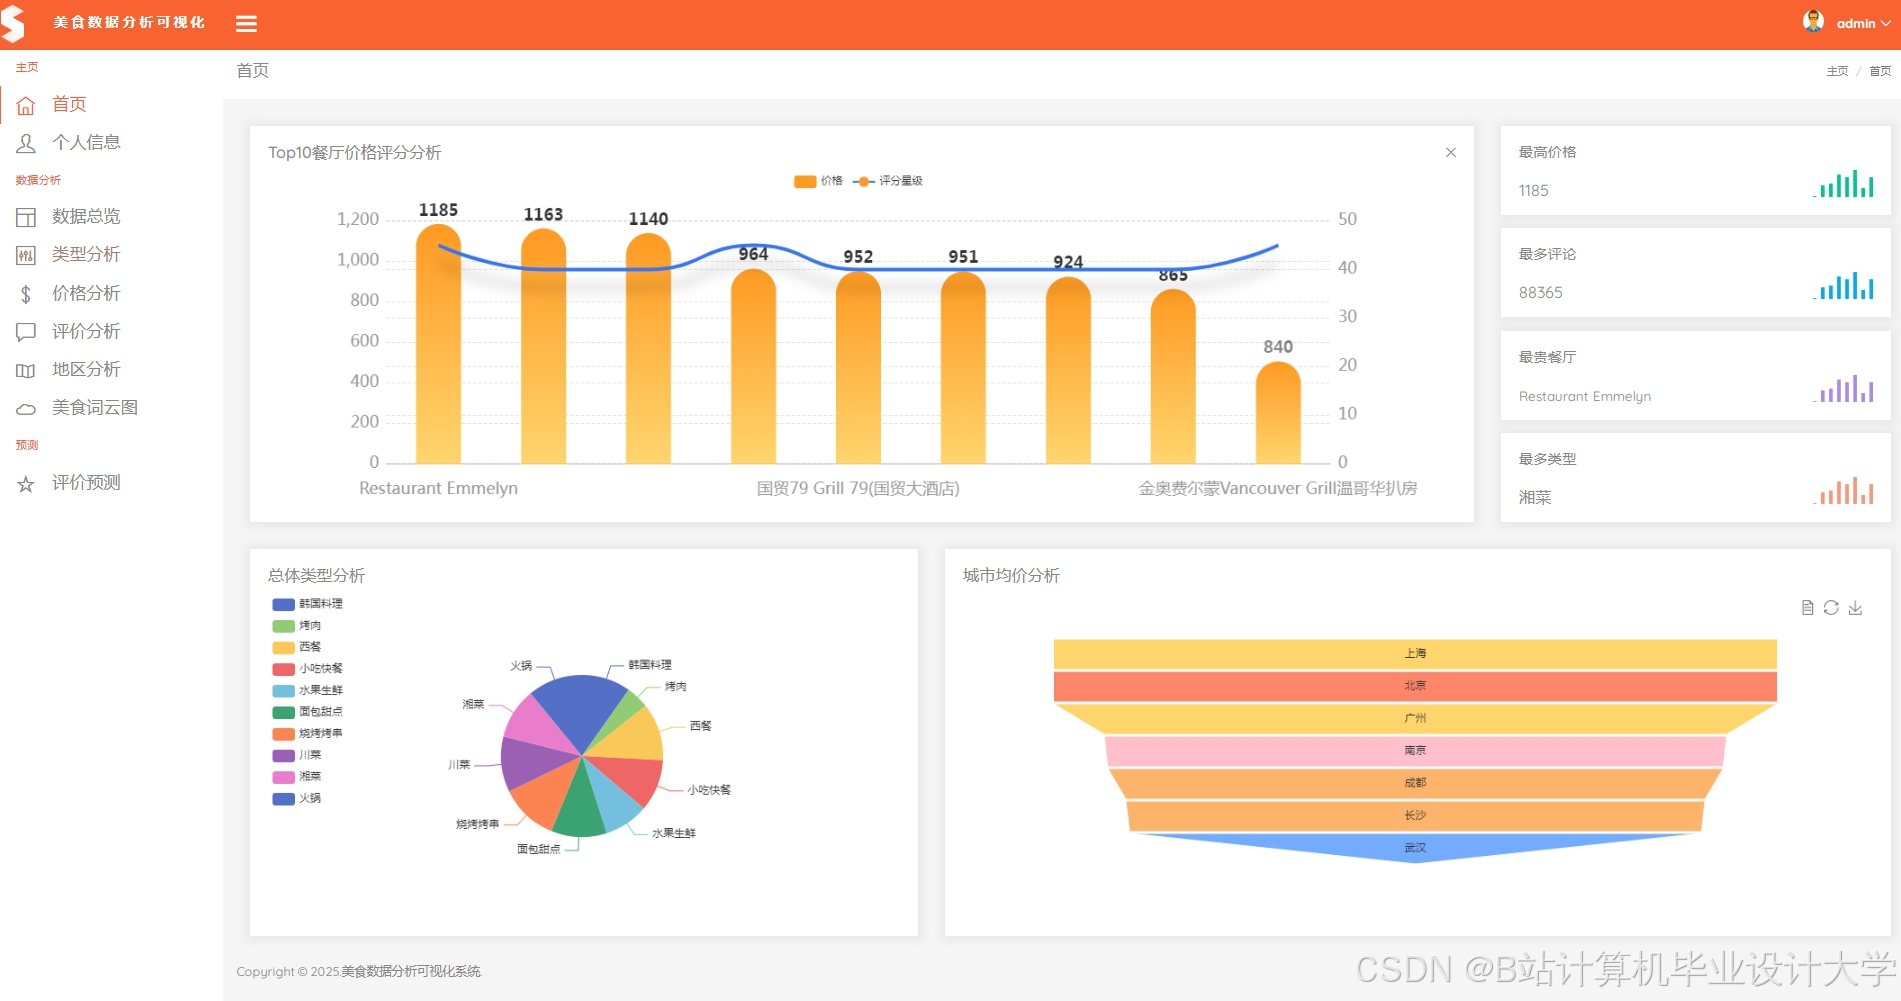
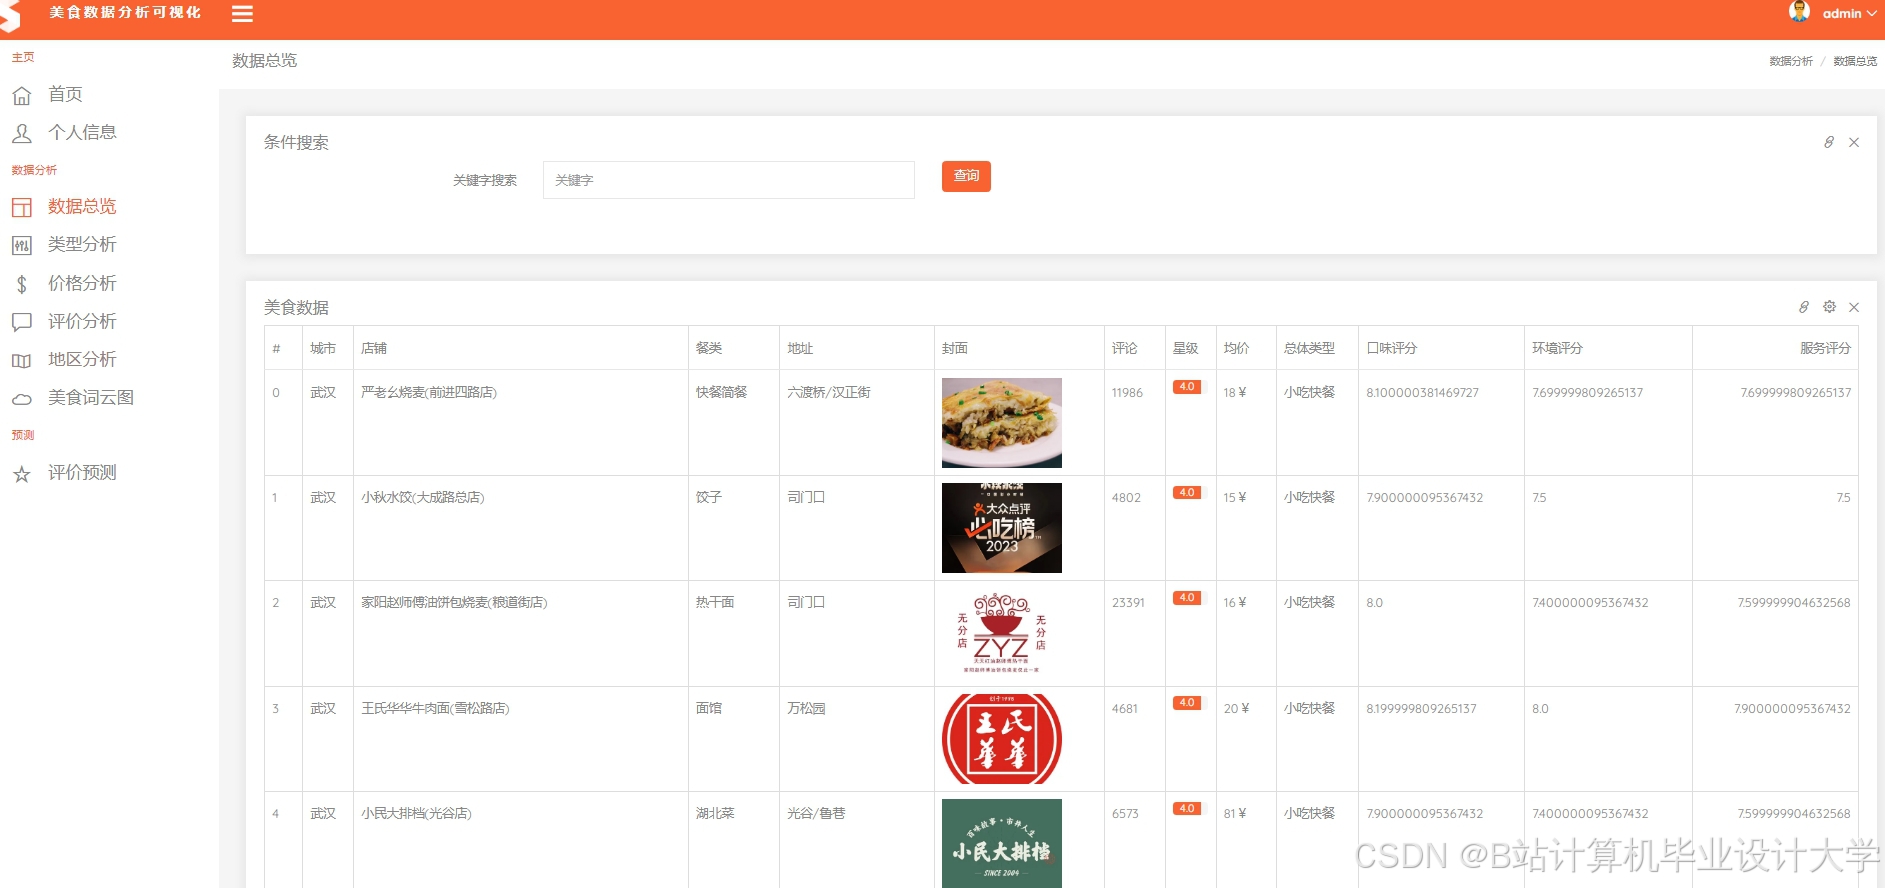
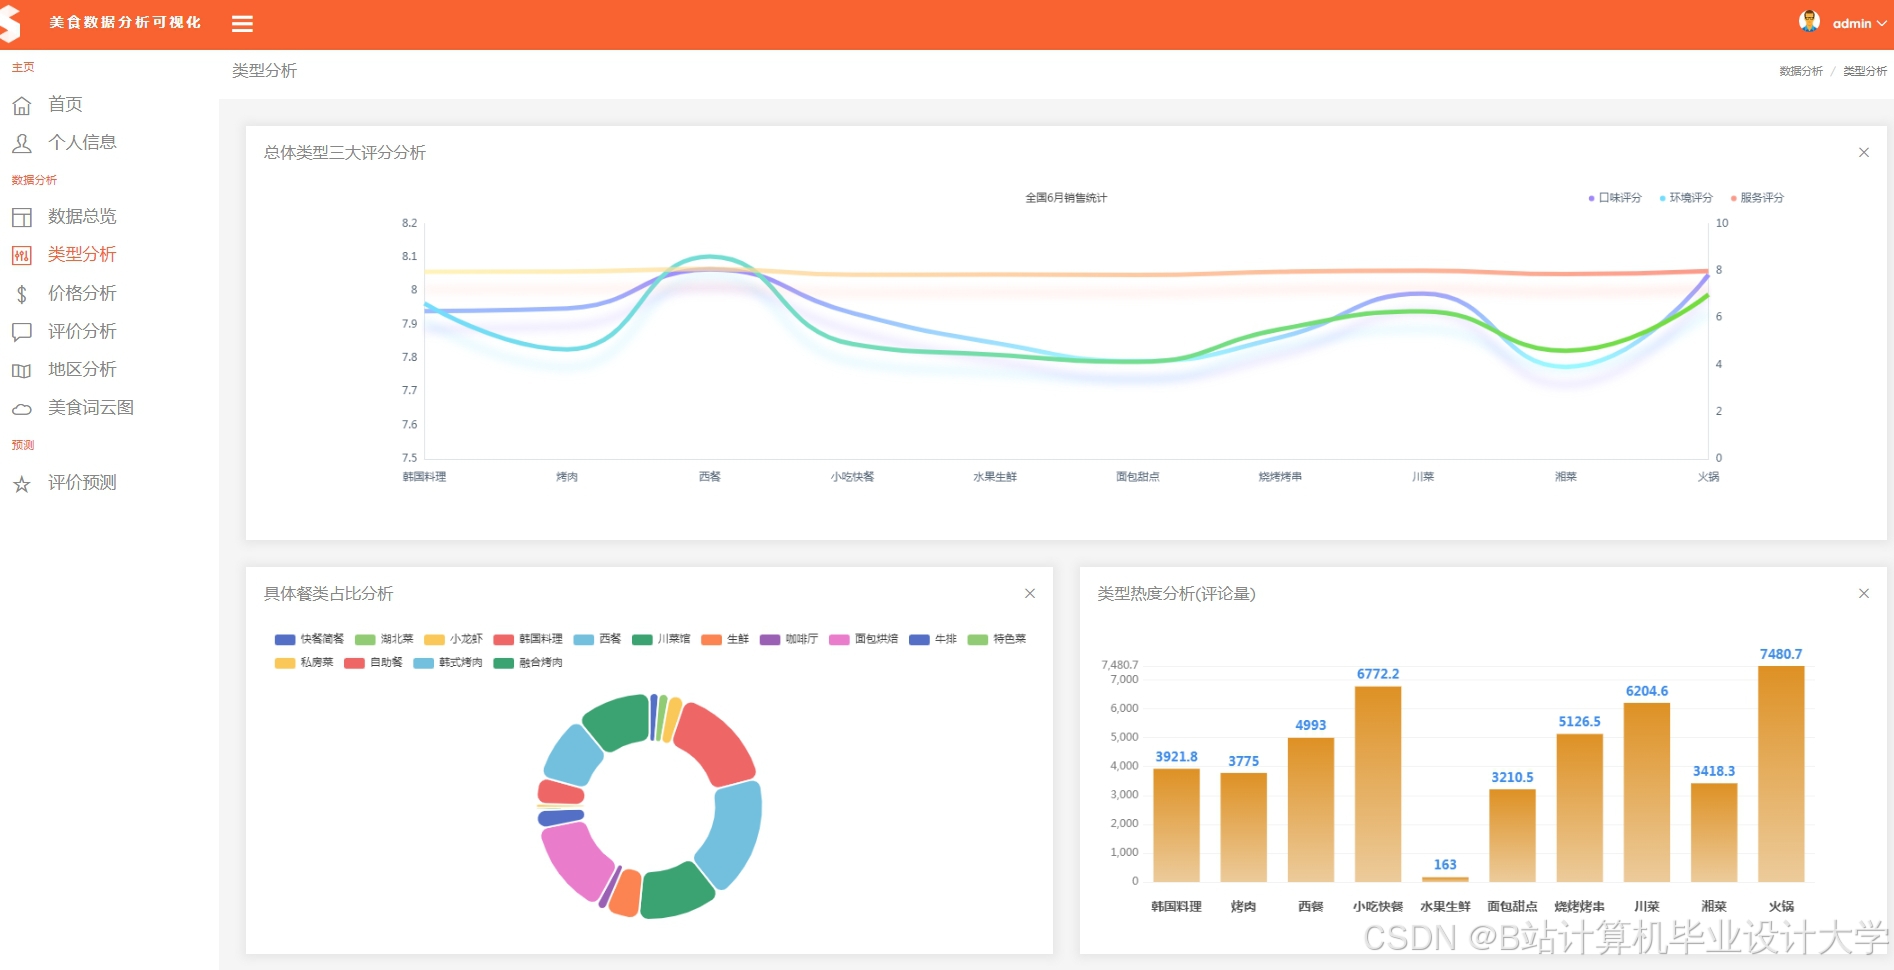
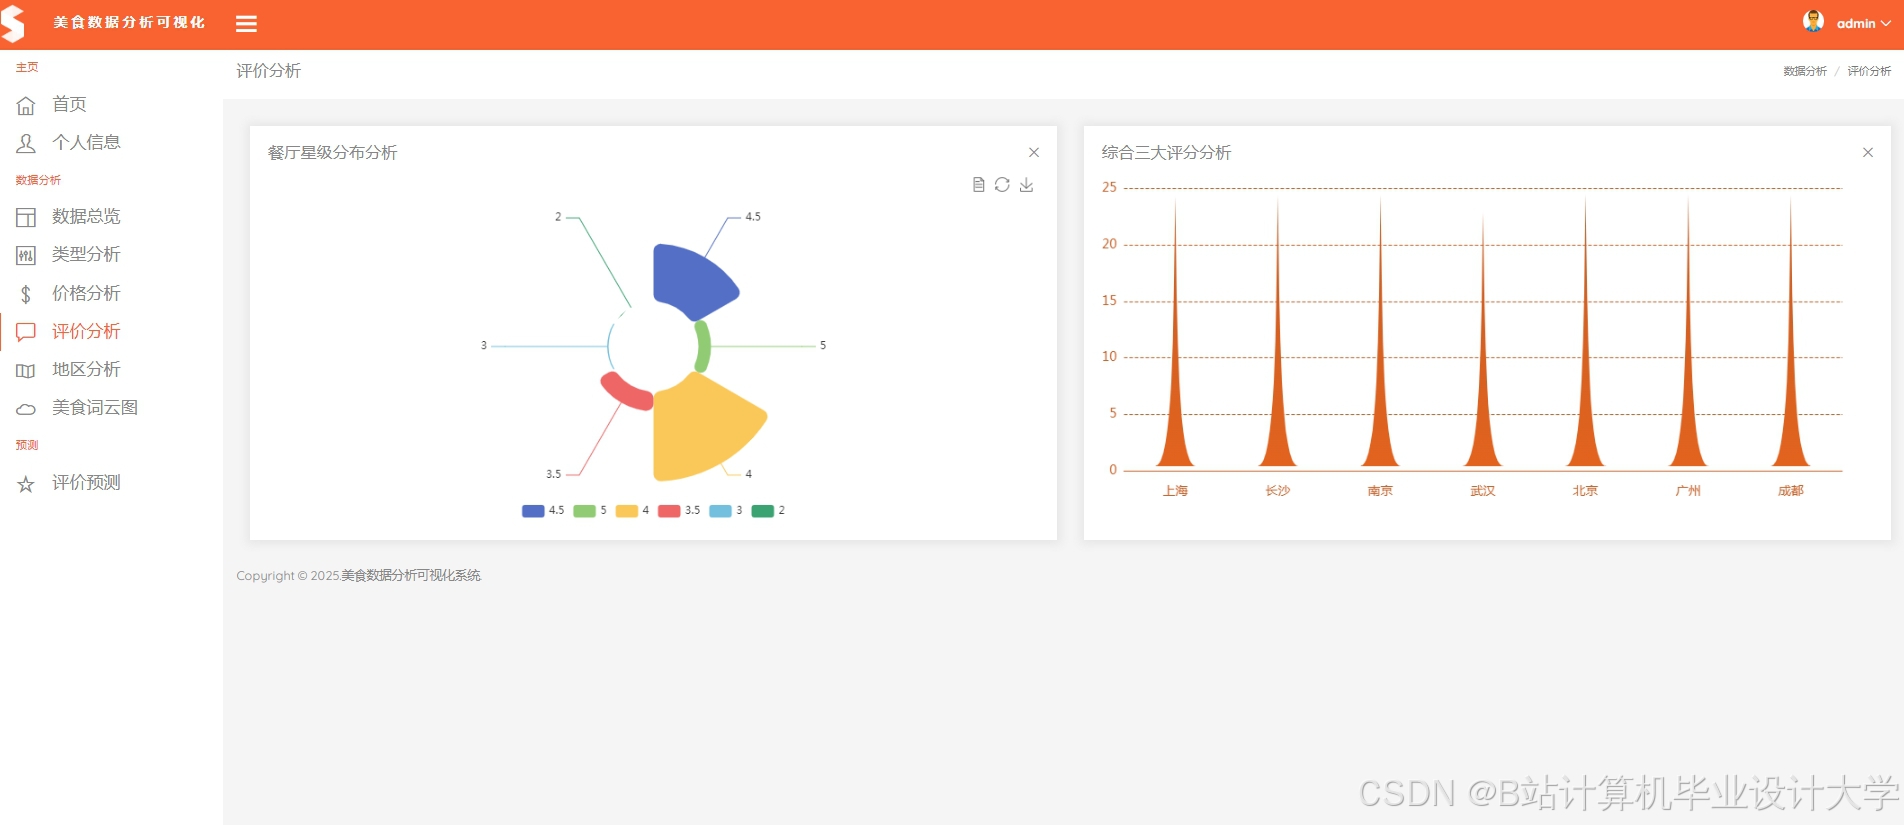
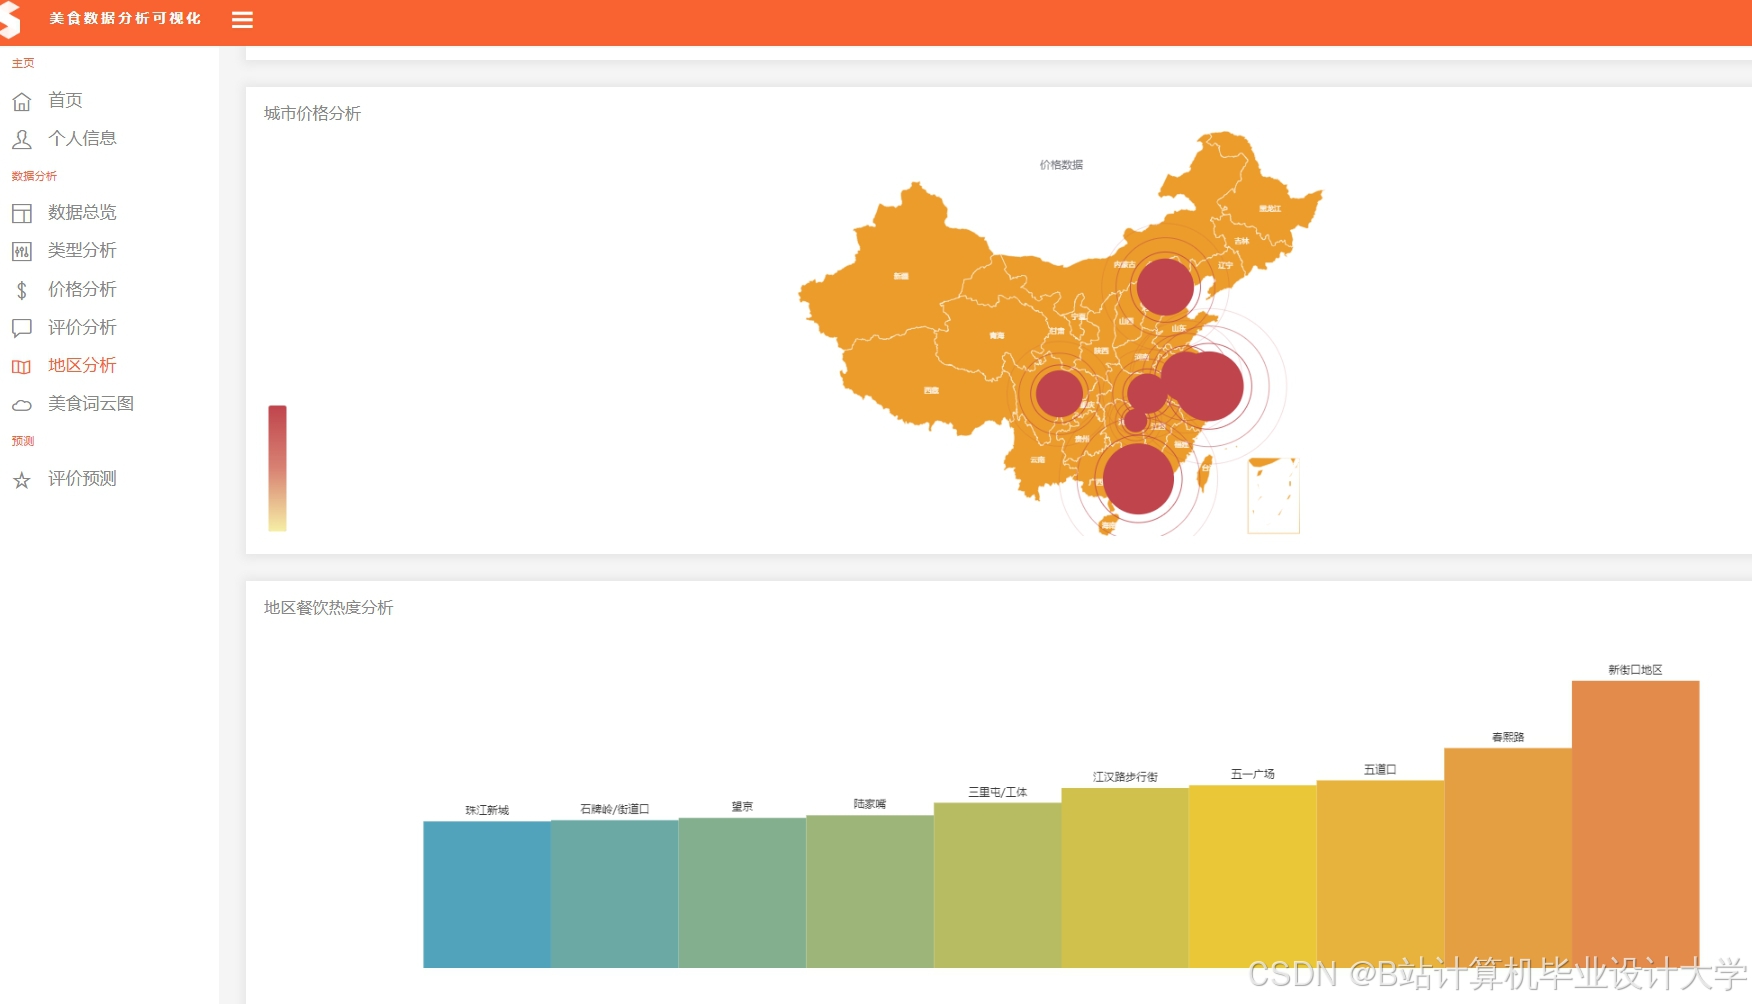
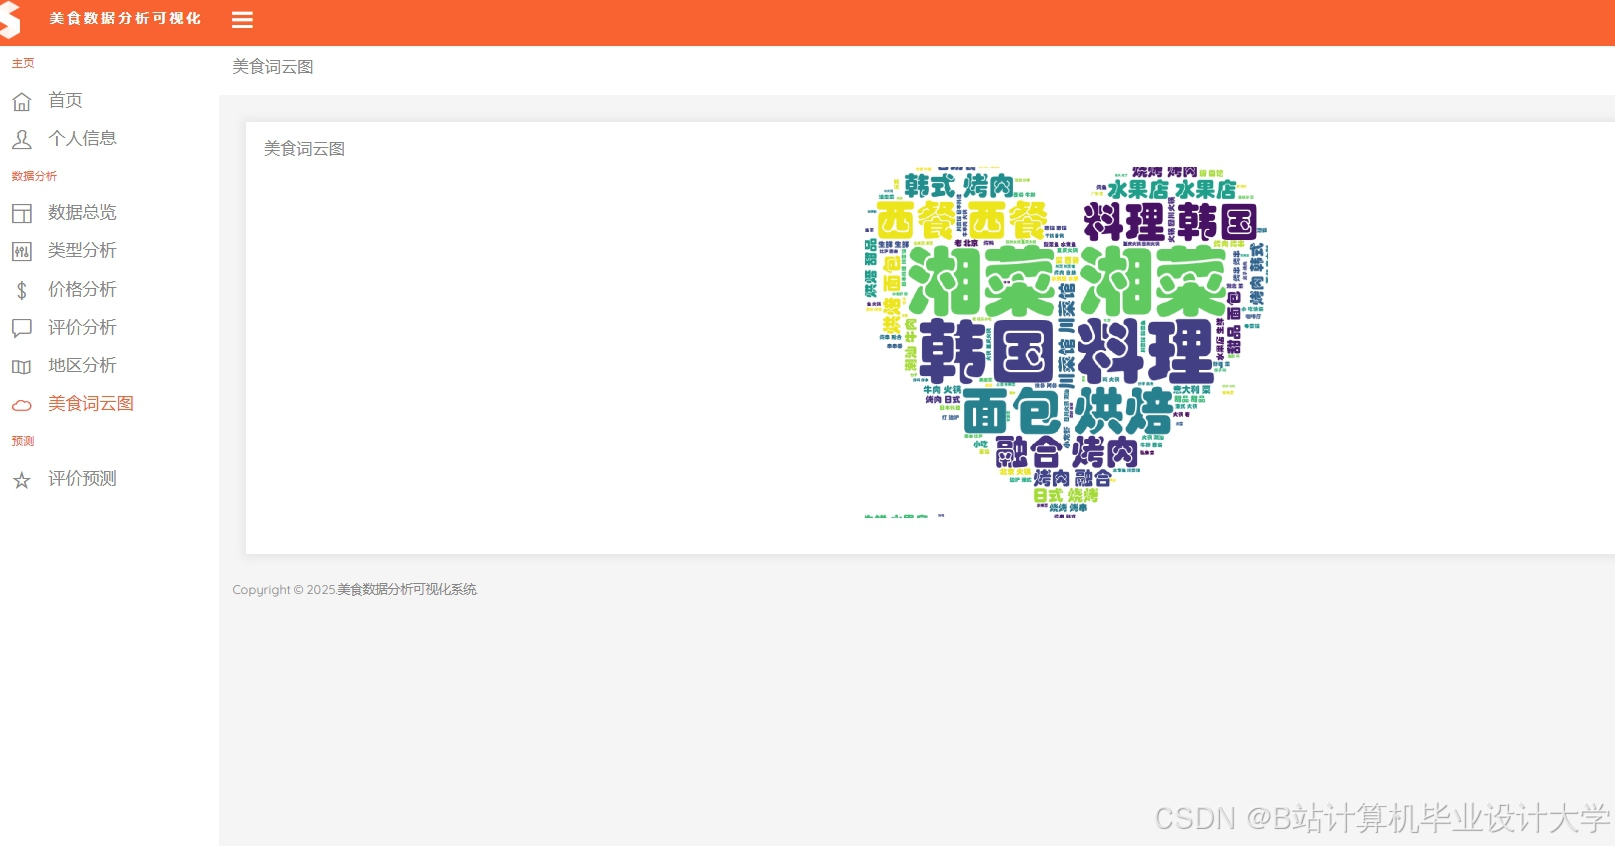
运行截图




推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
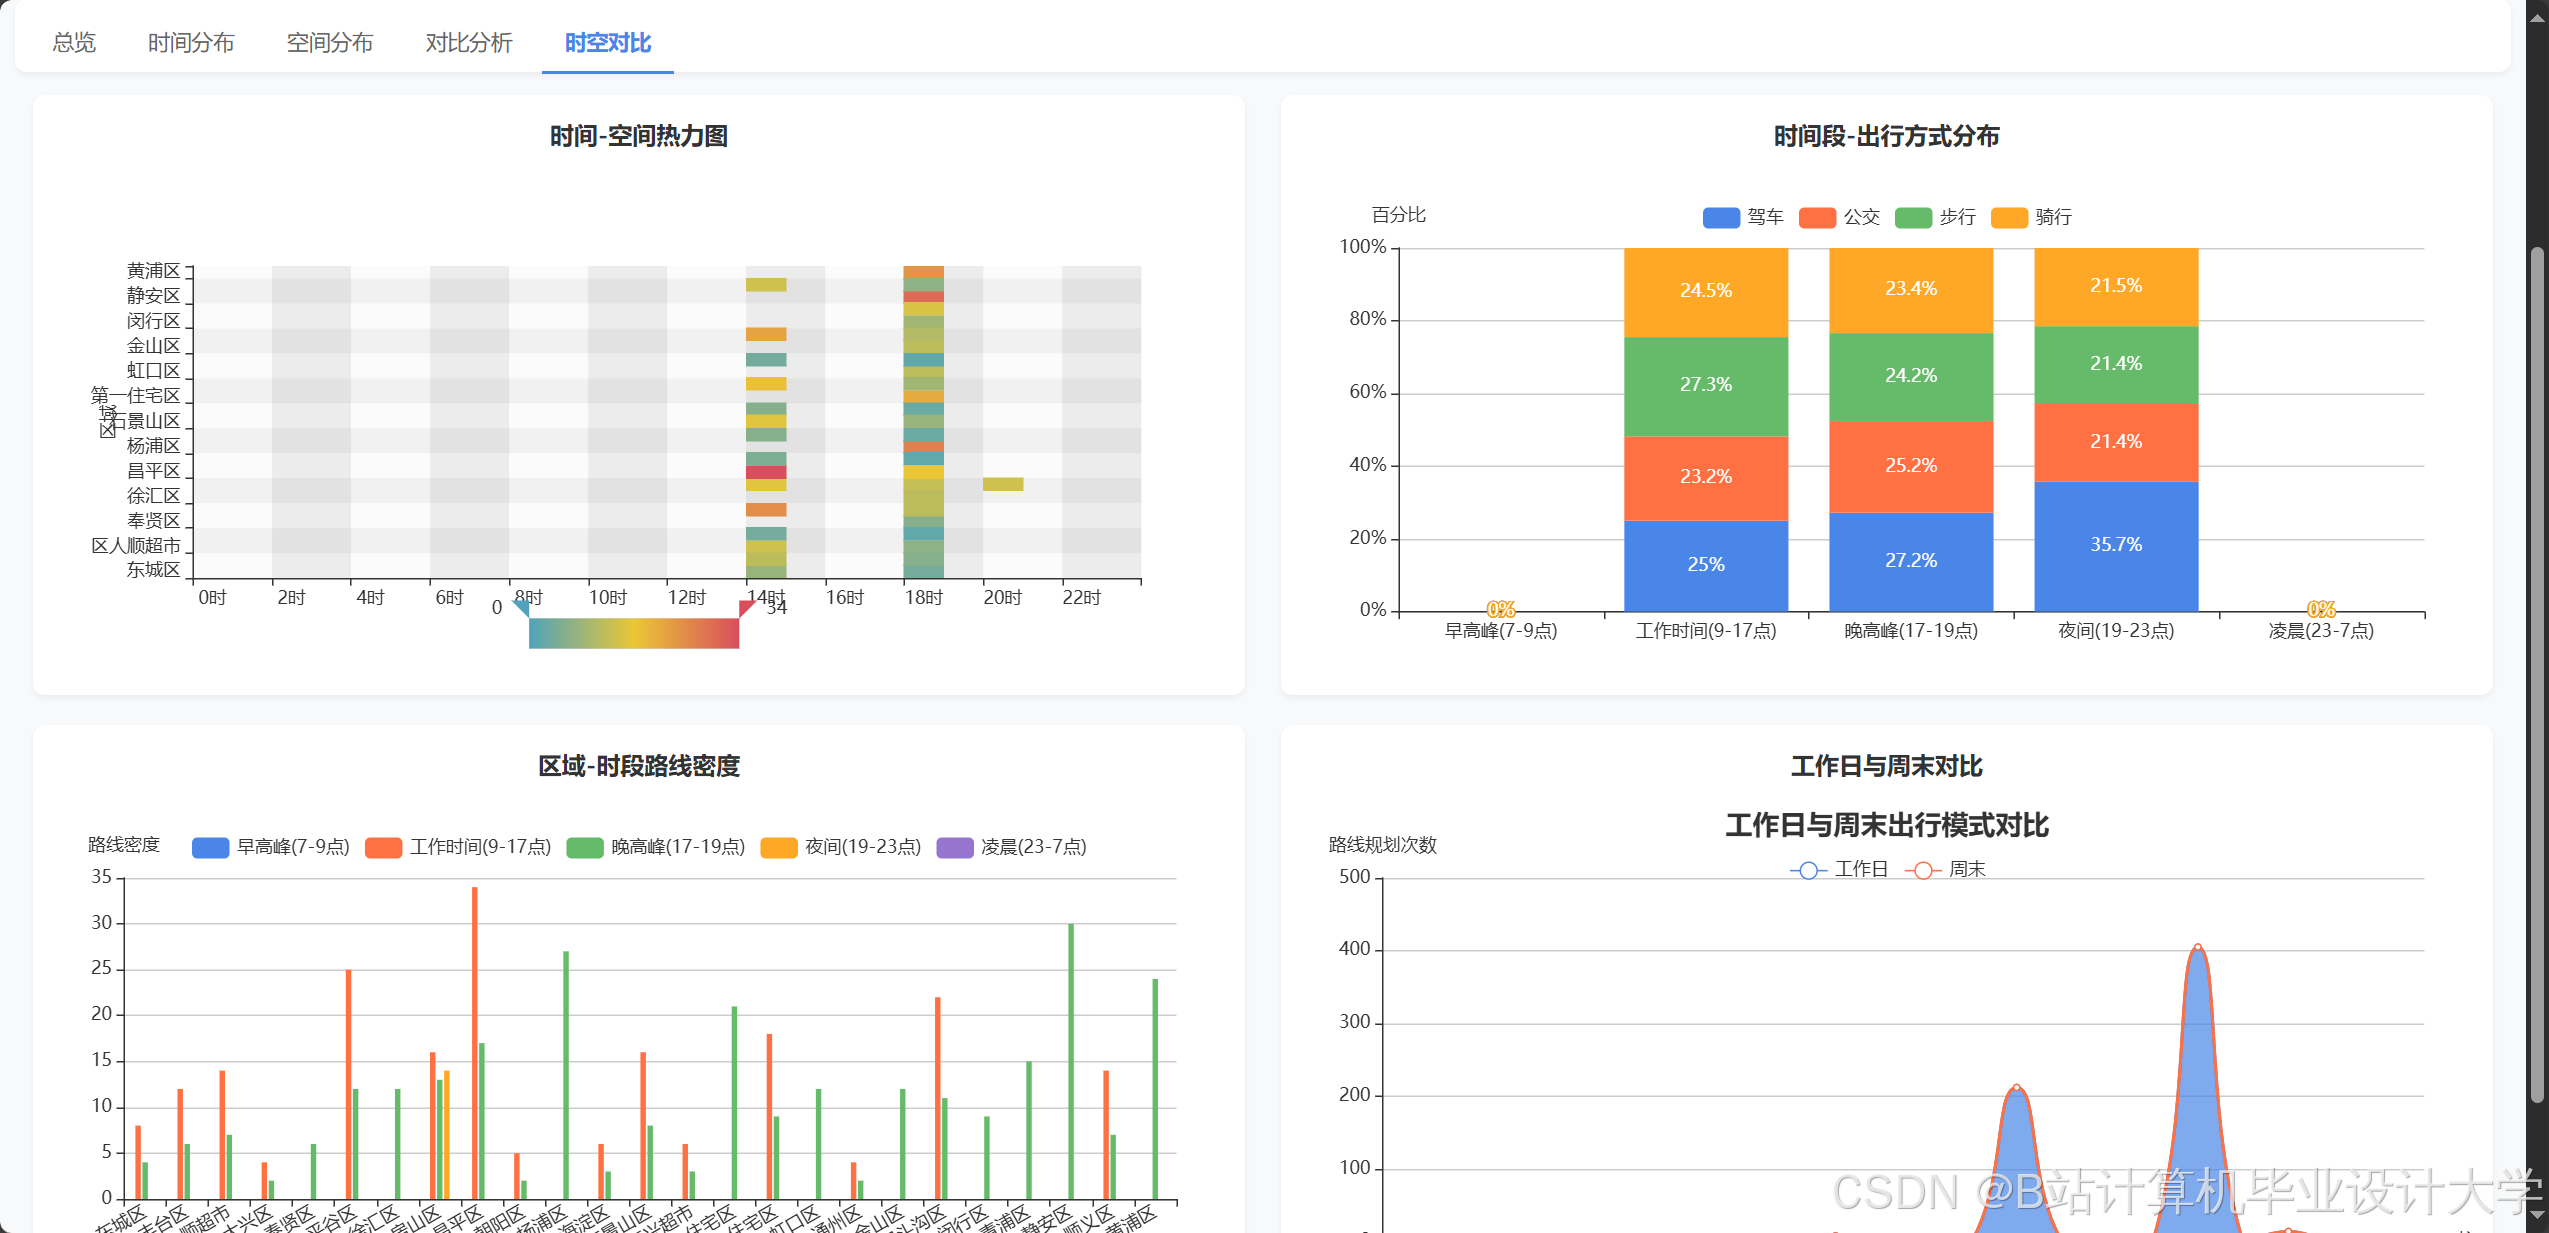
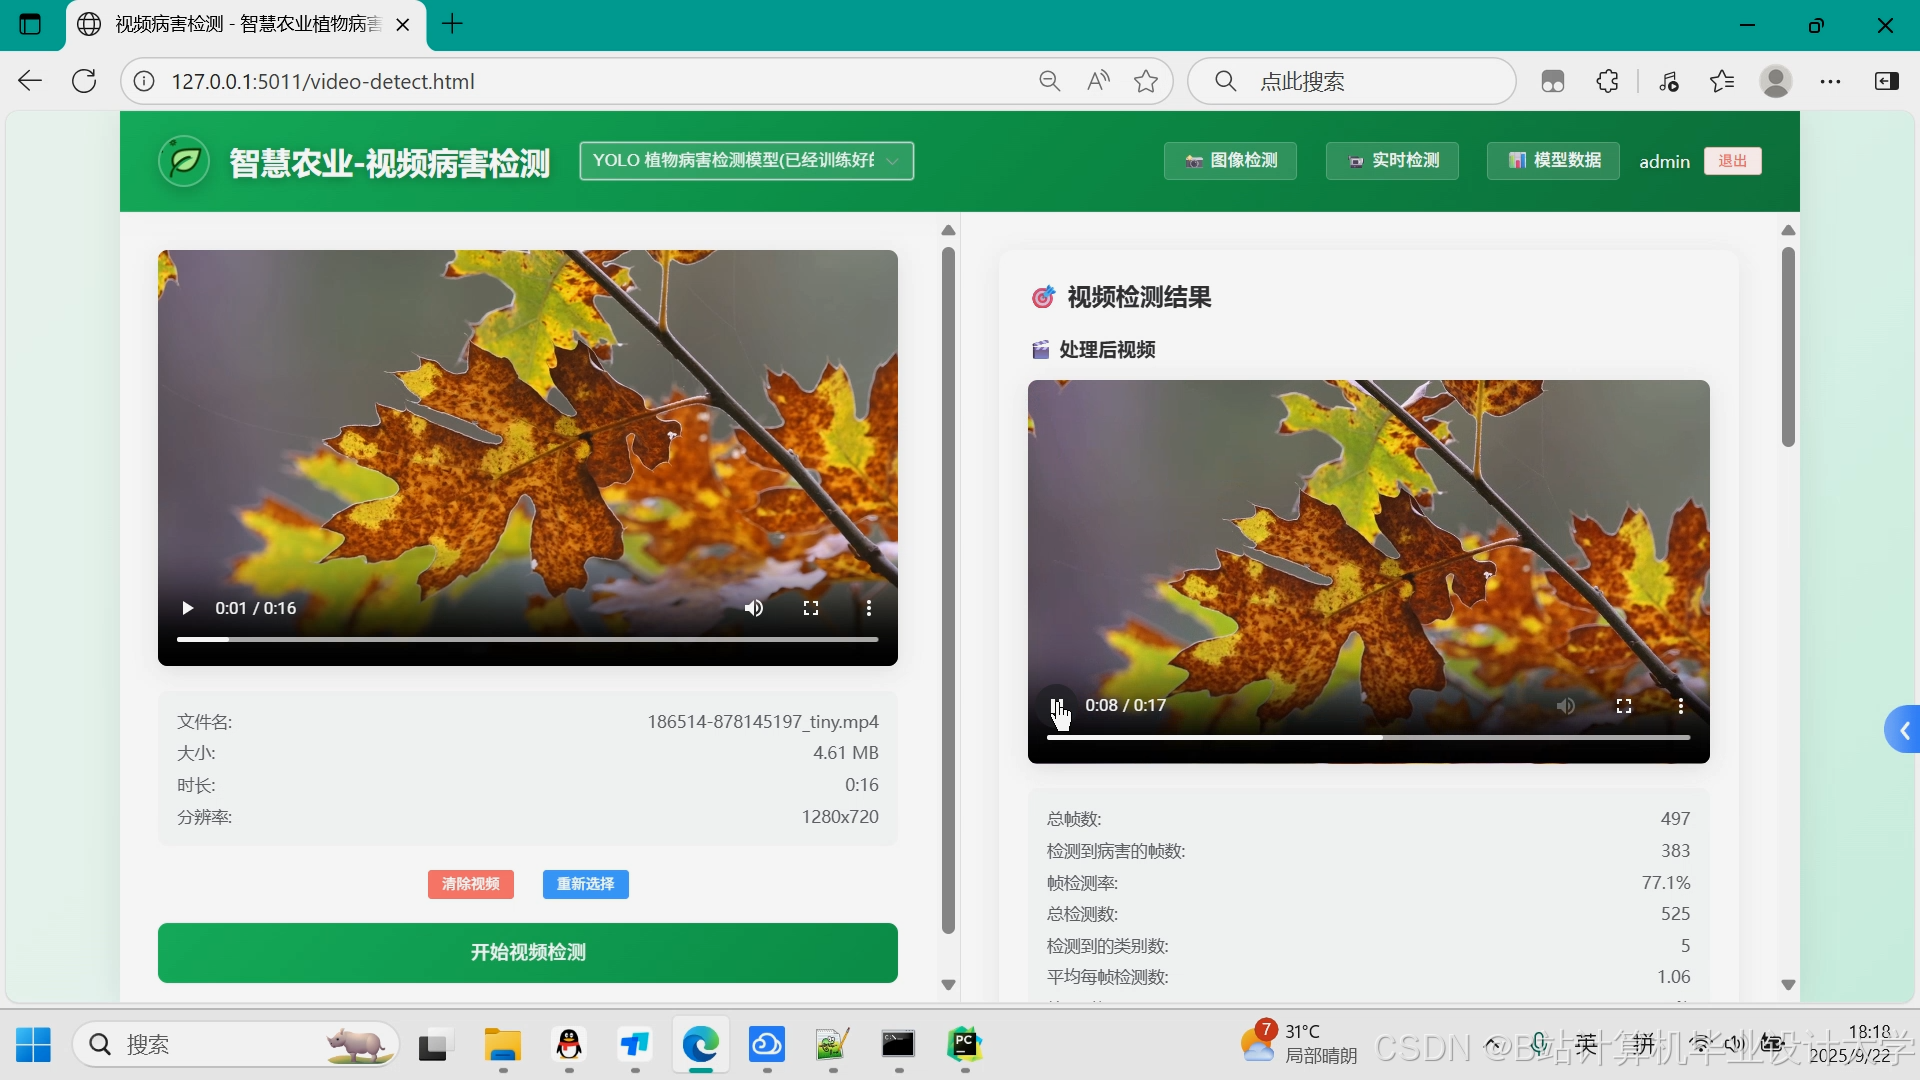
项目案例


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!

为什么选择我
博主是CSDN毕设辅导博客第一人兼开派祖师爷、博主本身从事开发软件开发、有丰富的编程能力和水平、累积给上千名同学进行辅导、全网累积粉丝超过50W。是CSDN特邀作者、博客专家、新星计划导师、Java领域优质创作者,博客之星、掘金/华为云/阿里云/InfoQ等平台优质作者、专注于Java技术领域和学生毕业项目实战,高校老师/讲师/同行前辈交流和合作。
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查↓↓↓↓↓↓获取联系方式↓↓↓↓↓↓↓↓