Python入门:Python3 数据结构全面学习教程
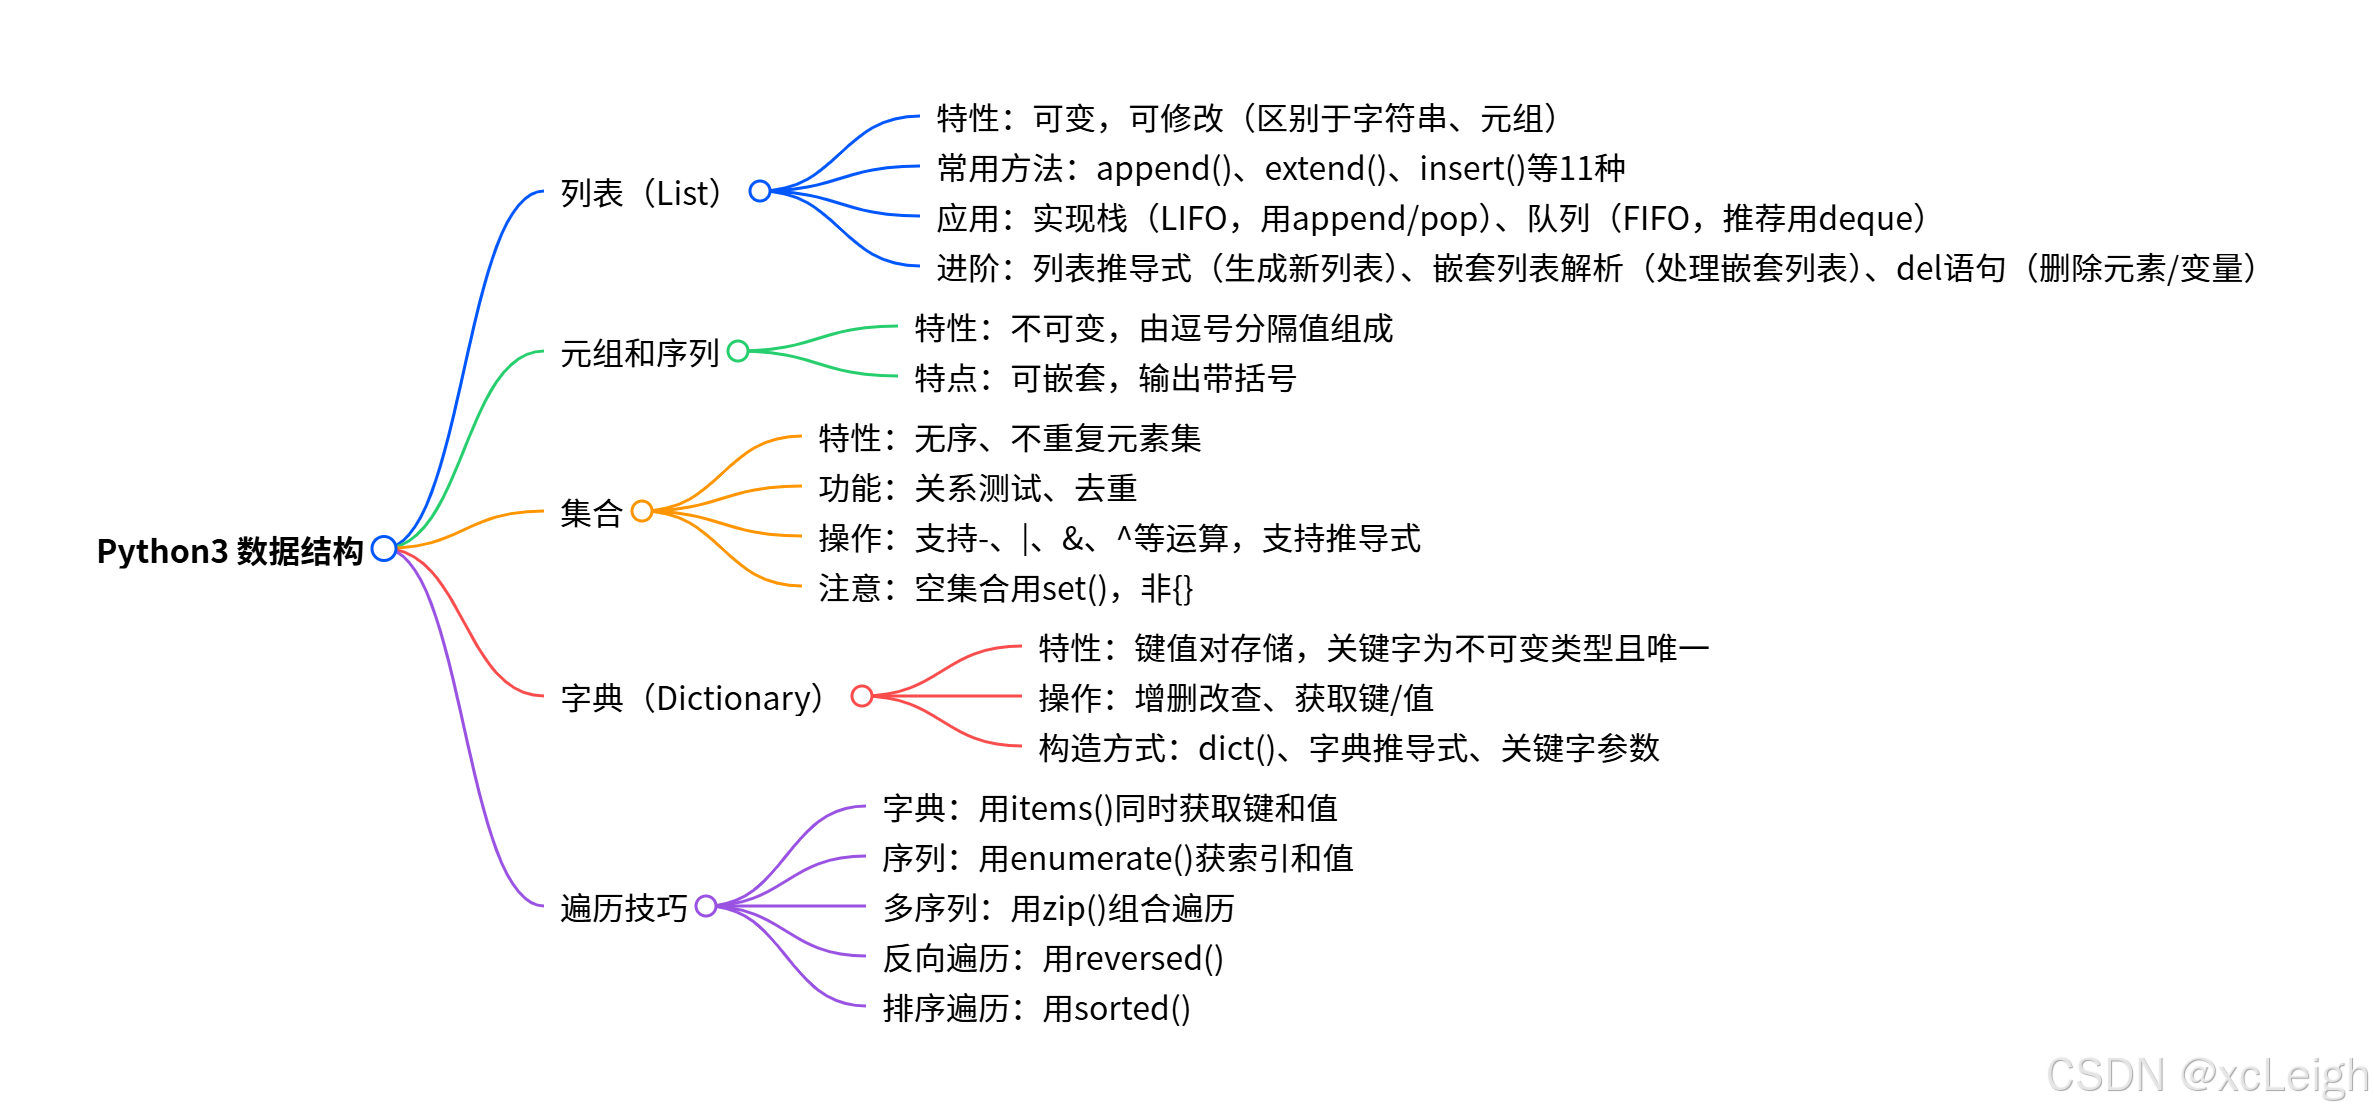
Python入门:Python3 数据结构全面学习教程,本文详细介绍Python3常用数据结构及遍历技巧。列表为可变序列,含丰富操作方法,可实现栈和队列,还可通过推导式及嵌套解析高效处理数据,del语句能删除元素或变量。元组是不可变序列,由逗号分隔值组成,可嵌套。集合为无序不重复元素集,支持关系测试和推导式。字典以键值对存储,关键字不可变且唯一,有多种构造方式。此外,还讲解了字典、序列等的遍历技巧,如用items()、enumerate()、zip()等函数,助力高效编程。
前言
Python作为一门简洁、易读、功能强大的编程语言,其基础语法是入门学习的核心。掌握好基础语法,能为后续的编程实践打下坚实的基础。本文将全面讲解Python3的基础语法知识,适合编程初学者系统学习。Python以其简洁优雅的语法和强大的通用性,成为当今最受欢迎的编程语言。本专栏旨在系统性地带你从零基础入门到精通Python核心。无论你是零基础小白还是希望进阶的专业开发者,都将通过清晰的讲解、丰富的实例和实战项目,逐步掌握语法基础、核心数据结构、函数与模块、面向对象编程、文件处理、主流库应用(如数据分析、Web开发、自动化)以及面向对象高级特性,最终具备独立开发能力和解决复杂问题的思维,高效应对数据分析、人工智能、Web应用、自动化脚本等广泛领域的实际需求。
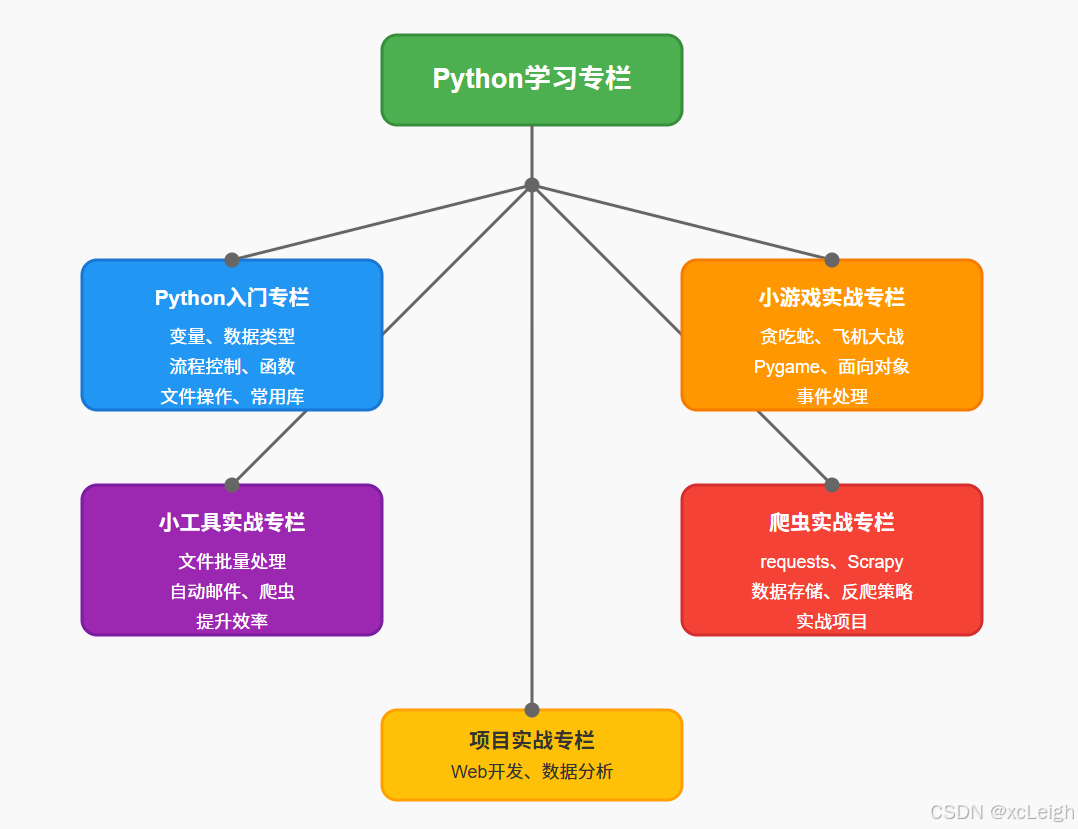
🥇 点击进入Python入门专栏,Python凭借简洁易读的语法,是零基础学习编程的理想选择。本专栏专为初学者设计,系统讲解Python核心基础:变量、数据类型、流程控制、函数、文件操作及常用库入门。通过清晰示例与实用小项目,助你快速掌握编程思维,打下坚实根基,迈出自动化办公、数据分析或Web开发的第一步。
🥇 点击进入Python小游戏实战专栏, 寓教于乐,用Python亲手打造经典小游戏!本专栏通过开发贪吃蛇、飞机大战、猜数字、简易版俄罗斯方块等趣味项目,在实践中掌握Python核心语法、面向对象编程、事件处理、图形界面(如Pygame)等关键技能,将枯燥的代码学习转化为可见的成果,让学习编程充满乐趣与成就感,快速提升实战能力。
🥇 点击进入Python小工具实战专栏,告别重复劳动,用Python打造效率神器!本专栏教你开发文件批量处理、自动邮件通知、简易爬虫、桌面提醒、密码生成器、天气查询等实用小工具。聚焦os、shutil、requests、smtplib、schedule等核心库,通过真实场景案例,快速掌握自动化脚本编写技巧,解放双手,显著提升工作与生活效率,让代码真正服务于你的日常。
🥇 点击进入Python爬虫实战专栏,解锁网络数据宝库!本专栏手把手教你使用Python核心库(如requests、BeautifulSoup、Scrapy)构建高效爬虫。从基础网页解析到动态页面抓取、数据存储(CSV/数据库)、反爬策略应对及IP代理使用,通过实战项目(如电商比价、新闻聚合、图片采集、舆情监控),掌握合法合规获取并利用网络数据的核心技能,让数据成为你的超能力。
🥇 点击进入Python项目实战专栏,告别碎片化学习,挑战真实项目!本专栏精选Web应用开发(Flask/Django)、数据分析可视化、自动化办公系统、简易爬虫框架、API接口开发等综合项目。通过需求分析、架构设计、编码实现、测试部署的全流程,深入掌握工程化开发、代码复用、调试排错与团队协作核心能力,积累高质量作品集,真正具备解决复杂问题的Python实战经验。
🌐 前篇文章咱们讲解了 Python入门:Python3 装饰器全面学习教程 ,如果忘记了,可以去重温一下,不停的重复敲击基础代码,有助于让你更加熟练掌握一门语言。今天咱们学习 Python3 数据结构全面学习教程,下面开始吧!
在 Python 编程中,数据结构是处理和组织数据的基础。掌握好各种数据结构的特性和用法,能让我们更高效地编写代码。本文将详细介绍 Python3 中常用的数据结构,包括列表、元组、集合、字典等,以及它们的操作方法和实际应用场景。
一、列表(List)
列表是 Python 中最常用的数据结构之一,它是可变的,这也是它与字符串和元组最显著的区别,即列表可以修改,而字符串和元组不能。
列表的常用方法
列表提供了丰富的方法来操作元素,如下表所示:
| list.append(x) | 把一个元素添加到列表的结尾,相当于 a[len(a):] = [x] |
| list.extend(L) | 通过添加指定列表的所有元素来扩充列表,相当于 a[len(a):] = L |
| list.insert(i, x) | 在指定位置插入一个元素。第一个参数是准备插入到其前面的那个元素的索引 |
| list.remove(x) | 删除列表中值为 x 的第一个元素。如果没有这样的元素,就会返回一个错误 |
| list.pop([i]) | 从列表的指定位置移除元素,并将其返回。如果没有指定索引,a.pop()返回最后一个元素 |
| list.clear() | 移除列表中的所有项,等于del a[:] |
| list.index(x) | 返回列表中第一个值为 x 的元素的索引。如果没有匹配的元素就会返回一个错误 |
| list.count(x) | 返回 x 在列表中出现的次数 |
| list.sort() | 对列表中的元素进行排序 |
| list.reverse() | 倒排列表中的元素 |
| list.copy() | 返回列表的浅复制,等于a[:] |
列表方法示例演示
下面通过一个实例来演示列表的大部分方法:
a = [66.25, 333, 333, 1, 1234.5]
print(a.count(333), a.count(66.25), a.count('x')) # 输出:2 1 0
a.insert(2, –1)
a.append(333)
print(a) # 输出:[66.25, 333, -1, 333, 1, 1234.5, 333]
print(a.index(333)) # 输出:1
a.remove(333)
print(a) # 输出:[66.25, -1, 333, 1, 1234.5, 333]
a.reverse()
print(a) # 输出:[333, 1234.5, 1, 333, -1, 66.25]
a.sort()
print(a) # 输出:[-1, 1, 66.25, 333, 333, 1234.5]
需要注意的是,类似 insert、remove 或 sort 等修改列表的方法没有返回值。
将列表当作栈使用
栈是一种后进先出(LIFO, Last-In-First-Out)的数据结构,意味着最后添加的元素最先被移除。在 Python 中,可以使用列表来实现栈的功能,主要用到 append() 和 pop() 方法。
栈的基本操作及实现如下:
stack = []
stack.append(1)
stack.append(2)
stack.append(3)
print(stack) # 输出: [1, 2, 3]
top_element = stack.pop()
print(top_element) # 输出: 3
print(stack) # 输出: [1, 2]
top_element = stack[–1]
print(top_element) # 输出: 2
is_empty = len(stack) == 0
print(is_empty) # 输出: False
size = len(stack)
print(size) # 输出: 2
我们还可以封装一个 Stack 类来实现栈的功能:
class Stack:
def __init__(self):
self.stack = []
def push(self, item):
self.stack.append(item)
def pop(self):
if not self.is_empty():
return self.stack.pop()
else:
raise IndexError("pop from empty stack")
def peek(self):
if not self.is_empty():
return self.stack[–1]
else:
raise IndexError("peek from empty stack")
def is_empty(self):
return len(self.stack) == 0
def size(self):
return len(self.stack)
# 使用示例
stack = Stack()
stack.push(1)
stack.push(2)
stack.push(3)
print("栈顶元素:", stack.peek()) # 输出: 栈顶元素: 3
print("栈大小:", stack.size()) # 输出: 栈大小: 3
print("弹出元素:", stack.pop()) # 输出: 弹出元素: 3
print("栈是否为空:", stack.is_empty()) # 输出: 栈是否为空: False
print("栈大小:", stack.size()) # 输出: 栈大小: 2
将列表当作队列使用
队列是一种先进先出(FIFO, First-In-First-Out)的数据结构,意味着最早添加的元素最先被移除。
使用列表直接实现队列并不是最优选择,因为在列表开头插入或删除元素的时间复杂度是 O(n)。Python 提供了 collections.deque,它是双端队列,可以在两端高效地添加和删除元素,时间复杂度为 O(1)。
使用 collections.deque 实现队列
from collections import deque
# 创建一个空队列
queue = deque()
# 向队尾添加元素
queue.append('a')
queue.append('b')
queue.append('c')
print("队列状态:", queue) # 输出: 队列状态: deque(['a', 'b', 'c'])
# 从队首移除元素
first_element = queue.popleft()
print("移除的元素:", first_element) # 输出: 移除的元素: a
print("队列状态:", queue) # 输出: 队列状态: deque(['b', 'c'])
# 查看队首元素(不移除)
front_element = queue[0]
print("队首元素:", front_element) # 输出: 队首元素: b
# 检查队列是否为空
is_empty = len(queue) == 0
print("队列是否为空:", is_empty) # 输出: 队列是否为空: False
# 获取队列大小
size = len(queue)
print("队列大小:", size) # 输出: 队列大小: 2
使用列表实现队列
虽然 deque 更高效,但也可以使用列表来实现队列:
queue = []
queue.append('a')
queue.append('b')
queue.append('c')
print("队列状态:", queue) # 输出: 队列状态: ['a', 'b', 'c']
first_element = queue.pop(0)
print("移除的元素:", first_element) # 输出: 移除的元素: a
print("队列状态:", queue) # 输出: 队列状态: ['b', 'c']
front_element = queue[0]
print("队首元素:", front_element) # 输出: 队首元素: b
is_empty = len(queue) == 0
print("队列是否为空:", is_empty) # 输出: 队列是否为空: False
size = len(queue)
print("队列大小:", size) # 输出: 队列大小: 2
也可以封装一个 Queue 类:
class Queue:
def __init__(self):
self.queue = []
def enqueue(self, item):
self.queue.append(item)
def dequeue(self):
if not self.is_empty():
return self.queue.pop(0)
else:
raise IndexError("dequeue from empty queue")
def peek(self):
if not self.is_empty():
return self.queue[0]
else:
raise IndexError("peek from empty queue")
def is_empty(self):
return len(self.queue) == 0
def size(self):
return len(self.queue)
# 使用示例
queue = Queue()
queue.enqueue('a')
queue.enqueue('b')
queue.enqueue('c')
print("队首元素:", queue.peek()) # 输出: 队首元素: a
print("队列大小:", queue.size()) # 输出: 队列大小: 3
print("移除的元素:", queue.dequeue()) # 输出: 移除的元素: a
print("队列是否为空:", queue.is_empty()) # 输出: 队列是否为空: False
print("队列大小:", queue.size()) # 输出: 队列大小: 2
列表推导式
列表推导式提供了从序列创建列表的简单途径。它的基本形式是在 for 之后跟一个表达式,然后有零到多个 for 或 if 子句,返回结果是一个根据表达式从其后的 for 和 if 上下文环境中生成出来的列表。
列表推导式示例
vec = [2, 4, 6]
print([3*x for x in vec]) # 输出: [6, 12, 18]
vec = [2, 4, 6]
print([[x, x**2] for x in vec]) # 输出: [[2, 4], [4, 16], [6, 36]]
freshfruit = [' banana', ' loganberry ', 'passion fruit ']
print([weapon.strip() for weapon in freshfruit]) # 输出: ['banana', 'loganberry', 'passion fruit']
vec = [2, 4, 6]
print([3*x for x in vec if x > 3]) # 输出: [12, 18]
print([3*x for x in vec if x < 2]) # 输出: []
vec1 = [2, 4, 6]
vec2 = [4, 3, –9]
print([x*y for x in vec1 for y in vec2]) # 输出: [8, 6, -18, 16, 12, -36, 24, 18, -54]
print([x+y for x in vec1 for y in vec2]) # 输出: [6, 5, -7, 8, 7, -5, 10, 9, -3]
print([vec1[i]*vec2[i] for i in range(len(vec1))]) # 输出: [8, 12, -54]
print([str(round(355/113, i)) for i in range(1, 6)]) # 输出: ['3.1', '3.14', '3.142', '3.1416', '3.14159']
嵌套列表解析
Python 的列表可以嵌套,通过嵌套列表解析可以对嵌套列表进行处理。
例如,将 3X4 的矩阵列表转换为 4X3 列表:
matrix = [
[1, 2, 3, 4],
[5, 6, 7, 8],
[9, 10, 11, 12],
]
print([[row[i] for row in matrix] for i in range(4)]) # 输出: [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]
也可以使用以下方法实现:
transposed = []
for i in range(4):
transposed.append([row[i] for row in matrix])
print(transposed) # 输出: [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]
或者:
transposed = []
for i in range(4):
transposed_row = []
for row in matrix:
transposed_row.append(row[i])
transposed.append(transposed_row)
print(transposed) # 输出: [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]
del 语句
使用 del 语句可以从一个列表中根据索引来删除一个元素、删除一个切割或清空整个列表,也可以删除实体变量。
a = [–1, 1, 66.25, 333, 333, 1234.5]
del a[0]
print(a) # 输出: [1, 66.25, 333, 333, 1234.5]
del a[2:4]
print(a) # 输出: [1, 66.25, 1234.5]
del a[:]
print(a) # 输出: []
del a # 删除变量 a
二、元组和序列
元组由若干逗号分隔的值组成,它是不可变的。
t = 12345, 54321, 'hello!'
print(t[0]) # 输出: 12345
print(t) # 输出: (12345, 54321, 'hello!')
# 元组可以嵌套
u = t, (1, 2, 3, 4, 5)
print(u) # 输出: ((12345, 54321, 'hello!'), (1, 2, 3, 4, 5))
元组在输出时总是有括号的,以便于正确表达嵌套结构。在输入时可能有或没有括号,不过括号通常是必须的(如果元组是更大的表达式的一部分)。
三、集合
集合是一个无序不重复元素的集,基本功能包括关系测试和消除重复元素。
可以用大括号({})创建集合。注意:如果要创建一个空集合,必须用 set() 而不是 {},后者创建一个空的字典。
集合的基本操作
basket = {'apple', 'orange', 'apple', 'pear', 'orange', 'banana'}
print(basket) # 输出: {'orange', 'banana', 'pear', 'apple'}(删除重复元素)
print('orange' in basket) # 输出: True(检测成员)
print('crabgrass' in basket) # 输出: False
a = set('abracadabra')
b = set('alacazam')
print(a) # 输出: {'a', 'r', 'b', 'c', 'd'}(a 中唯一的字母)
print(a – b) # 输出: {'r', 'd', 'b'}(在 a 中的字母,但不在 b 中)
print(a | b) # 输出: {'a', 'c', 'r', 'd', 'b', 'm', 'z', 'l'}(在 a 或 b 中的字母)
print(a & b) # 输出: {'a', 'c'}(在 a 和 b 中都有的字母)
print(a ^ b) # 输出: {'r', 'd', 'b', 'm', 'z', 'l'}(在 a 或 b 中的字母,但不同时在 a 和 b 中)
集合推导式
a = {x for x in 'abracadabra' if x not in 'abc'}
print(a) # 输出: {'r', 'd'}
四、字典(Dictionary)
字典是 Python 中另一种非常重要的数据结构,它与序列不同,序列以连续的整数为索引,而字典以关键字为索引,关键字可以是任意不可变类型,通常用字符串或数值。
字典可以看作是无序的键值对集合,在同一个字典中,关键字必须互不相同。一对大括号{}可以创建一个空字典。
字典的基本操作
# 创建并初始化字典
tel = {'jack': 4098, 'sape': 4139}
# 新增键值对
tel['guido'] = 4127
print(tel) # 输出: {'sape': 4139, 'guido': 4127, 'jack': 4098}
# 获取指定键的值
print(tel['jack']) # 输出: 4098
# 删除键值对
del tel['sape']
# 再次新增键值对
tel['irv'] = 4127
print(tel) # 输出: {'guido': 4127, 'irv': 4127, 'jack': 4098}
# 获取所有键并转为列表
print(list(tel.keys())) # 输出: ['irv', 'guido', 'jack']
# 对键进行排序
print(sorted(tel.keys())) # 输出: ['guido', 'irv', 'jack']
# 检查键是否在字典中
print('guido' in tel) # 输出: True
print('jack' not in tel) # 输出: False
字典的构造方式
print(dict([('sape', 4139), ('guido', 4127), ('jack', 4098)]))
# 输出: {'sape': 4139, 'jack': 4098, 'guido': 4127}
print({x: x**2 for x in (2, 4, 6)}) # 输出: {2: 4, 4: 16, 6: 36}
print(dict(sape=4139, guido=4127, jack=4098))
# 输出: {'sape': 4139, 'jack': 4098, 'guido': 4127}
五、遍历技巧
在处理各种数据结构时,掌握有效的遍历技巧能提高编程效率。
遍历字典
在字典中遍历时,可使用items()方法同时获取关键字和对应的值:
knights = {'gallahad': 'the pure', 'robin': 'the brave'}
for k, v in knights.items():
print(k, v)
# 输出:
# gallahad the pure
# robin the brave
遍历序列
在序列中遍历时,enumerate()函数可同时获取索引位置和对应值:
for i, v in enumerate(['tic', 'tac', 'toe']):
print(i, v)
# 输出:
# 0 tic
# 1 tac
# 2 toe
同时遍历多个序列
使用zip()函数可以组合多个序列,实现同时遍历:
questions = ['name', 'quest', 'favorite color']
answers = ['lancelot', 'the holy grail', 'blue']
for q, a in zip(questions, answers):
print('What is your {0}? It is {1}.'.format(q, a))
# 输出:
# What is your name? It is lancelot.
# What is your quest? It is the holy grail.
# What is your favorite color? It is blue.
反向遍历序列
调用reversed()函数可以反向遍历一个序列:
for i in reversed(range(1, 10, 2)):
print(i)
# 输出:
# 9
# 7
# 5
# 3
# 1
按顺序遍历序列
使用sorted()函数可返回一个已排序的序列,且不修改原序列,从而实现按顺序遍历:
basket = ['apple', 'orange', 'apple', 'pear', 'orange', 'banana']
for f in sorted(set(basket)):
print(f)
# 输出:
# apple
# banana
# orange
# pear
总结
本文详细介绍了 Python3 中常用的数据结构,包括列表、元组、集合、字典等。列表作为可变序列,提供了丰富的方法,可用于实现栈和队列;元组是不可变序列,适合存储不可修改的数据;集合能有效处理元素去重和关系测试;字典则以键值对的形式存储数据,便于快速查找。
同时,文中还介绍了各种数据结构的遍历技巧,掌握这些知识能帮助我们更灵活地处理数据,提高编程效率。希望本教程能为大家学习 Python 数据结构提供有力的帮助。
💡下一篇咱们学习 Python3 模块全面学习教程!
附录:扩展学习资源
- Python官网:https://www.python.org
- PyPI:https://pypi.org(查找第三方库)
- 安装包等相关文件(另附带pycharm工具),网盘下载地址:https://pan.quark.cn/s/649af731037c
- 学习资料视频和文档资源,网盘下载地址: https://pan.quark.cn/s/ee16901a8954
- 代码资源仓库:CSDN专属资源在线获取
- 海量Python教程:关注公众号:xcLeigh,获取网盘地址
- 一对一答疑:添加微信与博主在线沟通(备注“Python专栏”)
联系博主
xcLeigh 博主,全栈领域优质创作者,博客专家,目前,活跃在CSDN、微信公众号、小红书、知乎、掘金、快手、思否、微博、51CTO、B站、腾讯云开发者社区、阿里云开发者社区等平台,全网拥有几十万的粉丝,全网统一IP为 xcLeigh。希望通过我的分享,让大家能在喜悦的情况下收获到有用的知识。主要分享编程、开发工具、算法、技术学习心得等内容。很多读者评价他的文章简洁易懂,尤其对于一些复杂的技术话题,他能通过通俗的语言来解释,帮助初学者更好地理解。博客通常也会涉及一些实践经验,项目分享以及解决实际开发中遇到的问题。如果你是开发领域的初学者,或者在学习一些新的编程语言或框架,关注他的文章对你有很大帮助。
亲爱的朋友,无论前路如何漫长与崎岖,都请怀揣梦想的火种,因为在生活的广袤星空中,总有一颗属于你的璀璨星辰在熠熠生辉,静候你抵达。
愿你在这纷繁世间,能时常收获微小而确定的幸福,如春日微风轻拂面庞,所有的疲惫与烦恼都能被温柔以待,内心永远充盈着安宁与慰藉。
至此,文章已至尾声,而您的故事仍在续写,不知您对文中所叙有何独特见解?期待您在心中与我对话,开启思想的新交流。
💞 关注博主 🌀 带你实现畅游前后端!
🏰 大屏可视化 🌀 带你体验酷炫大屏!
💯 神秘个人简介 🌀 带你体验不一样得介绍!
🥇 从零到一学习Python 🌀 带你玩转Python技术流!
🏆 前沿应用深度测评 🌀 前沿AI产品热门应用在线等你来发掘!
💦 注:本文撰写于CSDN平台,作者:xcLeigh(所有权归作者所有) ,https://xcleigh.blog.csdn.net/,如果相关下载没有跳转,请查看这个地址,相关链接没有跳转,皆是抄袭本文,转载请备注本文原地址。
📣 亲,码字不易,动动小手,欢迎 点赞 ➕ 收藏,如 🈶 问题请留言(或者关注下方公众号,看见后第一时间回复,还有海量编程资料等你来领!),博主看见后一定及时给您答复 💌💌💌