前置知识点
1、什么是RAG
RAG全称是Retrieval-Augmented Generation(检索增强生成),让大模型(LLM)在回答问题前,先去外部知识库(如公司文档、数据库)“查资料”,再结合查到的资料生成答案的技术架构。
2、为什么需要RAG
- 解决幻觉问题: 如果大模型训练时没有喂给它某方面知识,当我们问这方面知识时候,大模型就喜欢“一本正经地胡说八道”。RAG 强制模型基于检索到的真实事实回答,大幅减少造假。
- 更新知识无需重训: 大模型训练完知识就固化了。RAG 允许你随时更新知识库(如添加新政策、新新闻),模型立刻就能学到,无需昂贵的重新训练。
- 数据隐私与安全: 企业私有数据不需要喂给大模型训练(防止泄露),只需放在本地向量库中,查询时临时调用即可。
3、向量数据库和向量模型
在 RAG(检索增强生成)架构中,向量模型(Embedding Model)和向量数据库(Vector Database)是核心基础设施。它们共同解决了大语言模型(LLM)无法直接理解“语义相似度”以及无法高效存储海量数据的问题。
简单来说:
- 向量模型是“翻译官”:把文字变成数学向量(数字列表)。
- 向量数据库是“超级图书馆”:专门用来快速查找“意思相近”的向量。
例如:
- 传统搜索(如 Ctrl+F 或 SQL LIKE)只能匹配字面。如果你搜“手机”,传统搜索找不到包含“iPhone”但没出现“手机”二字的文档。
- 向量模型经过训练,知道“手机”和“iPhone”在语义上非常接近,因此它们生成的向量在数学空间里距离非常近。
- 核心价值:实现了语义检索(Semantic Search),即“搜意思”而不是“搜字眼”。
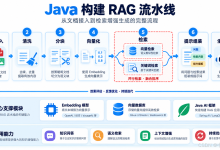
构建RAG流程
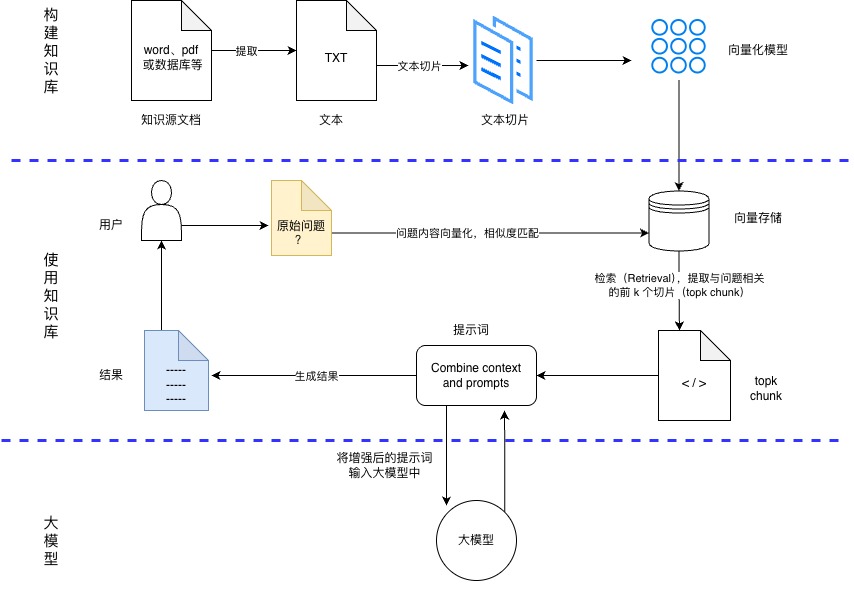
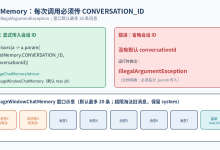
构建上下文感知检索器流程
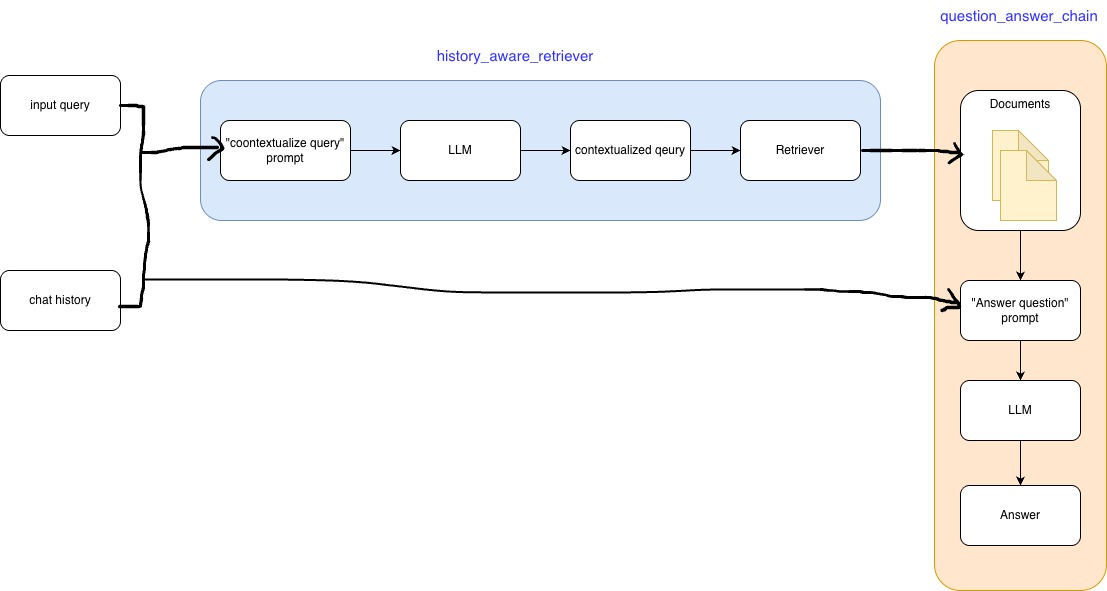
上下文感知RAG功能实现
1、安装依赖
pip install beautifulsoup4 langchain-chroma langchain-text-splitters sentence-transformers numpy
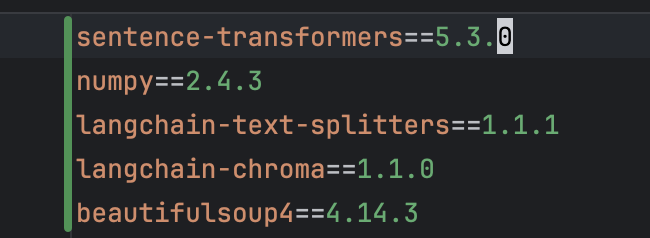
2、下载向量模型Qwen/Qwen3-Embedding-0.6B
# 在项目下,创建存放向量模型的目录
mkdir -p models/Qwen3-Embedding-0.6B
# 安装魔塔工具
pip install modelscope
# 下载向量模型
modelscope download –model Qwen/Qwen3-Embedding-0.6B –local_dir ./models/Qwen3-Embedding-0.6B
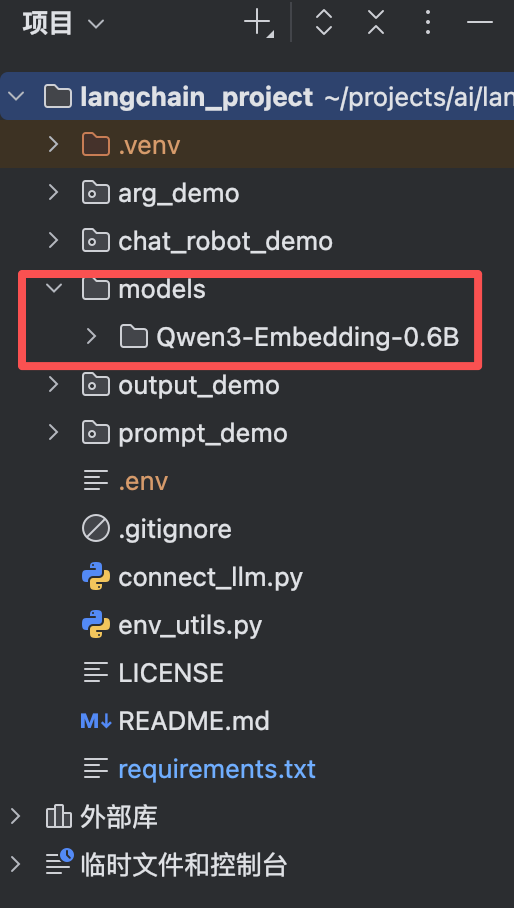
3、功能实现
基于Embeddings类,实现Qwen3-Embedding的封装
# custom_embedding.py
from typing import Any
from langchain_core.embeddings import Embeddings
from numpy import ndarray, dtype
from sentence_transformers import SentenceTransformer
class CustomQwen3Embedding(Embeddings):
def __init__(self, model_path):
self.qwen_embedding = SentenceTransformer(model_path)
def embed_query(self, text: str) -> list[float]:
return self.qwen_embedding.encode([text])[0]
def embed_documents(self, texts: list[str]) -> ndarray[tuple[Any, …], dtype[Any]]:
return self.qwen_embedding.encode(texts)
知识源我是从网上获取某篇关于 agent 智能体博客内容,向量化入库,然后再检索。
from pathlib import Path
import bs4
from langchain_chroma import Chroma
from langchain_community.document_loaders import WebBaseLoader
from langchain_core.chat_history import InMemoryChatMessageHistory
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnableWithMessageHistory, RunnableConfig
from langchain_core.output_parsers import StrOutputParser
from langchain_text_splitters import RecursiveCharacterTextSplitter
from connect_llm import qw_llm
from custom_embeding import CustomQwen3Embedding
# ================= 配置部分 =================
# 加载向量模型
local_model_path = "/Users/zhu/projects/ai/langchain_project/models/Qwen3-Embedding-0.6B"
qwen_embedding = CustomQwen3Embedding(local_model_path)
# 构建向量数据库
vector_db_path = "./chroma_db"
vector_store = Chroma(
persist_directory=vector_db_path,
embedding_function=qwen_embedding,
collection_name="t_agent_blog",
)
def create_dense_db():
"""把网络上关于agent的博客数据写入向量数据库"""
# 如果向量数据库目录存在则表示改博客内容向量数据已经存在,不再创建
db_path = Path(vector_db_path)
if db_path.exists():
print("向量数据库已存在,无需重新创建。")
return
loader = WebBaseLoader(
web_path=["https://lilianweng.github.io/posts/2023-06-23-agent/"],
bs_kwargs=dict(
parse_only=bs4.SoupStrainer(
class_=("post-content", "post-title", "post-header")
)
)
)
docs_list = loader.load()
# 切割文本
text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000, chunk_overlap=200)
docs = text_splitter.split_documents(docs_list)
print(f"切割后,文档数量为:{len(docs)}")
ids = [f"doc_{i}" for i in range(len(docs))]
vector_store.add_documents(documents=docs, ids=ids)
create_dense_db() # 如果需要重新构建数据库,取消注释
# ================= Prompt 定义 =================
# 1. 重写问题的 Prompt (用于处理多轮对话的历史上下文)
contextualize_q_system_prompt = (
"给定聊天历史和最新的用户问题(可能引用聊天历史中的上下文),"
"将其重新表述为一个独立的问题(不需要聊天历史也能理解)。"
"不要回答问题,只需在需要时重新表述问题,否则保持原样。"
)
contextualize_q_prompt = ChatPromptTemplate.from_messages(
[
("system", contextualize_q_system_prompt),
MessagesPlaceholder("chat_history"),
("human", "{input}"),
]
)
# 2. 最终回答的 Prompt (RAG 核心)
system_prompt = (
"你是一个问答任务助手。"
"使用以下检索到的上下文来回答问题。"
"如果不知道答案,就说你不知道。"
"回答最多三句话,保持简洁。"
"\\n\\n"
"{context}"
)
qa_prompt = ChatPromptTemplate.from_messages(
[
("system", system_prompt),
MessagesPlaceholder("chat_history"),
("human", "{input}"),
]
)
# ================= 构建链条 (LCEL 方式 – 纯串行稳定版) =================
# 1. 基础检索器
retriever = vector_store.as_retriever(search_kwargs={"k": 2})
# 文档格式化辅助函数
def format_docs(docs):
if not docs:
return "未找到相关上下文。"
return "\\n\\n".join(doc.page_content for doc in docs)
# — 步骤 1: 重写问题 —
# 输入: {"input": str, "chat_history": list}
# 输出: str (重写后的问题)
rewrite_step = (
contextualize_q_prompt
| qw_llm
| StrOutputParser()
)
# — 步骤 2: 构造检索所需的完整上下文 —
# 输入: {"input": str, "chat_history": list}
# 逻辑: 先运行 rewrite_step 得到新问题,同时保留原始 input 和 history
# 我们使用 RunnablePassthrough.assign() 来安全地添加新字段,而不是用并行字典
from langchain_core.runnables import RunnableLambda
def prepare_retrieval_input(data):
# data 包含: input, chat_history
# 我们需要手动调用 rewrite_step 来获取 rewritten_question
# 注意:这里必须在同步上下文中调用,或者使用 invoke
rewritten_q = rewrite_step.invoke(data)
return {
"rewritten_question": rewritten_q,
"original_input": data["input"],
"chat_history": data.get("chat_history", [])
}
# 将准备逻辑封装为一个 Runnable
prepare_step = RunnableLambda(prepare_retrieval_input)
# — 步骤 3: 执行检索并格式化 —
def retrieve_and_format(data):
docs = retriever.invoke(data["rewritten_question"])
formatted_context = format_docs(docs)
return {
"context": formatted_context,
"input": data["original_input"],
"chat_history": data["chat_history"]
}
retrieve_step = RunnableLambda(retrieve_and_format)
# — 步骤 4: 组装最终链 (纯串行) —
# 流程: 原始输入 -> 准备数据(含重写) -> 检索并格式化 -> 填充Prompt -> LLM -> 解析
rag_chain_logic = (
prepare_step # 输出: {rewritten_question, original_input, chat_history}
| retrieve_step # 输出: {context, input, chat_history}
| qa_prompt # 输出: PromptMessages
| qw_llm # 输出: AIMessage
| StrOutputParser() # 输出: str
)
# ================= 添加会话记忆包装器 =================
store = {}
def get_session_chat_history(session_id: str):
if session_id not in store:
store[session_id] = InMemoryChatMessageHistory()
return store[session_id]
conversational_rag_chain = RunnableWithMessageHistory(
rag_chain_logic,
get_session_chat_history,
input_messages_key="input",
history_messages_key="chat_history",
)
# ================= 运行测试 =================
config = RunnableConfig()
config["configurable"] = {"session_id": "user123"}
print("— 第一轮问答 —")
try:
resp1 = conversational_rag_chain.invoke(
input={"input": "What is Task Decomposition?"},
config=config
)
print(resp1)
except Exception as e:
import traceback
print(f"发生错误: {e}")
traceback.print_exc()
print("\\n— 第二轮问答 (带上下文) —")
try:
resp2 = conversational_rag_chain.invoke(
input={"input": "What are common ways of doing it?"},
config=config
)
print(resp2)
except Exception as e:
import traceback
print(f"发生错误: {e}")
traceback.print_exc()
测试
代码中,我们问了两个问题:
- What is Task Decomposition? 什么是分解任务
- What are common ways of doing it? 常见的做法有哪些
大模型回答:
/Users/zhu/projects/ai/langchain_project/.venv/bin/python /Users/zhu/projects/ai/langchain_project/arg_demo/arg.py
USER_AGENT environment variable not set, consider setting it to identify your requests.
Loading weights: 100%|██████████| 310/310 [00:00<00:00, 17184.09it/s]
向量数据库已存在数据。
— 第一轮问答 —
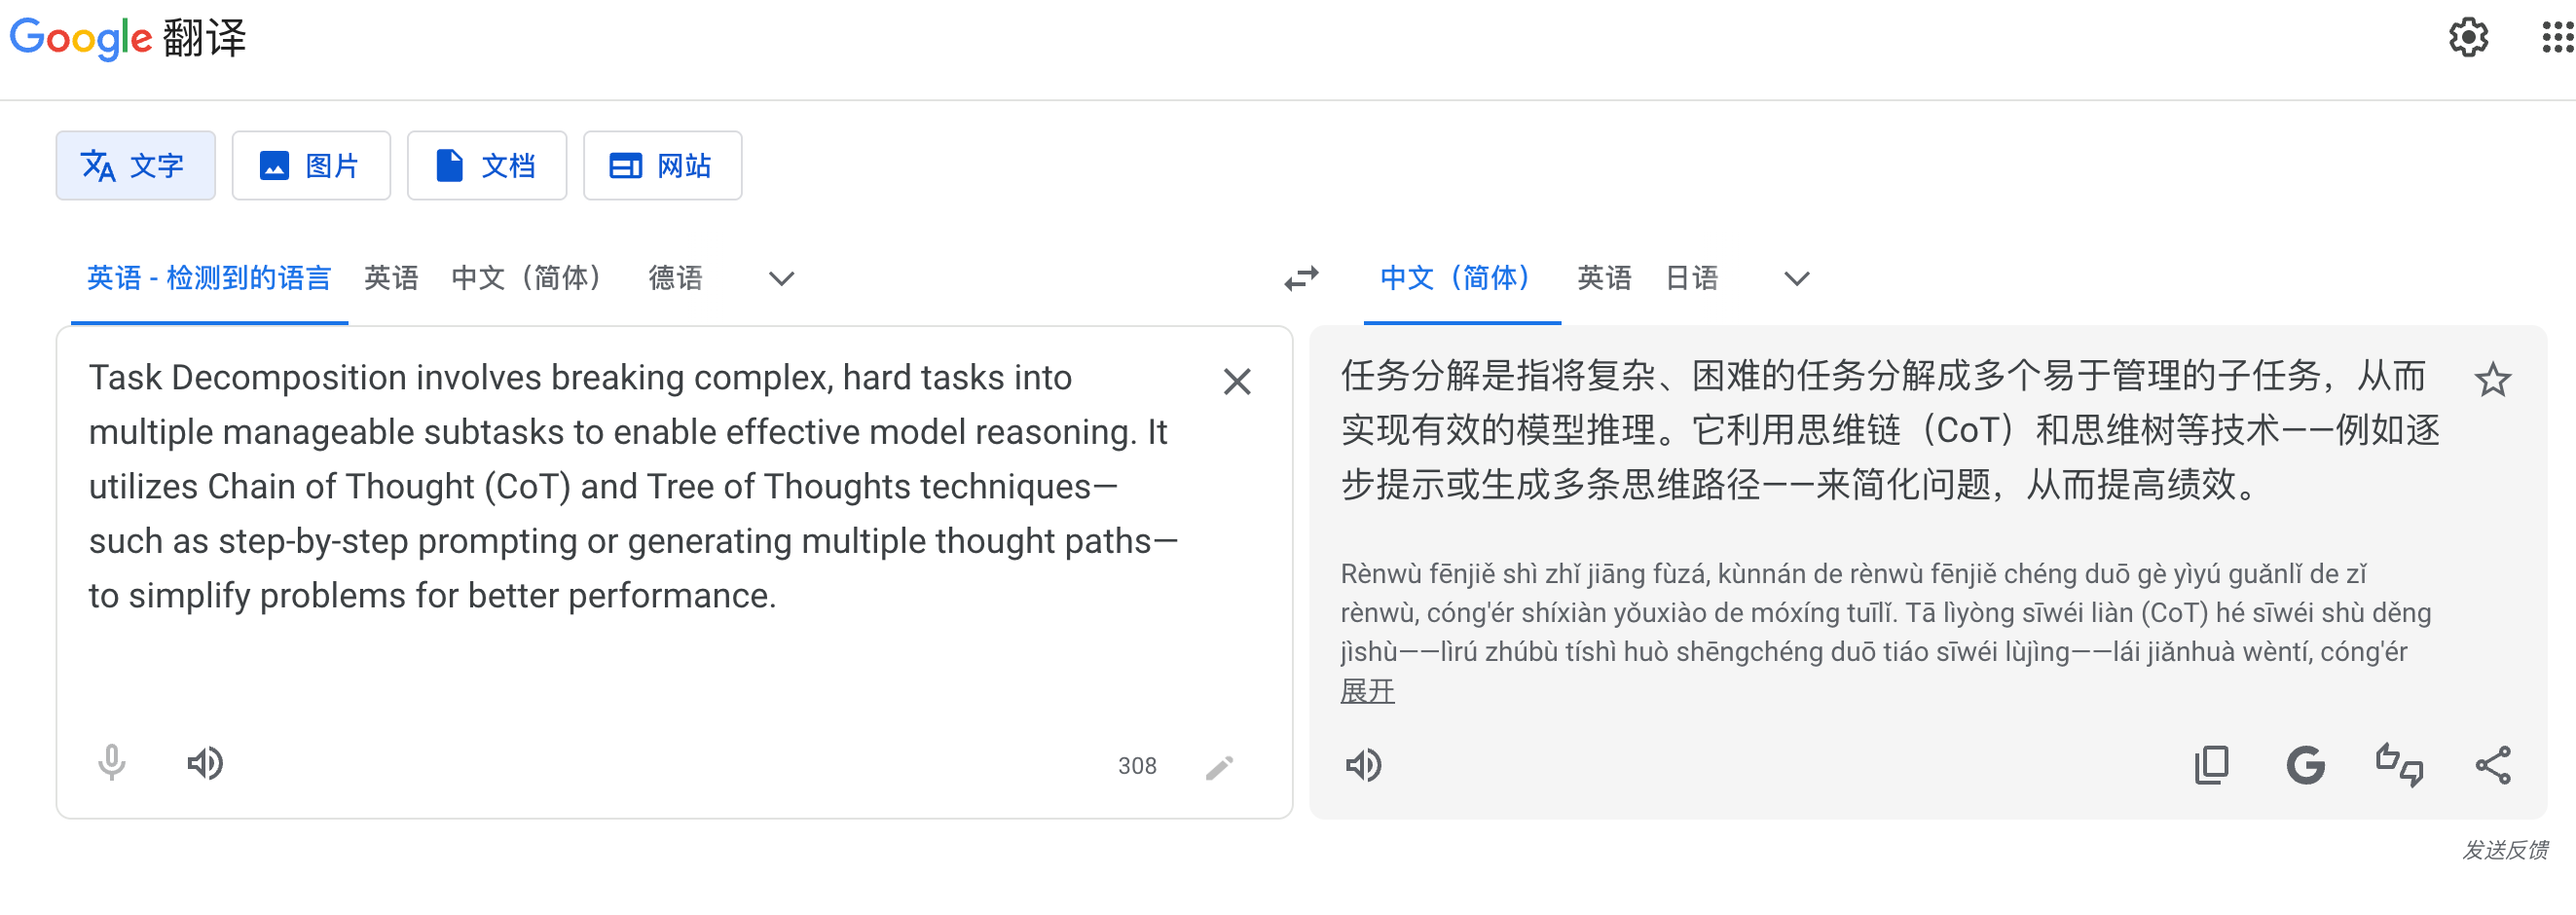
Task Decomposition involves breaking complex, hard tasks into multiple manageable subtasks to enable effective model reasoning. It utilizes Chain of Thought (CoT) and Tree of Thoughts techniques—such as step-by-step prompting or generating multiple thought paths—to simplify problems for better performance.
— 第二轮问答 (带上下文) —
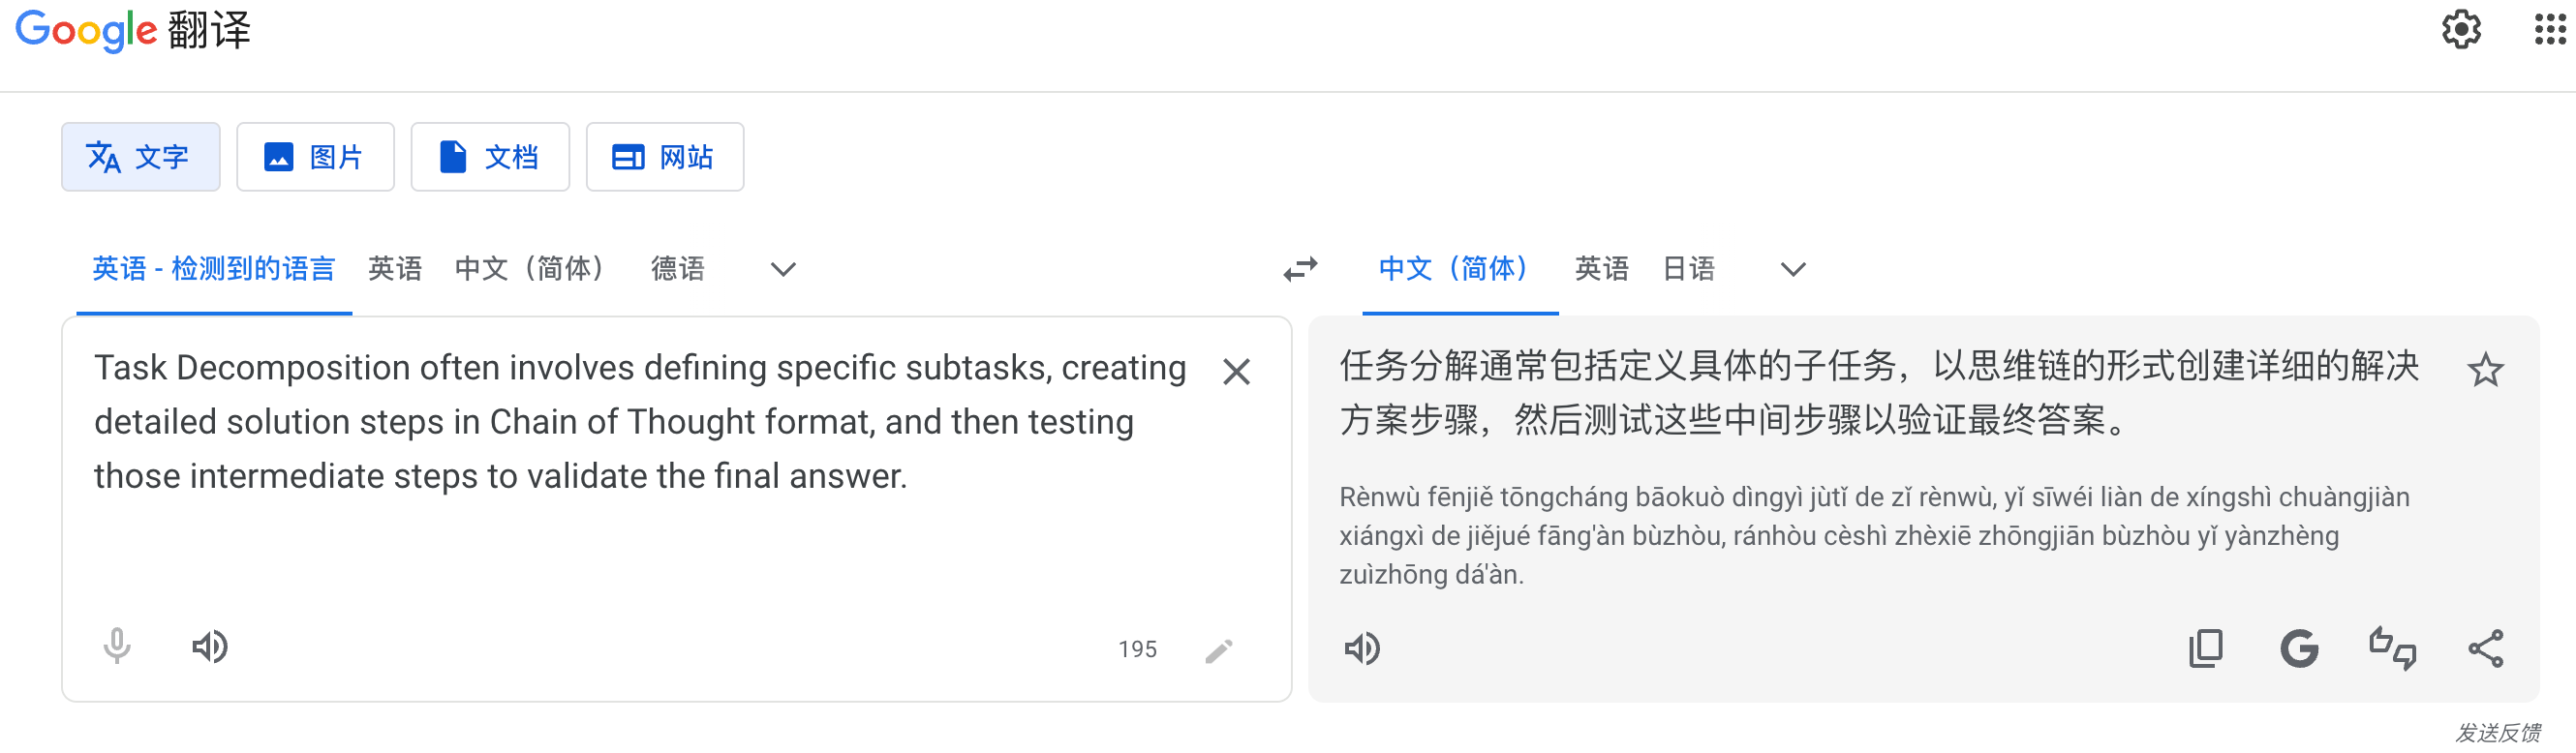
Task Decomposition often involves defining specific subtasks, creating detailed solution steps in Chain of Thought format, and then testing those intermediate steps to validate the final answer.
进程已结束,退出代码为 0
第一个问题回答翻译:
第二个问题回答翻译:
总结
我们只需把知识源换成公司内部的知识库文档即可,如 word、pdf、excel 或者数据库,读取数据–>切片–>向量化模型–>向量化数据库存储–>公司内部知识库检索–>后端基于 fastapi 或 flask 提供接口给前端–>公司内部感知上下文企业 RAG
完整项目源码:
https://github.com/Tangugo/langchain_project#
commit id: 86a4eea