论文:DiffusionDrive: Truncated Diffusion Model for End-to-End Autonomous Driving
代码:https://github.com/hustvl/DiffusionDrive
点击链接加入我们的腾讯频道:AI人工智能大模型算法频道
欢迎加入我们的QQ群:978151813 一起交流学习
摘要
近期,diffusion model作为一种强大的生成式技术,在机器人策略学习中崭露头角,能够对多模态动作分布进行建模。将其能力应用于端到端自动驾驶是一个有前景的方向。然而,机器人扩散策略中大量的去噪步骤,以及交通场景更具动态性和开放性的特点,给以实时速度生成多样化驾驶动作带来了巨大挑战。为应对这些挑战,我们提出了一种新颖的截断扩散策略,该策略引入先验多模态锚点并截断扩散调度,使模型能够从锚定的高斯分布学习去噪,映射到多模态驾驶动作分布。此外,我们设计了一种高效的级联扩散解码器,以增强与条件场景上下文的交互。所提出的模型 DiffusionDrive,在仅使用 2 步去噪的情况下,相比原始扩散策略实现了 10 倍的去噪步骤缩减,展现出更优的多样性和质量。在以规划为导向的 NAVSIM 数据集上,在统一的 ResNet-34 骨干网络下,DiffusionDrive 无需任何额外技巧即达到 88.1 PDMS,创下新纪录,同时在 NVIDIA 4090 上实现 45 FPS 的实时速度。在挑战性场景中的定性结果进一步证实,DiffusionDrive 能够稳健地生成多样化且合理的驾驶轨迹。
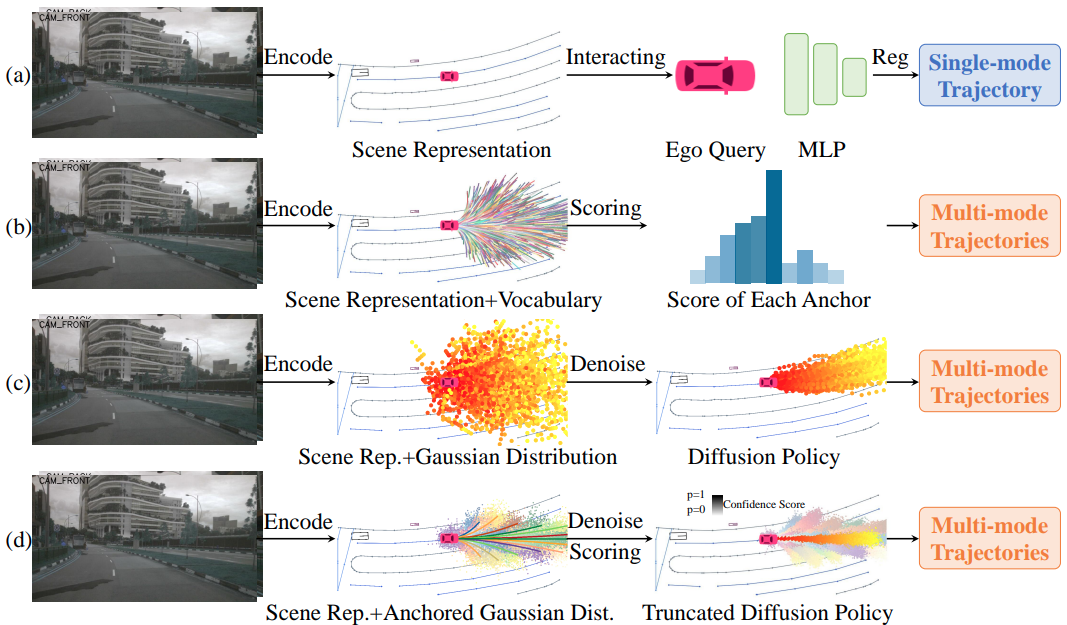
图 1. 不同端到端范式的对比 (a) 单模态回归 [7, 16, 20] (b) 基于词表采样 [3, 25] (c) 原始扩散策略 [6, 19] (d) 本文提出的截断扩散策略
1. Introduction
近年来,端到端自动驾驶因感知模型(检测 [4,17,24,42]、跟踪 [54–56]、在线建图 [27,28,32] 等)的显著进展而备受关注,其直接从原始传感器输入学习驾驶策略。这种数据驱动方法为传统基于规则的运动规划提供了可扩展且鲁棒的替代方案,而后者在复杂真实驾驶环境中往往泛化能力不足。
为有效利用数据,主流端到端规划器(如 Transfuser [7]、UniAD [16]、VAD [20])通常采用“单模态回归”范式,即通过 ego-query 回归单一轨迹(见图 1a)。然而,该范式未能考虑驾驶行为固有的不确定性与多模态特性。近期,VADv2 [20] 引入包含 4096 条 anchor 轨迹的固定大词表,将连续动作空间离散化以覆盖更广的驾驶行为,再依据预测得分从中采样(见图 1b)。但该大词表方法受 anchor 轨迹数量与质量的根本限制,常因词表外场景失效;同时,大量anchors带来的计算负担也显著制约实时性。不同于离散化动作空间,diffusion model [6] 在机器人领域已被证明是一种强大的生成式决策策略,可通过迭代去噪直接从高斯分布采样出多模态且物理可行的动作。
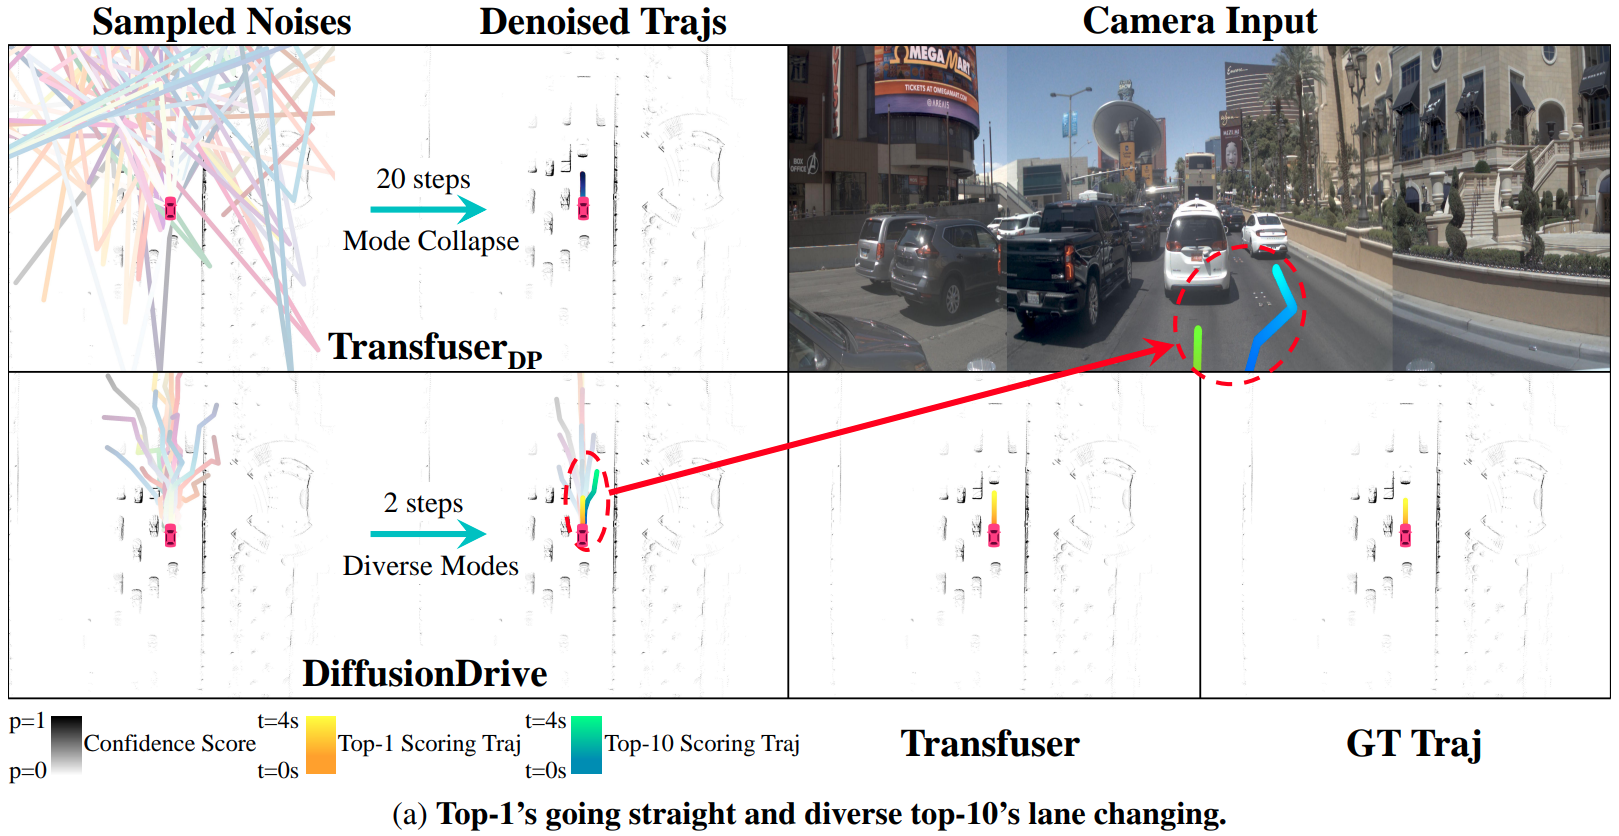
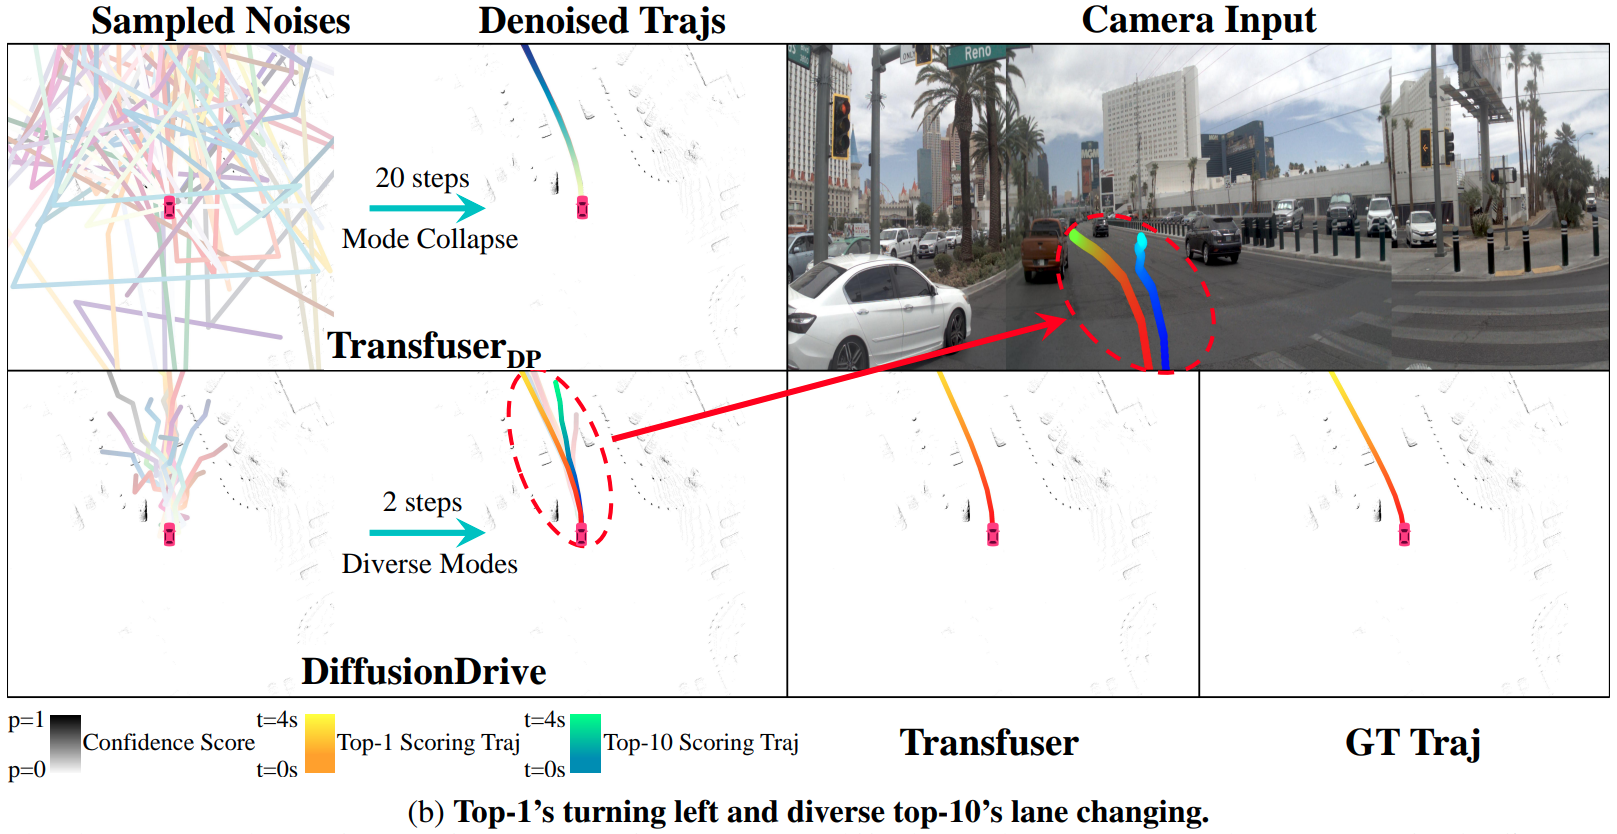
图 2. 在 NAVSIM navtest 划分挑战性场景上的定性对比:Transfuser、TransfuserDP 与 DiffusionDrive。 在相同的前视相机与激光雷达输入下,如表 2 所示,DiffusionDrive 的 Top-1 得分轨迹取得了最高的规划质量。我们在前视图中渲染了 DiffusionDrive 预测的、高亮显示的多样化轨迹。(a)(b) 两例表明,无论是直行还是左转,DiffusionDrive 的 Top-1 轨迹均与真值高度吻合;此外,其 Top-10 轨迹展现出高质量的变道能力——该能力在多模态 TransfuserDP 中未出现,而在单模态 Transfuser 中则完全不存在。
这启发我们将扩散模型在机器人领域的成功迁移至端到端自动驾驶。我们尝试将原始机器人扩散策略应用于著名的单模态回归方法 Transfuser [7],提出变体 TransfuserDP:用条件扩散模型 [34] 替换其确定性 MLP 回归头。尽管 TransfuserDP 提升了规划性能,却暴露两大问题: 1) 原始 DDIM 扩散策略需 20 步去噪,推理计算量巨大(见表 2),难以满足自动驾驶实时需求; 2) 不同高斯噪声采样出的轨迹严重重叠(见图 2),凸显在动态开放交通场景中驯服扩散模型的非平凡挑战。
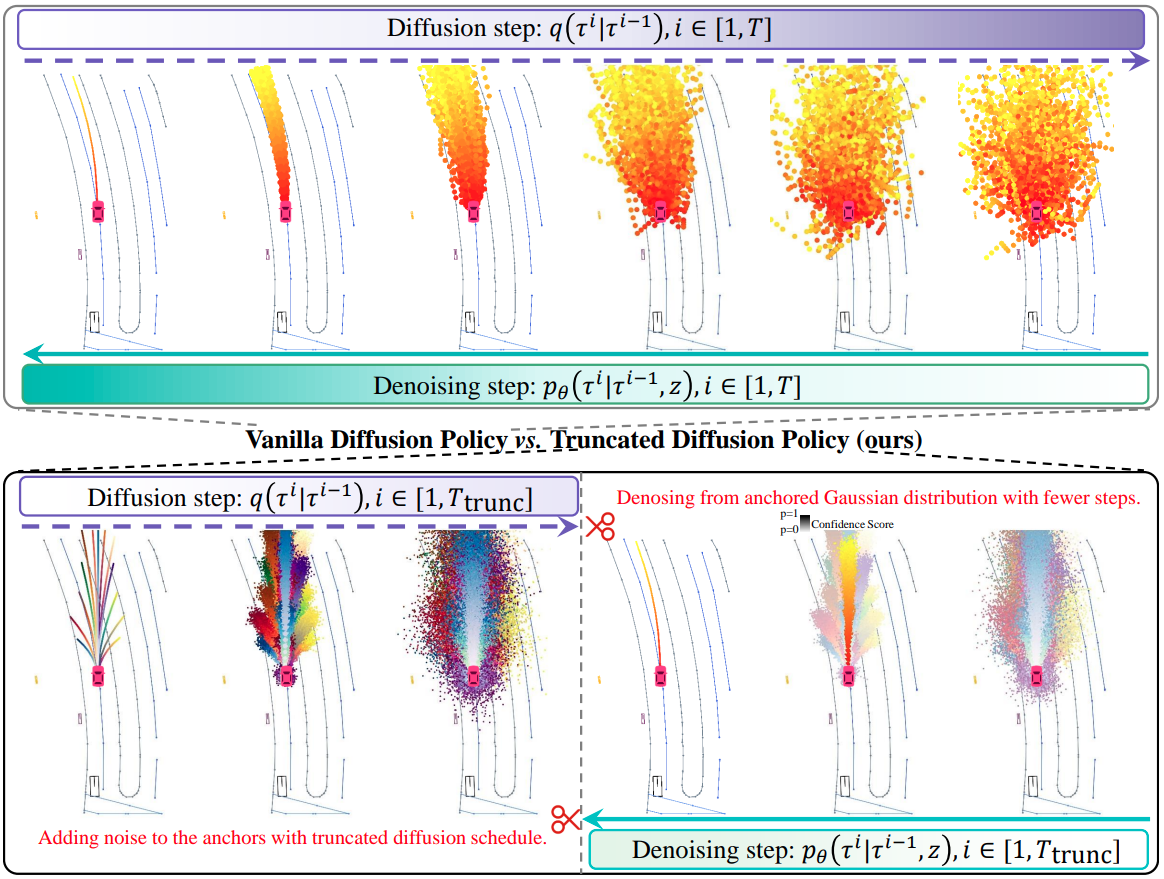
图 3. 截断扩散策略与原始扩散策略的示意图。我们截断扩散过程,仅向anchor轨迹注入少量高斯噪声,使其扩散至锚定高斯分布;随后训练扩散模型在该anchored高斯分布基础上,结合场景条件上下文重建真值轨迹。推理阶段同样截断去噪过程,从anchored高斯分布中质量更高的样本出发,而非原始的高斯噪声,从而加速生成。
与从随机高斯噪声出发的原始扩散策略不同,人类驾驶遵循既定模式,并根据实时交通动态调整。受此启发,我们将先验驾驶模式嵌入扩散策略:把高斯分布划分为以先验 anchors 为中心的多个子高斯分布,称为anchored高斯分布。具体实现上,通过截断扩散调度,仅在 anchors 周围引入少量高斯噪声(见图 3)。得益于扩散模型对多模态分布的表达能力,所提截断扩散策略无需像 VADv2 那样依赖大量固定 anchors 即可有效覆盖潜在动作空间。借助 anchored 高斯分布提供的更合理初始噪声样本,我们可截断去噪过程,将步数从 20 降至仅 2,实现数量级加速,满足实时要求。
为增强与条件场景上下文的交互,我们提出一种高效的级联扩散 decoder,基于稀疏可变形注意力机制 [62],与感知模块的结构化 queries 以及鸟瞰图(BEV)和透视图(PV)特征进行交互;并引入级联机制,在扩散 decoder 的每一步迭代中细化轨迹重建。
基于上述创新,我们提出 DiffusionDrive——面向实时端到端自动驾驶的扩散模型。在面向规划的 NAVSIM 数据集 [10] 上,我们采用非反应式仿真与闭环评测基准对方法进行评估。无需任何花哨技巧,DiffusionDrive 在统一 ResNet-34 backbone下于 NAVSIM navtest 划分取得 88.1 PDMS,显著优于既有sota方法。即便与 NAVSIM 挑战赛冠军方案 Hydra-MDP-V8192-W-EP [25] 相比,后者沿袭 VADv2 的 8192 条锚轨迹框架,并额外引入后处理与强化监督,DiffusionDrive 仍凭借直接从人类示范学习、无需后处理的推理方式,在指标上领先 1.6 PDMS,同时在 NVIDIA 4090 上保持 45 FPS 的实时速度。我们进一步在广泛使用的 nuScenes 数据集 [2] 上进行开环验证:在相同 ResNet-50 backbone下,DiffusionDrive 运行速度是 VAD 的 1.8 倍,L2 误差降低 20.8%,碰撞率降低 63.6%,展现出 sota 规划性能。
本文贡献总结如下: • 首次将扩散模型引入端到端自动驾驶领域,提出新颖的截断扩散策略,解决原始扩散策略在交通场景中出现的模态坍缩与巨大计算开销问题。 • 设计高效的级联式 Transformer 扩散解码器,与条件信息逐层交互,实现更优的轨迹重建。 • 无需任何额外技巧,DiffusionDrive 在相同 backbone 下以 88.1 PDMS 刷新 NAVSIM navtest 划分纪录,同时在 NVIDIA 4090 上维持 45 FPS 实时性能。 • 定性实验表明,DiffusionDrive 可生成更加多样且合理的轨迹,在多种挑战性场景中展现出高质量的多模态驾驶行为。
3. Method
3.1. Preliminary
Task formulation. 端到端自动驾驶以原始传感器数据为输入,预测自车未来轨迹。轨迹表示为一系列路径点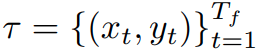 ,其中
 为规划时域,
 为当前自车坐标系下 t 时刻的路径点坐标。
Conditional diffusion model. 条件扩散模型将前向扩散过程定义为逐步向数据样本添加噪声:
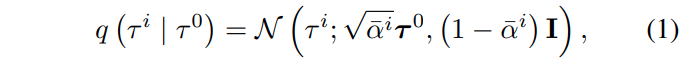
其中  为干净样本,
 为第 i 步带噪样本(上标 i 表示扩散时间步)。常数
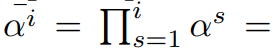 ,
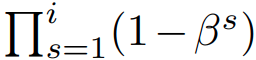 ,
 为噪声调度。我们训练反向过程模型
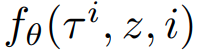 ,在条件信息 z 指导下从 预测 ,θ 为可学习参数。推理时,训练好的扩散模型
 从随机高斯噪声
 出发,在条件 z 指导下逐步去噪,最终得到预测的干净样本 :
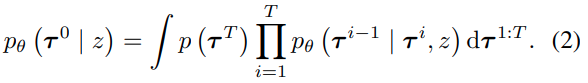
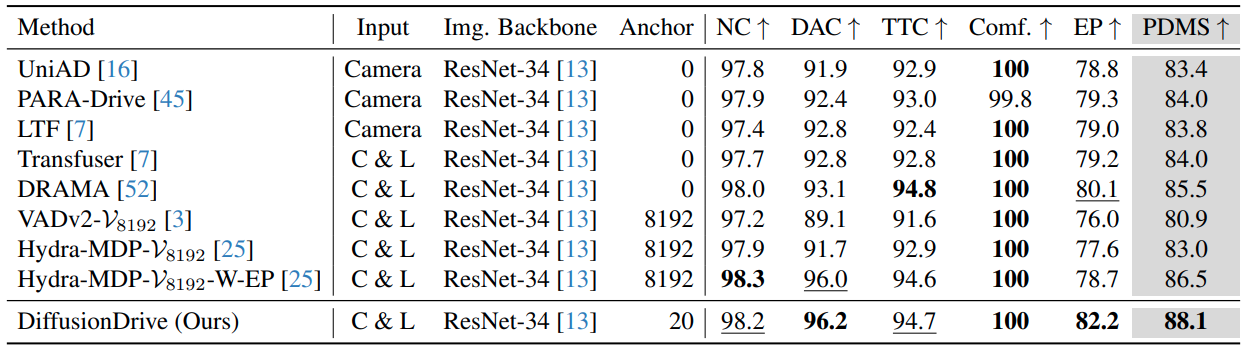
表 1. 在面向规划的 NAVSIM navtest 划分上的闭环指标对比。“C & L” 表示同时使用相机和激光雷达作为传感器输入。“V8192” 表示使用 8192 条锚轨迹。“Hydra-MDP-V8192-W-EP” 是 Hydra-MDP [25] 的一个变体,其通过基于规则的评估器提供额外监督,以拟合 EP 评估指标,并采用加权置信度后处理。DiffusionDrive 仅通过人类示范学习,推理时无需任何后处理。最优和次优结果分别用粗体和下划线标出。
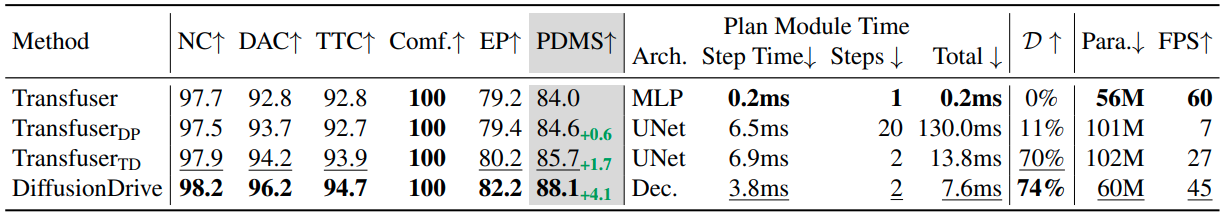
表 2. 在 NAVSIM navtest 划分上从 Transfuser 到 DiffusionDrive 的演进路径。“TransfuserDP” 表示在 Transfuser 上应用原始 DDIM 扩散策略 [6];“TransfuserTD” 表示在 Transfuser 上应用截断扩散策略。“Step Time” 为每一步去噪的运行时间。“FPS” 及运行时间均在 NVIDIA 4090 GPU 上测得。“D” 表示由公式 (3) 定义的模态多样性得分。
3.2. 调研分析
将 Transfuser [7] 改造为条件扩散模型。我们以具有代表性的确定性端到端规划器 Transfuser [7] 为起点,将其改造为生成式模型 TransfuserDP:仅用条件扩散模型 UNet 替换原有的回归 MLP 头,遵循原始扩散策略 [6]。评估时,随机采样一条噪声轨迹,并以 20 步迭代去噪。表 2 显示,TransfuserDP 在规划质量上优于确定性 Transfuser。
模态坍缩。为了进一步考察原始扩散策略在驾驶任务中的多模态特性,我们从高斯分布随机采样 20 条噪声,并以 20 步去噪。图 2 显示,不同随机噪声经去噪后收敛至几乎相同的轨迹。为定量度量该模态坍缩现象,我们定义模态多样性得分 D:基于各去噪轨迹与全部去噪轨迹并集的平均交并比(mIoU):

其中 表示第 i 条去噪后的轨迹,N 为采样轨迹总数, 为所有去噪轨迹的并集。mIoU 越高,说明去噪轨迹的多样性越低。表 2 中的模态多样性定量结果进一步印证了图 2 的观察。
去噪开销巨大。DDIM [35] 扩散策略需 20 步去噪才能将随机噪声转化为可行轨迹,计算开销显著:规划模块 FPS 从 60 降至 7(表 2),难以满足实时在线驾驶需求。
3.3. Truncated Diffusion
人类驾驶遵循既定模式,而非如原始扩散策略那样从随机噪声开始去噪。受此启发,我们提出截断扩散策略:不再从标准高斯分布,而是从 anchored 高斯分布启动去噪。为让模型学会从 anchored 高斯分布还原出期望的驾驶策略,我们在训练阶段进一步截断扩散调度,仅向 anchors 注入少量高斯噪声。
Training. 首先通过对训练集进行 K-Means 聚类,构建 anchors  其中
 。截断扩散噪声调度仅将这些anchors扩散到anchored高斯分布:

其中 为截断后的扩散步数。
训练期间,扩散 decoder 以  条带噪轨迹
 为输入,同时输出分类得分
 与去噪后的轨迹
 。

其中 z 为条件信息。我们将距离真值轨迹  最近的锚点所生成的带噪轨迹设为正样本(yk = 1),其余为负样本(yk = 0)。训练目标同时优化轨迹重建与分类:

其中 λ 用于平衡简单的 L1 重建loss Lrec 与二元交叉熵(BCE)分类loss。
Inference. 我们使用截断去噪过程,从 anchored 高斯分布采样的带噪轨迹出发,逐步去噪至最终预测。在每个去噪时间步,将前一步估计的轨迹输入扩散解码器 ,由其预测分类得分  和坐标
 。获得当前步的预测后,我们应用 DDIM [35] 更新规则采样下一时间步的轨迹。
Inference flexibility. 本方法的一个关键优势在于推理的灵活性。模型在训练时使用 N_anchor 条轨迹,但在推理过程中可以容纳任意数量的轨迹样本 N_infer,N_infer 可根据计算资源或应用需求动态调整。
图 4. DiffusionDrive 整体架构。(a) DiffusionDrive 可集成多种现有感知模块与传感器输入。(b) 所设计的扩散解码器以 anchored 高斯分布采样得到的带噪轨迹为输入,以级联方式与条件场景上下文进行强化交互,逐步去噪并生成最终预测。
3.4. 网络架构
图 4 展示了所提出方法 DiffusionDrive 的整体架构。DiffusionDrive 可兼容现有端到端规划器 [7,16,20,39] 中的多种感知模块,并支持不同传感器输入。专为复杂驾驶场景设计的扩散解码器,强化了与条件场景上下文的交互。
Diffusion decoder. 给定从anchored高斯分布采样得到的 N_infer 条带噪轨迹  ,首先利用可变形空间交叉注意力 [29,42,62],依据轨迹坐标与鸟瞰图(BEV)或透视图(PV)特征进行交互;随后,在轨迹特征与感知模块输出的 agent/map 查询之间执行交叉注意力,并接入前馈网络(FFN)。为编码扩散时间步信息,引入时间步调制层,其后接MLP预测置信度得分及相对于初始带噪轨迹坐标的偏移量。该扩散解码器层的输出作为下一级联扩散解码器层的输入DiffusionDrive 复用同一组级联扩散解码器参数,在推理阶段迭代执行去噪。最终,选择置信度最高的轨迹作为输出。
 表 3. 设计选择的消融实验。“级联解码器”表示堆叠 2 层扩散解码器。ID-1 即表 2 中的 TransfuserTD,使用条件 UNet 并与 Transfuser 原有的 ego-query 交互,后者用于直接回归单模态轨迹。

4. Experiment
4.1. Dataset
NAVSIM. NAVSIM 数据集 [10] 是一个面向规划任务的真实驾驶数据集,基于 OpenScene [9]——nuPlan [22] 的精简重发布版本,后者是目前最大的公开标注驾驶数据集。NAVSIM 使用 8 路相机实现 360° 环视,并融合 5 颗激光雷达的点云。标注频率为 2 Hz,提供 HD 地图与目标 3D 框。数据集刻意保留动态意图变化的复杂场景,剔除静止或匀速等平凡片段。 NAVSIM 采用非反应式仿真与闭环指标综合评估规划性能。本文使用其提出的 PDM 分数(PDMS)[10],该分数综合了无责碰撞(NC)、可行驶区域合规(DAC)、碰撞时间(TTC)、舒适性(Comf.)与自车进度(EP)五项子指标。
4.2. Implementation Detail
为公平对比,我们沿用与 Transfuser 相同的感知模块及 ResNet-34 backbone [13]。在扩散解码器层,仅对 BEV 特征执行空间交叉注意力,以遵循 Transfuser 的 BEV 设定;由于 Transfuser 的感知模块不包含矢量化地图构建,我们仅做 agent 交叉注意力。堆叠 2 层级联扩散解码器,截断扩散策略采用 20 个聚类锚点。训练阶段扩散调度截断为 50/1000,仅对锚点加噪;推理时仅执行 2 步去噪,并取置信度最高的轨迹作为最终输出。训练与推理流程完全对齐 Transfuser:输入为三幅裁剪并降采样的前视相机图像(拼接为 1024×256)及栅格化 BEV 激光雷达;DiffusionDrive 在 navtrain split上从头训练 100 代,使用 AdamW 优化器,8 块 NVIDIA 4090,总 batch 512,初始学习率 6×10⁻⁴;无测试时增强,navtest split输出 8 个路点,对应 4 秒规划时域。
4.3. Quantitative Comparison
表 1 在 NAVSIM navtest split上将 DiffusionDrive 与现有最先进方法进行对比。在相同的 ResNet-34 骨干网络下,DiffusionDrive 取得 88.1 PDMS,显著优于以往基于学习的方法。与 VADv2 相比,DiffusionDrive 领先 7.2 PDMS,同时把锚点数量从 8192 减至 20,缩减达 400 倍。相较沿用 VADv2“词表采样”范式的 Hydra-MDP,DiffusionDrive 再提升 5.1 PDMS。即便面对 Hydra-MDP-V8192-W-EP——该变体通过额外监督拟合 EP 评估指标并采用加权置信后处理——DiffusionDrive 仍纯靠直接模仿人类示范、无任何后处理,在 EP 子项上领先 3.5,总体 PDMS 领先 1.6。与仅替换规划模块的 Transfuser 基线相比,DiffusionDrive 在所有子指标上实现 4.1 PDMS 的显著提升。

表 7. 在 nuScenes 数据集上的开环指标对比。FPS 在单块 NVIDIA 4090 GPU 上测得,遵循 SparseDrive [39] 的测试流程;指标计算方式遵照 ST-P3 [15]。
4.4. Roadmap
由表 2 可见,将 Transfuser 升级为生成式 TransfuserDP 后,凭借原始扩散策略,PDMS 提升 0.6,模态多样性 D 提升 11%;然而规划模块开销激增:去噪步数增至 20 倍,每步耗时扩至 32 倍,总运行时间膨胀 650 倍。引入本文截断扩散策略后,TransfuserTD 把去噪步数从 20 砍到 2,PDMS 再涨 1.1,模态多样性跃升 59%。进一步融入所提扩散解码器,终版 DiffusionDrive 取得 88.1 PDMS 与 74% 模态多样性。相较 TransfuserDP,DiffusionDrive 再提 3.5 PDMS,模态多样性再增 64%,去噪步数缩减 10 倍,FPS 提升 6 倍,实现实时、高质量、多模态规划。
4.5. Ablation Study
Effect of designs in diffusion decoder. 表 3 验证了我们各项设计选择的有效性。ID-1 即表 2 中的 TransfuserTD。对比 ID-6 与 ID-1 可见,所提扩散解码器在参数量减少 39% 的同时,将规划质量显著提升 2.4 PDMS。ID-2 由于缺乏丰富且分层的环交互,性能严重退化;对比 ID-2 与 ID-3 可知,空间交叉注意力对精准规划至关重要。ID-5 表明所提级联机制有效,可进一步提升性能。
Denoising step number. 表 4 显示,得益于合理的初始分布,DiffusionDrive 即使仅执行 1 步去噪也能获得良好规划质量;增加去噪步数可在复杂场景下带来质量增益与推理灵活性。
Cascade stages. 表 5 消融了级联阶段数的影响。增加阶段数可提升规划质量,但在 4 阶段后趋于饱和,且每步参数量与推理时间随之增加。
Number of sampled noises N_infer. 如第 3.3 节所述,DiffusionDrive 可通过改变从锚定高斯分布采样的噪声数量生成多样化轨迹。表 6 表明,仅采样 10 条噪声即可取得可观规划质量;继续增加采样数可覆盖更多潜在动作空间,进一步提升规划质量。
4.6. Qualitative Comparison
由于 PDMS 规划指标仅依据 Top-1 得分轨迹计算,而我们提出的 D 指标仅评估模态多样性,二者均无法全面反映多样化轨迹的品质。为此,图 2 在 NAVSIM navtest 划分的挑战性场景中可视化了 Transfuser、TransfuserDP 与 DiffusionDrive 的规划结果。可见 DiffusionDrive 生成的多模态轨迹不仅多样,且质量优异。图 2a 中,DiffusionDrive 的 Top-1 轨迹与真值几乎重合,而高亮显示的 Top-10 轨迹竟尝试完成一次高质量变道;图 2b 中,高亮 Top-10 轨迹同样完成变道,且邻近的一条低分轨迹还与周围交通参与者交互,有效避免潜在碰撞。
4.7. Quantitative Comparison on nuScenes dataset
nuScenes 数据集曾是端到端规划的主流基准,但其主要场景多为简单、平凡的情况,因此我们仅在表 7 给出对比结果。我们遵循 SparseDrive [39] 的训练与推理配置,并在其基础上实现 DiffusionDrive,采用 ST-P3 [15] 提出的开环指标进行评估。模型堆叠 2 层级联扩散解码器,截断扩散策略使用 18 个聚类锚点。
如表 7 所示,DiffusionDrive 将 SparseDrive 的平均 L2 误差降低 0.04 m,取得最低的 L2 误差与平均碰撞率。同时,DiffusionDrive 运行高效,速度为 VAD 的 1.8 倍,L2 误差再降 20.8%,碰撞率再降 63.6%。
5. Conclusion
本文提出了一种新颖的生成式驾驶决策模型DiffusionDrive,用于端到端自动驾驶。该模型融合了所提出的截断扩散策略与高效的级联扩散解码器,能够从锚定高斯分布中对任意数量的样本进行去噪,在实时速度下生成多样化的规划轨迹。大量实验与定性对比验证了 DiffusionDrive 在规划质量、运行效率和模态多样性方面的优越性。