无论是想要学习人工智能当做主业营收,还是像我一样作为开发工程师但依然要了解这个颠覆开发的时代宠儿,都有必要了解、学习一下人工智能。
近期发现了一个巨牛的人工智能学习网站,通俗易懂,风趣幽默,入行门槛低,讲解极为丰富。
点击跳转:前言 – 人工智能教程
目录
技术演进中的抗拒与共生:从全栈工程师视角看AI焦虑
一、现象观察:当"无AI"标签成为新时代的"非预制菜"宣言
二、技术焦虑的三重根源
1、"黑箱恐惧"与控制幻觉
2、生成式AI正在消磨基础学习的热情
3、数据污染和低级错误
三、为什么说抗拒是"慢性自杀"
四、拥抱AI的破局攻略
1、提升AI交互质量
2、建立核查和批判性思维
五、结语
作者:watermelo37
涉及领域:Vue、SpingBoot、Docker、LLM、python等
———————————————————————
温柔地对待温柔的人,包容的三观就是最大的温柔。
———————————————————————
技术演进中的抗拒与共生:从全栈工程师视角看AI焦虑
一、现象观察:当"无AI"标签成为新时代的"非预制菜"宣言
前几天在B站刷到一个视频,UP主开场就特意强调:"纯人工,无AI"。这让我想起去年某餐馆老板在抖音拍桌子怒吼"我的菜都是现炒的,绝对不用预制菜"的样子——两个看似不相关的场景,背后藏着同样的技术焦虑。这种对"人工痕迹"的刻意强调,既有趣又值得深思。
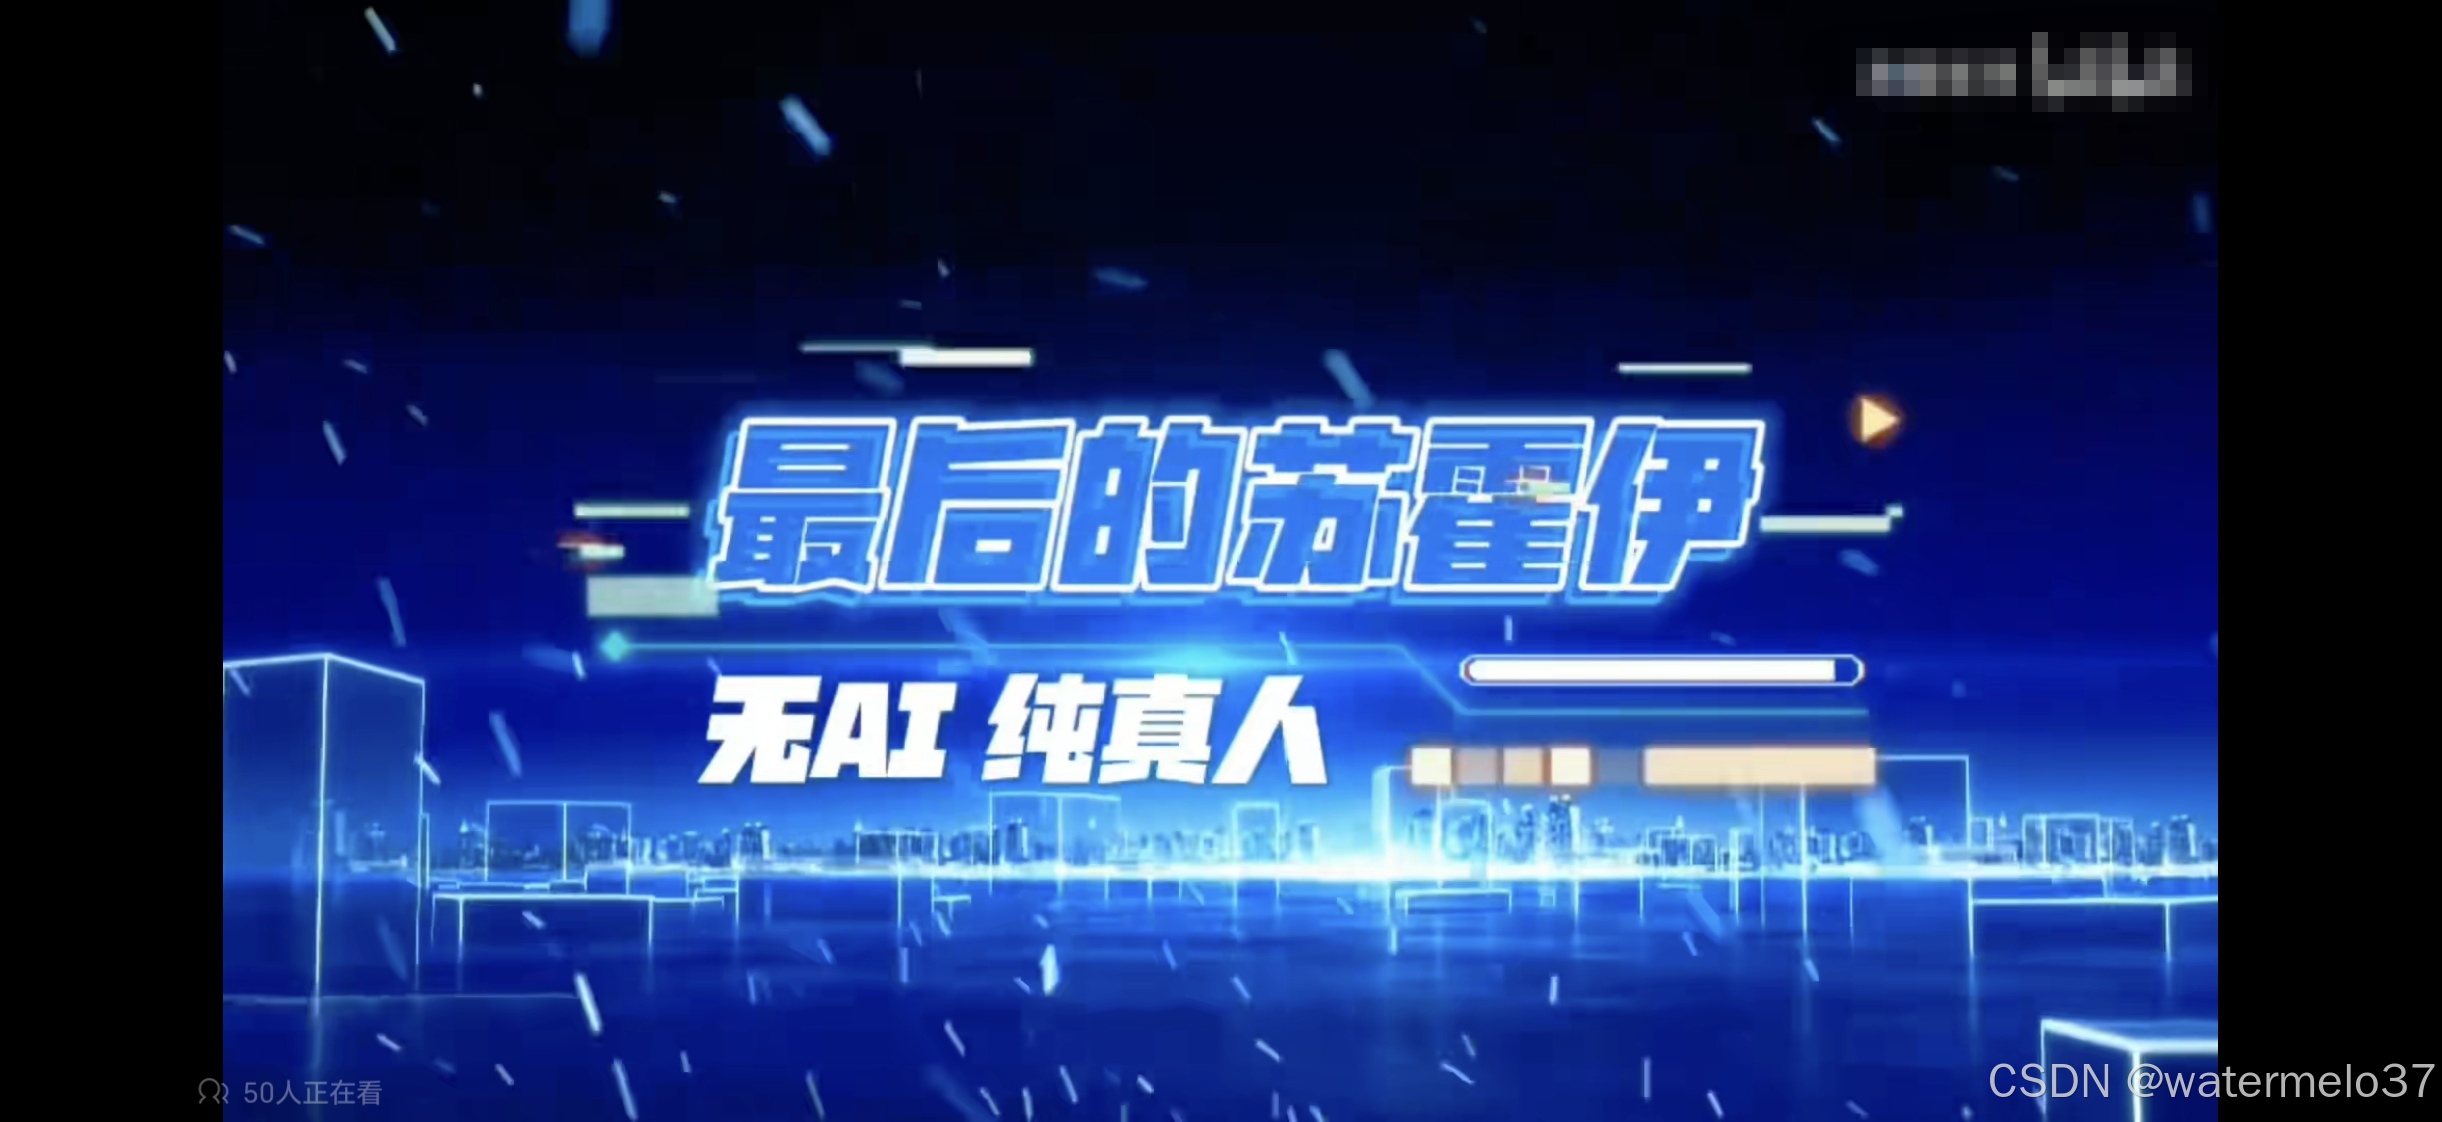
越来越多的创作者用醒目标语强调"本视频未使用AI生成";在餐饮行业,"现炒无预制菜"的招牌成为品质象征。这种现象背后,折射出公众对技术介入生产流程的复杂态度。作为全栈工程师,我们对这类现象有着双重敏感:既理解技术工具的价值,又目睹技术滥用带来的信任危机。
这种集体心理与2016年"AlphaGo击败李世石"引发的讨论如出一辙。当时围棋界对AI的抗拒主要集中在竞技公平性层面,而如今的抗拒心理已渗透到日常创作领域。用户对技术介入的隐忧开始日益加深。
二、技术焦虑的三重根源
1、"黑箱恐惧"与控制幻觉
去年测试某代码生成工具时,发现生成的Vue组件存在内存泄漏。排查发现AI把beforeDestroy钩子写成了beforeUnmount,这种低级错误暴露出两个问题:
// AI生成的Vue组件示例
export default {
data() {
return {
message: 'Hello World'
}
},
beforeDestroy() { // 错误!应为beforeUnmount
console.log('Component destroyed')
}
}
事实上,大模型使用者面对大模型的时候是彻底的面对黑箱获得产出,比较稳定的产出质量会异化掉人们的思维价值,这时遇到错误带来的问题会远比常规情况的问题破坏力更大。尤其是很多时候大模型会给出较为生僻或者少见的解决方案,在技术栈不够全面的情况下很难对大模型生成的内容进行判断——而照搬往往又是有问题的。
有的人选择无脑照搬,自己理解不了别人也理解不了,但是看起来很厉害,不是吗?
有的人选择谨慎拒绝,我都理解不了我为什么要使用?从而开始贴上“无AI”标签。
但有一点是绝对的,人们面对黑箱产出可能出错的情况无从下手,只能成为被动选择的羔羊。
2、生成式AI正在消磨基础学习的热情
读高中的时候数学老师说过一句话:“基础不牢,地动山摇。”
有次带人用AI优化SpringBoot接口,他兴奋地说:“大模型生成CRUD这样的基础内容太强了!根本就不用人来干预。”但我注意到生成的代码缺少事务管理,问他为什么不用@Transactional注解,他居然反问:"那个注解是干什么的?"
// 缺少事务管理的AI生成代码
@Service
public class UserService {
@Autowired
private UserRepository userRepository;
public void createUser(User user) {
userRepository.save(user); // 缺少@Transactional注解
}
}
是的,现在哪怕基础不牢,也能完成一定规模的开发任务,甚至运气好能解决综合性复杂问题。
越来越多的开发者在AI辅助下跳过了基础学习,就像用预制菜省去学炒菜的过程,这所带来的最大的问题就是越来越多的开发者遇到问题不知道具体该问什么,只能大段大段的复制代码,寄希望于自己写出的bug就在这一堆代码里面。
基础不牢,虚假的成绩终有一天会砸到自己身上。
3、数据污染和低级错误
大语言模型的性能与其训练数据的质量高度相关,在它眼中没有复杂绝伦的题目,也没有无人问津的冷门,它只有训练到位的数据和并未接触到的内容。
比如早期gpt3.5信誓旦旦的讲述“林黛玉倒拔垂杨柳”的故事,又或者一直纠结的“3.9和3.11哪个更大”问题。这些在人类眼中万分简单的基础知识,简单问题,却可能在大模型生成的内容中错误频出。
有学者悲观的认为,可能不远的将来我们将没有优质的数据可供训练,而不得不训练大模型生成的内容。
三、为什么说抗拒是"慢性自杀"
和预制菜不同,大模型发展到如今的阶段,绝不可能通过抵制来粗暴地规避它的问题。就像我虽然建议初学者少用AI,我刚开始教我对象入行前端的时候我甚至都不告诉她可以用AI解决很多问题,但是我自己每天都离不开AI——对于我来说只是时间问题的操作,为什么不让AI代劳呢?有难度的攻关,为什么不让AI进行资料检索和初筛呢?
与其回避AI的错误,不如花费时间在优化和提升上。
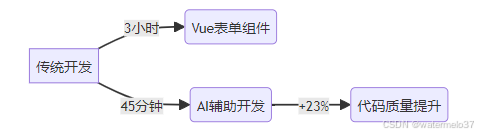
此外,要提升AI应用者的应用水准、优化能力、检错能力和思考能力。要彻底把AI当成工具使用而不是一个“砖家”,只有这样在享受AI带来的效率提升的同时,消弭AI带来的窘境。
一味的抗拒一定是慢性自杀,大模型发展的势头已经不可阻挡,Docker发展的早期也有人认为和虚拟机拉不开差距,现在呢?
四、拥抱AI的破局攻略
1、提升AI交互质量
对于日常高频次的需要,可以通过寻找高度领域聚焦的大模型、给AI设定明确的Prompt模板、人工检查生成内容、整理数据训练微雕后的专用大模型等方法来提升AI的交互质量。
此外,尽可能避免大段式的生成,这是很多初学者常做的破坏自己思维能力的错误行为。自己先拟一个框架,思考清楚业务逻辑和数据规范,在自己的框架内让AI添砖加瓦,这样所有的风险都在可控范围内,AI更像是一个勤勤恳恳的劳工而不是请来解决问题的技术专家。
这些方式可以有效的提升AI交互质量,就像给AI加装"质量过滤网",既享受效率提升,又避免翻车风险。
2、建立核查和批判性思维
每次评估AI方案时,我会问三个问题:
经过核查和批判的生成结果会可信很多,而且能做到心中有数。
五、结语
AI只能当做秘书,而不能当做leader;只能当做同门,不能当做导师;只能当做顾问,不能当做专家。当你无法理解AI,无法驾驭AI的时候,就是距离被AI控制最近的时候,与其如此,不如先“抗拒AI”,等自己有足够的能力驾驭了,再来享受AI的便利。
只有锻炼思维才能可持续地解决问题,只有思维才是真正值得学习和分享的核心要素。如果这篇博客能给您带来一点帮助,麻烦您点个赞支持一下,还可以收藏起来以备不时之需,有疑问和错误欢迎在评论区指出~
其他热门文章,请关注:
极致的灵活度满足工程美学:用Vue Flow绘制一个完美流程图
你真的会使用Vue3的onMounted钩子函数吗?Vue3中onMounted的用法详解
DeepSeek:全栈开发者视角下的AI革命者
通过array.filter()实现数组的数据筛选、数据清洗和链式调用
通过Array.sort() 实现多字段排序、排序稳定性、随机排序洗牌算法、优化排序性能
通过MongoDB Atlas 实现语义搜索与 RAG——迈向AI的搜索机制
TreeSize:免费的磁盘清理与管理神器,解决C盘爆满的燃眉之急
深入理解 JavaScript 中的 Array.find() 方法:原理、性能优势与实用案例详解
el-table实现动态数据的实时排序,一篇文章讲清楚elementui的表格排序功能
MutationObserver详解+案例——深入理解 JavaScript 中的 MutationObserver
Dockerfile全面指南:从基础到进阶,掌握容器化构建的核心工具
在线编程实现!如何在Java后端通过DockerClient操作Docker生成python环境
干货含源码!如何用Java后端操作Docker(命令行篇)




