1、工作背景需求
在日常工作中,更新工参、升级操作等,需从网管中提取最新数据,下载后再重复整理,如下表:经数据整理后,最终想要保留的是Nodeid列、usedAddress列中IP地址。
|
NodeId |
TransportId |
RouterId |
InterfaceIPv4Id |
AddressIPv4Id |
usedAddress |
|
xxxx |
1 |
Traffic_OAM |
Traffic_OAM |
Traffic_OAM |
10.10.100.100/30 |
|
xxxx |
1 |
Node_Internal_F1 |
NRDU |
1 |
10.10.100.101/30 |
2、AI工具安装与应用实例
以往需要手动制作宏工具或者在表格内编辑公式,现在借助AI工具可以实现自动化处理,可以在个人电脑中安装以下软件:
python3.12软件:稳定版本,免费下载并安装环境。
pycharm软件:个人建议安装(可选),PyCharm 是一个集成开发环境(IDE),为您提供编写、调试和管理 Python 代码的图形化界面。本人安装的是community-2025.1.2。
TRAE IDE:字节公司AI工具,当前免费下载使用,个人看重其支持用自然语言对话模式,支持代码的编写、调试、测试等,而且内置智能体,多任务处理等。
在安装好上述软件后,即完成了第一步的工作环境搭建;第二步AI工具应用:先打开TRAE IDE工具,用准备好的提示词,可以通过自然语言跟SOLO Coder聊天,期间等待其生成、测试以及工具导出;第三步结果验证:将生成的python程序,在pycharm中打开,运行即可,若结果与预期一致,则可做专题保存;否则,继续回到第二步中调试。
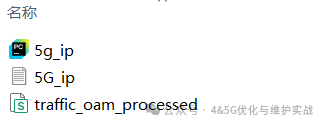
运行结果如下:可以新定义一个文件夹,每次放入新的网管ip.txt地址文件,经过pycharm运行程序后,生成的traffic_oam_processed文件内容就是想要的结果。
需要注意的是:文中的表格内信息是“隐”去敏感信息的,喂给AI部分也是如此,敏感数据不能网上“裸奔”。
3、案例代码展示
import pandas as pd
import re
def process_traffic_data(input_file, output_file='output.csv',
node_id_col=0, router_id_col=2, used_addr_col=5, chunk_size=10_000):
"""
5G流量数据处理:筛选Traffic_OAM节点并仅保留usedAddress中的IP地址
Args:
input_file: 输入TXT文件路径
output_file: 输出CSV文件路径
node_id_col: NodeId所在列索引(从0开始)
router_id_col: RouterId所在列索引(用于筛选Traffic_OAM)
used_addr_col: usedAddress所在列索引
chunk_size: 分块处理大小(大文件适用)
"""
try:
# 1. 探测文件表头信息
with open(input_file, 'r', encoding='utf-8') as f:
for _ in range(3):
f.readline() # 跳过前3行
header_line = f.readline().strip()
col_count = len(re.split(r'\\s+', header_line))
# 验证列索引是否有效
if max(node_id_col, router_id_col, used_addr_col) >= col_count:
print(f"错误:列索引超出范围(共{col_count}列,索引范围0~{col_count – 1})")
return
# 2. 分块读取与处理
reader = pd.read_csv(
input_file,
sep=r'\\s+', header=3, encoding='utf-8',
engine='python', chunksize=chunk_size
)
result_chunks = []
total_rows = 0
for chunk in reader:
# 选择需要的列:NodeId, RouterId, usedAddress
selected_cols = [node_id_col, router_id_col, used_addr_col]
chunk = chunk.iloc[:, selected_cols]
chunk.columns = ['NodeId', 'RouterId', 'usedAddress']
# 筛选Traffic_OAM记录(基于RouterId列)
mask = chunk['RouterId'].str.contains('Traffic_OAM', na=False)
filtered = chunk[mask]
if not filtered.empty:
# 提取IP地址(仅保留第一个'/'前的内容)
filtered['usedAddress'] = filtered['usedAddress'].str.split('/', n=1).str[0]
# 仅保留NodeId和处理后的IP地址
filtered = filtered[['NodeId', 'usedAddress']]
result_chunks.append(filtered)
total_rows += len(filtered)
if not result_chunks:
print("未找到包含'Traffic_OAM'的记录")
return
# 3. 合并结果并保存
result_df = pd.concat(result_chunks, ignore_index=True)
result_df.to_csv(output_file, index=False, encoding='utf-8')
print(f"处理完成!共筛选到 {total_rows} 条记录,已保存至 {output_file}")
return result_df
except FileNotFoundError:
print(f"错误:文件 '{input_file}' 未找到")
except Exception as e:
print(f"处理错误:{str(e)}")
if __name__ == "__main__":
input_path = r"E:\\pathon\\in_out\\5g_ip\\5g_ip.txt"
output_path = r"E:\\pathon\\in_out\\5g_ip\\traffic_oam_processed.csv"
# 修正参数:node_id_col=0(原始NodeId列),router_id_col=2(用于筛选)
result = process_traffic_data(input_path, output_path,
node_id_col=0, router_id_col=2, used_addr_col=5)
if result is not None:
print("\\n数据预览(仅保留NodeId和IP地址):")
print(result.head())