目录
- 2.1 张量并行(Tensor Parallelism)
- 2.2 流水线并行(Pipeline Parallelism)
- 2.3 专家并行(Expert Parallelism)
- 2.4 数据并行(Data Parallelism)
- 2.5 混合并行策略实战
- 3.1 LoRA技术原理回顾
- 3.2 vLLM中的LoRA实现架构
- 3.3 多LoRA并发推理实战
- 3.4 动态加载与卸载API
- 4.1 流式生成的技术挑战
- 4.2 vLLM流式API实现原理
- 4.3 客户端集成最佳实践
- 4.4 性能优化与延迟控制
- 5.1 AsyncLLMEngine架构剖析
- 5.2 请求调度与队列管理
- 5.3 资源隔离与优先级控制
- 6.1 配置参数调优
- 6.2 监控与可观测性
- 6.3 高可用与故障恢复
1. 引言:为什么需要高级特性?
在大模型服务化部署的实战中,简单的单GPU推理往往难以满足生产级需求。随着模型规模扩大(如Llama-3.3-70B、Qwen2.5-VL-72B)、并发请求增多、用户对响应延迟要求提高,我们需要更复杂的部署策略来平衡性能、成本与功能需求。
vLLM作为当前最热门的高吞吐量推理框架,其核心价值不仅在于PagedAttention和连续批处理,更在于为生产环境提供了一整套高级特性解决方案:
- 多GPU并行:解决大模型单卡显存不足问题,支持超大规模模型部署
- LoRA动态加载:实现个性化模型适配,支持多租户、多场景同时服务
- 流式输出:提升用户体验,实现实时交互式应用
- 异步API:提高系统吞吐量,支持高并发场景
本文将深入剖析vLLM在v0.8.x及以上版本中的高级特性实现机制,结合官方文档、源码分析与实战案例,为开发者提供从原理到部署的完整指南。
2. 多GPU并行架构深度解析
2.1 张量并行(Tensor Parallelism)
张量并行是vLLM中最基础的并行策略,它将模型权重在多个GPU间按列或按行切分,每个GPU只存储部分参数并计算部分输出。这种并行方式特别适合单个节点内的多GPU部署。
技术原理
张量并行的核心思想是将线性层
Y
=
X
W
Y = XW
Y=XW 的权重矩阵
W
W
W 按列切分:
W
=
[
W
1
,
W
2
,
⋯
,
W
n
]
W = [W_1, W_2, \\cdots, W_n]
W=[W1,W2,⋯,Wn]
其中
n
n
n 为张量并行大小(GPU数量)。前向传播时,每个GPU计算:
Y
i
=
X
W
i
Y_i = XW_i
Yi=XWi
然后通过All-Reduce操作汇总结果:
Y
=
∑
i
=
1
n
Y
i
Y = \\sum_{i=1}^{n} Y_i
Y=i=1∑nYi
vLLM实现架构
vLLM实现了Megatron-LM风格的张量并行算法,通过ColumnParallelLinear和RowParallelLinear两种并行线性层实现:
from vllm.model_executor.layers.linear import (
ColumnParallelLinear,
RowParallelLinear
)
class ParallelMLP(nn.Module):
def __init__(self, dim: int, hidden_dim: int, tp_size: int):
super().__init__()
# 列并行:权重按列切分
self.w1 = ColumnParallelLinear(
dim,
hidden_dim,
bias=False,
return_bias=False,
)
self.act = nn.GELU()
# 行并行:权重按行切分
self.w2 = RowParallelLinear(
hidden_dim,
dim,
bias=False,
input_is_parallel=True, # 输入已切分
return_bias=False,
)
def forward(self, x):
# x: [batch, seq, dim] (在所有GPU上复制)
# w1输出切分后的张量 [batch, seq, hidden_dim/tp_size]
x = self.w1(x)
x = self.act(x)
# w2通过All-Reduce恢复完整维度
x = self.w2(x)
return x
#### 部署实战
在vLLM中启用张量并行非常简单,只需设置`tensor_parallel_size`参数:
```python
from vllm import LLM
# 在4个GPU上运行70B模型
llm = LLM(
model="meta-llama/Llama-3.3-70B-Instruct",
tensor_parallel_size=4, # 使用4个GPU
gpu_memory_utilization=0.9,
)
# 或通过命令行启动API服务器
# vllm serve meta-llama/Llama-3.3-70B-Instruct \\
# –tensor-parallel-size 4 \\
# –gpu-memory-utilization 0.9
性能考量
张量并行的通信开销主要来自All-Reduce操作,其开销模型为:
T
c
o
m
m
=
α
+
β
⋅
2
(
n
−
1
)
n
⋅
M
T_{comm} = \\alpha + \\beta \\cdot \\frac{2(n-1)}{n} \\cdot M
Tcomm=α+β⋅n2(n−1)⋅M
其中:
-
α
\\alpha
α:延迟开销 -
β
\\beta
β:带宽倒数 -
n
n
n:GPU数量 -
M
M
M:通信数据量
2.2 流水线并行(Pipeline Parallelism)
当模型无法在单个节点内放下时,流水线并行将模型按层切分到多个节点,形成处理流水线。
实现原理
流水线并行将模型层序列
L
1
,
L
2
,
⋯
,
L
m
L_1, L_2, \\cdots, L_m
L1,L2,⋯,Lm 分配到
p
p
p 个GPU上:
- GPU 1:
L
1
,
L
2
,
⋯
,
L
k
1
L_1, L_2, \\cdots, L_{k_1}
L1,L2,⋯,Lk1 - GPU 2:
L
k
1
+
1
,
⋯
,
L
k
2
L_{k_1+1}, \\cdots, L_{k_2}
Lk1+1,⋯,Lk2 -
⋯
\\cdots
⋯ - GPU p:
L
k
p
−
1
+
1
,
⋯
,
L
m
L_{k_{p-1}+1}, \\cdots, L_m
Lkp−1+1,⋯,Lm
数据流以微批次(micro-batch)形式在GPU间传递,通过流水线调度隐藏通信延迟。
vLLM实现
vLLM的流水线并行目前处于测试阶段,支持在线服务场景:
# 在2个节点(各4个GPU)上部署70B模型
# 节点1:层0-15,张量并行大小4
# 节点2:层16-31,张量并行大小4
# 启动命令
# 节点1(头节点):
vllm serve meta–llama/Llama–3.3–70B–Instruct \\
––tensor–parallel–size 4 \\
––pipeline–parallel–size 2 \\
––distributed–executor–backend ray
# 节点2(工作节点):
# 通过Ray自动加入集群
通信模式
流水线并行的通信模式为点对点传输,每层的输出需要发送到下一个GPU:

2.3 专家并行(Expert Parallelism)
专家并行是专门为混合专家(Mixture of Experts,MoE)模型设计的并行策略,如DeepSeekV3、Qwen3MoE、Llama-4等。
技术原理
MoE模型包含多个专家网络(expert),每个前向传播时通过门控机制选择部分专家。专家并行将不同专家分配到不同GPU上,实现计算负载均衡。
vLLM配置
from vllm import LLM
llm = LLM(
model="deepseek-ai/DeepSeek-V3",
tensor_parallel_size=4,
enable_expert_parallel=True, # 启用专家并行
# MoE层将使用专家并行而非张量并行
)
2.4 数据并行(Data Parallelism)
数据并行复制整个模型到多个GPU集合,并行处理不同的请求批次。vLLM支持数据并行与张量并行/专家并行的组合。
配置示例
# 16个GPU:数据并行大小2,张量并行大小8
llm = LLM(
model="meta-llama/Llama-3.3-70B-Instruct",
tensor_parallel_size=8,
data_parallel_size=2, # 数据并行
)
通信拓扑
数据并行需要All-Reduce通信来同步梯度,但在推理场景中主要用于负载均衡和请求隔离。
2.5 混合并行策略实战
在实际生产环境中,往往需要组合多种并行策略。vLLM支持灵活的并行组合配置:
# 复杂部署场景:16个GPU,4个节点
# 张量并行大小4,流水线并行大小2,数据并行大小2
llm = LLM(
model="meta-llama/Llama-3.4-405B-Instruct", # 超大规模模型
tensor_parallel_size=4, # 单节点内TP
pipeline_parallel_size=2, # 跨节点PP
data_parallel_size=2, # 模型副本数
enable_expert_parallel=True, # MoE专家并行
)

3. LoRA适配器动态加载与推理
3.1 LoRA技术原理回顾
LoRA(Low-Rank Adaptation)是一种参数高效微调技术,通过低秩分解将微调参数量降低2-3个数量级。其核心公式:
W
′
=
W
+
B
A
W' = W + BA
W′=W+BA
其中:
-
W
∈
R
d
×
k
W \\in \\mathbb{R}^{d \\times k}
W∈Rd×k:原始预训练权重 -
B
∈
R
d
×
r
B \\in \\mathbb{R}^{d \\times r}
B∈Rd×r:低秩矩阵B(可训练) -
A
∈
R
r
×
k
A \\in \\mathbb{R}^{r \\times k}
A∈Rr×k:低秩矩阵A(可训练) -
r
≪
min
(
d
,
k
)
r \\ll \\min(d, k)
r≪min(d,k):低秩维度(通常4-64)
3.2 vLLM中的LoRA实现架构
vLLM通过SupportsLoRA接口为模型添加LoRA支持,实现动态适配器加载与推理。
核心组件
代码结构
from dataclasses import dataclass
from typing import Optional
@dataclass
class LoRARequest:
"""LoRA请求数据结构"""
lora_name: str # 人类可识别名称
lora_id: int # 全局唯一ID
lora_path: str # 适配器路径
class LoRALayer(nn.Module):
"""LoRA层实现"""
def __init__(self, base_layer: nn.Module, rank: int):
super().__init__()
self.base_layer = base_layer
self.lora_A = nn.Parameter(torch.zeros(base_layer.in_features, rank))
self.lora_B = nn.Parameter(torch.zeros(rank, base_layer.out_features))
def forward(self, x: torch.Tensor) –> torch.Tensor:
base_output = self.base_layer(x)
lora_output = x @ self.lora_A @ self.lora_B
return base_output + lora_output
### 3.3 多LoRA并发推理实战<a id="3.3"></a>
vLLM支持同时加载多个LoRA适配器,并在不同请求间动态切换。
#### 离线推理示例
```python
from vllm import LLM, SamplingParams
from vllm.lora.request import LoRARequest
# 初始化基础模型,启用LoRA支持
llm = LLM(
model="meta-llama/Llama-2-7b-hf",
enable_lora=True,
max_loras=4, # 最大并发LoRA数量
max_lora_rank=64, # 最大LoRA秩
)
# 下载LoRA适配器
sql_lora_path = snapshot_download(repo_id="yard1/llama-2-7b-sql-lora-test")
finance_lora_path = snapshot_download(repo_id="finance-llm/llama-2-7b-finance")
# 准备采样参数
sampling_params = SamplingParams(
temperature=0,
max_tokens=256,
stop=["[/assistant]"]
)
# 并发处理不同LoRA的请求
prompts = [
("[user] Write a SQL query to find top customers [/user] [assistant]",
LoRARequest("sql_adapter", 1, sql_lora_path)),
("[user] Analyze the quarterly financial report [/user] [assistant]",
LoRARequest("finance_adapter", 2, finance_lora_path)),
]
outputs = llm.generate(
prompts=[p[0] for p in prompts],
sampling_params=sampling_params,
lora_requests=[p[1] for p in prompts]
)
for i, output in enumerate(outputs):
print(f"LoRA {prompts[i][1].lora_name}: {output.outputs[0].text}")
#### 内存管理
vLLM采用LRU缓存策略管理LoRA权重,当超过`max_loras`限制时,自动卸载最久未使用的适配器。
<!–– 此处插入 [LoRA加载流程图] 图片 ––>

### 3.4 动态加载与卸载API<a id="3.4"></a>
vLLM服务器支持运行时动态管理LoRA适配器,适用于A/B测试、灰度发布等场景。
#### 启用动态API
```bash
# 设置环境变量启用动态LoRA管理
export VLLM_ALLOW_RUNTIME_LORA_UPDATING=True
# 启动服务器
vllm serve meta–llama/Llama–2–7b–hf \\
––enable–lora \\
––max–loras 10 \\
––lora–modules sql–lora=/path/to/sql–lora
API端点
curl -X POST http://localhost:8000/v1/load_lora_adapter \\
-H "Content-Type: application/json" \\
-d '{
"lora_name": "finance_adapter",
"lora_path": "/path/to/finance-lora"
}'
curl -X POST http://localhost:8000/v1/unload_lora_adapter \\
-H "Content-Type: application/json" \\
-d '{
"lora_name": "sql_adapter"
}'
curl http://localhost:8000/v1/lora_adapters
生产实践
在企业级部署中,动态LoRA管理可实现:
- 多租户隔离:不同客户使用不同适配器
- 版本灰度:逐步发布新版本LoRA
- 热更新:无需重启服务更新模型能力
4. 流式输出与实时API设计
4.1 流式生成的技术挑战
传统批处理推理需要等待整个序列生成完成后才返回结果,导致首Token延迟(TTFT)高,用户体验差。流式输出需要解决:
4.2 vLLM流式API实现原理
vLLM通过异步生成器(AsyncGenerator)实现流式输出,支持OpenAI兼容的Server-Sent Events(SSE)协议。
核心机制
代码实现
import asyncio
from vllm import AsyncLLM, SamplingParams
from vllm.sampling_params import RequestOutputKind
async def stream_generation_example():
# 初始化异步引擎
engine = AsyncLLM.from_engine_args(
model="meta-llama/Llama-3.2-1B-Instruct",
enforce_eager=True,
)
# 配置流式采样参数
sampling_params = SamplingParams(
max_tokens=100,
temperature=0.8,
top_p=0.95,
output_kind=RequestOutputKind.DELTA, # 增量输出模式
)
prompt = "The future of artificial intelligence is"
request_id = "stream-req-001"
print(f"Prompt: {prompt}")
print("Response: ", end="", flush=True)
# 流式生成
async for output in engine.generate(
request_id=request_id,
prompt=prompt,
sampling_params=sampling_params
):
for completion in output.outputs:
new_text = completion.text
if new_text:
print(new_text, end="", flush=True)
if output.finished:
print("\\nGeneration complete!")
break
# 运行示例
asyncio.run(stream_generation_example())
### 4.3 客户端集成最佳实践<a id="4.3"></a>
#### Python客户端
```python
import openai
# 配置vLLM服务器端点
client = openai.OpenAI(
base_url="http://localhost:8000/v1",
api_key="none" # vLLM不需要API密钥
)
# 发起流式请求
stream = client.chat.completions.create(
model="qwen-7b-chat",
messages=[{"role": "user", "content": "请解释相对论的基本原理"}],
stream=True, # 启用流式输出
temperature=0.7,
max_tokens=500,
)
# 实时处理响应
for chunk in stream:
if chunk.choices[0].delta.content:
print(chunk.choices[0].delta.content, end="", flush=True)
#### Web前端集成
```javascript
// 使用EventSource接收服务器推送
const eventSource = new EventSource(
'http://localhost:8000/v1/chat/completions?stream=true'
);
eventSource.onmessage = (event) => {
const data = JSON.parse(event.data);
if (data.choices && data.choices[0].delta.content) {
// 实时显示到页面
document.getElementById('output').innerHTML +=
data.choices[0].delta.content;
}
if (data.choices && data.choices[0].finish_reason) {
eventSource.close();
console.log('Generation finished');
}
};
// 发送请求
eventSource.onopen = () => {
fetch('http://localhost:8000/v1/chat/completions', {
method: 'POST',
headers: { 'Content-Type': 'application/json' },
body: JSON.stringify({
model: 'qwen-7b-chat',
messages: [{ role: 'user', content: 'Hello' }],
stream: true
})
});
};
### 4.4 性能优化与延迟控制<a id="4.4"></a>
流式输出的性能关键指标:
1. **首Token延迟(TTFT)**:从请求到第一个Token的时间
2. **Token生成速率**:每秒生成的Token数
3. **内存占用**:KV缓存与模型权重的内存使用
#### 优化策略
```python
from vllm import AsyncEngineArgs
# 优化配置示例
engine_args = AsyncEngineArgs(
model="meta-llama/Llama-3.2-3B-Instruct",
# 内存优化
gpu_memory_utilization=0.85, # GPU内存利用率
max_model_len=8192, # 最大上下文长度
# 批处理优化
max_num_batched_tokens=16384, # 每批最大Token数
max_num_seqs=256, # 最大并发序列数
# 调度优化
scheduler_policy="fcfs", # 先来先服务
enable_chunked_prefill=True, # 分块预填充
# 流式优化
streaming_interval=1, # 流式输出间隔
)
#### 监控指标
```python
import time
from dataclasses import dataclass
## 5. 异步推理引擎设计<a id="5"></a>
vLLM的AsyncLLMEngine为高并发在线服务提供异步推理能力,基于asyncio实现非阻塞I/O,核心组件包括请求队列、执行器池和回调处理器。
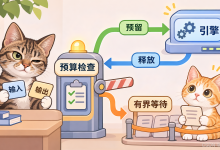
### 5.1 请求调度机制
vLLM采用两级队列系统管理请求:等待队列(新到达请求)和运行队列(正在推理请求)。调度器根据可用KV缓存块选择请求,分配资源后移动到运行队列。
### 5.2 优先级控制
支持多级优先级调度(CRITICAL、HIGH、NORMAL、LOW),确保关键请求获得及时处理,实现资源隔离与服务质量管理。
## 6. 生产环境部署指南<a id="6"></a>
### 6.1 配置参数调优<a id="6.1"></a>
#### 部署脚本示例
```bash
#!/bin/bash
# vLLM生产部署脚本
# 环境变量配置
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_ALLOW_RUNTIME_LORA_UPDATING=True
# 启动vLLM API服务器
python –m vllm.entrypoints.openai.api_server \\
––model meta–llama/Llama–3.3–70B–Instruct \\
––tensor–parallel–size 4 \\
––gpu–memory–utilization 0.85 \\
––max–model–len 16384 \\
––max–num–batched–tokens 16384 \\
––enable–lora \\
––max–loras 16 \\
––port 8000 \\
––host 0.0.0.0 \\
––log–requests \\
––log–level INFO
### 6.2 监控与可观测性<a id="6.2"></a>
#### 关键监控指标
1. **性能指标**
– 请求吞吐量(requests/sec)
– Token生成速率(tokens/sec)
– 首Token延迟(TTFT)
2. **资源指标**
– GPU利用率(%)
– GPU内存使用(GB)
– KV缓存命中率
3. **业务指标**
– 请求成功率(%)
– 平均响应时间(ms)
– 并发用户数
#### Prometheus监控配置
```yaml
# prometheus.yml
scrape_configs:
– job_name: 'vllm'
static_configs:
– targets: ['localhost:8000']
metrics_path: '/metrics'
params:
format: ['prometheus']
6.3 高可用与故障恢复
多副本部署
# Kubernetes部署配置
apiVersion: apps/v1
kind: Deployment
metadata:
name: vllm–server
spec:
replicas: 3 # 三个副本
selector:
matchLabels:
app: vllm
template:
metadata:
labels:
app: vllm
spec:
containers:
– name: vllm
image: vllm/vllm–openai:latest
ports:
– containerPort: 8000
resources:
limits:
nvidia.com/gpu: 4
env:
– name: CUDA_VISIBLE_DEVICES
value: "0,1,2,3"
#### 健康检查
```python
from fastapi import FastAPI
from contextlib import asynccontextmanager
app = FastAPI()
@app.get("/health")
async def health_check():
"""健康检查端点"""
return {
"status": "healthy",
"timestamp": time.time(),
"version": "v0.8.3",
"metrics": {
"active_requests": engine.active_requests,
"queue_size": len(engine.waiting_queue),
"gpu_memory_used": get_gpu_memory_used(),
}
}
## 7. 总结与未来展望<a id="7"></a>
### 7.1 核心要点总结
通过本文的深度剖析,我们掌握了vLLM高级特性的核心技术:
1. **多GPU并行**:灵活组合张量并行、流水线并行、专家并行与数据并行,支持超大规模模型部署
2. **LoRA动态加载**:实现个性化适配器实时切换,支持多租户、多场景并发服务
3. **流式输出**:极低延迟的实时Token生成,提升用户体验
4. **异步引擎**:高并发、高吞吐的生产级推理服务
### 7.2 最佳实践建议
1. **渐进式部署**:从单GPU开始,根据需求逐步增加并行策略
2. **监控驱动优化**:基于实际监控数据调整配置参数
3. **容错设计**:实现优雅降级和自动故障恢复
4. **成本效益平衡**:在性能与资源消耗间找到最优平衡点
### 7.3 未来发展趋势
vLLM作为开源推理框架的领导者,未来发展方向包括:
1. **更高效的并行策略**:动态自适应并行,智能资源调度
2. **多模态支持扩展**:视觉、语音、视频等多模态统一推理
3. **边缘部署优化**:轻量级部署,低功耗推理
4. **生态系统完善**:插件化架构,丰富的第三方集成
### 7.4 实践路线图
对于希望在生产环境中部署vLLM的团队,建议按以下路线图推进:
```mermaid
graph TD
A[单GPU基础部署] ––> B[多GPU并行扩展]
B ––> C[LoRA动态支持]
C ––> D[流式输出优化]
D ––> E[高可用集群]
E ––> F[智能调度系统]
技术永无止境,实践出真知。 希望本文能为你的vLLM生产部署提供实用指导。在实际应用中遇到的具体问题,欢迎在评论区交流讨论。让我们共同推动大模型推理技术的发展与落地!