关键词:数据采集、ETL、网络爬虫、日志采集、物联网、数据质量
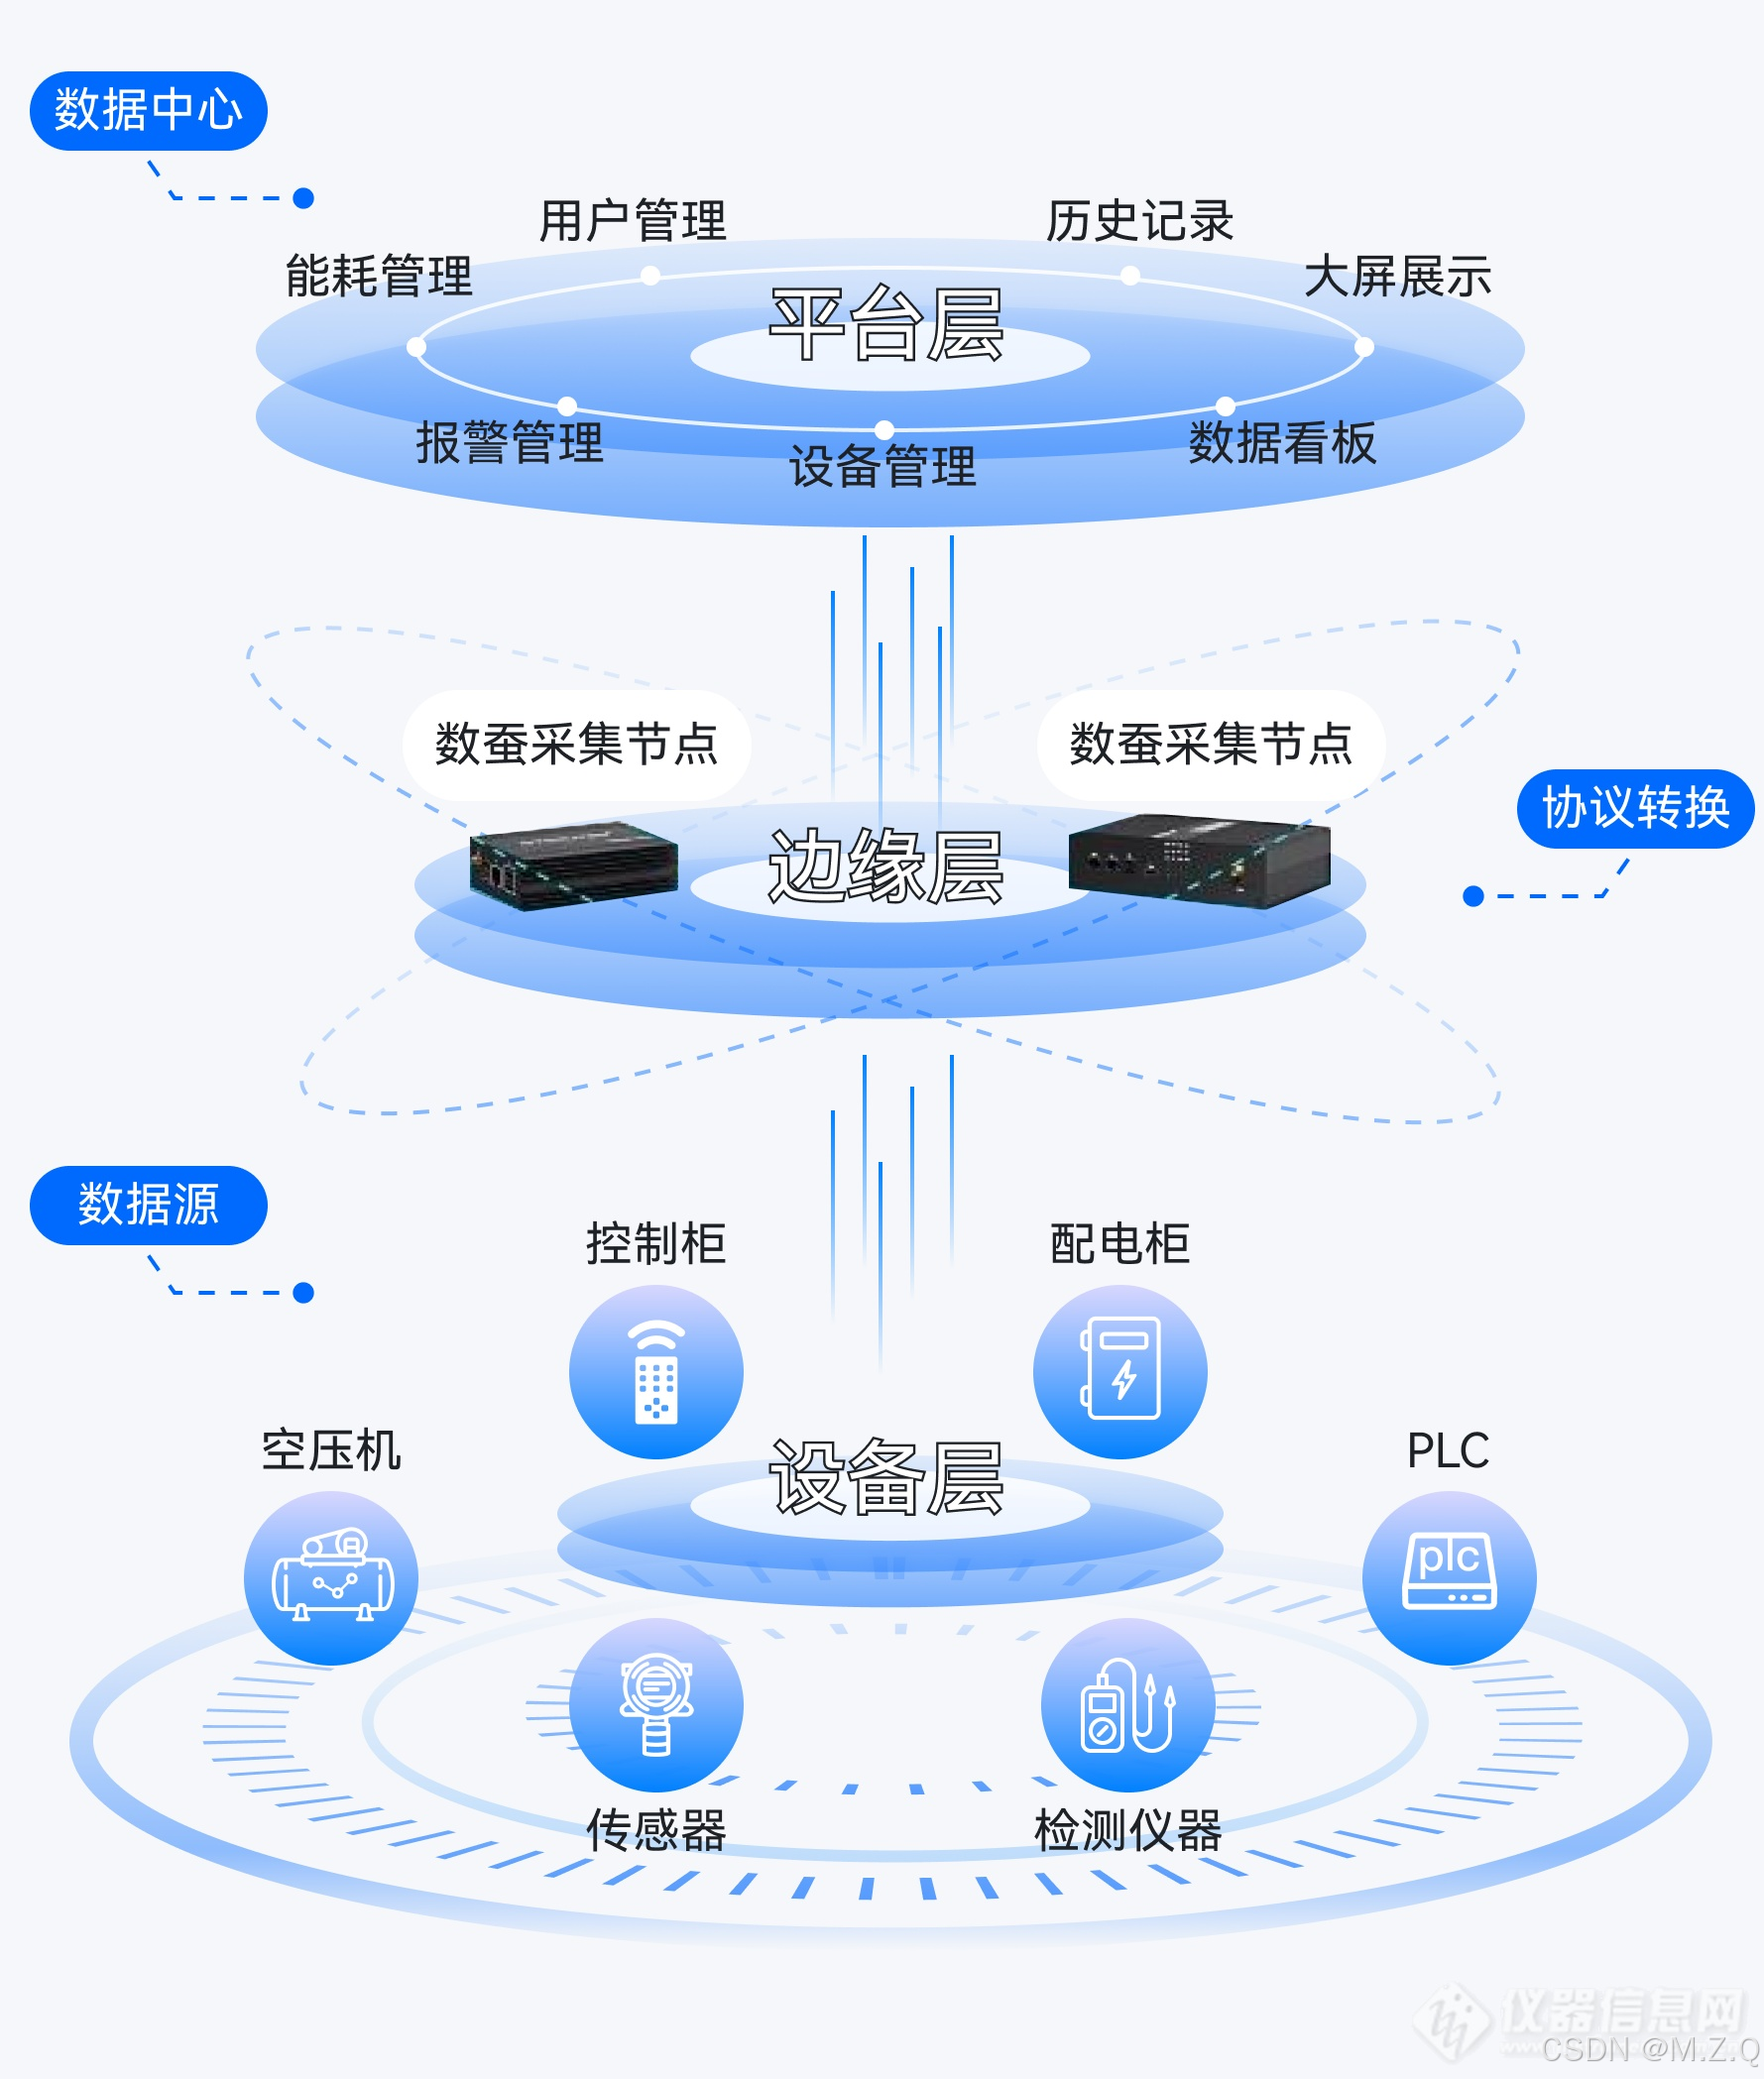
在大数据与人工智能时代,有一句行话广为流传:“Garbage In, Garbage Out(垃圾进,垃圾出)”。无论你的算法模型多么精妙,如果输入的数据质量低劣或不完整,最终产出的结果也必然毫无价值。
数据采集(Data Collection)正是这一链条的第一环,也是整个数据体系的基石。本文将深入探讨数据采集的定义、流程、常见技术、挑战以及最佳实践,为你构建完整的数据知识体系。
一、什么是数据采集?
数据采集是指通过各种技术手段,从不同的数据源(如网站、APP、传感器、数据库等)获取数据,并将其传输、汇聚到数据存储系统(如数据仓库、数据湖)的过程。
在更广义的语境下,它通常包含三个阶段,合称为 ETL (Extract-Transform-Load) 的前半部分:
提取(Extract):从源头抽取数据。
转换(Transform):清洗、格式化、补全数据。
加载(Load):将处理后的数据存入目标系统。
二、数据采集的主要来源与类型
根据数据产生的场景,我们可以将采集对象分为三大类:
1. 线上行为数据(Web & App)
这是互联网公司最主要的数据来源,记录了用户在数字产品上的所有交互行为。
-
来源:网页浏览、点击、滑动、表单提交、搜索记录。
-
特点:体量大、实时性要求高、半结构化(JSON/Log)。
-
示例:用户在电商APP上浏览商品、加入购物车、下单支付。
2. 内容数据(Content)
指互联网上的公开信息或非结构化数据。
-
来源:新闻文章、社交媒体帖子、论坛评论、图片、视频。
-
特点:非结构化、异构性强、通常需要NLP或CV处理。
-
示例:通过爬虫抓取微博热搜榜、知乎问答。
3. 机器与物联网数据(IoT & Logs)
来自服务器、应用程序或物理设备的数据。
-
来源:服务器运行日志、传感器读数(温度、压力)、GPS轨迹、工业设备状态。
-
特点:高频、时序性、结构化或半结构化。
-
示例:自动驾驶汽车每秒上传的雷达点云数据、工厂流水线的振动监测数据。
三、核心技术与工具栈
针对不同的数据源,工程师们发展出了不同的采集技术体系。
1. 网络爬虫(Web Crawling/Scraping)
用于自动化获取互联网公开数据。
-
通用爬虫:如 Google/Baidu 搜索引擎的蜘蛛程序,广度优先遍历全网。
-
聚焦爬虫:针对特定主题或网站进行定向抓取。
-
常用工具:
-
Python 库:Requests(HTTP请求)、BeautifulSoup/lxml(HTML解析)、Scrapy(异步爬虫框架)。
-
浏览器自动化:Selenium、Playwright(应对JavaScript重度渲染的SPA页面)。
-
Headless Browser:Puppeteer(Node.js环境)。
-
2. 埋点与日志采集(Logging)
用于收集用户行为和系统运行状态。
-
客户端埋点:
-
代码埋点:手动在代码中插入SDK发送事件(如友盟+、神策数据)。
-
全埋点(无埋点):自动采集页面所有控件的交互行为。
-
-
服务端日志:
-
通过 Nginx、Logback、ELK Stack 收集服务器访问日志和应用错误日志。
-
-
常用工具:Flume, Logstash, Kafka(作为日志缓冲队列)。
3. 数据库与批量同步(Batch Sync)
用于企业内部系统间的数据打通。
-
全量同步:一次性导出整表数据(如使用 mysqldump)。
-
增量同步:仅同步发生变化的数据(基于时间戳、自增ID或Binlog)。
-
常用工具:Sqoop(Hadoop与关系库之间)、DataX、Canal(监听MySQL Binlog)、Debezium(CDC工具)。
4. 流式与实时采集(Real-time Streaming)
用于需要毫秒级延迟的场景(如实时监控、金融风控)。
-
技术原理:通过消息队列解耦生产者和消费者。
-
常用工具:Apache Kafka, Apache Pulsar, RabbitMQ, Flink CDC。
四、数据采集的标准流程
一个规范的数据采集项目通常遵循以下步骤:
需求分析:明确要采集什么数据(字段粒度)、数据量级、实时性要求(T+1 还是秒级)。
目标调研:分析数据源结构(API接口、HTML DOM、数据库表结构)。
技术方案选型:选择爬虫框架、存储引擎、调度系统。
开发与反爬对抗(针对爬虫):编写解析逻辑,处理验证码、IP封禁、JS加密等问题。
数据清洗与预处理:去除脏数据、去重、填补缺失值、统一编码格式。
存储落地:写入 HDFS、Hive、ClickHouse 或对象存储(S3/OSS)。
监控与运维:监控采集成功率、数据延迟、服务器负载,确保管道持续稳定。
五、关键挑战与应对策略
数据采集看似简单,实则暗礁密布。
|
反爬虫机制 |
IP封禁、User-Agent校验、验证码、字体反爬、JS混淆。 |
IP代理池、请求频率控制、模拟真实浏览器指纹、OCR识别验证码。 |
|
数据质量问题 |
缺失值、异常值、格式不统一、重复数据。 |
建立严格的数据Schema校验,实施数据质量监控(Data Quality Monitoring)。 |
|
法律与合规风险 |
侵犯隐私(PII)、违反网站Robots协议、版权纠纷。 |
严格遵守法律法规(如《数据安全法》、《个人信息保护法》),仅采集公开非敏感数据。 |
|
海量数据吞吐 |
数据量巨大导致网络带宽瓶颈、存储压力过大。 |
采用分布式采集架构,使用压缩算法,分层存储(热数据/冷数据)。 |
六、最佳实践与原则
合法合规是底线:永远不要触碰个人隐私数据(如手机号、身份证号)的红线,遵守 robots.txt协议。
最小够用原则:只采集当前业务需要的数据,避免过度采集造成资源浪费和合规风险。
幂等性设计:采集任务失败重试时,要确保不会重复写入数据(例如使用唯一ID去重)。
可观测性:建立完善的报警机制,一旦爬虫失效或数据断流,第一时间通知开发人员。
模块化与解耦:采集逻辑、清洗逻辑、存储逻辑分离,便于维护和扩展。
七、总结
数据采集是数据工程的“咽喉”,它连接着物理世界/数字世界与数据系统。随着技术的演进,数据采集正从简单的“抓网页”向更复杂的多模态采集(文本、图像、视频融合)、边缘采集(在数据产生源头处理)以及智能化采集(自适应调整抓取策略)发展。
掌握数据采集技术,不仅是爬虫工程师的必修课,更是每一位数据从业者理解数据源头、把控数据质量的必经之路。
如果你对某一特定领域的采集技术(如反爬虫攻防实战、APP端埋点设计或大规模日志处理架构)感兴趣,可以告诉我,我们可以进一步深入探讨。




