文章目录
- 哨兵集群的组建方式
- 判定主库下线的投票机制
- 谁来执行故障转移:Leader 选举
- 故障转移的完整流程
- 客户端怎么感知切换
- 哨兵集群的部署建议
- 哨兵的局限

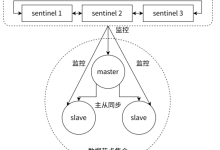
单个哨兵监控 Redis 主从架构,本身就是单点。哨兵挂了,主库故障就没人发现、没人切换。所以生产环境必须部署哨兵集群——多个哨兵实例协同工作,任何一个挂了都不影响整体的监控和故障转移能力。
哨兵集群的组建方式

哨兵实例之间不需要手动配置彼此的地址。它们通过 Redis 的 Pub/Sub 机制自动发现对方。
具体过程:每个哨兵都会向它监控的主库的 __sentinel__:hello 频道发布自己的 IP、端口和运行 ID。同时,每个哨兵也订阅这个频道。这样一来,所有监控同一组主从的哨兵就能互相感知到彼此的存在。
这个设计很巧妙:哨兵的发现依赖于被监控的 Redis 实例本身。只要哨兵们都配置了同一个主库地址,它们就能自动组网。
哨兵还能自动发现从库。它通过向主库发送 INFO 命令,获取所有从库的地址列表,然后逐一建立连接并监控。

判定主库下线的投票机制
单个哨兵 ping 不通主库,只能算"主观下线"(Subjectively Down,简称 sdown)。网络抖动、哨兵自身负载高都可能导致误判。

要确认主库真的挂了,需要多个哨兵达成共识——这就是"客观下线"(Objectively Down,简称 odown)。当一个哨兵判定主库 sdown 后,它会询问其他哨兵:"你那边也 ping 不通吗?"如果收到的"同意下线"票数达到配置的 quorum 值,就判定为客观下线。
sentinel monitor mymaster 192.168.1.10 6379 2
最后那个 2 就是 quorum。意思是至少 2 个哨兵都认为主库挂了,才触发故障转移。
谁来执行故障转移:Leader 选举
客观下线只是"判定",接下来要有一个哨兵站出来执行切换操作。这个角色叫 Leader,通过类似 Raft 的选举产生。

选举规则:
注意一个关键区别:quorum 决定"是否下线",多数派决定"谁来切换"。
举个例子:5 个哨兵,quorum=2。只要 2 个哨兵认为主库挂了就判定 odown,但执行切换需要拿到至少 3 票(5/2+1)。如果此时有 3 个哨兵挂了,虽然能判定下线(剩下 2 个够 quorum),但选不出 Leader(2 < 3),切换就无法执行。
所以哨兵集群的数量建议是奇数(3 或 5),且要保证大多数存活。
故障转移的完整流程
Leader 选出后,执行以下步骤:
从所有从库中选一个新主库。选择标准按优先级排序:
- 过滤掉网络不稳定的(断连次数超阈值)
- 优先级高的优先(replica-priority 配置)
- 复制偏移量大的优先(数据最新)
- runID 最小的优先(兜底)
向选中的从库发送 SLAVEOF NO ONE,让它升级为主库。
向其他从库发送 SLAVEOF <新主库>,让它们切换复制源。
把旧主库标记为从库。如果旧主库后来恢复了,哨兵会让它以从库身份加入。
客户端怎么感知切换
哨兵切换完主库后,客户端还连着旧地址怎么办?
哨兵提供了通知机制。客户端可以订阅哨兵的特定频道(如 +switch-master),收到切换通知后重新连接新主库。主流的 Redis 客户端库(Jedis、Lettuce、redis-py)都内置了哨兵模式的支持,会自动处理这个过程。
客户端连接哨兵的配置方式:
from redis.sentinel import Sentinel
sentinel = Sentinel([
('sentinel-1', 26379),
('sentinel-2', 26379),
('sentinel-3', 26379)
], socket_timeout=0.1)
master = sentinel.master_for('mymaster', socket_timeout=0.1)
slave = sentinel.slave_for('mymaster', socket_timeout=0.1)
客户端先问哨兵"当前主库是谁",拿到地址后再直连 Redis。
哨兵集群的部署建议

哨兵的局限
哨兵解决了主从架构的自动故障转移问题,但它有几个天然限制:
- 写能力无法扩展:所有写流量都打到一个主库,主库的内存和 CPU 就是上限。
- 存储容量受限于单机内存:主从只是副本,不是分片。
- 切换期间有短暂不可用:从发现故障到完成切换,通常需要 10-30 秒。
当单机内存不够用、或者写入量超过单机承载能力时,就需要切片集群了。哨兵负责的是"高可用",切片集群负责的是"可扩展",两者解决的是不同层面的问题。