目录
前情回顾
1、网络初识
2、套接字
网络原理之史上最伟大的发明-HTTP协议
1、HTTP报文格式
2、HTTP请求Request
认识URL
认识 "⽅法" (method)
认识请求 "报头" (header)
Host
Content-Length
Content-Type
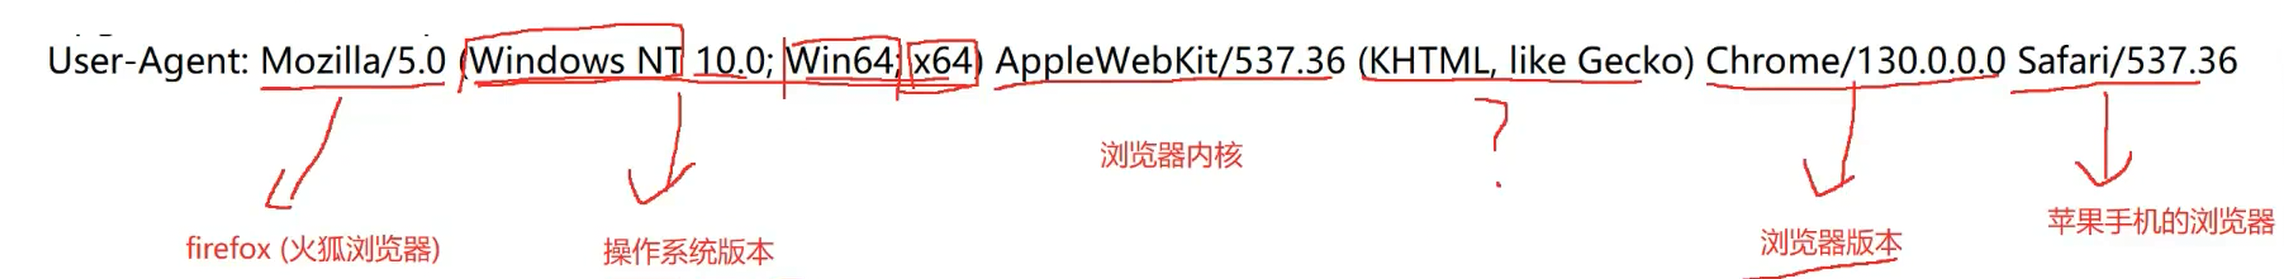
User-Agent (简称 UA)
Referer
Cookie
3、HTTP 响应详解 认识 "状态码" (status code)
200 表示响应成功
404 not found 访问资源没有找到
403 Forbidden
405 Method Not Allowed
500 Internal Server Error
504 Gateway Timeout
302 Move temporarily
4、构造HTTP请求
form 发送 GET 请求
通过 ajax 构造 HTTP 请求
通过 Java socket 构造 HTTP 请求
5、HTTPS(防劫持)
1、运营商劫持
2、对称加密
3、非对称加密
4、中间人攻击
5、引入校验机制
前情回顾
1、网络初识
前面网络初识我们讲了协议,协议分层和TCP/IP五层模型,封装/分用,我们来大概过一下,
协议:网络协议的简称,网络协议是网络通信 (即网络数据传输) 经过的所有网络设备都必须共同遵从的一组约定、规则。如怎么样建立连接、怎么样互相识别等。只有遵守这个约定,计算机之间才能相互通信交流。
协议分层:只有相邻两层可以通信,上层协议调用下层协议,下层协议给上层协议提供服务,不能跨层通信
TCP/IP模型: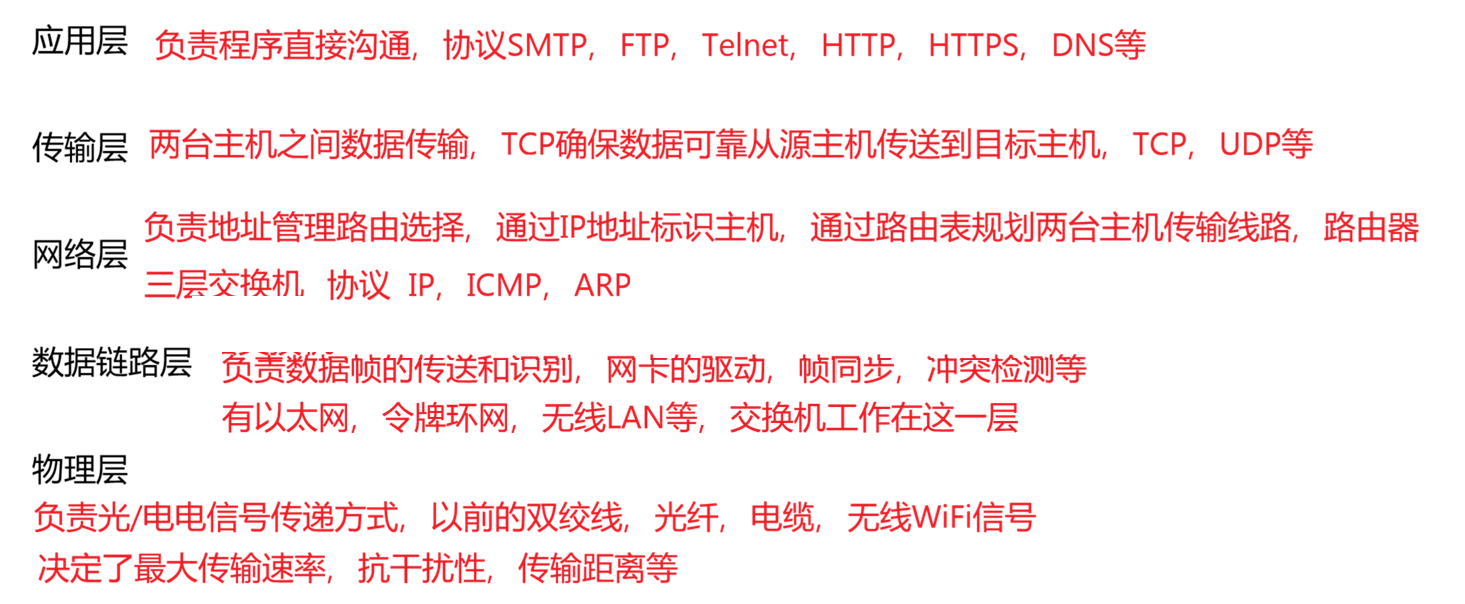
封装/分用:在网络通信里面,源主机通过TCP/IP模型进行封装,上层协议加上头部信息,交给下层,最终到物理层变成二进制比特流,传输到目标主机以后,目标再按照TCP/IP模型进行解析,并从物理层到应用层,每层去掉头部,解析成原来的可读信息,发送端从上到下逐层加首部打包,接收端从下到上逐层拆包分发
2、套接字
在传输层有两个核心协议TCP 有连接,可靠传输,面向字节流,全双工,UDP 无连接,不可靠传输,面向数据报,全双工
1、有连接的意思是TCP里面保存了对方的信息,而UDP没有
2、可靠传输和不可靠传输是,网络传输容路由器堵车易丢包,光信号/电信号外界干扰,可靠传输就是能感知到丢包,尽可能达到提高传输概率,不可靠就只是把数据发了
3、TCP读写数据以字节为单位,UDP以数据报为单位
4,一个通信链路支持双向通信(能读/能写)
我们一般使用Socket api进行网络编程,他是操作系统提供的api,这里我们来回顾一下,在Java里面有两套api一个是UDP的DatagramSocket和DatagramPacket,还有一个是TCP的Seversocket和Socket,针对操作系统进行了封装
注意事项:
1、读写数据通过Socket,通过Socket内置的InputStream和OutputStream,读写单位都是字节流
网络原理之史上最伟大的发明-HTTP协议
HTTP协议是超文本传输协议,他是类似于一问一答形式,请求和响应对应
1、HTTP报文格式
一个http请求分为请求头和请求体
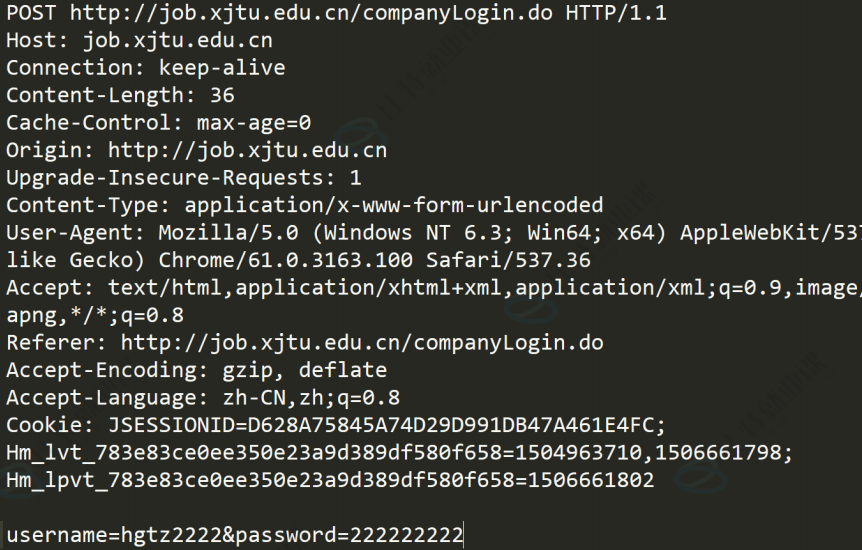
首行请求方式,接着地址,http版本,请求头(Header),请求体(Body)
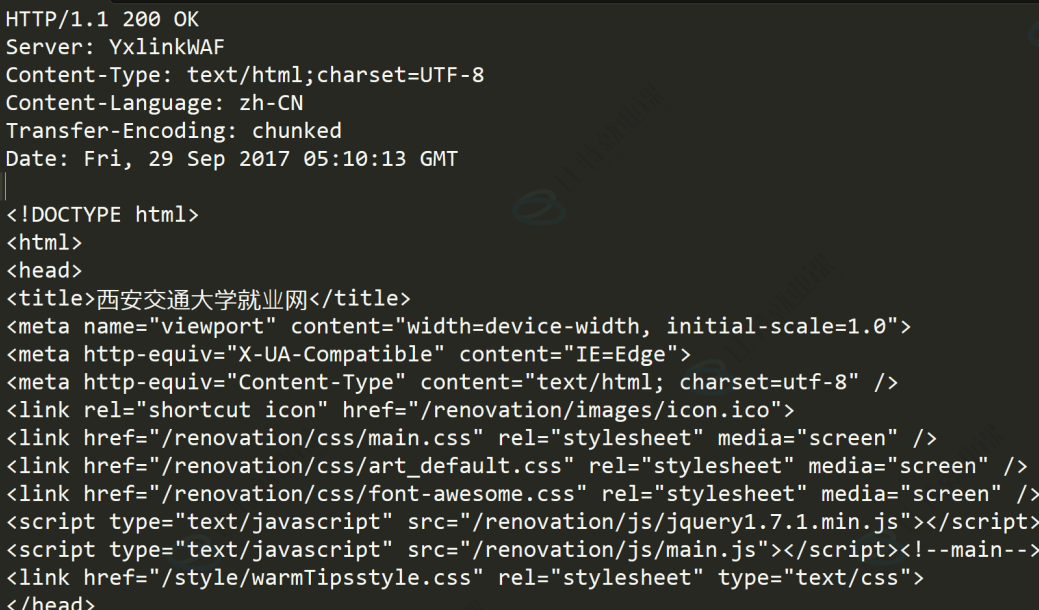
首行版本号+状态吗,请求头和请求体
2、HTTP请求Request
认识URL
Uniform Resource Locator 统⼀资源定位符,完整格式 协议:IP地址或资源路径:端口号
例如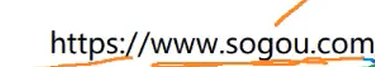
认识 "⽅法" (method)
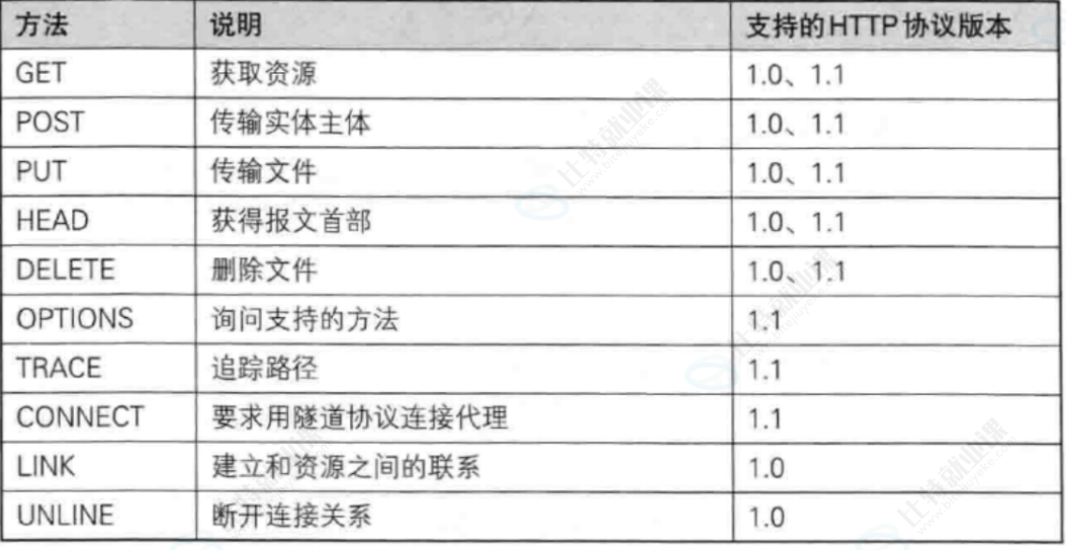
虽然方法很多只用掌握两个Post和get就行了,这两个请求非常常见,由于主播这里非常熟悉这两个了我就大概做一下这两个区别
1、两个可以语义上面混着用
2、Get携带数据一般在URL上面,Post携带的数据一般在请求体中
3、网上说Post根安全一些,这个说法错误,通过抓包还是和get显示一样
4、get传输有限制都是上古时期,现在都没有了
5、确实geturl里面只能放文本,但是可以通过把二进制base64转成文本
6、get也不是完全不能带Body,只是有些客户端不支持
认识请求 "报头" (header)
header 的整体的格式也是 "键值对" 结构
Host
表⽰服务器主机的地址和端⼝,即你访问的目标资源的服务器地址与域名
.
Content-Length
表⽰ body 中的数据⻓度,用来表示请求体的数据长度,如果请求体数据长度和这里不一样会产生错误
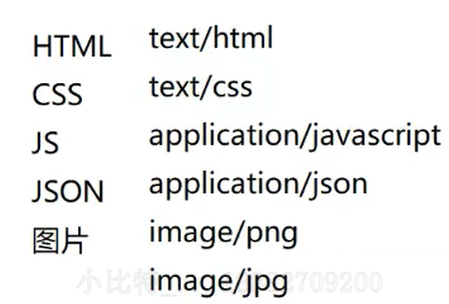
Content-Type
表⽰请求的 body 中的数据格式.有如下类型
User-Agent (简称 UA)
里面表示了用户设备的操作系统和浏览器的情况,根据这些特性,区分用户支持哪些特性
Referer
表⽰这个⻚⾯是从哪个⻚⾯跳转过来的. 形如,直接输入url和点收藏是没有的
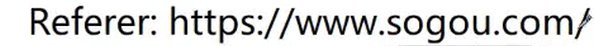
Cookie
通常浏览器里面的js代码无法直接访问文件系统,出于安全考虑,浏览器给js代码弄上了这个限制,而cookie这种机制的出现是浏览器允许网页在本地存储的机制,只能存储键值对
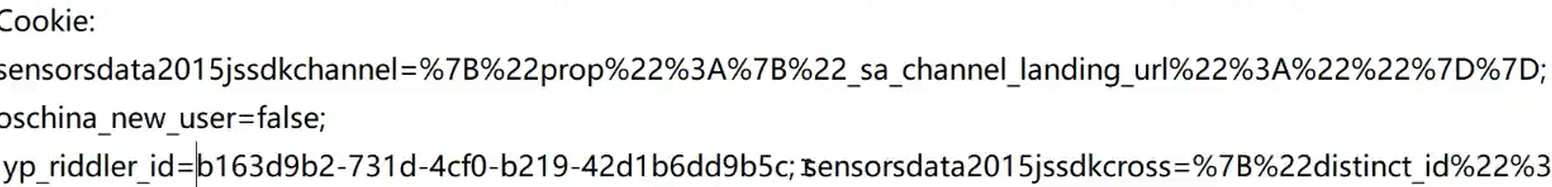
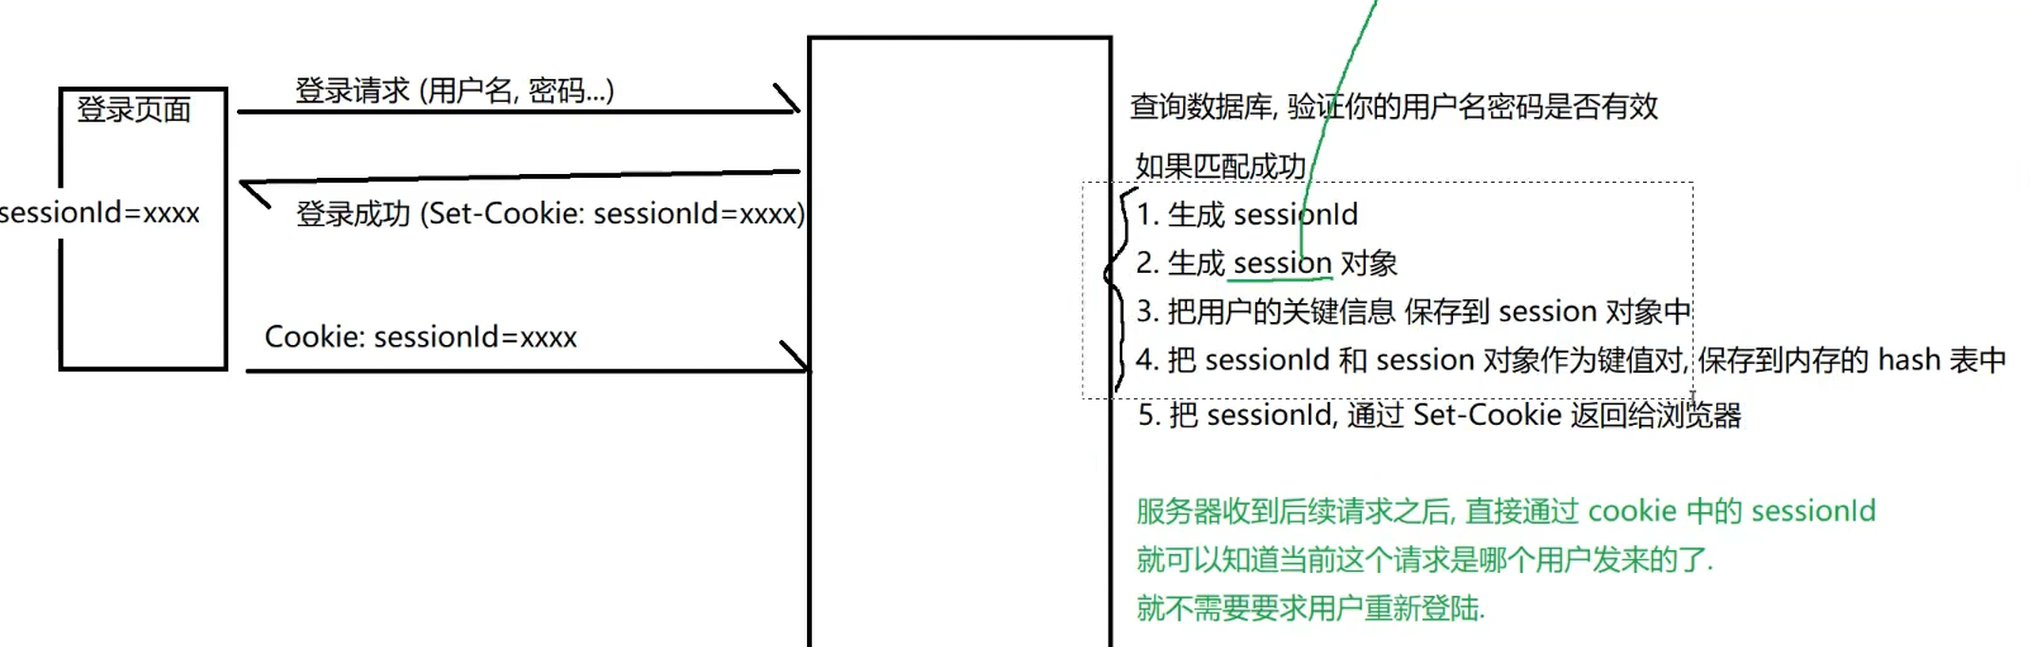
cookie经常用于登录场景,刚开始用户输入用户名和密码传到服务器那边,服务器去查询数据库对比,匹配成功生成session对象里面包含用户关键信息,sessionid和session键值对存储到服务器的内存hash里面或者Redis里面,然后在通过Set cookie返回sessionid给用户,用户下次登录拿着这个发送到服务器,就不用重新输入密码
3、认识请求 "正⽂" (body)
正⽂中的内容格式和 header 中的 Content-Type 密切相关. 上⾯也罗列了三种常⻅的情况
3、HTTP 响应详解 认识 "状态码" (status code)
状态码表⽰访问⼀个⻚⾯的结果. (是访问成功, 还是失败, 还是其他的⼀些情况…). 以下为常⻅的状态码.
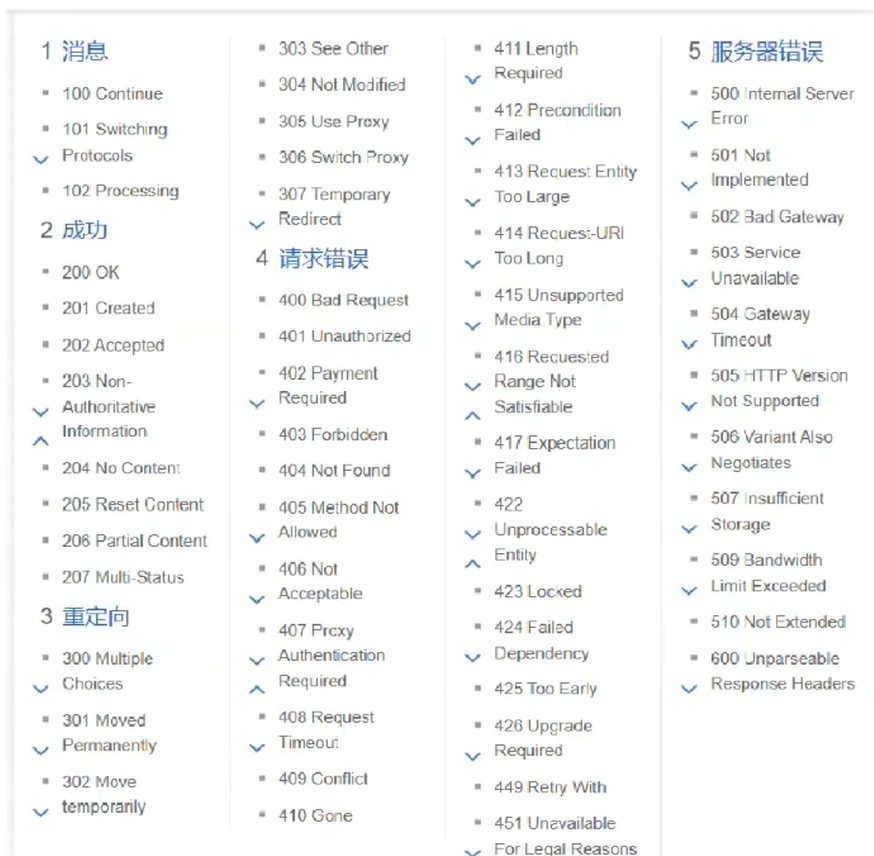
我们只需要掌握常见的就行了
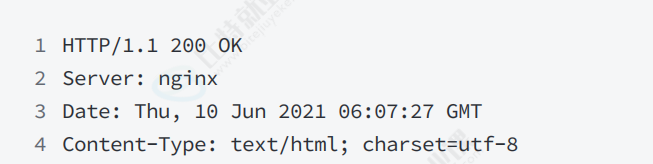
200 表示响应成功
404 not found 访问资源没有找到
403 Forbidden
访问拒绝没有权限
405 Method Not Allowed
请求的方法和服务器注解不匹配会出现
500 Internal Server Error
服务器出现错误,服务器抛出异常没有catch到
504 Gateway Timeout
当服务器负载⽐较⼤的时候, 服务器处理单条请求的时候消耗的时间就会很⻓, 就可能会导致出现超时的情况.
302 Move temporarily
临时重定向
总结:2xx开头是成功,3xx是重定向,4xx是客户端出错(请求出现问题),5xx是服务器出错(服务器的代码有问题)
4、构造HTTP请求
form 发送 GET 请求
<form action="http://abcdef.com/myPath" method="GET">
<input type="text" name="userId">
<input type="text" name="classId">
<input type="submit" value="提交">
</form>
通过 ajax 构造 HTTP 请求
<script src="https://code.jquery.com/jquery-3.6.3.min.js"></script>
3 <script>
4 $.ajax({
5 type: 'get',
6 url: 'https://www.sogou.com?studentName=zhangsan',
7 // 此处 success 就声明了⼀个回调函数, 就会在服务器响应返回到浏览器的时候触发该回调
8 // 正是此处的 回调 体现了 "异步"
9 success: function(data) {
10 // data 则是响应的正⽂部分.
11 console.log("当服务器返回的响应到达浏览器之后, 浏览器触发该回调, 通知到咱们
12 }
13 });
14 console.log("浏览器⽴即往下执⾏后续代码");
15 </script>
通过 Java socket 构造 HTTP 请求
本质上HTTP请求就是基于TCP,只需要构造字符串符合HTTP协议格式,写入到TCP Socket里面
public class HttpClient {
private Socket socket;
private String ip;
private int port;
public HttpClient(String ip, int port) throws IOException {
this.ip = ip;
this.port = port;
socket = new Socket(ip, port);
}
public String get(String url) throws IOException {
StringBuilder request = new StringBuilder();
// 构造⾸⾏
request.append("GET " + url + " HTTP/1.1\\n");
// 构造 header
request.append("Host: " + ip + ":" + port + "\\n");
// 构造 空⾏
request.append("\\n");
// 发送数据
OutputStream outputStream = socket.getOutputStream();
outputStream.write(request.toString().getBytes());
// 读取响应数据
InputStream inputStream = socket.getInputStream();
byte[] buffer = new byte[1024 * 1024];
int n = inputStream.read(buffer);
return new String(buffer, 0, n, "utf-8");
}
public String post(String url, String body) throws IOException {
StringBuilder request = new StringBuilder();
// 构造⾸⾏
request.append("POST " + url + " HTTP/1.1\\n");
// 构造 header
request.append("Host: " + ip + ":" + port + "\\n");
request.append("Content-Length: " + body.getBytes().length + "\\n");
request.append("Content-Type: text/plain\\n");
// 构造 空⾏
request.append("\\n");
// 构造 body
request.append(body);
// 发送数据
OutputStream outputStream = socket.getOutputStream();
outputStream.write(request.toString().getBytes());
// 读取响应数据
InputStream inputStream = socket.getInputStream();
byte[] buffer = new byte[1024 * 1024];
int n = inputStream.read(buffer);
return new String(buffer, 0, n, "utf-8");
}
public static void main(String[] args) throws IOException {
HttpClient httpClient = new HttpClient("42.192.83.143", 8080);
String getResp = httpClient.get("/AjaxMockServer/info");
System.out.println(getResp);
String postResp = httpClient.post("/AjaxMockServer/info", "this is body"
System.out.println(postResp);
}
}
使⽤ Java 构造的 HTTP 客⼾端不再有 "跨域" 限制了, 此时也可以⽤来获取其他服务器的数据了
HttpClient httpClient = new HttpClient("www.sogou.com", 80);
String resp = httpClient.get("/index.html");
System.out.println(resp);
// 此时可以获取到 搜狗主⻚ 的 html
5、HTTPS(防劫持)
1、运营商劫持
首先我们来举一个例子,运营商劫持问题,我们点击下载天天动听,正常情况下跳出天天动听的下载链接,
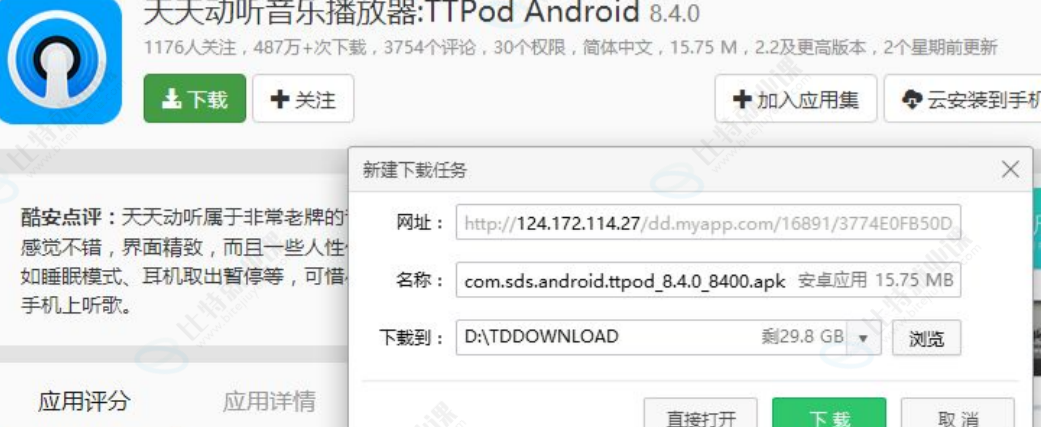
而出现运营商劫持的时候,会弹出qq浏览器下载链接
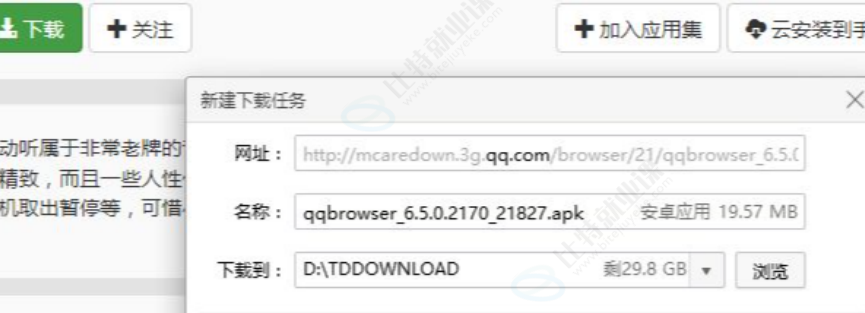
由于我们通过⽹络传输的任何的数据包都会经过运营商的⽹络设备(路由器, 交换机等), 那么运营商的⽹ 络设备就可以解析出你传输的数据内容, 并进⾏篡改. 点击 "下载按钮", 其实就是在给服务器发送了⼀个 HTTP 请求, 获取到的 HTTP 响应其实就包含了该 APP 的下载链接. 运营商劫持之后, 就发现这个请求是要下载天天动听, 那么就⾃动的把交给⽤⼾的响应 给篡改成 "QQ浏览器" 的下载地址了.
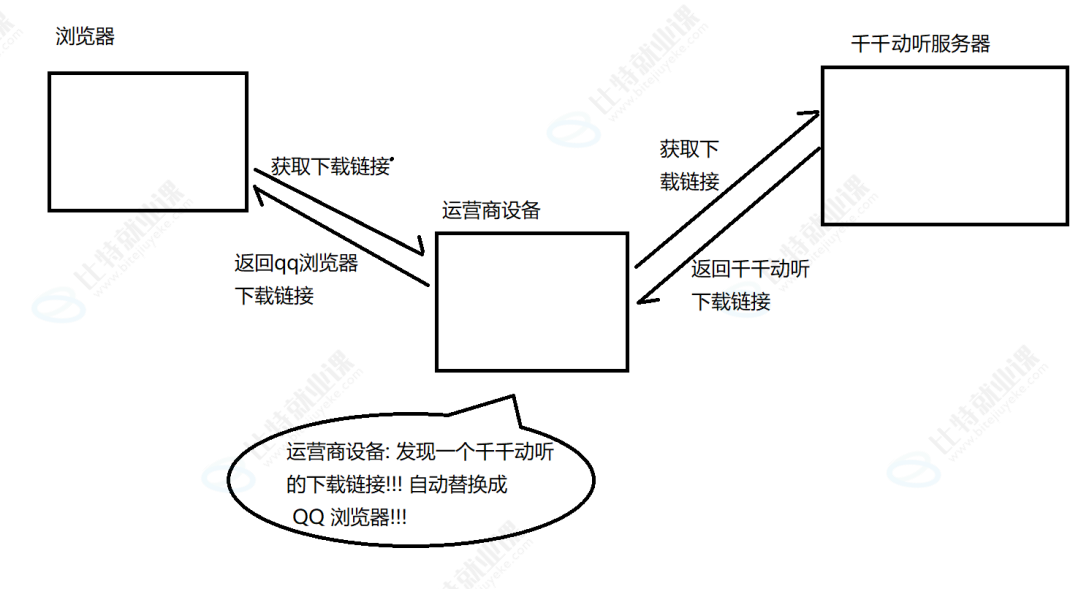
于是乎引入了HTTPS,即HTTP+SSL证书,接下来详细介绍关于加密,加密分为两大类,一类是对称加密,一类是非对称加密
2、对称加密
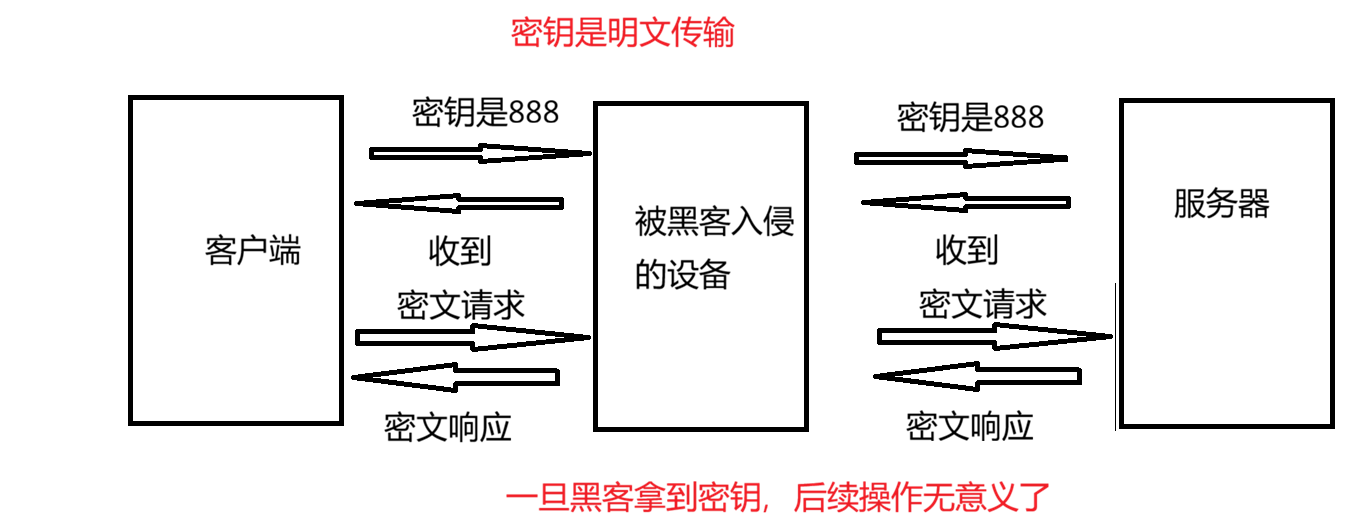
对称加密即加密和解密使用同一个密钥key,适用于数据量大的加密
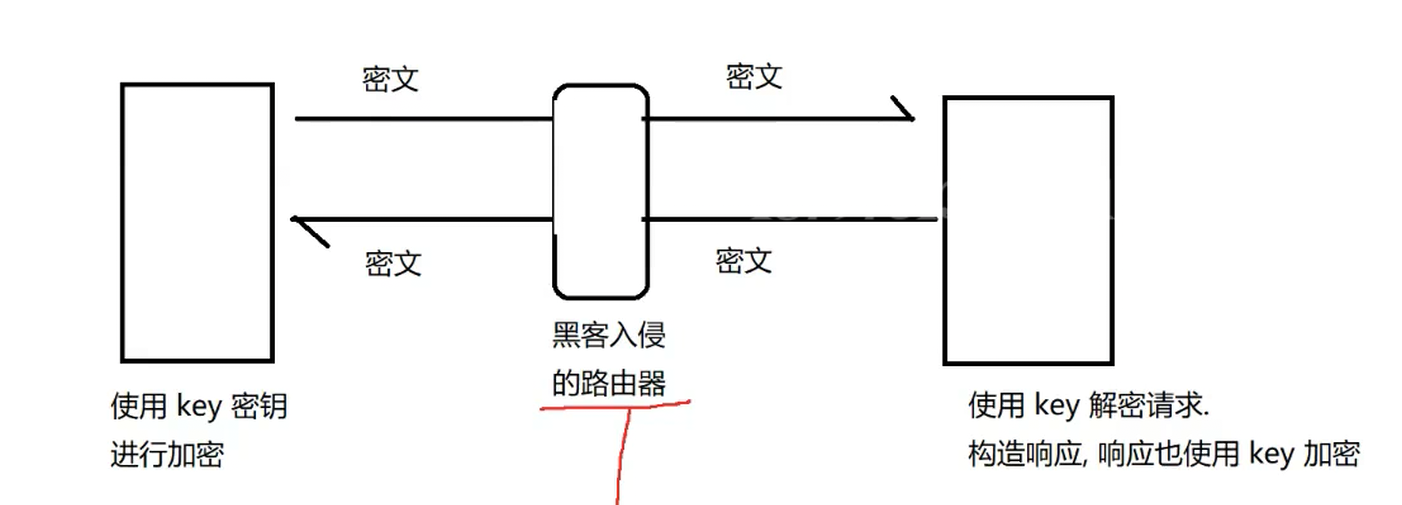
但是如果黑客也控制了一个网络设备,由于密钥是明文,一旦黑客获取,后续操作无意义了
3、非对称加密
引入非对称加密就是为了解决传输过程中的问题,但是不适合数据量大的加密

1、客⼾端在本地⽣成对称密钥, 通过公钥加密, 发送给服务器.
2、由于中间的⽹络设备没有私钥, 即使截获了数据, 也⽆法还原出内部的原⽂, 也就⽆法获取到对称密钥
3、服务器通过私钥解密, 还原出客⼾端发送的对称密钥. 并且使⽤这个对称密钥加密给客⼾端返回的响 应数据
4、后续客⼾端和服务器的通信都只⽤对称加密即可. 由于该密钥只有客⼾端和服务器两个主机知道, 其 他主机/设备不知道密钥即使截获数据也没有意义.
客⼾端如何获取到公钥? 客⼾端如何确定这个公钥不是⿊客伪造的?但是这样流程存在一个重大安全隐患,通过特殊手段可以获取对称密钥——中间人攻击,破坏安全传输性
4、中间人攻击
内容如下

1、最开始服务器生成公钥和私钥pub1和pri2,然后客户端开始向服务器询问公钥是什么,黑客就会劫持,然后转发给服务器
2,服务器返回公钥pub1,黑客收到pub1,然后自己生成公钥和私钥pub2和pri2,然后把pub2发给客服端
3、此时客户端无法分别pub2是不是服务器发过来的,只能选择相信,生成对称加密key,用pub2加密,发送
4、黑客收到客户端发过来的请求,使用pri2解密,再修改内容,使用pub1加密发送给服务器
5、服务器收到使用pri2解密
这就是中间人攻击过程
5、引入校验机制
中间人攻击的关键,在于客户端无法区分收到的公钥是否是服务器真实的 公钥 还是被黑客篡改的公钥~~想办法能够对公钥是否正确,进行校验~~

1、服务器搭建的时候去找第三方认证机构,将自己的公钥和域名信息交给第三方机构,第三方认证机构将*证书机构是*证书有效期*服务器公钥*服务器拥有者域名这些信息,使用算法类似hash进行校验得到校验和
2、第三方机构生成pub2和pri2,使用pri2加密校验和
3、客户端开始向服务器询问证书,服务器返回证书,客户端将第三方认证机构将*证书机构是*证书有效期*服务器公钥*服务器拥有者域名这些信息,使用相同的算法得到校验和1,
然后再使用公钥pub2对数字签名进行解密得到校验和2,将校验和1 校验和2进行对比,如果一致则证书没有修改,如果不一致证书就是修改了
总结
HTTPS ⼯作过程中涉及到的密钥有三组.
第⼀组(⾮对称加密): ⽤于校验证书是否被篡改. 服务器持有私钥(私钥在注册证书时获得), 客⼾端持有 公钥(操作系统包含了可信任的 CA 认证机构有哪些, 同时持有对应的公钥). 服务器使⽤这个私钥对证书
的签名进⾏加密. 客⼾端通过这个公钥解密获取到证书的签名, 从⽽校验证书内容是否是篡改过.
第⼆组(⾮对称加密): ⽤于协商⽣成对称加密的密钥. 服务器⽣成这组 私钥-公钥 对, 然后通过证书把公 钥传递给客⼾端. 然后客⼾端⽤这个公钥给⽣成的对称加密的密钥加密, 传输给服务器, 服务器通过私钥 解密获取到对称加密密钥.
第三组(对称加密): 客⼾端和服务器后续传输的数据都通过这个对称密钥加密解密. 其实⼀切的关键都是围绕这个对称加密的密钥. 其他的机制都是辅助这个密钥⼯作的.
第⼆组⾮对称加密的密钥是为了让客⼾端把这个对称密钥传给服务器. 第⼀组⾮对称加密的密钥是为了让客⼾端拿到第⼆组⾮对称加密的公钥
小编在这里感谢大家的关注和点赞,如有不足,尽请指出,未来我们一起加油