前言:面向对象的三大特性分别是封装、继承和多态。多态并不是孤立存在的,它需要建立在继承关系之上,因此在继续认识多态之前,需要先把基类与派生类之间的关系弄清楚。本篇先介绍继承的基本使用、基类与派生类之间的转换、继承中的作用域与隐藏,以及派生类的默认成员函数,为后面真正认识多态做好准备。
1.继承的概念与基本使用
1.1继承的概念
假设要分别设计学生类和教师类,它们都会包含姓名、年龄等成员,也都会使用一些相同的成员函数。如果把这些内容分别写进两个类中,不仅会产生重复代码,后续修改时也需要同时维护多个地方。
继承可以把这些公共内容抽取到一个类中,再让其他类在它的基础上继续扩展。被继承的类叫做基类,也叫父类;通过继承得到的新类叫做派生类,也叫子类。
下面的代码先定义了Person,再让Student公有继承Person:
void test1()
{
// 父类:人
class Person
{
public:
void PrintInfo()
{
cout << "姓名:" << _name << endl;
cout << "年龄:" << _age << endl;
}
protected:
string _name;
int _age = 0;
private:
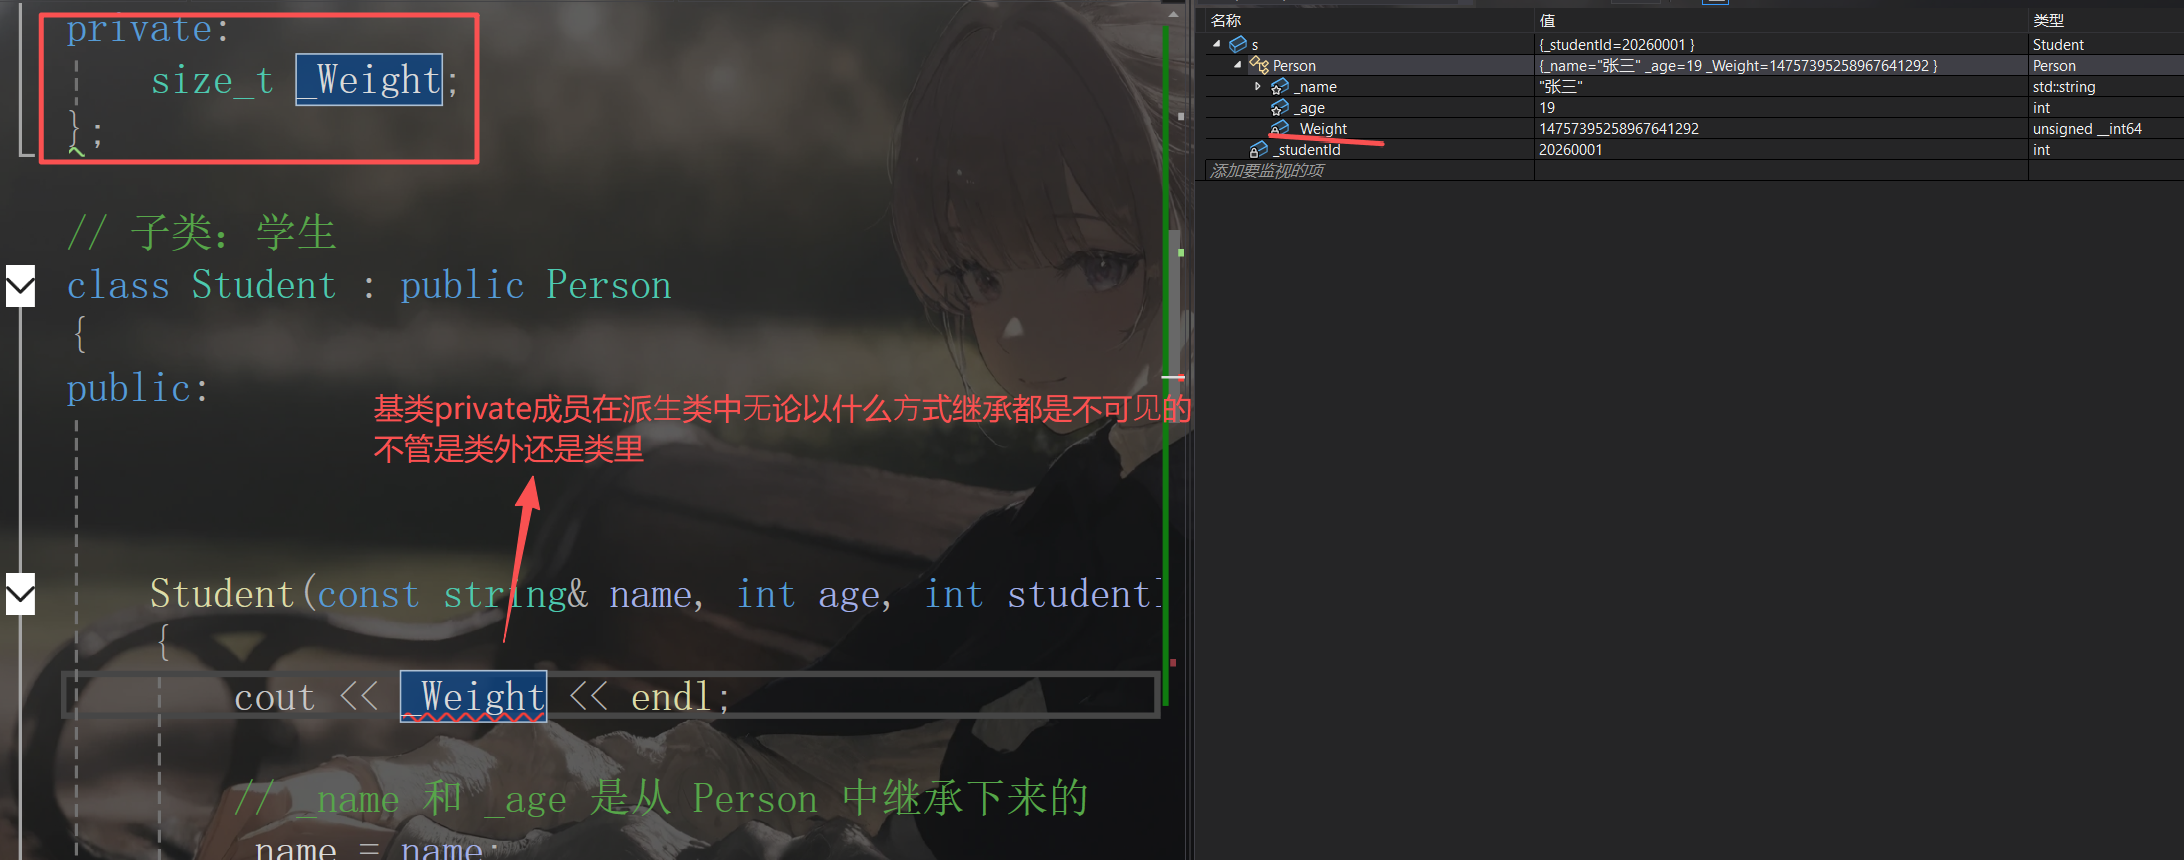
size_t _Weight = 0;
};
// 子类 学生
// 如果不写访问限定符对于class来说默认是private
// 是struct默认就是 public
class Student : public Person
{
public:
Student(const string& name, int age, int studentId)
{
// 虽然不可见但是可以通过父类间接的使用
//cout << _Weight << endl;
// _name 和 _age 是从 Person 中继承下来的
_name = name;
_age = age;
// _studentId 是 Student 自己新增的成员
_studentId = studentId;
}
void PrintStudent()
{
// 调用从父类继承下来的成员函数
PrintInfo();
cout << "学号:" << _studentId << endl;
}
private:
int _studentId;
};
Student s("张三", 19, 20260001);
s.PrintStudent();
}
定义继承关系的基本格式如下:
class 派生类 : 继承方式 基类
代码中的class Student : public Person表示Student公有继承Person。一个Student对象不仅拥有自己新增的_studentId,还包含一份从Person继承而来的基类部分,所以可以在派生类中使用_name、_age以及PrintInfo()。
运行得到:
姓名:张三
年龄:19
学号:20260001
这里的PrintStudent()先调用继承下来的PrintInfo()输出姓名和年龄,再输出Student自己新增的学号。继承并不是简单地把两份代码拼在一起,它表达的是一种is-a关系,也就是“学生是一种人”。
Person中的_Weight虽然属于基类的private成员,派生类对象中依然存在对应的基类部分,但是Student不能直接访问它。private限制的是访问权限,并不代表这个成员没有进入派生类对象。
1.2继承方式与访问权限
C++提供了public、protected和private三种继承方式。基类成员原来的访问限定符与继承方式会共同决定它们在派生类中的访问属性:
| 基类的public成员 | 派生类的public成员 | 派生类的protected成员 | 派生类的private成员 |
| 基类的protected成员 | 派生类的protected成员 | 派生类的protected成员 | 派生类的private成员 |
| 基类的private成员 | 不可直接访问 | 不可直接访问 | 不可直接访问 |
可以把前两行简单理解成:继承以后得到的访问权限不会比继承方式更开放。public继承尽量保留基类原来的访问属性;protected继承会把原来的public成员收紧为protected;private继承则会把基类的public和protected成员都收紧为private。
protected成员在类外不能直接访问,但是派生类的成员函数可以访问,所以它经常用来保存需要交给派生类使用、又不希望完全暴露到类外的数据。实际设计中最常见的还是public继承,因为它能够比较自然地保持is-a关系。
如果使用class定义派生类但省略继承方式,默认是private继承;如果使用struct,默认则是public继承。为了让代码含义更加清楚,通常还是把继承方式显式写出来。
继承的基类也可以是一个类模板,代码中使用std::vector<T>作为stack<T>的基类:
namespace qen
{
template<class T>
class stack : public std::vector<T>
{
public:
void push(const T& x)
{
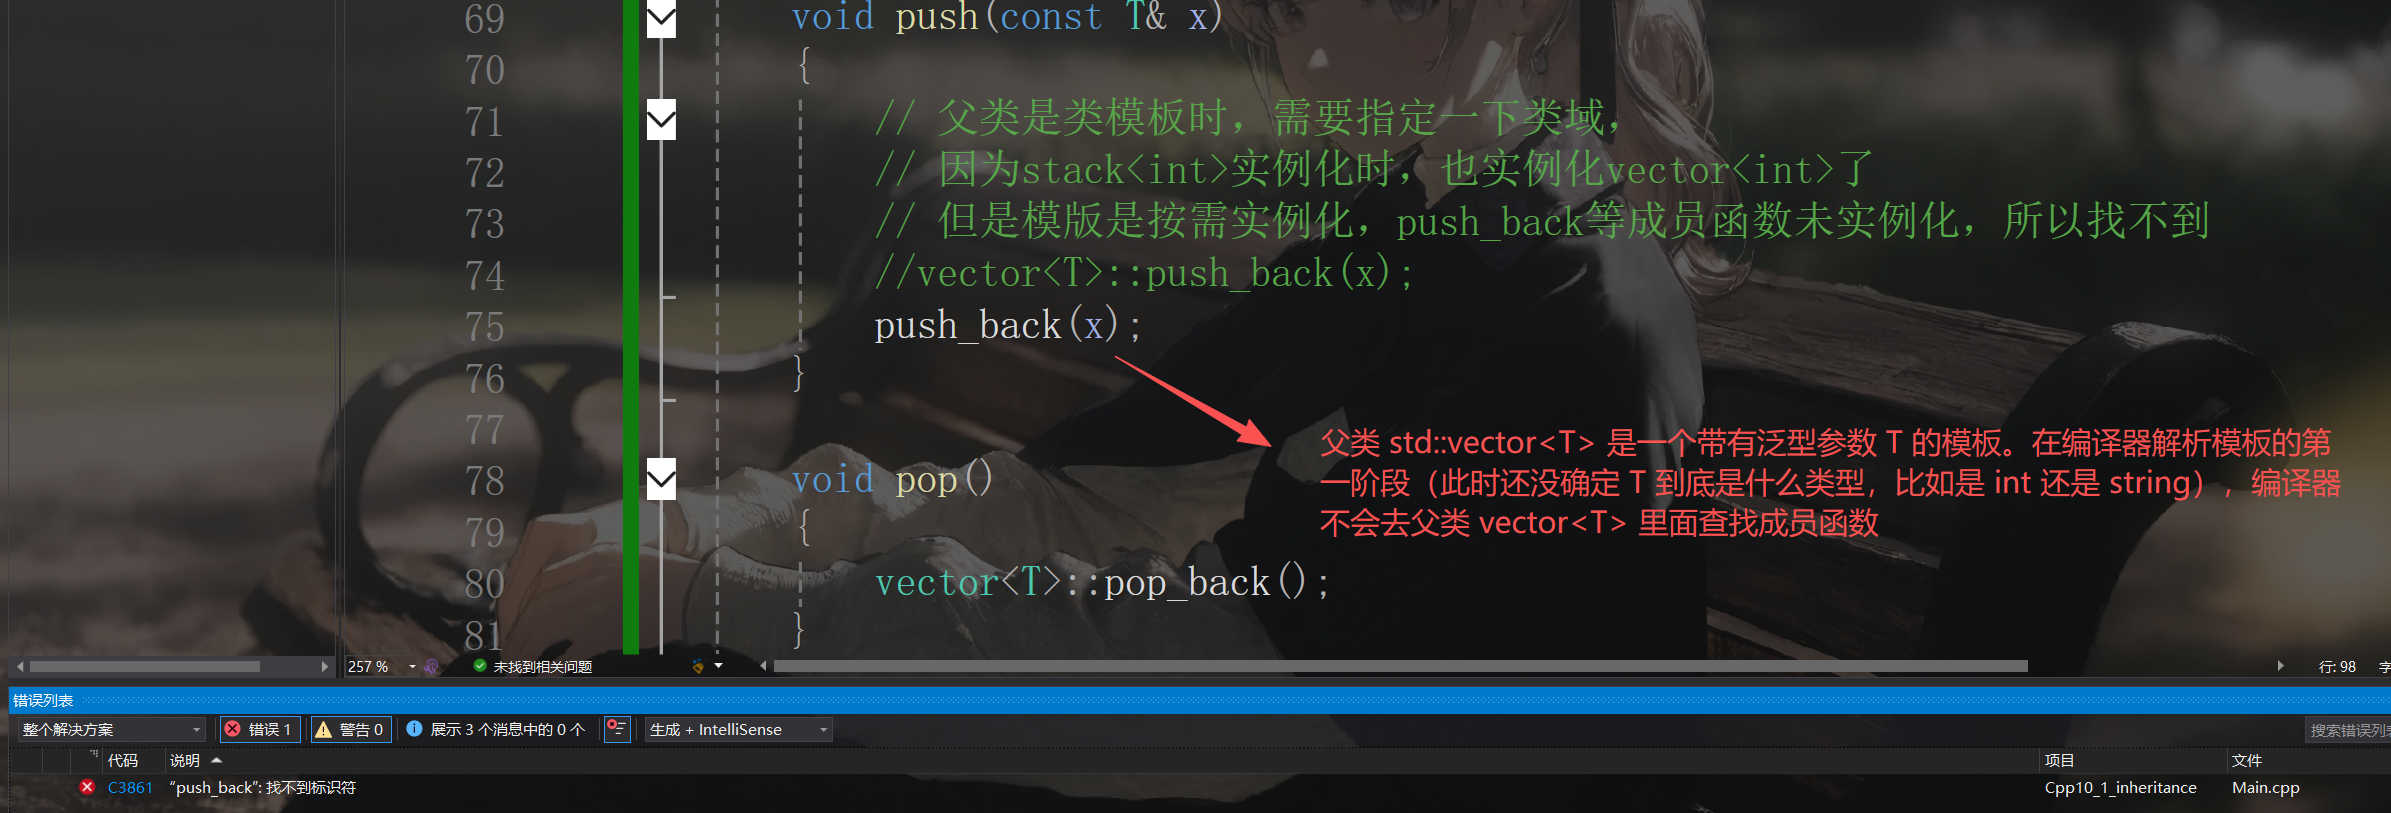
// 父类是类模板时,需要指定一下类域,
// 因为stack<int>实例化时,也实例化vector<int>了
// 但是模版是按需实例化,push_back等成员函数未实例化,所以找不到
vector<T>::push_back(x);
//push_back(x);
}
void pop()
{
vector<T>::pop_back();
}
const T& top()
{
return vector<T>::back();
}
bool empty()
{
return vector<T>::empty();
}
};
}
当基类类型依赖模板参数T时,编译器在模板定义阶段不会通过普通的未限定名称查找直接进入这个依赖基类,因此代码通过vector<T>::明确指出成员来自哪个类域。代码注释保留了比较直观的理解方式,这里再补充得准确一些:真正起作用的是依赖基类中的名称查找规则,与push_back是否已经完成实例化并不是一回事。
这样写以后,push、pop、top和empty就可以复用vector<T>提供的对应接口。这里主要是为了认识“基类也可以是类模板”,不继续展开容器适配器本身。
2.基类与派生类之间的关系
2.1赋值兼容转换
在public继承下,派生类对象可以交给基类对象、基类指针或者基类引用使用,这种规则也叫做赋值兼容转换:
void test2()
{
class Person
{
protected:
string _name; // 姓名
string _sex; // 性别
int _age; // 年龄
};
class Student : public Person
{
public:
int _No; // 学号
};
Student sobj;
Person* pp = &sobj;
Person& rp = sobj;
Person pobj = sobj;
//int a = 1;
//double b = 2.1;
//double& rb = a + b;
//基类对象不能赋值给派生类对象,这里会编译报错
//sobj = pobj;
}
代码中出现了三种不同形式:
| Person* pp = &sobj; | 基类指针指向派生类对象中的基类部分 |
| Person& rp = sobj; | 基类引用绑定派生类对象中的基类部分 |
| Person pobj = sobj; | 使用派生类对象的基类部分创建一个新的基类对象 |
前两种写法没有创建新的Person对象,pp和rp仍然关联原来的Student对象,只是通过基类的角度访问其中的基类部分。这种从派生类到基类的转换通常叫做向上转型,在公有继承下可以隐式完成。
还需要注意的一点是:
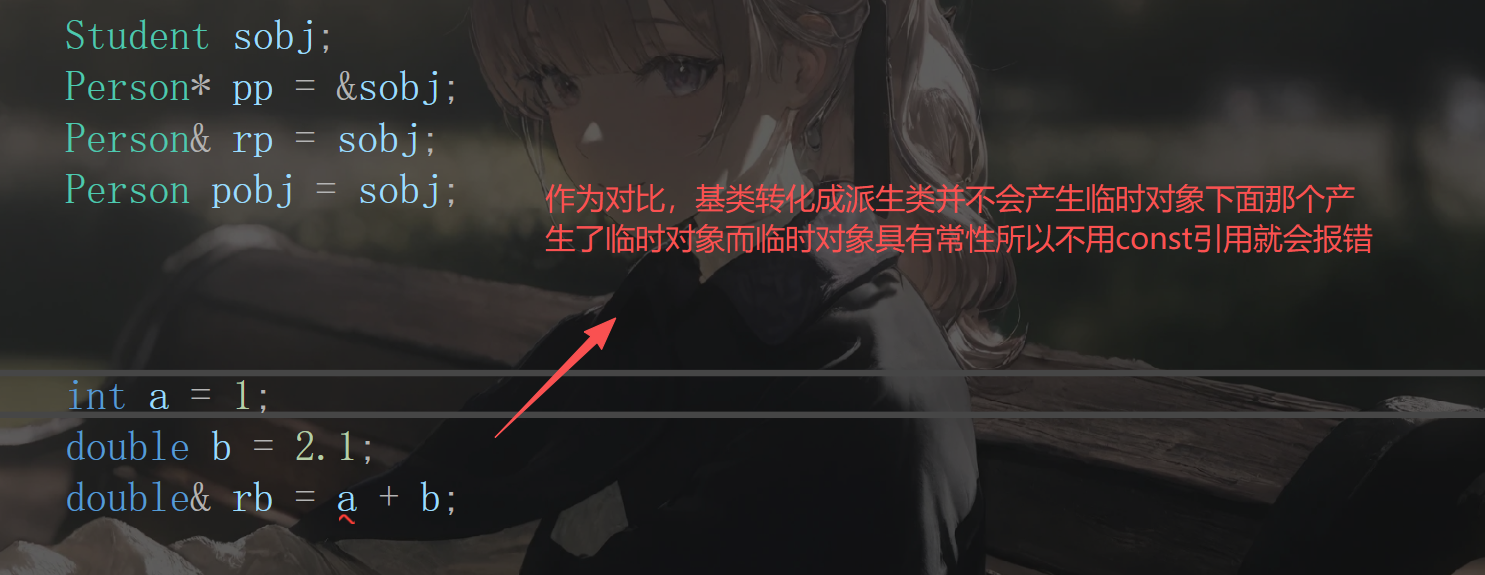
第三种写法会创建一个真正的Person对象,只复制sobj中的基类部分,Student自己新增的_No不会进入pobj,这种现象叫做对象切片。
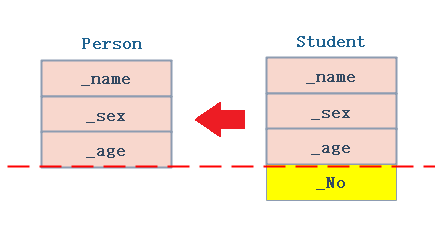
上图只是对基类部分和派生类独有部分的逻辑示意,不代表标准规定了对象成员必须采用图中的实际内存布局。它想说明的是:派生类对象包含基类部分,而复制成一个独立的基类对象时,只会留下这部分内容。
反过来,基类对象不能直接赋给派生类对象,因为一个普通Person对象并没有Student新增的_No,无法凭空补出派生类独有的数据,所以代码中的sobj = pobj会导致编译报错
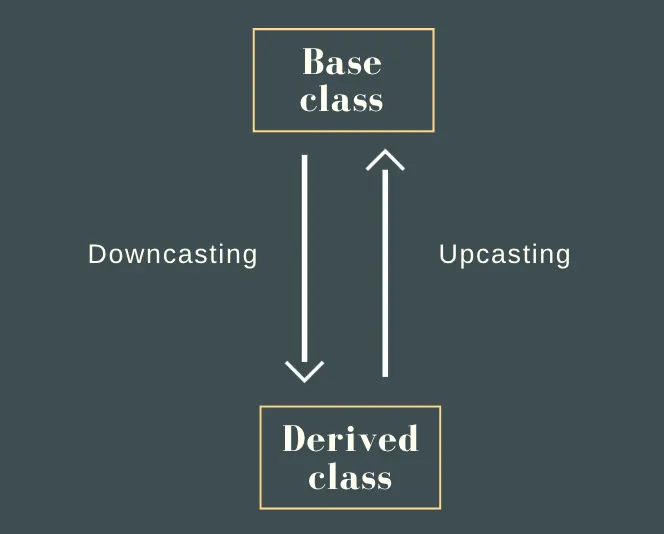
从派生类到基类的方向叫向上转型,通常是安全的;从基类回到派生类的方向叫向下转型,它不能仅凭继承关系就保证安全,本篇先不继续展开。这里最重要的是分清楚:**基类指针和引用接收派生类对象时不会发生对象切片,创建独立的基类对象时才会切片。**这也是后面继续认识多态时非常重要的一点。
2.2继承中的作用域与隐藏
基类和派生类各自拥有独立的类作用域。如果派生类重新定义了一个与基类同名的成员,派生类成员会屏蔽基类同名成员的直接访问,这种关系叫做隐藏。
分别演示了成员变量与成员函数的隐藏:
void test3()
{
class Base
{
public:
int _a = 10;
void Func()
{
cout << "Base::Func()" << endl;
}
};
class Derive : public Base
{
public:
int _a = 20; // 隐藏父类的_a
void Func(int x) // 隐藏父类的Func()
{
cout << "Derive::Func(int)" << endl;
}
void Test()
{
// 访问子类自己的_a
cout << "Derive::_a = " << _a << endl;
// 访问父类被隐藏的_a
cout << "Base::_a = " << Base::_a << endl;
// 调用子类函数
Func(10);
// 调用父类被隐藏的函数
Base::Func();
}
};
Derive d;
d.Test();
// 下面这两个func函数并不构成重载,因为父类与子类都用各自的类域
// 所以不构成重载而是隐藏
class A
{
public:
void Func()
{
}
};
class B : public A
{
public:
void Func(int)
{
}
};
}
Derive自己定义了_a,所以在Derive::Test()中直接写_a时访问的是派生类成员。想访问基类中被隐藏的_a,需要显式指定Base::_a:
Derive::_a = 20
Base::_a = 10
成员函数也是一样。Derive::Func(int)会隐藏Base::Func(),即使两个函数的参数不同,它们也不会构成重载,因为重载要求函数位于同一个作用域中。代码通过Base::Func()明确调用基类版本,完整输出为:
Derive::_a = 20
Base::_a = 10
Derive::Func(int)
Base::Func()
所以在继承体系中遇到同名成员时,首先应该想到的是隐藏,而不是重载。虽然可以通过指定基类作用域访问被隐藏的成员,但同名设计很容易增加阅读和维护成本,实际使用时应该尽量避免。
3.派生类的默认成员函数
一个派生类对象可以看成“基类部分+派生类自己新增的部分”,因此构造、拷贝、赋值和析构时,这两部分都必须得到正确处理。本篇主要关注下面四个常见成员函数:
| 构造函数 | 先调用基类构造函数,再构造派生类部分 |
| 拷贝构造函数 | 调用基类拷贝构造函数复制基类部分 |
| 赋值运算符 | 调用基类operator=复制基类部分 |
| 析构函数 | 先清理派生类部分,再自动调用基类析构函数 |
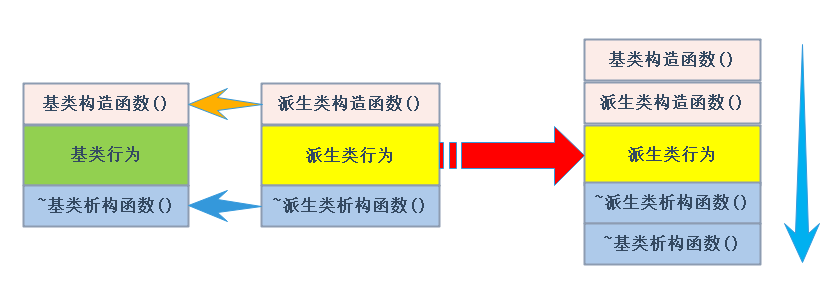
这张图表示的是普通对象在继承体系中的构造与析构顺序:构造时先基类后派生类,析构时顺序相反。下面再结合代码分别来看。
3.1构造函数
派生类构造函数不仅要初始化自己新增的成员,还要先把继承得到的基类部分构造好。如果基类没有可以直接调用的默认构造函数,就必须在派生类构造函数的初始化列表中显式调用合适的基类构造函数。
test4中的Person只提供了一个带参数的构造函数,因此Student通过Person(name)完成基类部分的初始化:
void test4()
{
class Person
{
protected:
string _name;
public:
// 这是一个带参构造函数。
// 因为我们手动提供了这个函数,编译器将不会再自动生成无参的默认构造函数
Person(const char* name)
: _name(name)
{
cout << "调用了基类 Person 的带参构造函数, 初始化 _name: " << _name << endl;
}
};
//子类
class Student : public Person
{
protected:
int _num;
string _addrss;
public:
// 派生类的构造函数
Student(const char* name, int num, const char* addrss)
: Person(name) //在初始化列表中显式调用基类的带参构造
, _num(num)
, _addrss(addrss)
{
cout << "调用了派生类 Student 的构造函数" << endl;
}
};
// 创建子类对象时,会先调用父类构造,再调用子类构造
Student s("李白", 1314, "王者峡谷");
}
创建Student对象时,虽然代码看起来只调用了Student的构造函数,但是执行顺序一定是先构造基类部分,再执行派生类构造函数体:
调用了基类 Person 的带参构造函数, 初始化 _name: 李白
调用了派生类 Student 的构造函数
这里还需要注意,基类部分的构造顺序由继承关系决定,并不会因为初始化列表中的书写位置改变。只有基类部分构造完成以后,派生类新增的成员和构造函数体才能继续处理。
3.2拷贝构造函数
派生类进行拷贝构造时,同样需要先调用基类的拷贝构造函数完成基类部分的复制,再复制派生类自己新增的成员。
Student(const Student& s)通过Person(s)调用Person的拷贝构造,再用_num(s._num)复制自己的学号:
void test5()
{
class Person
{
protected:
string _name;
public:
// 基类的普通带参构造
Person(const string& name) : _name(name)
{
cout << "调用了 Person 的普通构造函数" << endl;
}
// 基类的拷贝构造
Person(const Person& p) : _name(p._name)
{
cout << "调用了 Person 的拷贝构造函数, 拷贝了 _name: " << _name << endl;
}
};
class Student : public Person
{
public:
int _num;
// 子类的普通带参构造
Student(const string& name, int num)
: Person(name)
, _num(num)
{
cout << "调用了 Student 的普通构造函数" << endl;
}
Student(const Student& s)
: Person(s)
//显式调用父类拷贝构造并将子类对象 s 传进去(触发切片/向上转型)
//如果不写 Person(s),编译器会偷偷这样调用无参构造导致_name为空
// : Person()
, _num(s._num)
{
cout << "调用了 Student 的拷贝构造函数, 拷贝了 _num: " << _num << endl;
}
void printInfo()
{
cout << "当前学生信息 -> 姓名: " << _name << ", 学号: " << _num << endl;
}
};
Student s1("李白", 1314);
s1.printInfo();
// 此时会触发 s2 的拷贝构造函数
Student s2 = s1;
s2.printInfo();
}
Student对象可以绑定到const Person&,所以Person(s)会让基类拷贝构造函数取得s中的基类部分,并复制其中的_name。这里不会复制Student独有的_num,它仍然由派生类自己的初始化列表负责。
分别创建s1和s2以后,输出为:
调用了 Person 的普通构造函数
调用了 Student 的普通构造函数
当前学生信息 -> 姓名: 李白, 学号: 1314
调用了 Person 的拷贝构造函数, 拷贝了 _name: 李白
调用了 Student 的拷贝构造函数, 拷贝了 _num: 1314
当前学生信息 -> 姓名: 李白, 学号: 1314
派生类自己实现拷贝构造时,如果初始化列表中省略基类,编译器会尝试默认初始化基类部分。当前Person只提供了带参构造和拷贝构造,并没有无参的默认构造函数,因此这里必须写出Person(s),否则代码无法通过编译。
3.3赋值运算符与析构函数
派生类的赋值运算符也要分别处理基类部分和派生类部分。test6先通过Person::operator=(s)复制基类中的_name,再复制Student自己的_num:
void test6()
{
class Person
{
protected:
string _name;
public:
Person(const string& name) : _name(name) {}
Person& operator=(const Person& p)
{
if (this != &p) {
_name = p._name;
cout << "调用了 Person 的 operator=" << endl;
}
return *this;
}
~Person()
{
cout << "调用了 Person 的析构函数" << endl;
}
};
class Student : public Person
{
public:
int _num;
Student(const string& name, int num) : Person(name), _num(num) {}
Student& operator=(const Student& s)
{
if (this != &s) {
// operator=(s);
// 会发生无限递归死循环!因为派生类的 operator= 隐藏了基类的
//指定基类作用域,显式调用基类的赋值运算符完成基类成员的复制
Person::operator=(s);
_num = s._num;
cout << "调用了 Student 的 operator=" << endl;
}
return *this;
}
~Student()
{
// 这里不需要显示调用父类的析构函数,子类析构会
// 自动调用父类的析构函数
cout << "调用了 Student 的析构函数" << endl;
}
};
Student s1("张三", 1001);
Student s2("李四", 1002);
s2 = s1;
}
派生类的operator=会隐藏基类中的同名operator=,所以这里必须指定Person::作用域。如果在Student::operator=内部直接再次调用未限定的operator=(s),就会重新进入当前函数,形成无限递归。
析构函数不需要手动调用基类析构。Student析构函数体执行完成以后,编译器会自动继续调用Person析构函数,保证派生类自己新增的部分先清理,基类部分后清理。
运行结果如下:
调用了 Person 的 operator=
调用了 Student 的 operator=
调用了 Student 的析构函数
调用了 Person 的析构函数
调用了 Student 的析构函数
调用了 Person 的析构函数
前两行说明赋值时先处理基类部分,再处理派生类自己的成员。后面两组析构输出来自s2和s1,局部对象会按照创建顺序的逆序离开作用域,而每一个Student对象内部又会先执行派生类析构,再执行基类析构。
到这里,继承体系中最基础的对象关系就比较清楚了。继承让派生类能够复用并扩展基类,向上转型让基类指针和引用可以接收派生类对象,而构造、拷贝、赋值和析构则负责正确处理对象中的基类部分与派生类部分。这些内容正是后面继续认识多态的重要基础,剩下的内容再放到后续文章中展开。
完