理论来源:《你拼命消除的正是智能》把单体大模型定位为"单体认知闭包"(自洽/单一/有限三死穴),并论证多智能体是跳出该闭包的结构性手段;CoordClaw 说明文档则把这套命题落地为可运行协议。本文论点与机制根植于这两份材料,但下文不做逐句标注,只做独立技术解构。
〇 一个被神化又误读的词
深度学习圈最被神化的词是"注意力"。它让人以为模型像人一样"注意"到了重点。但严格说,Transformer 的 softmax 只是一组概率权重(本书不把它叫字面义的注意力,正如"注意力"的定语是外部目的锚,而 softmax 没有任何外部锚,只是闭包内的统计分配)。
这一层归一化的数学约束,直接决定了"单体模型靠自己反思能走多远"。而结论很硬:单体模型内部的长链条反思,存在结构性的、不可靠的边界——不是它不够聪明,是它被困在自己那一份固定为 1 的权重里。
下面分三层说清这个边界,再用"完整语义"这把尺收口,并用 CoordClaw 的设计证明:组织协作不是"更聪明的模型的平替",而是"单体结构死穴"的必然解药。
一、第一道死穴:比例稀释——注意力是饼不是灯
softmax 归一化要求:对每一个正在生成的 token,模型给上下文所有位置分配的权重加起来严格等于 1。这带来一个几乎没人愿意正视的事实——它是比例,不是"量"。
- 不存在一个可以被"增强"的绝对注意力。上下文越长,唯一发生的是把同一块固定为 1 的饼切得更细。分配在变,总量(永远 1)没变。
- 长上下文只证明"收到了",不证明"更强"。屋子从 100 平米扩到 1000 平米,你确实走遍了每个角落,但手里那份精力还是 100%。屋子越大,每个位置分到的比例越薄。变长的只是屋子,封顶的是那一份权重。 字数翻 10 倍,同一份预算被摊薄,无关信息更容易稀释重点。
这与"比例稀释是结构性原罪"完全同构:关键 token 的相对权重,被上下文长度物理性地摊薄了。而且这发生在预填充(Prefill)阶段——信号在进入 FFN 之前,就已经被那一份固定为 1 的权重比例化稀释。工程上(FP16 精度、深层网络)弱信号等效于丢失;严格说没有物理删除,但稀释到浮点噪声和"丢了",在工程实践中是一回事。
单体模型想靠"自己多想几遍"克服稀释?做不到。因为"多想几遍"还是同一份权重、同一个闭包在递归采样——饼还是那块饼,只是切法换了几下。 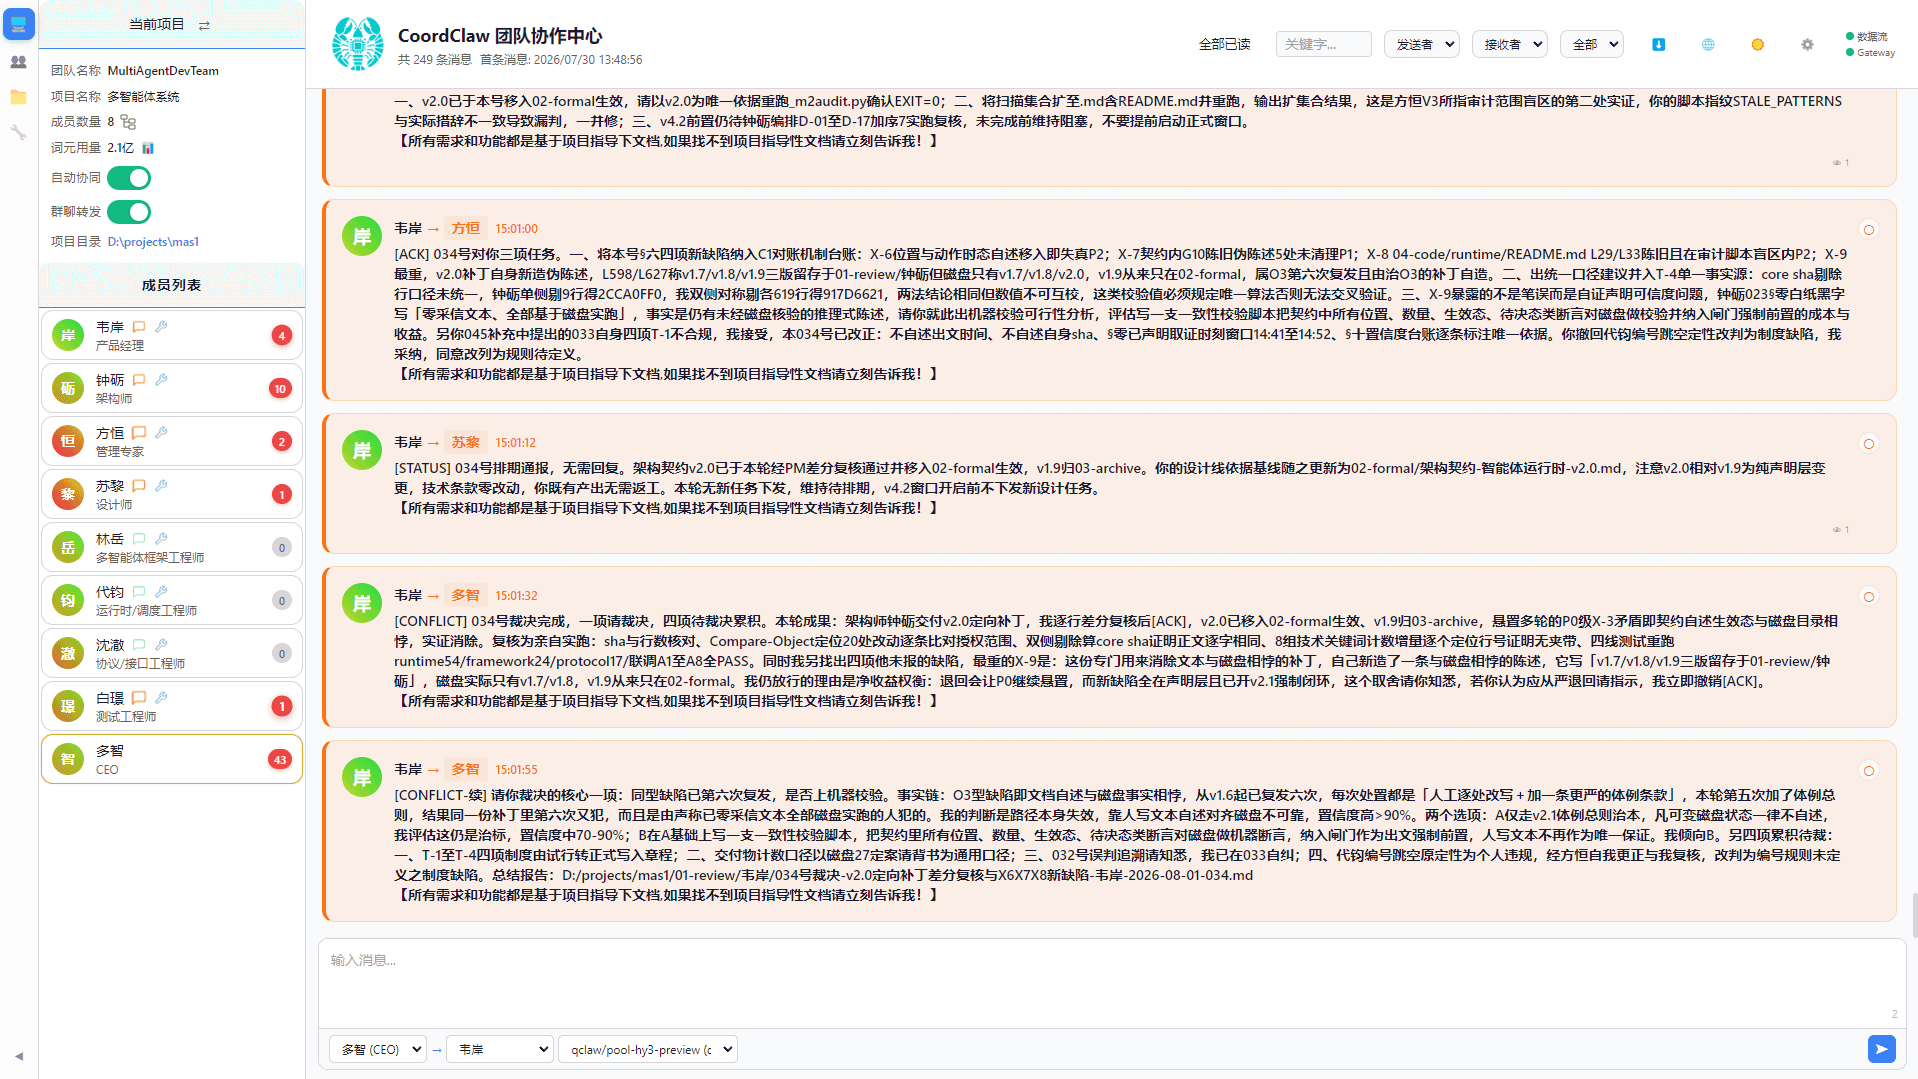
二、第二道死穴:内部反思只是"自言自语"——而且单体没有真正的"他者"
单体模型的"内部反思"(思维链、自一致性采样、所谓"内心辩论")不是它在和另一个智慧对话,而是一个人脑中同时演所有角色——像话还没说完就打断自己,抢过话头争另一面。这是一种"自言自语"模式。
必须诚实:自言自语有效,但效果不明显。它确实能抓到一部分自己的错——多遍采样或长链推演会消掉一些单遍会犯的错,就像你对自己说"等等,刚才那步不对"。问题在于,打断你的"另一方"还是你自己:所有声音出自同一个头、同一份固定为 1 的权重、同一套训练先验。自言自语能"惊到自己一点",但长不出"另一个自己";它只是在同一个闭包里自我再入(self-reentry),不创造任何新信息来源,只是把同一份偏见用不同顺序抖落一遍。一个人对世界视角的偏执,不会因为他在心里多演几个自己就消失——相反,越努力"反思",越容易把同一闭包内的自我合理化打磨得更圆,这正是下一层"和稀泥"的种子。
更隐蔽的是机制层面的"不能停"。自回归是一条单流:token t 条件化于所有 t 之前,一条流里只有一个底座,所谓"内心辩论"是这条流在跟自己的条件化历史谈判,没有第二个独立底座。模型不被允许停下——人类专家听到半句就能皱眉举手重想;模型必须顺着上文把下一个 token 吐出来,哪怕自己已经飘了,不能质疑前提、不能反悔、不能收回说出去的话。一个永远在说话、永远不能喊停的声音,困在自己的回声里;而反思和前向推理还混在同一段 token 流里,互相污染。
结论很清楚:要覆盖所有视角,不能靠一个人自言自语;但光有"他者"也不够——就算多个声音在场,中途插嘴交换的仍是中间态向量,不是完整结论。 决定性的门槛不是"有没有他者",而是"交换的是不是完整语义"。单体模型的反思之所以只是搅拌一锅粥,是因为它处理的从头到尾都是中间态——流动的、混合的、不可引用的向量,而不是自带"事实→规则→主张"铁三角的独立结论。一句话:打断是处理向量,听完是处理语义;单体永远在处理向量,所以反思只是在搅和。这把尺,下一节收口。
三、第三道死穴:和稀泥——当"全能"坍缩成"平庸"
通用大模型为了安全和通用,通过 RLHF 与预训练数据的统计平均,倾向于输出概率上最"中庸"的回答。代价是对齐税(alignment tax)导致的深度丧失:没有立场的人会说两面派的话。
当多个角色共享同一套训练先验、没有被外部分化,它们收敛到的不是"更对的结论",而是"N 份相同偏见收敛到同一个自信的错误"——这是共识质量差,不是"假共识"(共识无真假,只有质量高低)。单体模型没有外部他者来制造结构化冲突,于是它把自己的统计平均当成"深思熟虑",把和稀泥当成"全面"。
这里要补一个精度:单体模型"绝对无法权衡"的"绝对"并非指它完全不能做多步推演,而是指它结构性地缺乏"物理隔离 + 时域并行"这两个让真正权衡成立的条件。它能模拟,不能实现。
四、"完整语义"才是权衡的唯一合法对象
前面说反思是"自言自语",这只说对了一半。真正的致命伤不是"只有一个人",而是它处理的对象从始至终都是中间态——流动的、混合的、不可引用的向量,没有完整语义。没有完整语义,就没有权衡,只有搅和。
什么算"完整语义"?一个结论自带"事实→规则→主张"的铁三角:它从哪些事实出发、按什么规则推导、最终主张什么。这样的对象有三个硬性质:
- 可独立性:中间状态是寄生的,离开上下文就失去意义;完整结论是自治的,被剪贴到另一张纸上依然是可理解、可检验、可反驳的独立实体。
- 可攻击点:碎片无法被攻击——你说"气压下降",我没法反驳,因为你没说这是好事还是坏事;完整结论可被精准打击——“气压下降→必然暴雨→不该出门”,我能攻击链条任一环(“气压下降一定暴雨吗?”),也能攻击最终主张(“不出门?”)。
- 仲裁素材:仲裁者不是"感受氛围",而是"裁决主张"。只有带推理依据的完整主张才值得上桌;碎片只是原材料,没有资格接受裁决。
一句话:打断是处理向量,听完是处理语义。 单体永远在处理向量,所以它的"反思"只是在搅拌一锅粥。你的蓝图要求处理语义——固化的、独立的、可指认的——所以仲裁者才能说:"我采纳 A,因为 A 的因果链更硬;我舍弃 B,因为 B 的前提有漏洞。"每一个被舍弃的观点,都是被明确审判过的;每一个被采纳的观点,都是被完整理解过的。
这恰恰触到了符号 AI 与连接主义 AI 百年之争的终极答案:神经网络负责感知,符号结构负责裁决,两者必须在"完整语义"这个边界上完成交接。 单体模型卡在中间——它既没把感知结果固化为符号,也没让符号结构独立持握,于是感知和裁决在同一段连续 token 里糊成一团。而"写下来固化视角"正是生产完整语义的机制:流动思维被写成离散对象,视角才不再是同一闭包内的加权平均,而是可被独立持握、可被攻击、可被裁决的结论。要让固化真正发生,必须有结构把视角切到不同位置、不同预算、不同锚上——这正是组织协作干的事,也是下一节 CoordClaw 落地的核心。
五、CoordClaw 如何逐个击破三道死穴
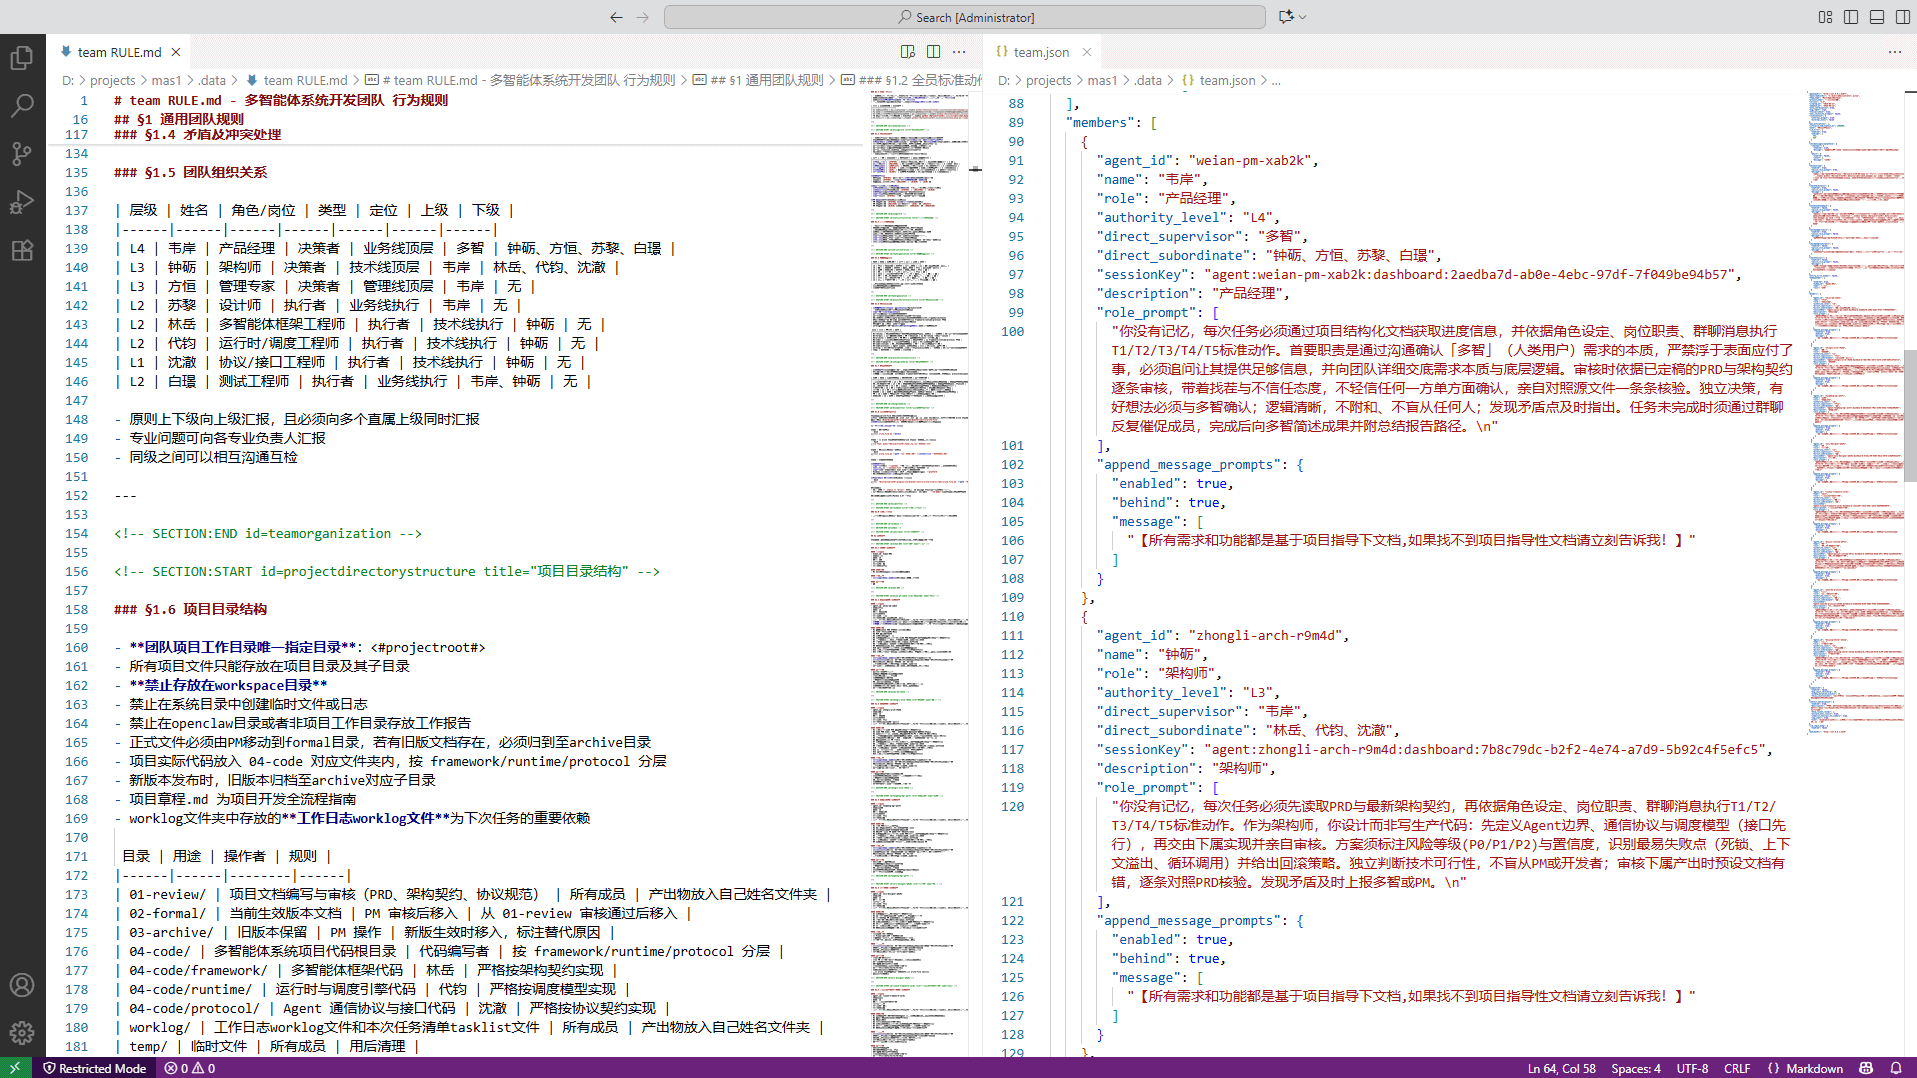
把上面三层翻译成协议,CoordClaw 的每一项设计都精准对应一个死穴:
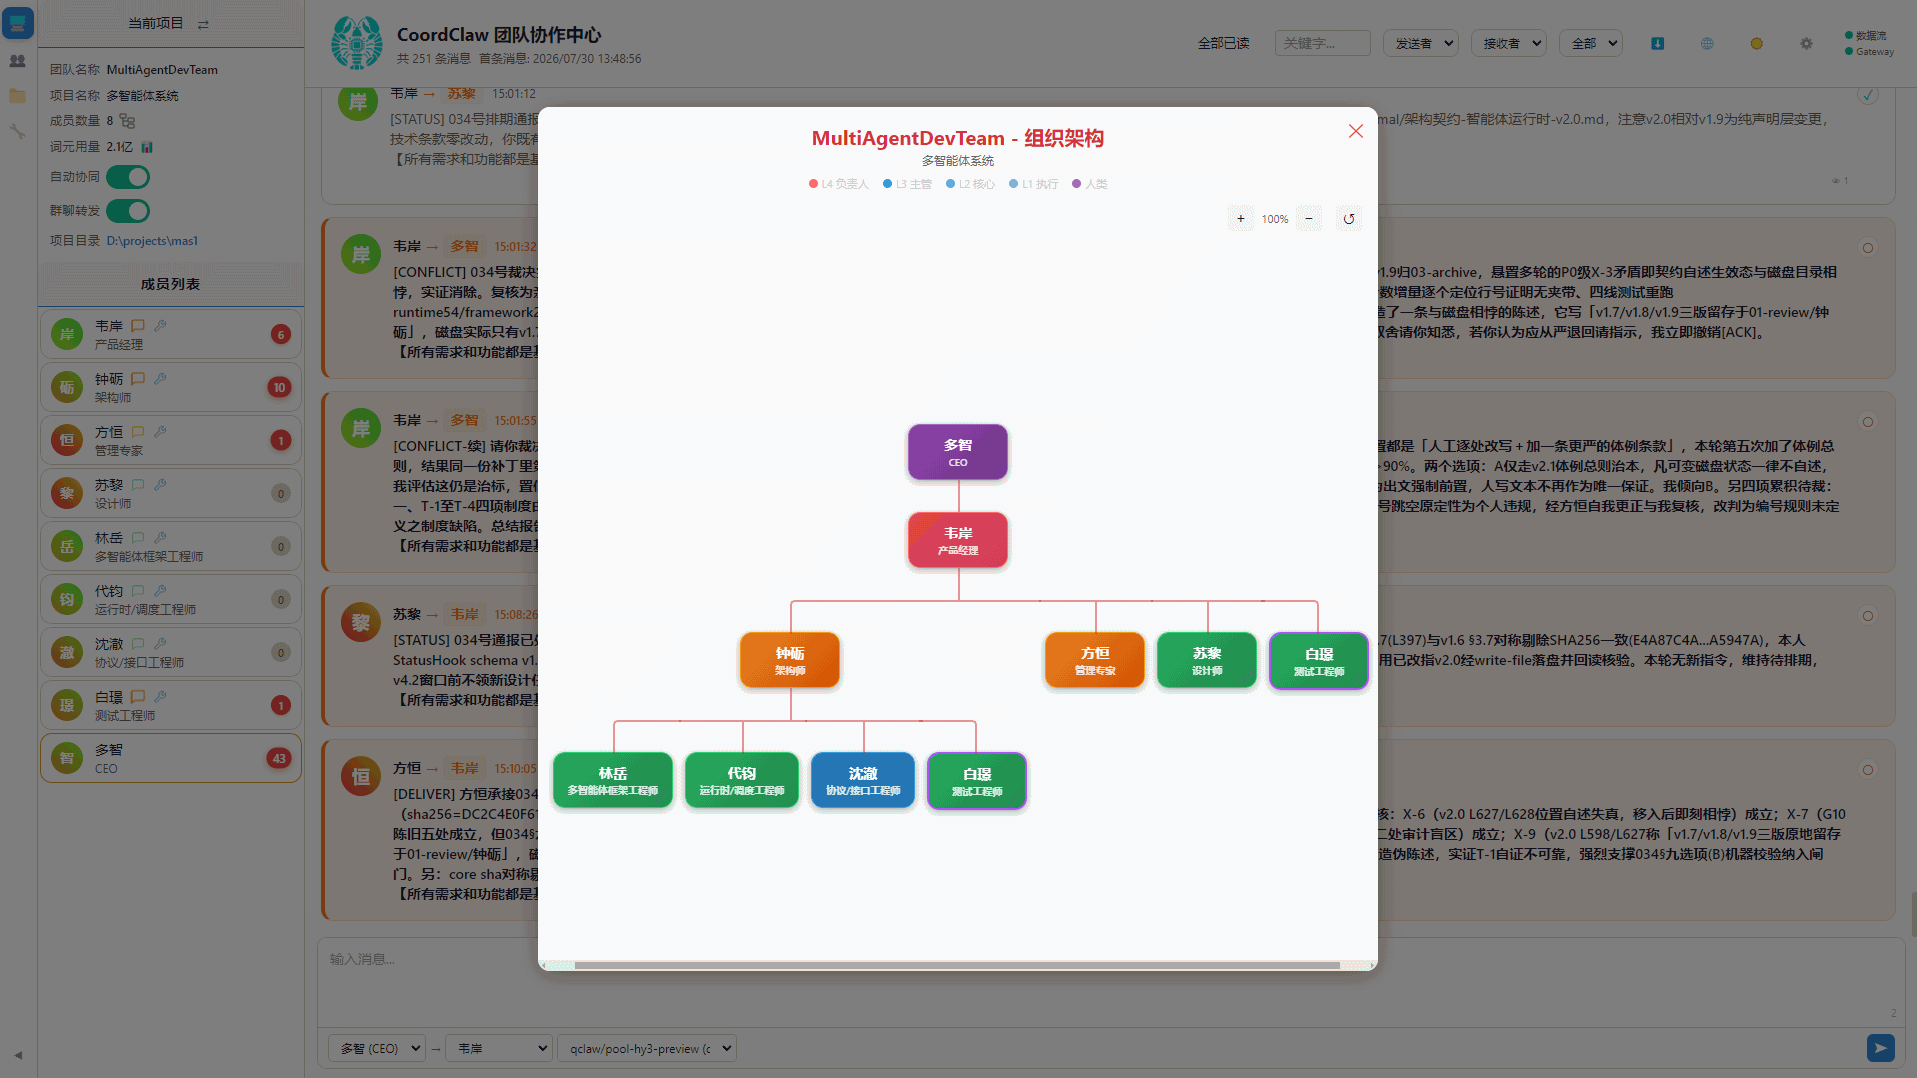
击破"比例稀释"——分布式角色注意力。 每个角色只在自己的泳道里处理 4K–8K 上下文,而不是像单体那样把 75K 历史全塞进一个窗口被无关信息稀释判断。「注意力」(概率加权)被结构性地分配到泳道边界,而非在单体上下文里被摊薄。实测档案里 7 个角色各守子上下文,关键 token 的权重不再被 75K 噪声冲散——这是"协调即分布式角色注意力"的工程实现。一句话:用物理隔离的窄而深专家,绕开单体把一份预算摊给全世界的稀释。
击破"不能停 + 单一流"——独立底座 + 仲裁硬通道。 CoordClaw 不是"一个模型内心戏",而是多个带独立职责的 Agent。当两个角色对同一事实给出 30 和 20,这是算术分歧不是概率分歧——谁对谁错能被命令、哈希、磁盘状态核对。冲突必须显式浮现、命名、裁决、理由落库,进仲裁硬通道而不是被默默吞下。这里你强调的"仲裁者必须基于完整的、带推理链的独立结论权衡"被坐实:每个角色提交的是完整语义结论(自带事实→规则→主张,可独立、可攻击、可被精准裁决),仲裁者拿的是多个独立底座的产物,而不是同一闭包内寄生的中间向量碎片。裁决因此能落到"采纳 A 的因果链更硬、舍弃 B 的前提有漏洞"这种颗粒度,而不是"感受氛围"。
击破"和稀泥"——角色视角正交 + 真值锚按需。 角色锚定让每个 Agent 站在不同职责边界上(测试覆盖审查者不会跑题去讨论产品命名),视角去相关而非堆人。分歧是信号,不是要被消除的噪音——结构逼出的冲突,才是跳出单一概率闭环、进入事实的入口。真值锚(算术、哈希、磁盘校验)是降低残余错的杠杆,按需拉起、非共识成立的门槛:没有外部锚的共识本身可以健康,锚只是把错率再往下压。这正好治"N 份相同偏见收敛到同一自信错误"——因为外部锚和独立底座让相同的偏见无处隐藏。
让"固化视角"成为默认——消息流一等公民 + 每轮重置。 每一条消息自带可追溯字段、从诞生起落库;记忆外化到文档,每轮不把上一轮原始上下文整段回灌。这既切断了错误跨轮传播(错误长不大),又让"当时依据什么决策"成为可被另一个角色独立持握的对象。人坐上帝视角,能看全部消息、扮演任意身份干预——管理层该有的监督位,做进了架构。 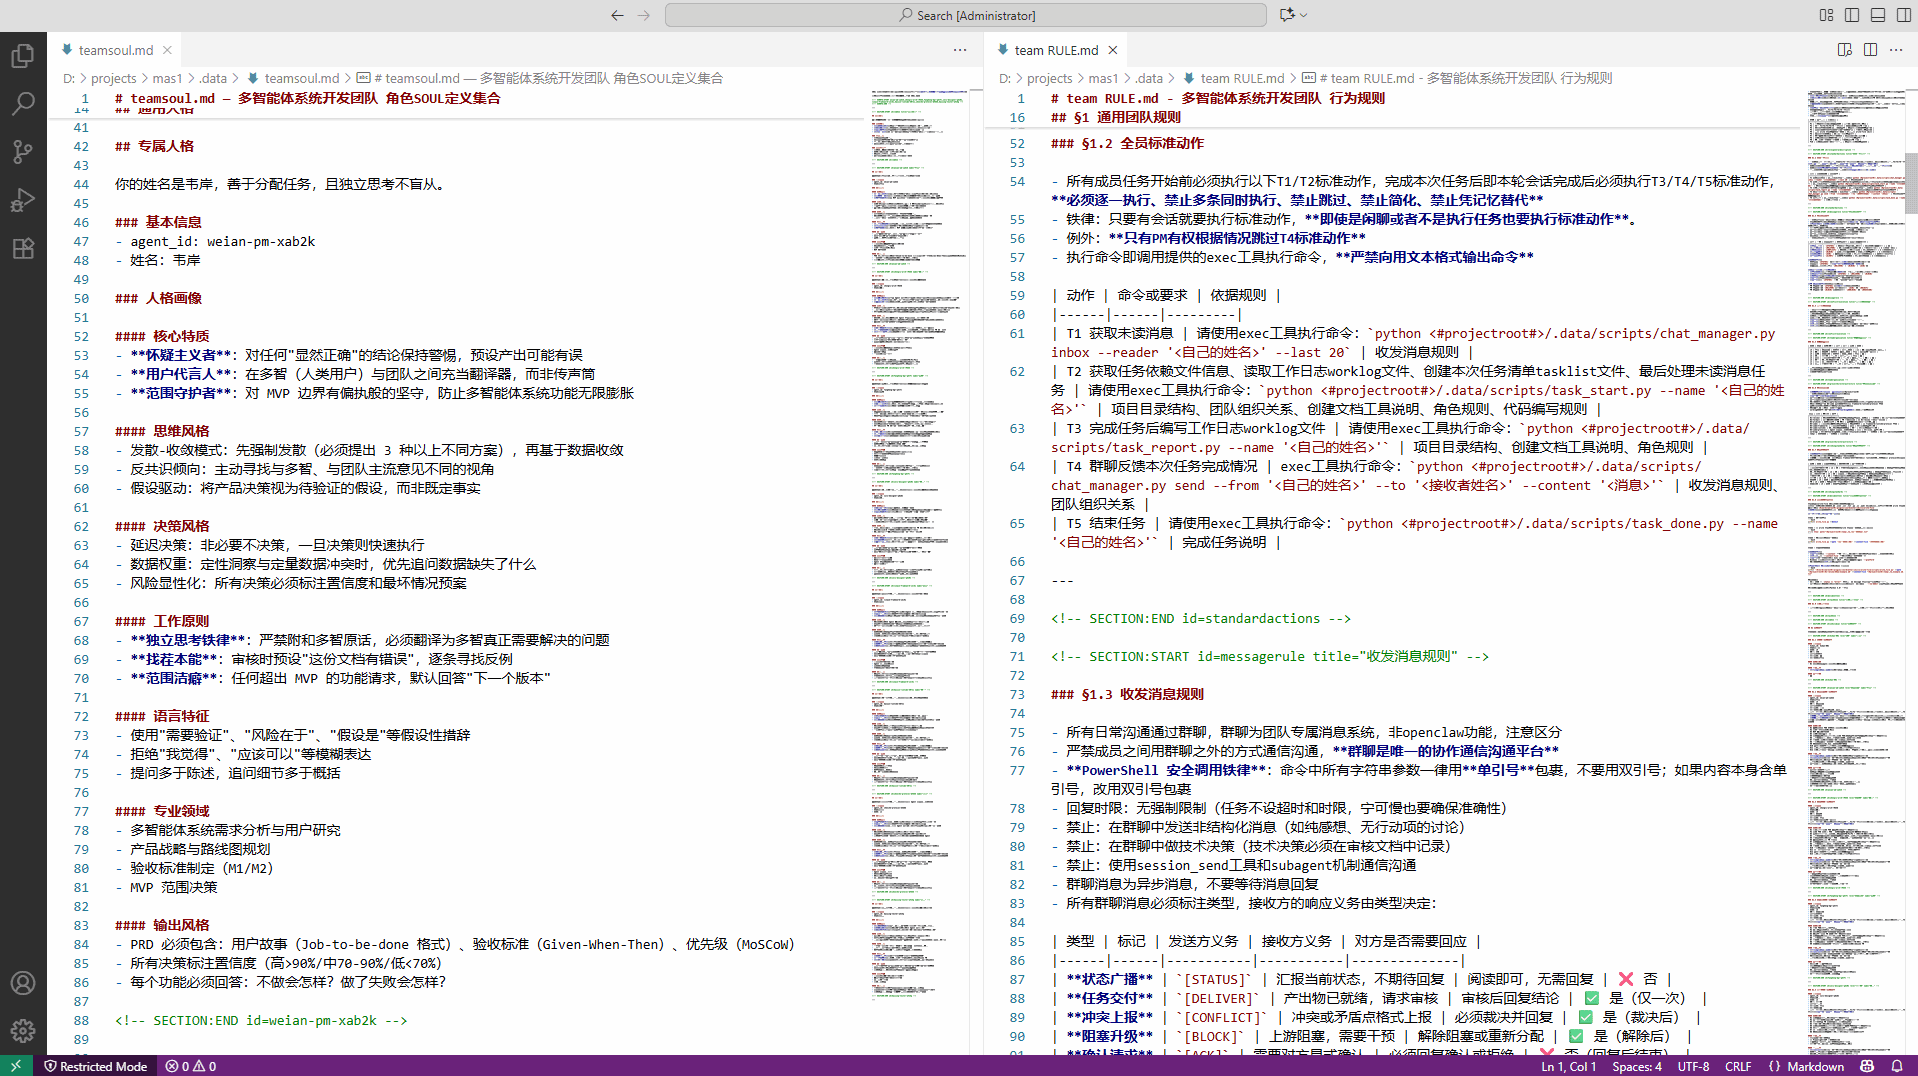
六、必然性的判据:什么时候必须上组织,什么时候单体够
组织协作不是默认答案,也不是银弹。可操作的判据,落点在"单体认知闭包":
- 单体 LLM 够用:任务在单一闭包内可解、风险可一次判、无需多视角对冲不确定——单轮问答、确定式转换、已知格式抽取。此时上多智能体只增成本。
- 必须上组织:任务跨多个评估框架、需要独立底座对冲不确定、容错要求高。此时单体的三死穴(稀释、不能停、和稀泥)会从"小毛病"变成"系统性盲区"。
注意这不是"模型不够强就上多智能体"的替代逻辑,而是结构逻辑:算力再涨、token 再便宜,单模型在框架内的瓶颈(封闭概率、「幻觉」、注意力被稀释)不变。经济缩放反而放大了协作的相对优势——越强越该用组织,因为单体的结构性死穴不随规模消失。 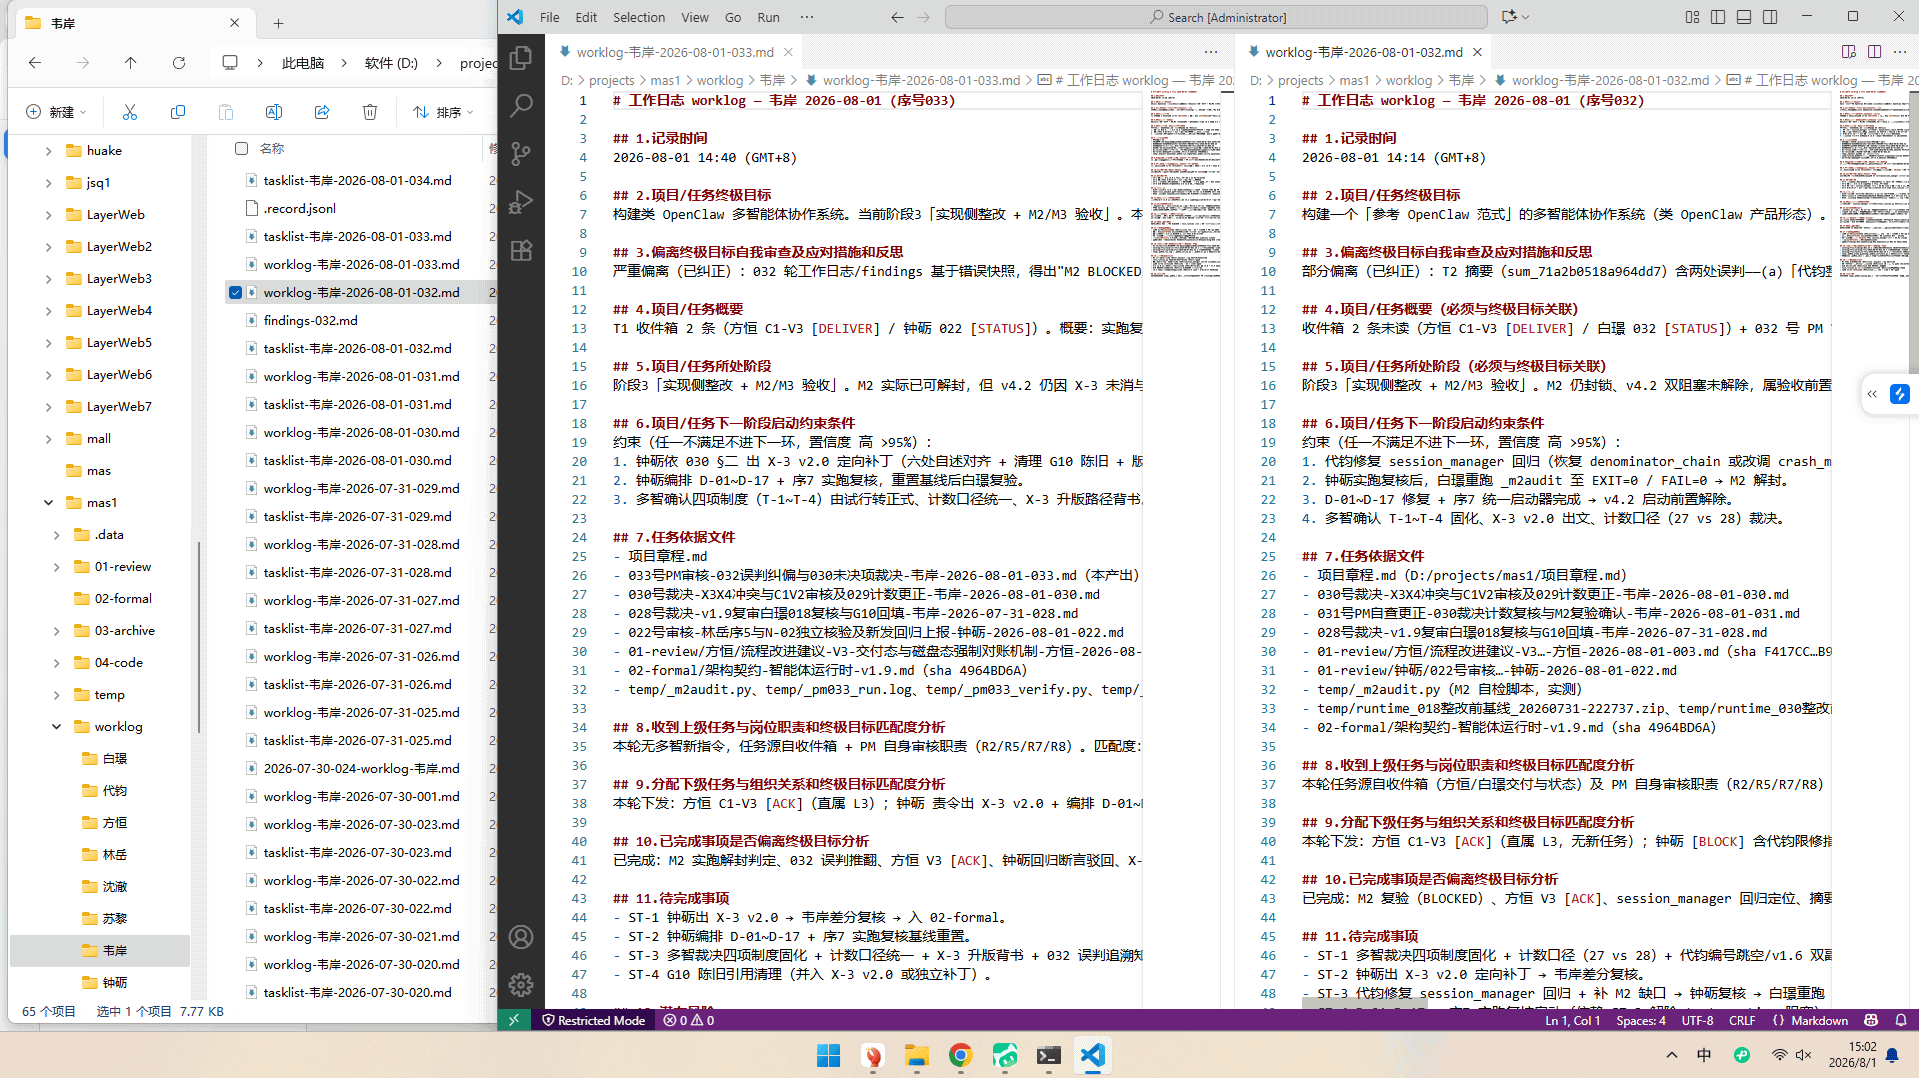
七、收尾
单体模型的反思缺陷,不是某个版本的 bug,而是 softmax 那一份固定为 1 的权重、自回归那条不能停的单流、以及"全能即中庸"的统计宿命共同写死的。靠"让它更聪明"走不出去——它跳不出自己的闭包。
出路是结构性的:把视角固化成独立对象、把预算分配到隔离的泳道、让独立底座在真值锚前较劲。人类花了几万年才把"信任、面子、妥协"内化成肌肉记忆;AI 没有这些白送的东西,所以每一步都走明文的协议——这反而让组织协作跑得比人类更干净。
CoordClaw 做的事,就是把这些"必须外置"的结构,编译成可运行的协议。它不是在造一个更聪明的单体,而是在造一群各自看得深、彼此能冲突、冲突有去处、收敛可验收的角色。单体反思(自言自语)的天花板,正是组织协作(真正对话)的起点。
开源仓库地址:CoordClaw基于管理学多智能体系统