版本 v1.1 · 面向架构评审与团队落地的设计基线文档
0. 文档说明
本文档沉淀一套面向金融行业的 Data Agent 设计。Data Agent 在这里的定位是:
企业级「上下文供给层」——统一汇聚多源异构数据,经治理、归一、加权、仲裁后,向投研 / 风控等上层领域 Agent(LLM)输出带溯源、可审计、可治理的可信上下文。
它不是「一个会写 SQL 的聊天机器人」,而是一个受治理的数据服务节点:对内整合 9 类数据形态、执行 7 条检索中策略、运行 6 条事后质量策略;对外提供 3 项核心能力(供给 / 标记 / 审计)。
设计遵循三条原则:
领域可宽、单体必窄:对外是重磅领域平台,对内是精细分工的系统(编排者 + 窄专家 + 横切控制面)。
可治理优先于智能化:没有语义层与治理底座,Agent 只会把垃圾放大、把不一致固化。
闭环重于单次正确:系统必须能「越用越强」——这是事后 6 条策略存在的理由。
1. 背景与定位
1.1 背景
金融行业中,数据复杂、数据量大、结果质量对原始数据依赖度高,这就不得不让我们考虑使用一个 Data Agent 来做这件事。当然也可以包括多个 sub-Agent(主从模式)。
1.2 怎么定义这个 Data Agent?
Data Agent 的职责 = 产出一份带溯源的可信上下文包(Evidence)[1],而不是把原始数据倒给领域 Agent。
Data Agent 输出的数据必须输送给审计系统服务——对应对外能力③的数据审计,即事后数据血缘审计、LLM 上下文审计、合规/越权审计。这是金融合规的刚需,也是「可治理」的体现。
1.3 数据领域专用 Agent 的定位
-
领域:专注数据任务(取数、清洗、分析、可视化、归因)
-
工具集:SQL / 数仓 / BI / 语义层 / 数据治理工具
-
能力边界:能规划分析路径、自我纠错(基于「推理—行动」协同的智能体范式)[2]
1.4 与上层领域 Agent 的关系
Data Agent 作为「上下文供给层」,向投研 / 风控等上层领域 Agent(LLM)输出带溯源、经治理、可审计的 Evidence;领域 Agent 基于 Evidence 做业务推理与决策。二者分工清晰:
Data Agent 管「正确的数据以正确的形式进入上下文」;领域 Agent 管「基于可信上下文做业务决策」。
2. 总体架构
2.1 整体架构图(技术视图)
【图 2.1 整体架构图(技术视图)】
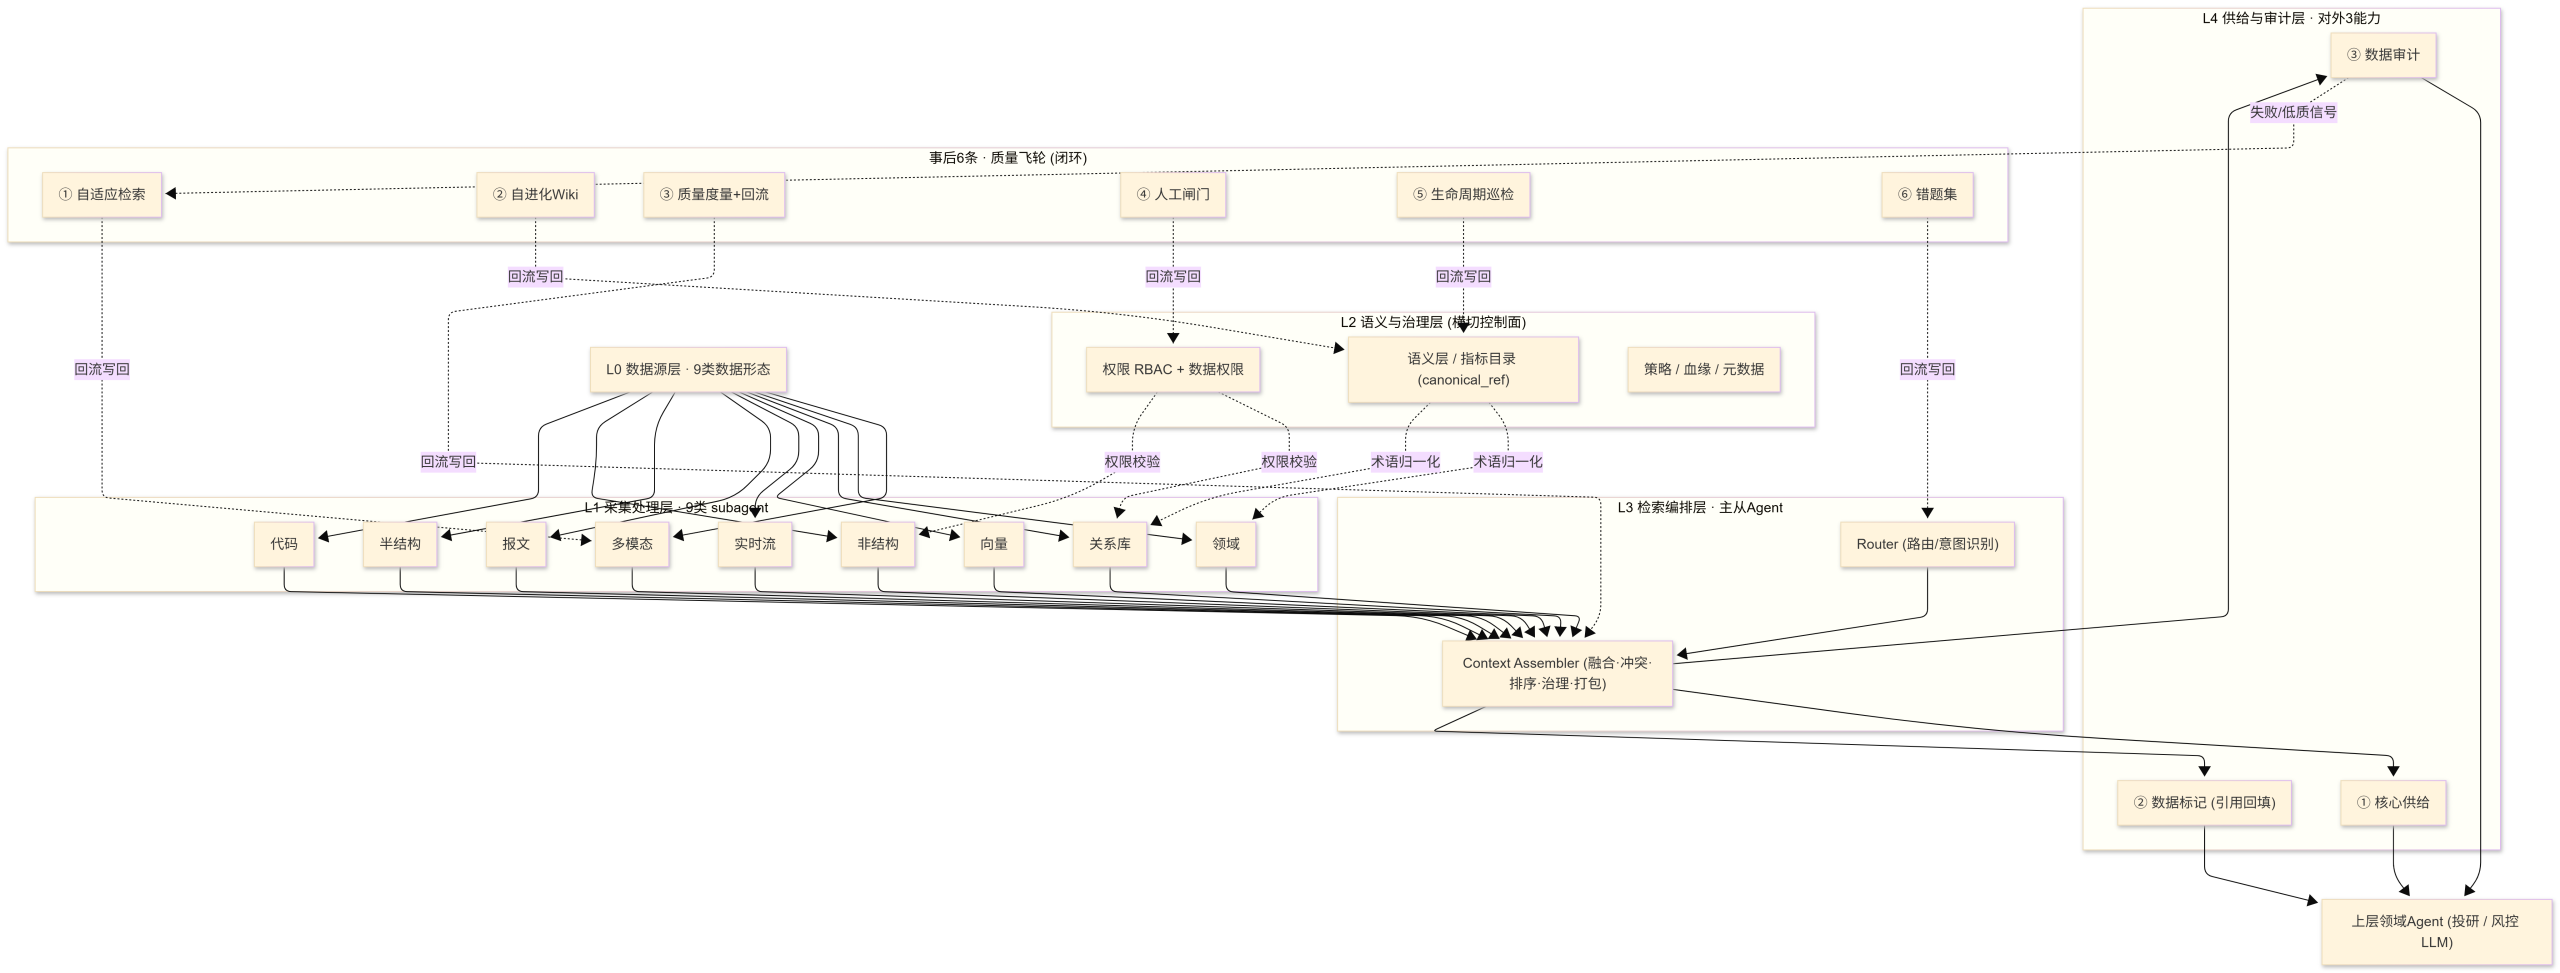
分层说明
-
L0 数据源层:9 类数据形态(§3)。
-
L1 采集处理层:9 类 subagent,各自对接一类数据源,出口按 Evidence 契约归一。
-
L2 语义与治理层:横切控制面(非数据类型),承载术语归一化、权限、策略、血缘。
-
L3 检索编排层:Router + Context Assembler,负责路由与收口。
-
L4 供给与审计层:对外 3 项能力(§8)。
-
事后 6 条:跨层闭环,通过「回流写回」持续修正 L1/L2/L3。
2.2 业务架构图(业务/价值视图)
【图 2.2 业务架构图(业务/价值视图)】
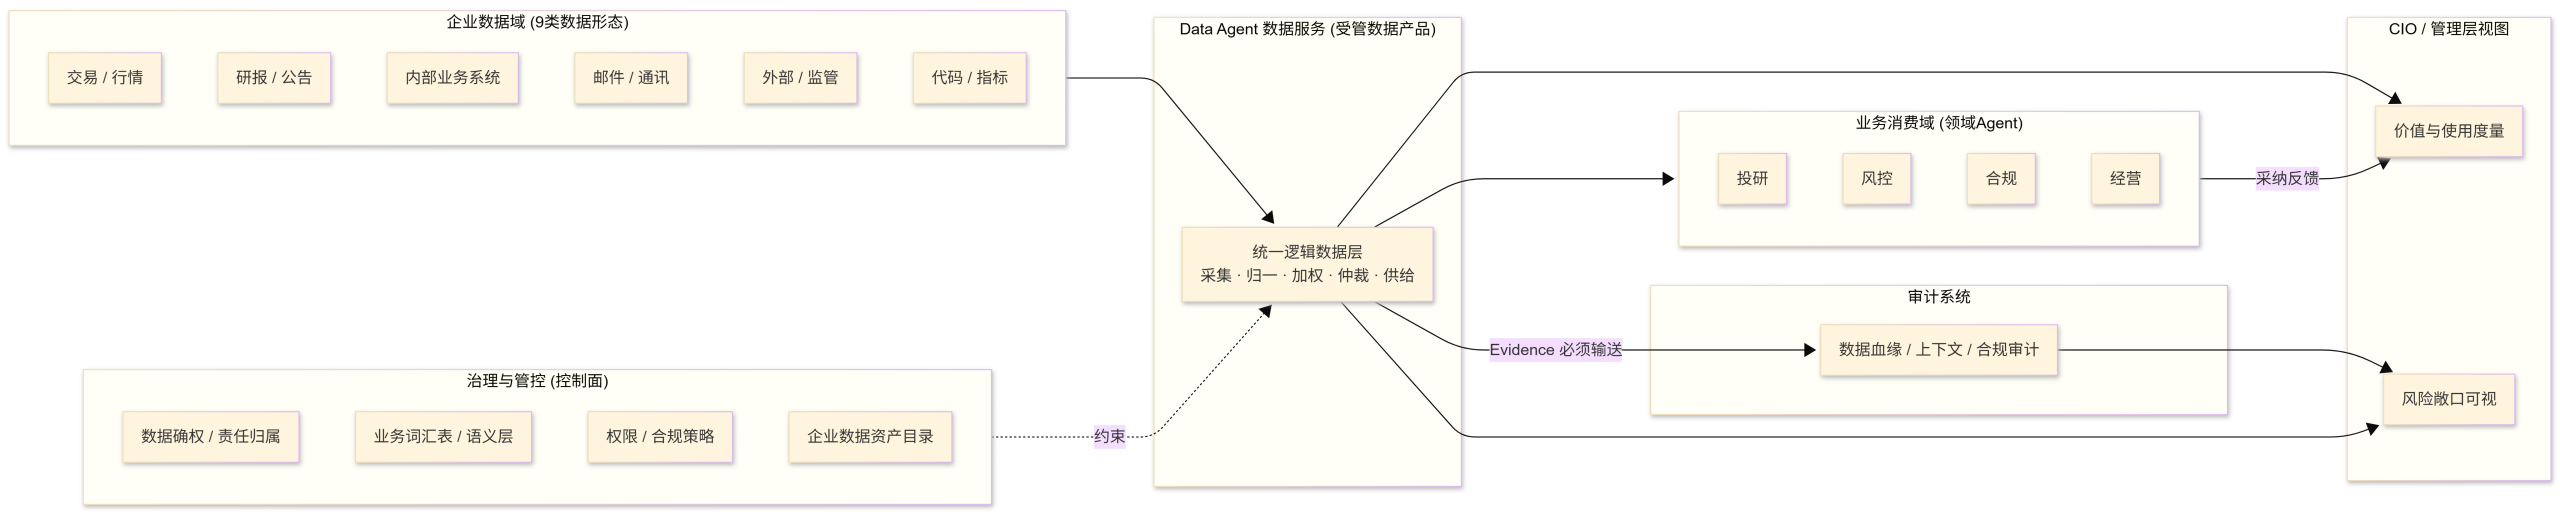
业务含义
-
Data Agent 是企业数据管理体系中的一个受管、可责、可组合的数据服务节点(对齐数据网格 Data Mesh[3] / 数据编织 Data Fabric[4])。
-
它既消费企业数据资产目录(查能供什么),也发布自己能服务的资产,避免制造新的影子数据通道。
-
其输出必须输送审计系统;同时向上级管理层提供价值度量与风险可视,支撑 CIO 的数据管理决策。
3. 数据形态分类(9 类)
分类主轴为「数据的本质形态 / 处理方式」,来源(内部/外部)、交付(静态/流式)、存储引擎(关系/时序/图/向量)作为正交修饰,不与平面类型混排。
|
1 |
多模态数据 |
图像 / 图表 / 音频(电话会议)/ 视频(路演) |
异构 model(OCR/VLM/ASR/LLM)→ 统一文本/结构化表示 |
|
2 |
领域数据 |
OKF 格式定义[5]、LLMWiki 抽取、本体论指导的术语/业务逻辑/监管规则 |
LLM 抽取 + 知识图谱;种子本体 + 人工校准 + provenance/版本 |
|
3 |
关系数据库 |
业务表 / 指标 |
NL2SL2SQL(走语义层,属文本到 SQL 研究范式)[6][7] + 投影筛选 → 结构化 JSON(带单位);pre-retrieval:术语归一化 + Table-to-JSON |
|
4 |
向量数据库 |
非结构文档 chunk |
结构感知 chunk + 混合召回(向量+BM25+KG)+ 重排 |
|
5 |
实时流 |
Kafka 行情 / CDC 变更 / 告警事件 / K 线流 |
流式 feed 采集(接入→落库→查询) |
|
6 |
金融报文 |
SWIFT[8] / FIX[9] / ISO 20022[10] |
专用解析器 → 结构化字段 |
|
7 |
半结构化数据 |
CSV / Excel / JSON / XML / YAML / 日志 |
专用解析 + schema 映射;Excel 多 sheet/公式/合并单元格特殊处理 |
|
8 |
非结构化数据 |
内部材料 / 邮件 IM(合规监控)/ 公告 / 官网 / 财报披露(XBRL 格式)[11] / 路透彭博 / Wind Choice / 社媒 / 股吧舆情 |
版面解析 + 切分 + 向量/LLM + 混合召回 |
|
9 |
代码与逻辑数据 |
SQL 脚本 / Notebook / BI 报表定义 / 指标计算代码 |
解析抽取真实口径 → 回填语义层(极高优先级) |
说明
-
向量库 / 时序库 / 图库 / 关系库是存储/索引引擎,不是数据类型;其上的数据按其本质并入上表相应行。
-
代码与逻辑数据(#9)是金融「真实口径」最常藏身之处(如「活跃客户」是否排除测试单),必须独立采集并回填语义层。
-
外部/监管(路透、XBRL、Wind 等)按结构并入 #4/#7/#8,统一在「来源」维度标注为外部,治理上一致对待(信任、许可、溯源)。
4. 检索中数据处理策略(7 条)
目标:把 9 类异构数据在「出口」收口为统一形态,并完成可信、可控、可排序的上下文装配。
策略 1:归一数据结构(Evidence 对象)
所有 subagent 不直接吐原始结果,而是 conform 到统一 Evidence 契约(详见 §5)。
策略 2:归一数据格式(Schema 格式)
表示归一——所有模态统一为可消费表示:表格→markdown/JSON(带单位标签),音频→transcript,图像→caption + 抽取值,代码→带注释片段。建议 content 带内容类型枚举:metric / fact / narrative / event / definition / code。
策略 3:归一数据标准(pre-retrieval)
-
术语归一化:依托语义层/指标目录,将用户模糊说法映射为规范指标(如「归母净利/扣非净利」→ 不同 M 编号;「上月/同比」→ 具体日期区间)。
-
Table-to-JSON:先语义查询筛出相关行、只投影所需列,再结构化输出(带单位/标签),非整表 dump。
-
术语归一化必须有承载中枢(语义层),否则 9 个 subagent 各归一各的会口径分裂。
策略 4:权限控制(外置 RBAC + 数据权限)
-
原则:只调用权限提取机制,不做权限管理——集成企业既有 RBAC,不自建。
-
两道拦截:① 检索前(无权限源根本不查);② 装配时(按 sensitivity 标签 vs 当前用户角色,脱敏/剔除)。
-
要求 subagent 走「权限感知的提取层」,防止自拼 SQL 绕过 RBAC;含行列级 + PII 脱敏 + 审计留痕。
策略 5:数据权重(多因子)
见 §6 权重与冲突。默认权重(类型先验):代码/领域=5,关系库/报文/实时流=4,半结构/官方非结构=3,多模态=2–3,舆情=2,向量=2。领域 > 向量成立,但「当前事实」场景下实时流/关系库会与其同档甚至更高。
策略 6:主从 Agent 模式(分派处理)
-
编排者(Router + Assembler)调度 9 类窄专家 subagent。
-
Router 决定本次调哪几类(不全调);Assembler 负责收口(融合/冲突/排序/治理/打包)。
-
subagent 必须 conform 到 Evidence 契约(呼应策略 1/2)。
策略 7:冲突仲裁(分层责任)
-
Data Agent 做确定性、低成本、可配置解决的冲突:去重、按 canonical_ref 聚类、口径分歧(语义层/代码资产为真理源落定)、同口径数值分歧(按 Authority·Freshness·Confidence 选主值)、权限冲突(治理拦截)。
-
真分歧交 LLM 权衡:两权威源对同一事实给不同值(且 material)、叙述性证据 vs 数值证据的张力——Data Agent 标为 divergence 连同备选证据交给 LLM,不偷偷抹平。
-
最差方案是「全丢回 LLM」(失审计、爆 context、不可复现);也不可「Data Agent 硬解一切」(它非分析师)。
5. Evidence 数据契约
所有 subagent 出口、Assembler 出口、对外供给,统一使用此契约。它是串联「归一 / 权重 / 冲突 / 审计」的主键载体。
Evidence:
id: string # 唯一 ID
content: string # 归一后的文本/结构化值
evidence_type: enum # metric | fact | narrative | event | definition | code
source: {system, doc_id/table, query_or_sql, url} # 出处
canonical_ref: string # 语义层指标 ID(术语归一化落点,串联 3/5/7 的主键)
as_of: datetime # 数据时点(金融防旧值当新值)
retrieved_at: datetime
confidence: float[0,1] # subagent 自估置信(需经事后校准)
sensitivity: enum # 公开 | 内部 | 机密 | PII(权限标签)
citations: [string] # 原文出处引用
trace_id: string # 可回溯到 subagent + 查询
resolution: enum # primary | alternate | divergence(冲突仲裁产出)
divergence_of: string # 若为 divergence,指向其归属的 canonical_ref
字段必要性说明
-
canonical_ref:术语归一化(策略3)、权重聚合(策略5)、冲突仲裁(策略7)的共同 join key。缺失则三者各算各的、口径再次分裂。
-
as_of:金融最怕拿旧值当新值,是权重 Freshness 因子的依据。
-
sensitivity:策略4 装配时拦截的判据。
-
citations + trace_id:策略3 数据审计(血缘/上下文/合规)的溯源基础。
6. 权重与冲突仲裁机制
6.1 多因子打分公式
score(E) = α·Authority(E) # 来源权威(内部系统/官方披露 > 外部社媒)
+ β·Relevance(E, q) # 与该问题的语义相关度
+ γ·Freshness(E) # as_of 距现在的衰减(实时流吃满,旧值打折)
+ δ·Confidence(E) # subagent 自估置信(经事后校准)
+ ε·TypeBase(E) # 类型默认权重(先验,见下表)
α+β+γ+δ+ε 可按任务调(投研重 Freshness,合规重 Authority)。
6.2 类型默认权重(TypeBase,1–5)
|
代码与逻辑数据 |
5 |
口径真理源 |
|
领域数据 |
5 |
语义真理源 |
|
关系库 / 金融报文 / 实时流 |
4 |
系统记录 / 权威交易 / 最新值 |
|
半结构 / 官方非结构(公告/财报/XBRL[11]) |
3 |
视来源 |
|
多模态(抽值后) |
2–3 |
经 model 转文本后定 |
|
舆情(社媒/股吧) |
2 |
噪声大,仅情绪信号 |
|
向量 chunk |
2 |
背景/线索,默认最低 |
6.3 任务情境改写默认权重
|
口径/定义解释 |
领域(5) · 代码(5) > 关系库 > 其他 |
|
当前值/行情 |
实时流(4) · 关系库(4) > 研报/公告 > 舆情 |
|
合规监控(邮件/IM) |
邮件/IM 本身即主证据(权重最高) |
|
风险归因 |
报文(4) · 实时流 · 关系库 > 叙述 |
|
投研观点 |
研报/公告(3–4) · 实时流 > 舆情(2) |
6.4 冲突仲裁细则
-
口径分歧(同词不同定义)→ 领域数据/代码资产仲裁(定义优先),其余标「异义口径」并提示。
-
数值分歧(同口径不同值)→ 按 Authority·Freshness·Confidence 选主值,保留差异供 LLM 展示,不擅自抹平。
-
上下文预算:context window 超预算时按 Authority·Relevance·Freshness 截断,保 Must(领域/代码/关系库/报文)、留 Supporting(实时流/半结构/官方非结构)、舍 Background(舆情/多模态/向量)。
7. 事后数据质量提升策略(6 条)
目标:把「事中」产出的失败/低质信号,转化为对系统的持续修正,形成越用越强的质量飞轮。以下逐条展开(非表格)。
7.1 自适应检索机制(MemCon)
-
机制:当检索「卡住」时自适应更换提示词。
-
落地要点:需明确定义触发条件(空结果 / confidence<阈值 / 冲突不可仲裁 / 超时);动作集不止换提示词,还应含换路(改调别的 subagent)、拆解(子问题)、降级认怂;并记忆历史解法(从错题集学「这类怎么解卡」),避免反复卡同一坑。
-
闭环角色:事中链路的兜底重试,降低首次失败率。
7.2 自进化知识整合(LLMWiki)
-
机制:自主整合新知识与纠错,并带版本回滚机制。
-
落地要点:纠错须对照真值源(代码资产/官方披露/人工审过的种子本体),避免幻觉叠加;低置信纠错须显式路由进「数据人工闸门(7.4)」;每条带 provenance + as_of,过期自动标 stale;纠错结果须写回语义层(更新 canonical_ref 映射)。
-
闭环角色:知识飞轮,持续提升语义层与领域知识质量。
7.3 检索数据质量度量
-
机制:对 Data Agent 供给的数据,建立 LLM 采纳 + 用户采纳 的反馈回路,做闭环质量度量,并执行回流写回与置信度校准。
-
落地要点:LLM 采纳 = 消费方是否真正引用该 Evidence(反映供给相关性);用户采纳 = 用户是否采信/导出(反映供给质量);补充忠实度(幻觉检测)与引用准确率指标;度量结论须驱动错题集(7.6)与回流写回。
-
闭环角色:飞轮的「仪表盘」与「回流驱动源」,把消费侧信号量化并导向修正。
7.4 数据人工闸门
-
机制:高风险数据人工检查、数据定期抽检、检测出机器歧义时 HITL。
-
落地要点:明确「高风险」定义(sensitivity 标签 / 高权重源变更 / 权限边界);人工结论须有下游出口(修权限映射 / 标 stale / 回写语义层),审完即闭环;与 7.2 低置信纠错直接对接。
-
闭环角色:金融高利害场景的强制兜底,保障安全与合规。
7.5 数据生命周期管理(主动巡检)
-
机制:主动巡检,而非仅被动响应。
-
落地要点:定时扫描 wiki/证据过期、语义层口径漂移、某源质量退化;用红队挑战集主动寻找系统弱点。
-
闭环角色:补足「被动」盲区,把问题发现在用户之前。
7.6 错题集
-
机制:持续增长的回归测试集 + 失败根因库。
-
落地要点:按失败类型归类(口径错 / 权限误拦 / 召回失败 / 时效错 / 冲突误判 / 权重错配),每条须指回 7 条事中策略哪条该改;既是回归验证集,又是 7.3 度量的输入、7.5 巡检的红队素材。
-
闭环角色:飞轮的「燃料」——把失败转化为可归因而可修复的资产。
7.7 闭环接线
[事中 7 条] ──失败/低质信号──▶ [事后 6 条]
① MemCon 自适应重试
② LLMWiki 自进化(版本回滚) ─┐
③ 度量+回流+校准 ├─▶ ⑥ 错题集(根因+回归)
④ 人工闸门(HITL) │
⑤ 主动巡检 ┘
│ 全部通过 ③ 的「回流写回」修正 事中 7 条(语义层/路由/权重/权限)
▼
越用越强的质量飞轮(可审计、可回滚)
8. 对外能力(3 项)
从「内部怎么建」转向「对外承诺什么」。这三项在战略层分别对应三条成熟管理学科。
能力 1:核心能力 —— 为 LLM 提供数据供给
-
对外契约:supply(question, context) → Evidence[]。
-
战略含义:受治理的数据产品 / 统一逻辑数据层——对上屏蔽 9 类物理异构,对下统一访问;贡献在「抽象与虚拟化」,非「采集」二字。
-
CIO 视角:自助式数据服务战略的体现,收敛分散访问、消解孤岛。
能力 2:数据标记 —— 数据出处标记
-
机器可读 + 人类可读,并支持「引用回填」(LLM 答案里的 [1][2] 一键跳回来源)。
-
标记字段 = Evidence 的元数据:source / canonical_ref / as_of / confidence / sensitivity / citations。
-
战略含义:元数据管理 + 绑定授权业务词汇表/语义模型——是跨系统、跨部门互操作的前提,也是企业数据资产目录的末端。
能力 3:数据审计 —— 事后数据审计 + LLM 上下文审计
拆为三块:
数据血缘审计:源 → 变换 → Evidence 全链路。
LLM 上下文审计(答案归因):给定一条结论,回放其用了哪些 Evidence、哪句 SQL/召回——支撑「为什么这么答」。
合规/越权审计:权限误拦、越权尝试、敏感泄露。
并需提供审计查询接口(监管/内审可调出某次回答用了哪些数据)。
-
战略含义:可追溯 + 合规 + 问责——治理闭环的强制项,也是 CIO 风险可控的保证。
9. 战略对齐
对外 3 能力须与企业现有管理体系咬合,而非自成一套。
| 数据治理 |
标记=元数据/术语/血缘;审计=问责/合规;供给=受管数据产品 |
① 数据确权与责任归属(Owner/Steward)② 标记绑定授权业务词汇表/指标目录 ③ 治理策略遵从声明 ④ 数据质量维度承诺(准确性/完整性/一致性/时效性/有效性) |
| 数据管理 |
供给=自助数据服务;标记=资产目录末端;审计=风险可控 |
⑤ 企业数据资产目录接入与发布(既消费又发布)⑥ 数据产品价值/使用度量(覆盖度/使用量/决策贡献)⑦ 风险敞口可视(敏感数据供给量/越权拦截量) |
| 数据架构 |
供给=逻辑数据层/虚拟化;标记=规范模型绑定;审计=跨层可追溯 |
⑧ 明确为 9 类物理数据的统一逻辑访问层 ⑨ 输出绑定企业规范/语义模型 ⑩ 作为可组合、标准遵从的数据服务节点(对齐数据网格 Data Mesh[3] / 数据编织 Data Fabric[4]) |
战略一句话:Data Agent 不是「一个供数工具」,而是「企业数据管理体系里一个受管、可责、可组合的数据服务节点」。
10. 落地路线与待细化项
10.1 优先级建议
先底座,后 Agent:先建语义层/指标目录 + 治理(权限/血缘),再生 Agent。顺序不可反。
先窄场景验证:选 1–2 个垂直高频场景(如经营复盘问数、风险归因)跑通 7 事中 + 3 对外。
再上事后飞轮:接入 6 事后,重点先建错题集(7.6)与度量(7.3),驱动回流。
10.2 待细化项(实现层,非架构缺口)
-
Evidence 字段落地:§5 的 as_of / canonical_ref / sensitivity / citations 须在工程中写死,尤其 canonical_ref 是 3/5/7 与回流的主键。
-
MemCon(7.1) 触发器:明确触发条件与动作集(换路/拆解/降级),避免仅「换提示词」。
-
LLMWiki(7.2) 与闸门(7.4) 接线:低置信纠错显式路由进 HITL。
-
错题集(7.6) 驱动闭环:根因须指回 7 条事中策略,并作为度量(7.3)的回归集、巡检(7.5)的红队素材。
-
语义层作为承载中枢:术语归一化、指标目录、canonical_ref 映射需独立模块长期维护。
10.3 设计完成度自评
-
9 类数据、7 事中、6 事后、3 对外 —— 架构闭环已完整。
-
所有早期提出的补丁(Evaluation 度量、回流写回、主动巡检、人工闸门、置信度校准、版本回滚)均已被吸收。
-
剩余仅为上述实现层细化,无需再补架构维度。
附录 A:端到端流程示例
用户问题:华东区上季增长最快的客户及原因?
│
├─ Router:识别意图→查语义层术语归一化→决定调 关系库sub + 实时流sub + 非结构sub(研报/舆情)
│
├─ 关系库sub:NL2SL2SQL → Evidence(华东区Q2净营收 12.3亿, as_of 2026-06-30, canonical_ref=M001, conf 0.98)
├─ 实时流sub:K线流 → Evidence(该客户今日持仓 +5.2%, as_of 2026-08-24 14:00)
└─ 非结构sub:研报PDF → Evidence(增长受价格战拖累, narrative, citations=研报p.3)
│ (各出口已完成 表示/语义/元数据 三类归一)
▼
Context Assembler:
· 聚类:三证据同归 M001 相关组
· 冲突:无数值冲突;标记研报为 supporting narrative
· 排序:关系库(权威,4) > 实时流(新鲜,4) > 研报(narrative,3)
· 治理:sensitivity=内部,当前角色可看 → 放行
· 打包:带编号 Evidence blocks + data summary
▼
投研 Agent 消费:
「华东区 Q2 净营收 12.3 亿[1];该客户今日持仓 +5.2%[2];研报指出增长受价格战拖累[3]。」
(引用可一键回填至 source/citations;审计可回溯 问题→subagent→SQL→Evidence→结论)
附录 B:术语表
|
Data Agent |
以数据任务为领域的智能体品类,此处特指企业级上下文供给层 |
|
Evidence |
统一数据契约对象,所有供给的最小可溯源单元 |
|
canonical_ref |
语义层指标 ID,术语归一化落点,串联归一/权重/冲突/审计的主键 |
|
NL2SL2SQL |
自然语言→语义层→SQL(文本到 SQL 研究范式)[6],避免模型直接对裸表猜 SQL |
|
数据网格/编织 |
Data Mesh[3] / Data Fabric[4],企业数据架构范式,Agent 作为其数据产品节点 |
|
HITL |
Human-in-the-Loop,人在回路 |
参考文献
本表按 GB/T 7714-2015 顺序编码制编排:中文文献列于前,外文文献按正文首次出现顺序列于后;正文引用以 [n] 标注,同一来源多处出现复用同一编号。(方括号 [2026-08-24] 为引用/访问日期。)
中文文献
[1] 方营. Data Agent 为什么总停在 Demo?MIP 从实时数据底座到可治理执行链路的实践[EB/OL]. DataFun, 2026-08-23[2026-08-24]. https://mp.weixin.qq.com/s/uUMyaAJ15O-F-HKN3IcXXA
外文文献
[2] YAO S, ZHAO J, YU D, et al. ReAct: Synergizing Reasoning and Acting in Language Models[EB/OL]. arXiv:2210.03629, 2022[2026-08-24]. https://arxiv.org/abs/2210.03629
[3] DEHGHANI Z. Data Mesh: Delivering Data-Driven Value at Scale[M]. O'Reilly Media, 2022.
[4] Gartner. Data Fabric[EB/OL]. [2026-08-24]. https://www.gartner.com/en/data-analytics/topics/data-fabric
[5] Google Cloud. Open Knowledge Format (OKF) Specification[EB/OL]. (v0.1 2026-06-12; v0.2 2026-07-24)[2026-08-24]. https://github.com/GoogleCloudPlatform/knowledge-catalog/blob/main/okf/SPEC.md
[6] YU T, ZHANG R, YANG K, et al. Spider: A Large-Scale Human-Labeled Dataset for Complex and Cross-Domain Semantic Parsing and Text-to-SQL Task[EB/OL]. arXiv:1809.08887, 2018[2026-08-24]. https://arxiv.org/abs/1809.08887
[7] A Survey on Text-to-SQL: From Heuristic-Based to LLM-Based Approaches[EB/OL]. arXiv:2407.15186, 2024[2026-08-24]. https://arxiv.org/abs/2407.15186
[8] SWIFT. SWIFT Standards (MT Messages, ISO 15022)[EB/OL]. [2026-08-24]. https://www.swift.com/standards
[9] FIX Trading Community. FIX Protocol[EB/OL]. [2026-08-24]. https://www.fixtrading.org/standards/fix-protocol/
[10] International Organization for Standardization. ISO 20022-1:2026 Financial Services — Universal Financial Industry Message Scheme[EB/OL]. [2026-08-24]. https://www.iso.org/standard/84854.html
[11] XBRL International. XBRL Standard[EB/OL]. [2026-08-24]. https://www.xbrl.org/ (注:美国 SEC 强制上市公司 iXBRL 报送,欧盟 ESMA 经 ESEF 要求)