做求职招聘系统的时候,简历上传解析这块是真折腾。本来以为就是一个文件上传,后端接住存起来就完事,结果从文件大小限制到编码乱码到各种解析异常,一路踩过来,记录一下。
一、先说说需求
求职者在前端(Vue + uniapp)上传简历文件,后端 Java 接收,解析出姓名、电话、期望职位、工作经历这些信息,落到 MySQL,方便后续搜索和职位匹配。
文件格式主要支持 PDF 和 Word(.doc/.docx),单个文件限制 5MB。
二、上传接口的坑
最开始写了个最朴素的上传接口:
@PostMapping("/upload")
public Result upload(@RequestParam("file") MultipartFile file) {
// 直接存
}
一上线就出问题,前端报 413,因为 Spring Boot 默认限制单文件 1MB,需要在配置文件里放开:
spring:
servlet:
multipart:
max-file-size: 5MB
max-request-size: 6MB
这里有个细节:max-request-size 一定要比 max-file-size 大,不然多文件上传的时候,几个文件加起来超过 request 大小还是会挂。我当时就只配了 max-file-size,结果用户上传两份简历直接报错,排查半天。
三、文件名乱码问题
用户上传中文名文件,比如"张三的简历.pdf",直接 file.getOriginalFilename() 拿到的是乱码。这是因为前端 uniapp 上传时 header 里带的文件名编码问题,稳妥做法是前端用 encodeURIComponent 处理一下,后端再解码:
String filename = URLDecoder.decode(file.getOriginalFilename(), "UTF-8");
这个坑不踩一次根本想不到,测试的时候全用的英文文件名,一上真实环境就暴露了。
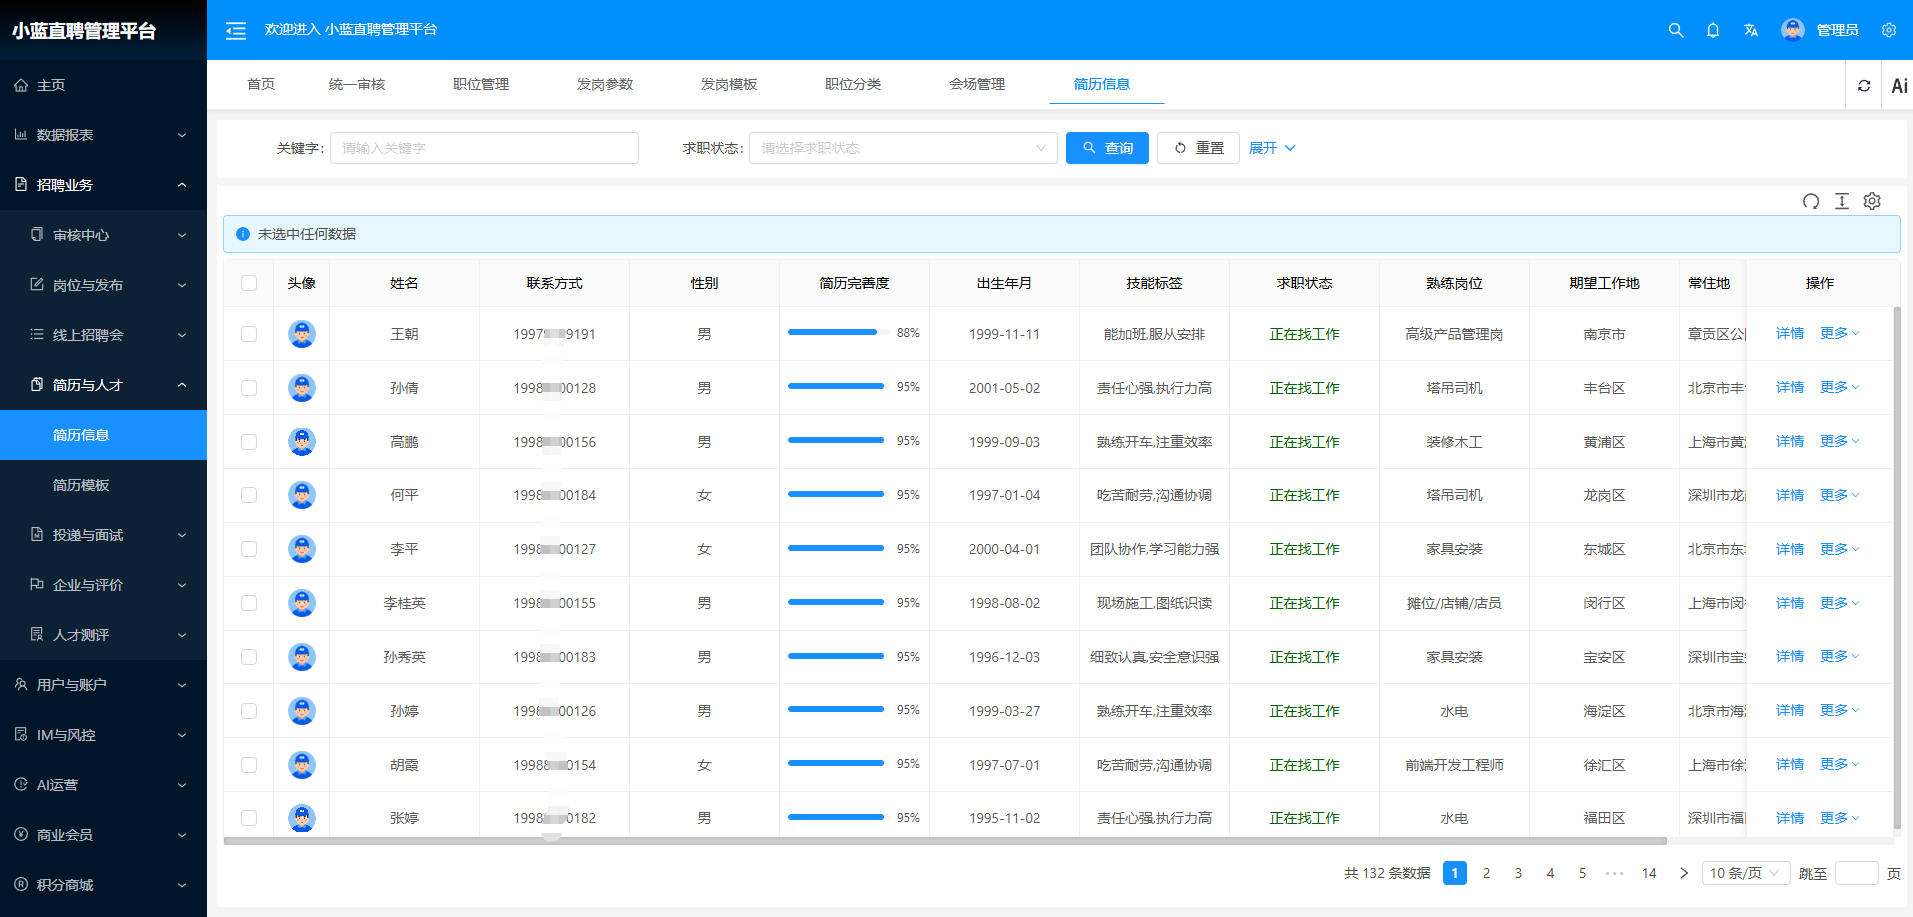
系统里的简历管理页面大概长这样:
四、简历解析——最大的坑
4.1 PDF 解析
PDF 文本提取用的 PDFBox,看着简单:
PDDocument document = PDDocument.load(inputStream);
PDFTextStripper stripper = new PDFTextStripper();
String text = stripper.getText(document);
结果遇到两类问题:
4.2 Word 解析
.doc 老格式用 Apache POI 的 HWPF,.docx 用 XWPF。最大的坑是表格:简历里的工作经历经常是表格形式,XWPFWordExtractor 提取的文本会把表格内容拼在一起,看不出对应关系。
// 只取段落文本,表格单独处理
XWPFDocument doc = new XWPFDocument(inputStream);
for (XWPFParagraph p : doc.getParagraphs()) {
text.append(p.getText()).append("\\n");
}
for (XWPFTable table : doc.getTables()) {
for (XWPFTableRow row : table.getRows()) {
for (XWPFTableCell cell : row.getTableCells()) {
text.append(cell.getText()).append(" | ");
}
text.append("\\n");
}
}
4.3 正则提取信息
文本拿到后就是正则匹配了,这里也是各种翻车:
// 手机号匹配,注意不能匹配出座机或身份证里的数字
Pattern phonePattern = Pattern.compile("(?<![\\\\d-])1[3-9]\\\\d{9}(?![\\\\d-])");
不加前后断言的话,"身份证号110101199003077712"里会匹配出"1101011990"这种假手机号。还有邮箱、姓名匹配,姓名是真难搞,中文名字没有明显规律,最后方案是:简历里有"姓名/姓 名"这种标签就优先取标签后面的值,匹配不到再考虑用常见姓氏表兜底,匹配率能到 90% 左右。
五、解析任务别放同步里
简历解析平均要 1~3 秒,同步解析用户要等半天。后来改成异步:上传接口先落库(状态=待解析),然后丢线程池解析,解析完更新状态。用 @Async 或者手动线程池都行,注意线程池别用 Executors.newFixedThreadPool(),生产环境要自定义队列和拒绝策略,不然任务一多直接把内存打爆。
@Async("resumeParseExecutor")
public void parseResume(Long resumeId, String filePath) {
// 解析逻辑
// 解析完更新状态 + 通知
}
六、总结
简历上传解析这块,看似简单,实际涉及文件大小限制、编码、格式兼容、内存管理、异步处理好几个层面。几个核心经验:
- 文件限制要配 request-size,不能只配 file-size
- 中文文件名用 URLDecoder 解码
- 扫描版 PDF 提不到文本要兜底
- 正则匹配注意边界
- 解析耗时操作异步化
现在这套逻辑在项目里跑得还算稳,还有不少细节没展开,后面再单独写。
项目源码:项目源码:https://gitee.com/gzqkl/job-uniapp