Linux 内核旁路:DPDK 和 eBPF 在 AI 网络加速中的可行性
一、AI 推理网络瓶颈:内核协议栈的隐性开销
大模型推理服务在网络层面的性能瓶颈,往往被 GPU 算力和显存讨论所掩盖。但在高并发推理场景中,网络数据传输的开销不容忽视。一次推理请求包含 5122048 个 token 的输入数据,约 28 KB;响应输出同样可能达到数 KB。当并发达到数百级别时,网络包处理速率需要支撑每秒数千次的小包传输。
Linux 内核的 TCP/IP 协议栈经过 30 年优化,通用性极强,但通用性本身就意味着妥协。每个网络包从网卡到达用户进程,需要经历中断处理、内核协议栈解析、socket 缓冲区拷贝等环节。实测数据表明,单核处理 64 字节小包的极限吞吐约 1.5 Mpps,而 10 Gbps 网卡的小包理论速率约 14.88 Mpps。内核协议栈的处理能力远低于硬件线速,这个差距在 AI 推理的小包密集场景中被放大。
内核旁路技术的核心思路是绕过内核协议栈,让网络包直接从网卡到达用户态进程。DPDK 和 eBPF 是两种截然不同的旁路方案——前者是完全绕过内核的用户态轮询,后者是在内核中注入可验证的安全代码实现协议栈加速。它们的工程代价和适用场景完全不同。
二、DPDK 与 eBPF 的底层架构对比
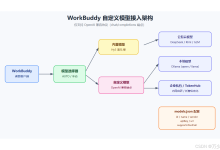
三种技术路径的数据流向如下:
DPDK 的核心机制是"用户态轮询 + DMA 直写"。网卡通过 DMA 将收到的数据包直接写入用户态预先分配的大页内存(hugepages),用户态进程通过轮询(polling)方式持续检查内存区域是否有新包到来。这个过程没有中断、没有内核拷贝、没有协议栈开销。代价是 CPU 需要独占一个或多个核心做轮询,这些核心不能被其他任务使用。
eBPF 的核心机制是"内核内可编程过滤"。在网卡收到包的最早时机(XDP Hook),eBPF 程序可以对包做快速判断:丢弃无效包、重定向包到特定 socket、或放行让内核协议栈正常处理。eBPF 程序经过验证器(Verifier)的严格安全检查后注入内核执行,不会导致内核崩溃。代价是 eBPF 程序的功能受限——不能调用任意内核函数,不能做复杂状态管理,循环次数有上限。
两者在网络吞吐上的实测差异(10 Gbps 网卡,64 字节小包):
| 内核协议栈 | 1.5 | 中断驱动,低负载时低 | 标准 | 完全兼容 |
| DPDK | 14+ | 独占核心,100% 轮询 | hugepages | 需专用驱动 |
| eBPF/XDP | 8~10 | 低,仅在包到达时执行 | 标准 | 内核原生支持 |
三、推理场景下的可行性验证代码
以下代码展示 eBPF/XDP 在推理服务网络层的快速过滤应用场景:将无效的探测包和超小包在 XDP 层直接丢弃,减少内核协议栈的无效处理。
// xdp_filter.bpf.c — XDP 层推理服务网络包过滤器
#include <linux/bpf.h>
#include <linux/if_ether.h>
#include <linux/ip.h>
#include <linux/tcp.h>
#include <bpf/bpf_helpers.h>
// 统计被 XDP 层过滤的包数量
struct {
__uint(type, BPF_MAP_TYPE_PERCPU_ARRAY);
__uint(key_size, sizeof(__u32));
__uint(value_size, sizeof(__u64));
__uint(max_entries, 4);
} filter_stats SEC(".maps");
SEC("xdp")
int xdp_inference_filter(struct xdp_md *ctx) {
void *data = (void *)(long)ctx->data;
void *data_end = (void *)(long)ctx->data_end;
// 解析以太网头
struct ethhdr *eth = data;
if ((void *)(eth + 1) > data_end)
return XDP_PASS; // 包不完整,交给内核处理
// 仅处理 IPv4 包
if (eth->h_proto != __constant_htons(ETH_P_IP))
return XDP_PASS;
// 解析 IP 头
struct iphdr *ip = (void *)(eth + 1);
if ((void *)(ip + 1) > data_end)
return XDP_PASS;
// 过滤规则:丢弃非 TCP 包(推理服务只走 TCP)
if (ip->protocol != IPPROTO_TCP) {
__u32 key = 0;
__u64 *val = bpf_map_lookup_elem(&filter_stats, &key);
if (val) (*val)++;
return XDP_DROP;
}
// 解析 TCP 头,过滤 SYN 扫描探测包
struct tcphdr *tcp = (void *)(ip + 1);
if ((void *)(tcp + 1) > data_end)
return XDP_PASS;
// 丢弃纯 SYN 探测包(无 payload 的连接探测)
if (tcp->syn && !tcp->ack && !tcp->psh) {
__u32 key = 1;
__u64 *val = bpf_map_lookup_elem(&filter_stats, &key);
if (val) (*val)++;
return XDP_DROP;
}
// 合法推理请求包,放行到内核协议栈
return XDP_PASS;
}
char _license[] SEC("license") = "GPL";
DPDK 在推理场景的应用更偏底层基础设施。典型用例是推理网关节点用 DPDK 做包转发加速,将推理请求从外部网卡快速分发到后端推理服务 pod 的虚拟网卡。这需要 DPDK 与 Kubernetes CNI 的深度集成,目前仅有少数商业方案支持。
四、Trade-offs 与适用边界分析
DPDK 的致命代价是 CPU 独占。轮询模式要求至少一个核心 100% 运行,不管有没有包到来。在推理集群中,GPU 节点的 CPU 核心本就紧张——需要给推理引擎、容器运行时、Kubernetes 组件预留资源。独占一个核心做 DPDK 轮询意味着推理引擎可用核心减少 1~2 个,对 CPU 密集型的预处理和后处理环节有直接影响。
DPDK 的另一个代价是生态割裂。DPDK 需要 exclusive 模式接管网卡,网卡一旦被 DPDK 管理就不再出现在内核网络设备列表中,ip、ifconfig 等标准工具无法使用。Kubernetes 的标准 CNI 插件(Calico、Cilium 等)与 DPDK 的集成要么不支持,要么需要大量定制。
eBPF/XDP 的代价是功能受限。XDP 只能做包级别的快速判断和重定向,不能替代完整的 TCP 协议栈。推理服务依赖 TCP 的可靠传输、流控和拥塞管理,这些功能 XDP 无法提供。eBPF 的适用场景是"减少无效包对内核协议栈的冲击",而非"替代内核协议栈"。
在 AI 推理场景中的可行性结论:
- DPDK 适用于推理网关/负载均衡节点,这些节点不运行推理引擎,CPU 可以被独占。但与 Kubernetes 的集成是工程难点。
- eBPF/XDP 适用于推理服务节点,在 XDP 层过滤无效流量,降低内核协议栈负载。成本低,不独占 CPU,与 Kubernetes 生态兼容。
- 对于推理集群内部的 pod 间通信(Service Mesh),eBPF 的 Cilium 方案已经成熟,可直接落地。DPDK 在这个场景下过度设计。
五、总结
内核旁路技术在 AI 推理网络加速中有价值,但 DPDK 和 eBPF 的适用边界截然不同。DPDK 的极致吞吐需要 CPU 独占和生态割裂的代价,只适合网关节点;eBPF/XDP 的轻量加速与 Kubernetes 生态天然兼容,适合推理服务节点的网络过滤。
落地路线: