自定义重排组件接入 LangChain:将 BGE-Reranker 封装为 DocumentCompressor
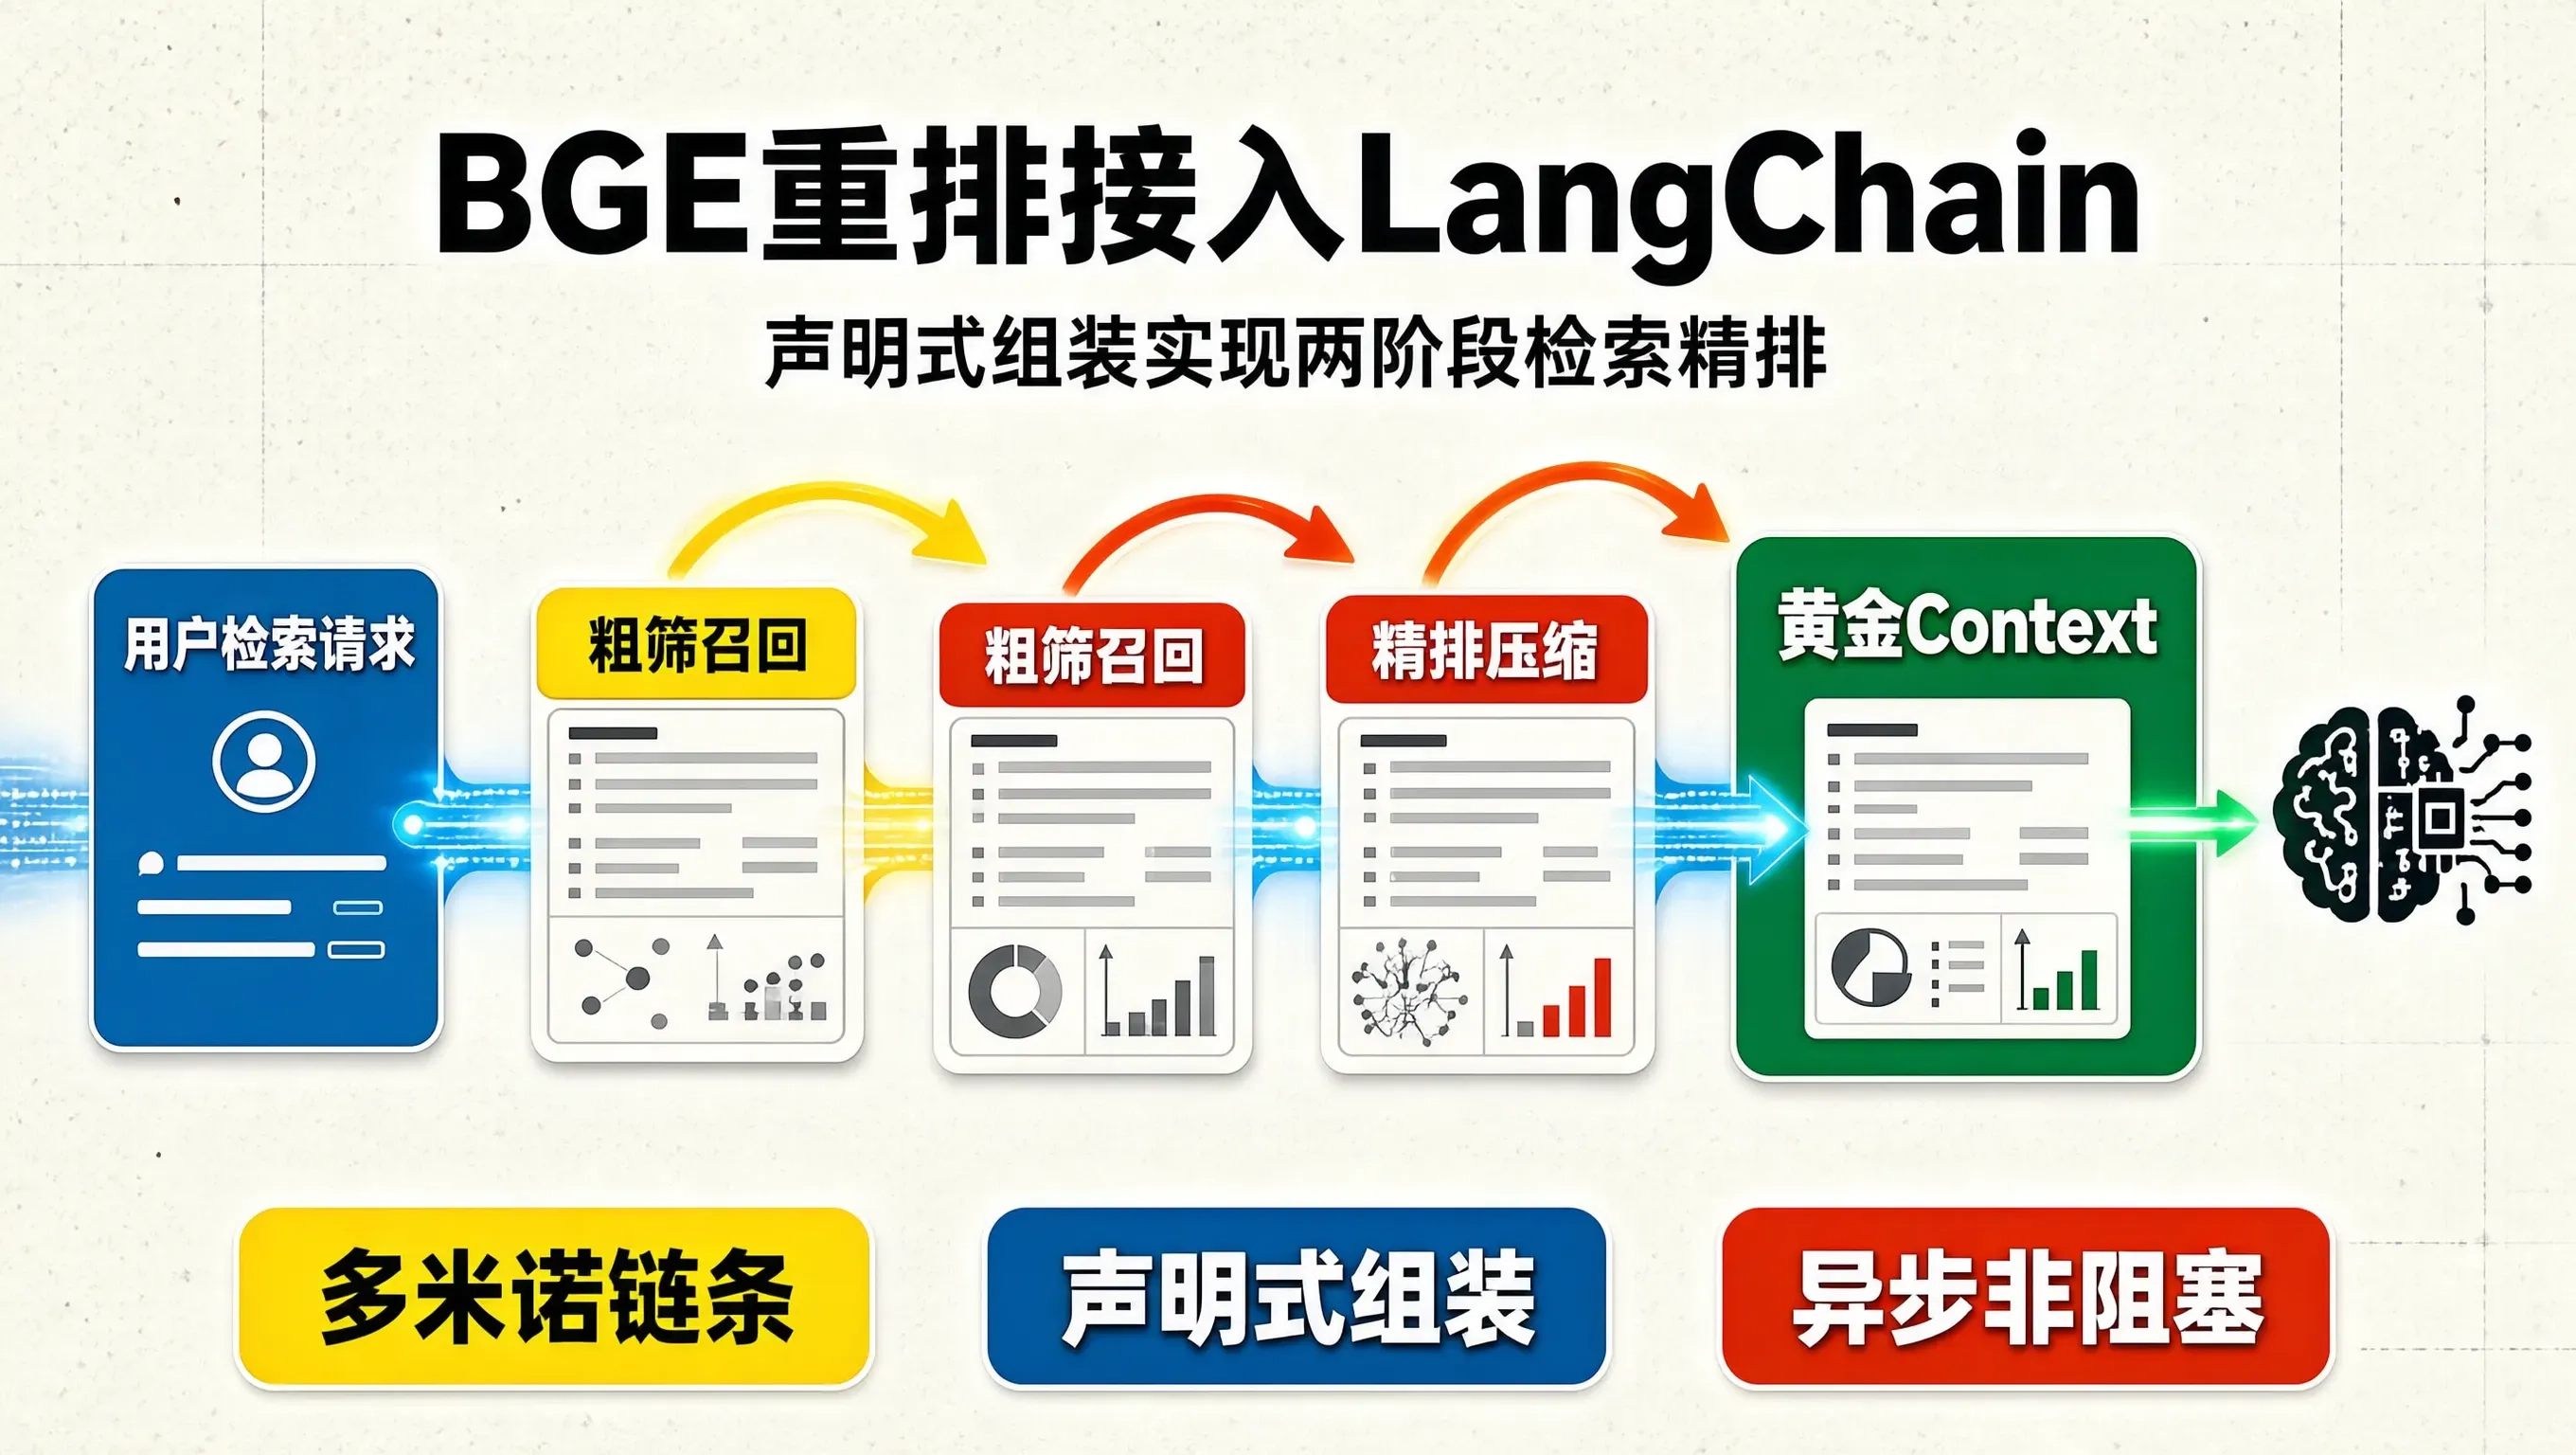
在基于 LangChain 构建生产级 RAG 检索流水线时,很多团队在接入重排模型(如 BAAI/bge-reranker-large、bge-reranker-v2-m3)时,常常写出高度侵入式的过程式代码:先手动调用 Retriever 拿到 List[Document],再手动写一段 Python 循环把 Query 和每个 Document 拼成 Pair 扔给模型打分,最后手动写 sorted() 排序和截断。
这种面条式写法不仅严重破坏了 LangChain 原生表达式(LCEL)的优雅链式语法,而且无法享受 LangChain 体系内置的异步并发调度、流式事件透传、链路追踪 Callback 与上下文压缩流水线。
在 LangChain 的核心架构中,官方提供了一套专门用于检索后精排、过滤与上下文精炼的标准抽象——BaseDocumentCompressor(文档压缩与后处理器)。配合 ContextualCompressionRetriever,可以实现检索与重排的极简声明式绑定。
如何手写一个继承自 BaseDocumentCompressor 的高性能、支持异步非阻塞与 GPU 动态批处理的生产级 BGE 重排插件?
LangChain 检索压缩架构的核心协议
在 langchain_core.documents.compressor 中,所有重排器与过滤器都必须实现两套核心契约:
- compress_documents(documents, query) -> Sequence[Document]:同步批量压缩重排;
- acompress_documents(documents, query) -> Sequence[Document]:全异步非阻塞重排(高并发核心)。
[ 用户发起检索请求: retriever.ainvoke(query) ]
|
v 1. 底层 BaseRetriever 粗筛 (召回 25 篇候选 Document)
[ 原始候选 Document 列表 ]
|
v 2. 自动流向 ContextualCompressionRetriever
+———————– 自定义 BGERerankerCompressor ———————–+
| 1. 组装输入 Pairs: [[query, doc1.page_content], [query, doc2.page_content], …] |
| 2. 调用 BGE-Reranker (Cross-Encoder) 进行 GPU 深度交叉注意力打分 |
| 3. 将真实相关度得分回填至 doc.metadata["rerank_score"] |
| 4. 阈值硬拦截 (score >= min_score) + 截断保留 Top-K (如保留前 3 篇) |
+————————————-+—————————————+
|
v 3. 输出精炼后的黄金 Document 列表
[ 纯净黄金 Context 直接流向 PromptTemplate 与大语言模型! ]
Python 生产级自定义 BGERerankerCompressor 完整代码实现
import asyncio
from typing import Sequence, List, Optional, Any, Dict
from pydantic import Field, PrivateAttr
from langchain_core.documents import Document
from langchain_core.documents.compressor import BaseDocumentCompressor
from langchain_core.callbacks import Callbacks
class BGERerankerCompressor(BaseDocumentCompressor):
"""
基于 BGE-Reranker Cross-Encoder 的生产级 LangChain 原生重排组件
"""
top_n: int = Field(default=3, description="重排后最终保留的最高分文档数量")
score_threshold: float = Field(default=0.35, description="最低相关度得分阈值,低于该分数的切片直接剔除")
model_name_or_path: str = Field(default="BAAI/bge-reranker-large")
device: str = Field(default="cuda")
batch_size: int = Field(default=32, description="送入 GPU 推理的微批大小")
# 私有属性维护真实的底层推理模型实例
_model: Any = PrivateAttr()
def __init__(self, **data: Any):
super().__init__(**data)
from sentence_transformers import CrossEncoder
# 初始化 CrossEncoder 模型
self._model = CrossEncoder(
self.model_name_or_path,
max_length=512,
device=self.device
)
print(f"🚀 [BGERerankerCompressor] 模型已加载至 {self.device},Top-N 设为: {self.top_n}")
def _rerank_sync(self, query: str, documents: Sequence[Document]) -> List[Document]:
"""底层同步重排打分核心"""
if not documents:
return []
# 1. 组装 Query-Doc 文本对
pairs = [[query, doc.page_content] for doc in documents]
# 2. 执行 GPU Cross-Encoder 批量推理打分
scores = self._model.predict(
pairs,
batch_size=self.batch_size,
show_progress_bar=False
)
# 3. 将得分注入 Document 元数据并结合原文档打包
scored_docs = []
for doc, score in zip(documents, scores):
score_float = float(score)
# 阈值过滤
if score_float >= self.score_threshold:
# 浅拷贝文档并注入精排打分
new_meta = {**doc.metadata, "rerank_score": round(score_float, 4)}
scored_docs.append(Document(page_content=doc.page_content, metadata=new_meta))
# 4. 按 rerank_score 从大到小降序排列
scored_docs.sort(key=lambda d: d.metadata["rerank_score"], reverse=True)
# 5. 截断保留 Top-N
final_top_docs = scored_docs[:self.top_n]
return final_top_docs
def compress_documents(
self,
documents: Sequence[Document],
query: str,
callbacks: Optional[Callbacks] = None,
) -> Sequence[Document]:
"""同步压缩入口"""
return self._rerank_sync(query, documents)
async def acompress_documents(
self,
documents: Sequence[Document],
query: str,
callbacks: Optional[Callbacks] = None,
) -> Sequence[Document]:
"""异步非阻塞压缩入口:将 GPU 同步推理派发给后台线程池,绝不阻塞主事件循环!"""
loop = asyncio.get_running_loop()
return await loop.run_in_executor(None, self._rerank_sync, query, documents)
声明式组装:接入 LangChain ContextualCompressionRetriever
一旦封装完成,重排组件可以以极度高雅的声明式语法与任何现有 Retriever 无缝嵌套:
from langchain.retrievers import ContextualCompressionRetriever
from langchain_community.vectorstores import Milvus
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
# 1. 基础底层向量检索器 (粗筛 25 篇)
base_vector_retriever = my_vectorstore.as_retriever(search_kwargs={"k": 25})
# 2. 实例化自定义 BGE 重排压缩器 (精筛前 3 篇)
rerank_compressor = BGERerankerCompressor(
model_name_or_path="BAAI/bge-reranker-large",
top_n=3,
score_threshold=0.40,
device="cuda"
)
# 3. 核心:声明式组装为高阶压缩检索器 (一键搞定粗筛+精排!)
compression_retriever = ContextualCompressionRetriever(
base_compressor=rerank_compressor,
base_retriever=base_vector_retriever
)
# 4. 构建标准全异步 LCEL 问答管道
prompt = ChatPromptTemplate.from_template("""基于以下精排证据回答问题:
{context}
问题:{question}
回答:""")
model = ChatOpenAI(model="gpt-4o-mini", temperature=0)
# 极简 LCEL 优雅串联!
rag_chain = (
{"context": compression_retriever, "question": lambda x: x["question"]}
| prompt
| model
| StrOutputParser()
)
# 异步调用示例
# response = await rag_chain.ainvoke({"question": "Kubernetes Pod CrashLoopBackOff 排查指引"})
架构收益量化
总结
优雅的架构设计在于对框架标准协议的极致利用。将 BGE-Reranker 封装为标准的 BaseDocumentCompressor,通过 ContextualCompressionRetriever 实现两阶段检索的声明式组装,是用最少、最地道的代码构建世界级工业 RAG 流水线的标准教科书范式。