博主介绍:✌全网粉丝10W+,前互联网大厂软件研发、集结硕博英豪成立软件开发工作室,专注于计算机相关专业项目实战6年之久,累计开发项目作品上万套。凭借丰富的经验与专业实力,已帮助成千上万的学生顺利毕业,选择我们,就是选择放心、选择安心毕业✌ > 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅
点击查看作者主页,了解更多项目!
🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2026年计算机专业毕业设计选题汇总(建议收藏)✅
2、最全计算机专业毕业设计选题大全(建议收藏)✅
1、项目介绍
毕业设计:基于python图书推荐系统 书籍数据分析可视化 爬虫技术 Django框架 豆瓣图书 协同过滤推荐算法(源码+文档)✅
Python豆瓣图书推荐系统 Django+协同过滤 数据可视化 计算机毕业设计
-
数据采集模块:基于requests爬虫技术,定向抓取豆瓣图书的书名、类型、评分、评论等核心数据,自动同步至系统,为分析与推荐提供全面数据源。
-
个性化推荐模块:采用矩阵分解式协同过滤算法,通过随机梯度下降优化用户与物品特征矩阵,挖掘潜在关联,精准预测用户评分并生成个性化图书推荐列表。
-
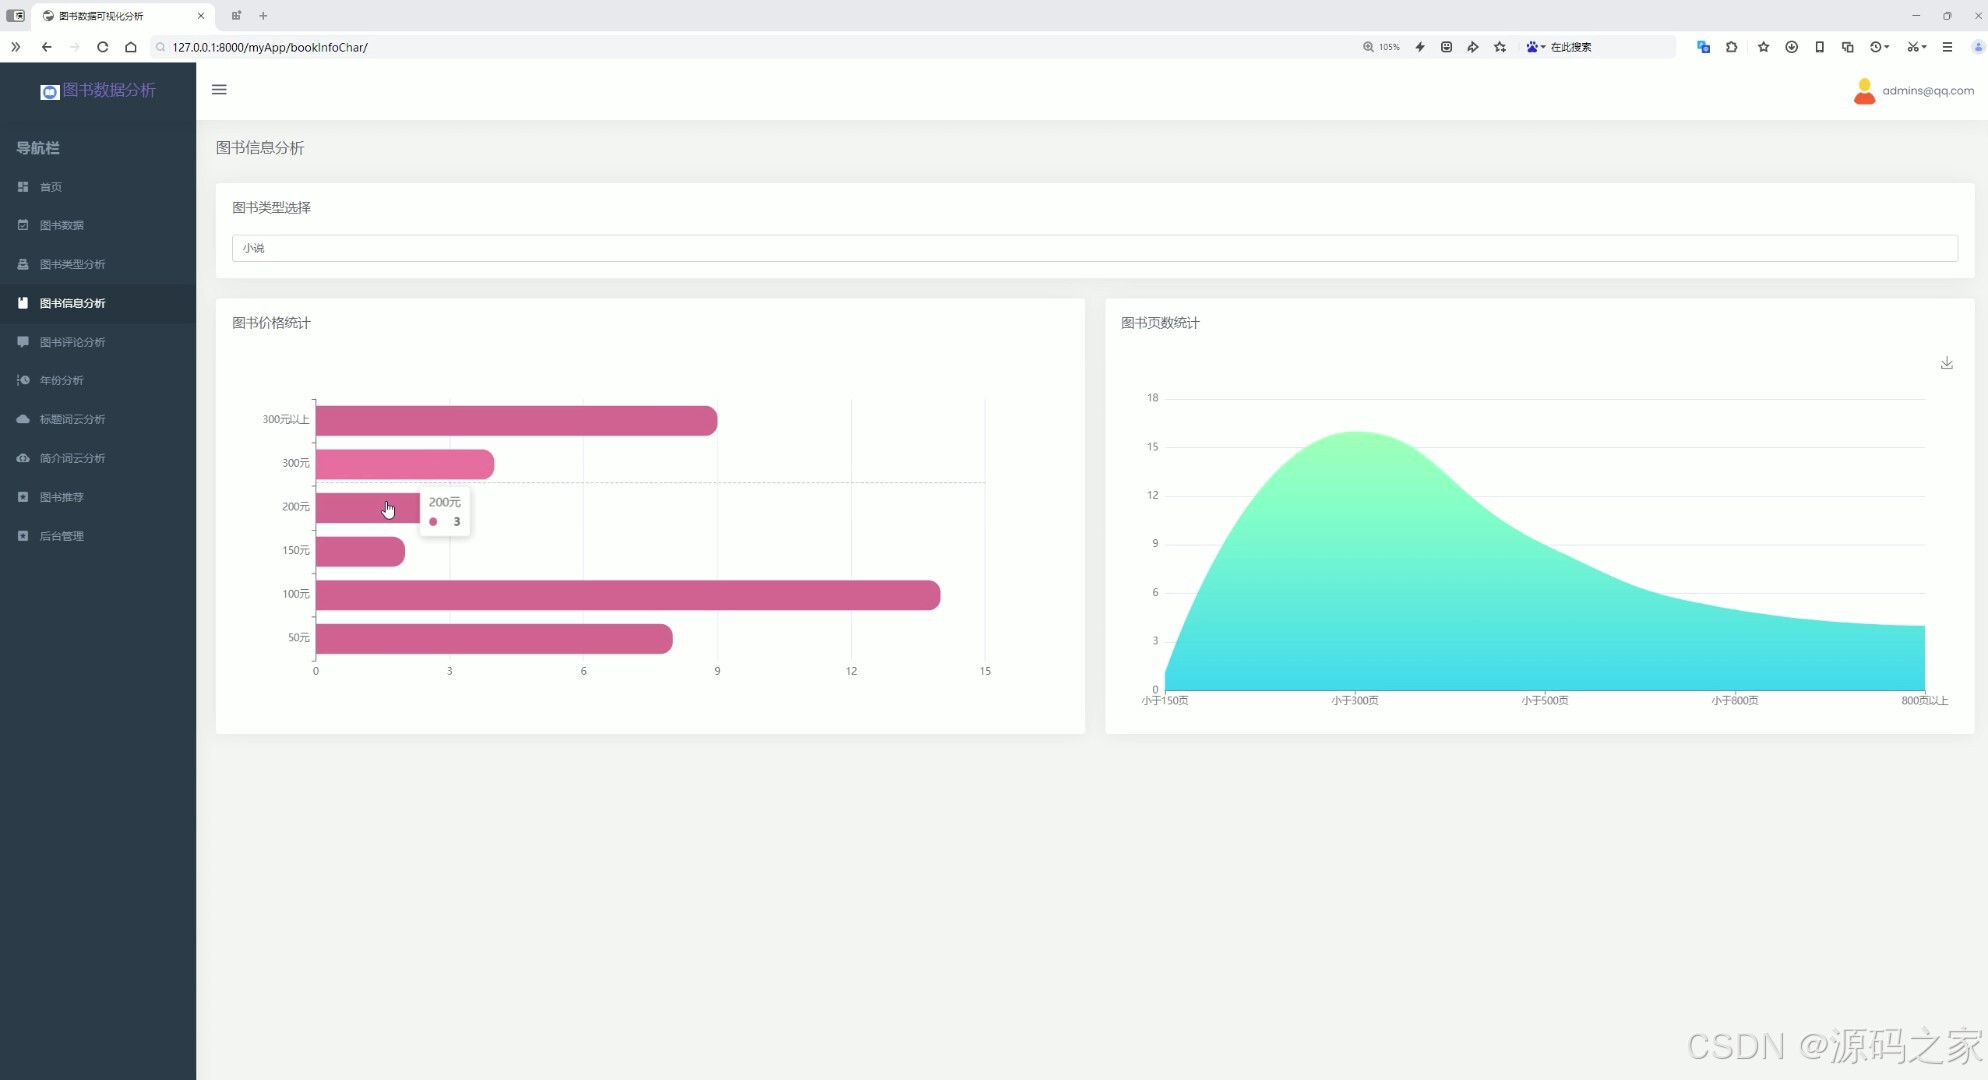
多维分析模块:整合图书类型、信息、评论及年份分析,借助Echarts生成柱状图、散点图、词云图等,直观呈现数据分布与趋势,支撑数据洞察。
-
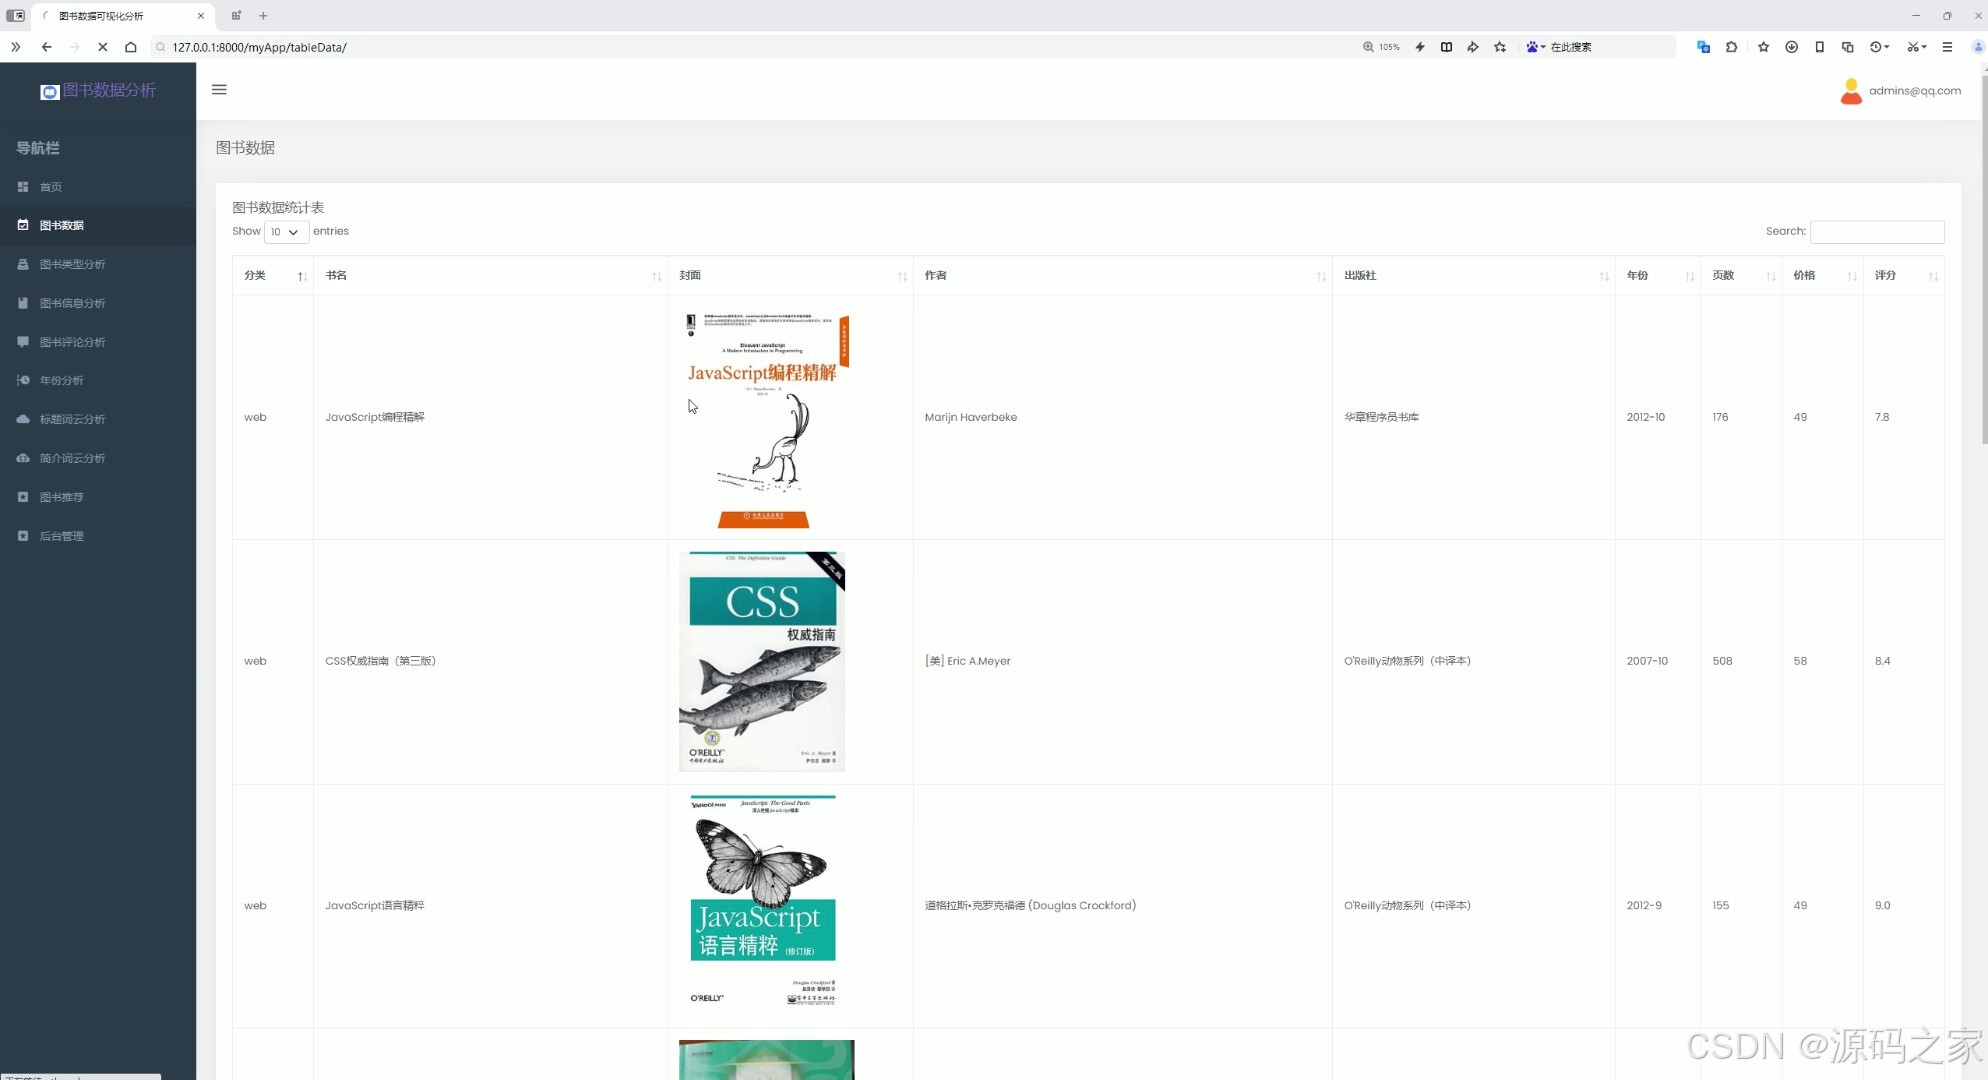
图书查询模块:提供清晰的图书列表展示,涵盖核心图书信息,方便用户快速检索浏览,搭配数据概况页实现信息高效获取。
-
数据管理模块:以MySQL存储用户数据与图书信息,管理员通过后台完成数据清洗、更新与审核,保障数据准确性与系统稳定运行。
-
用户交互模块:支持注册登录功能,实现身份验证与权限管控,为个性化推荐与数据安全提供基础支撑。
-
技术核心:基于Python与Django开发,融合爬虫、协同过滤算法及Echarts可视化,构建“采集-分析-推荐-管理”全流程图书服务平台。
技术栈: python语言、MySQL数据库、requests爬虫技术、采集豆瓣图书网站数据、Echarts可视化、 图书推荐模块:采用协同过滤推荐算法(矩阵分解的协同过滤推荐算法)
2、项目界面
(1)系统首页–数据概况

(2)图书列表
(3)图书类型分析 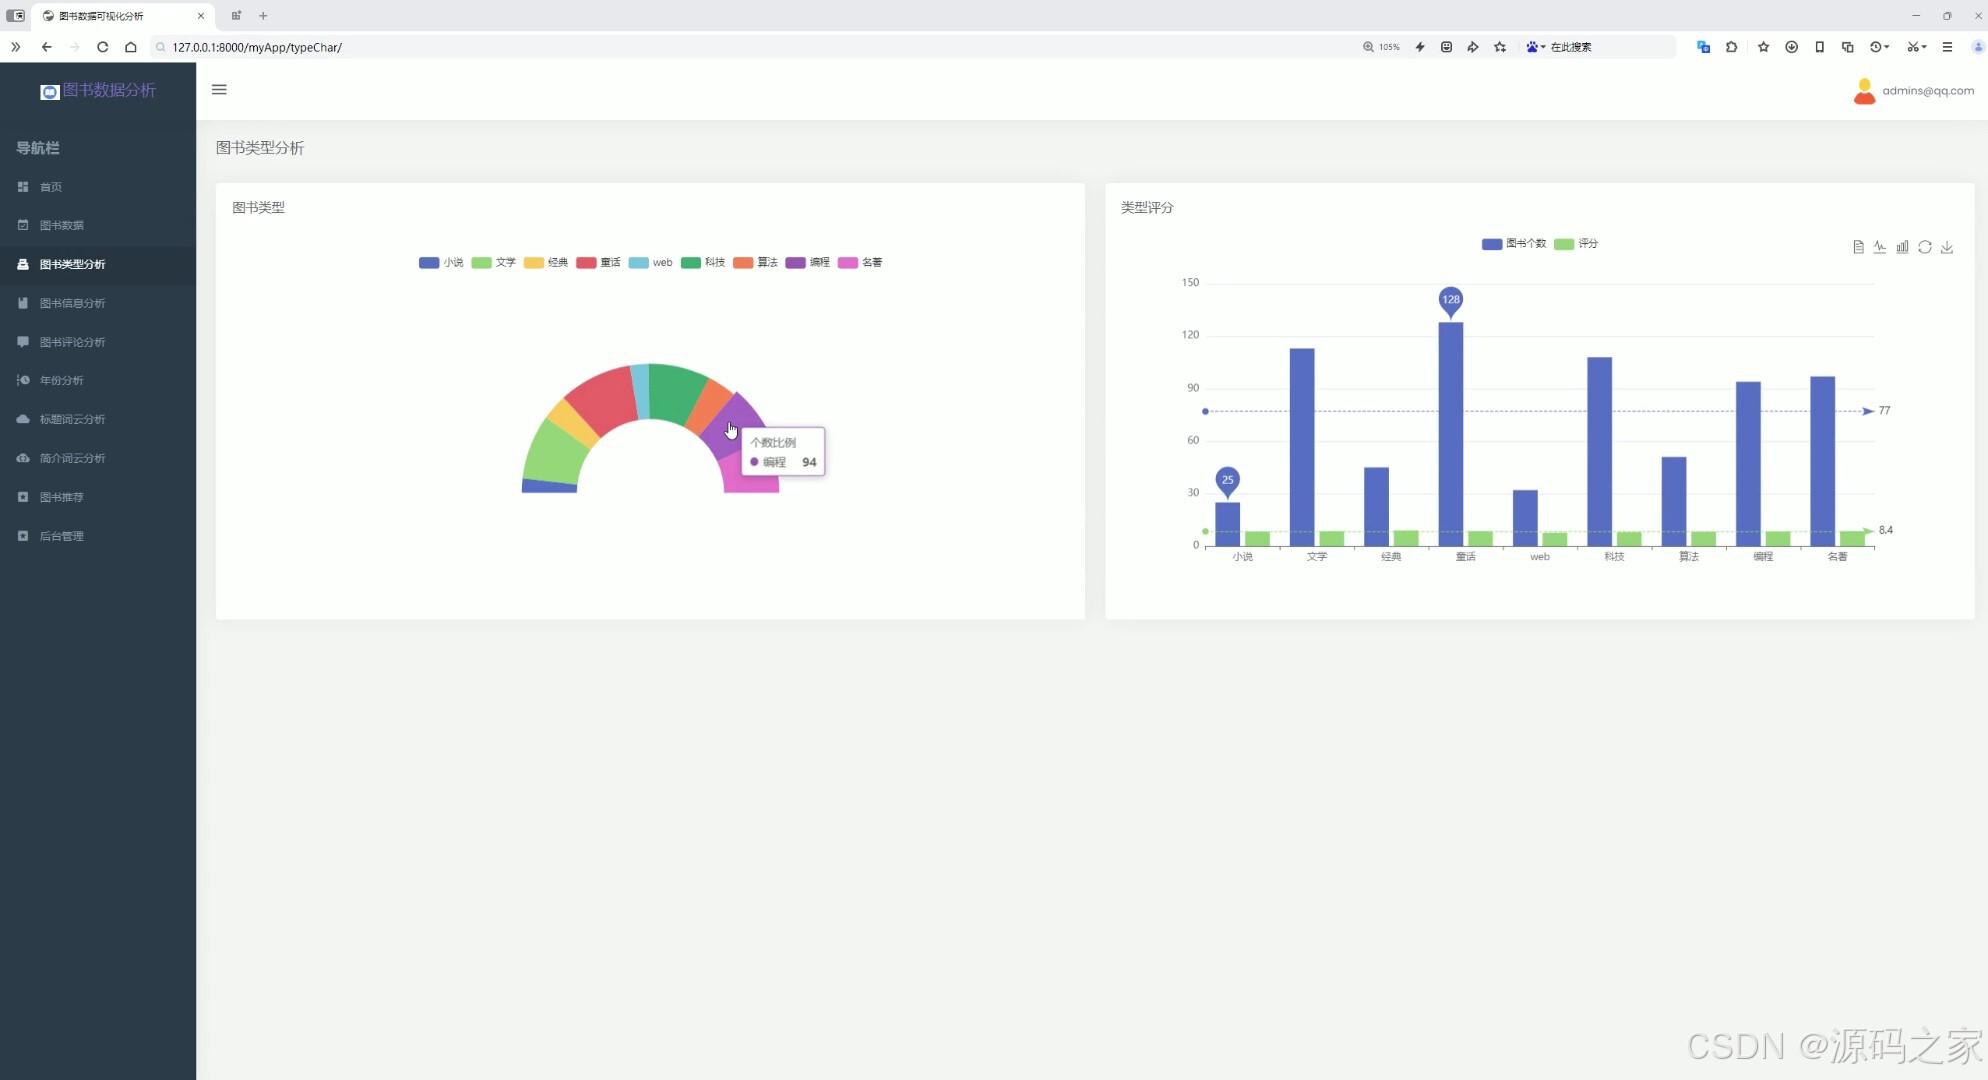
(4)图书数据分析
(5)各类型图书评论分析
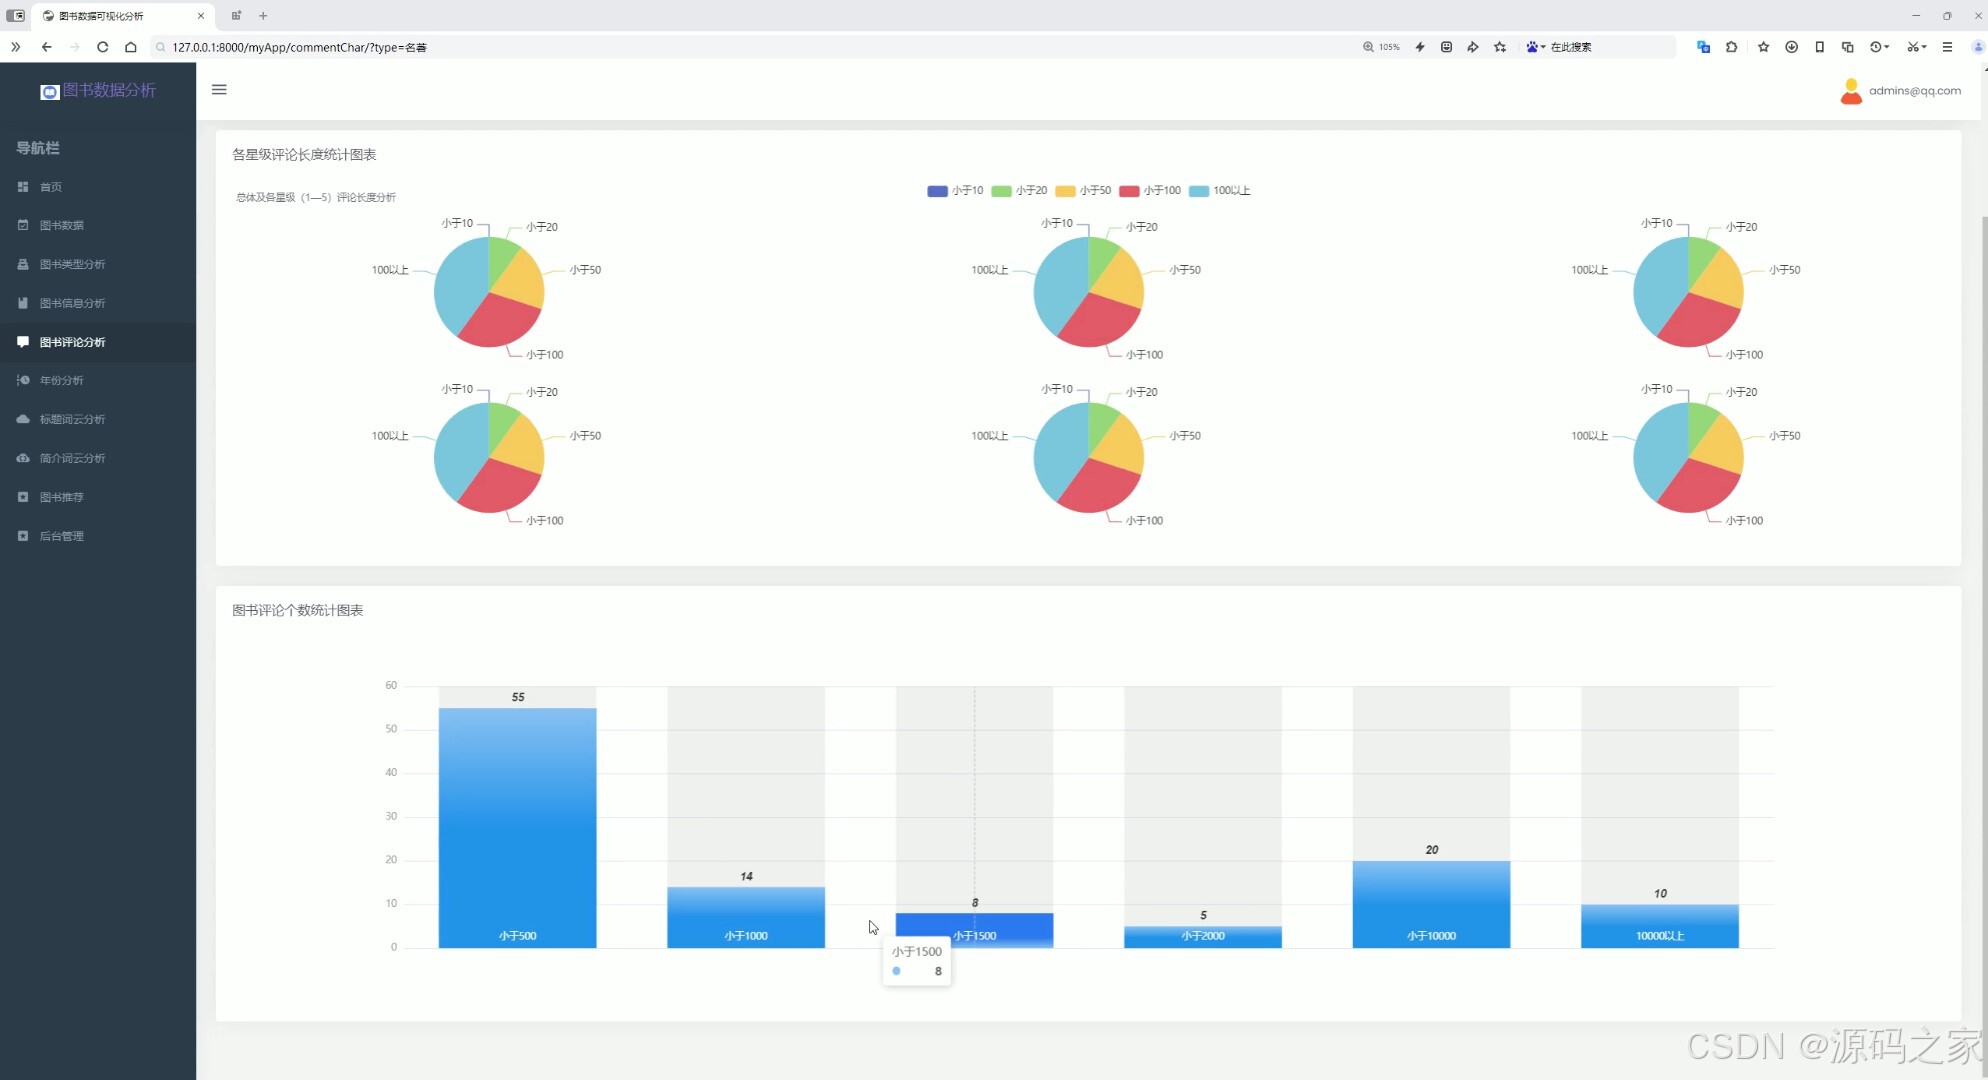
(6)年份分析
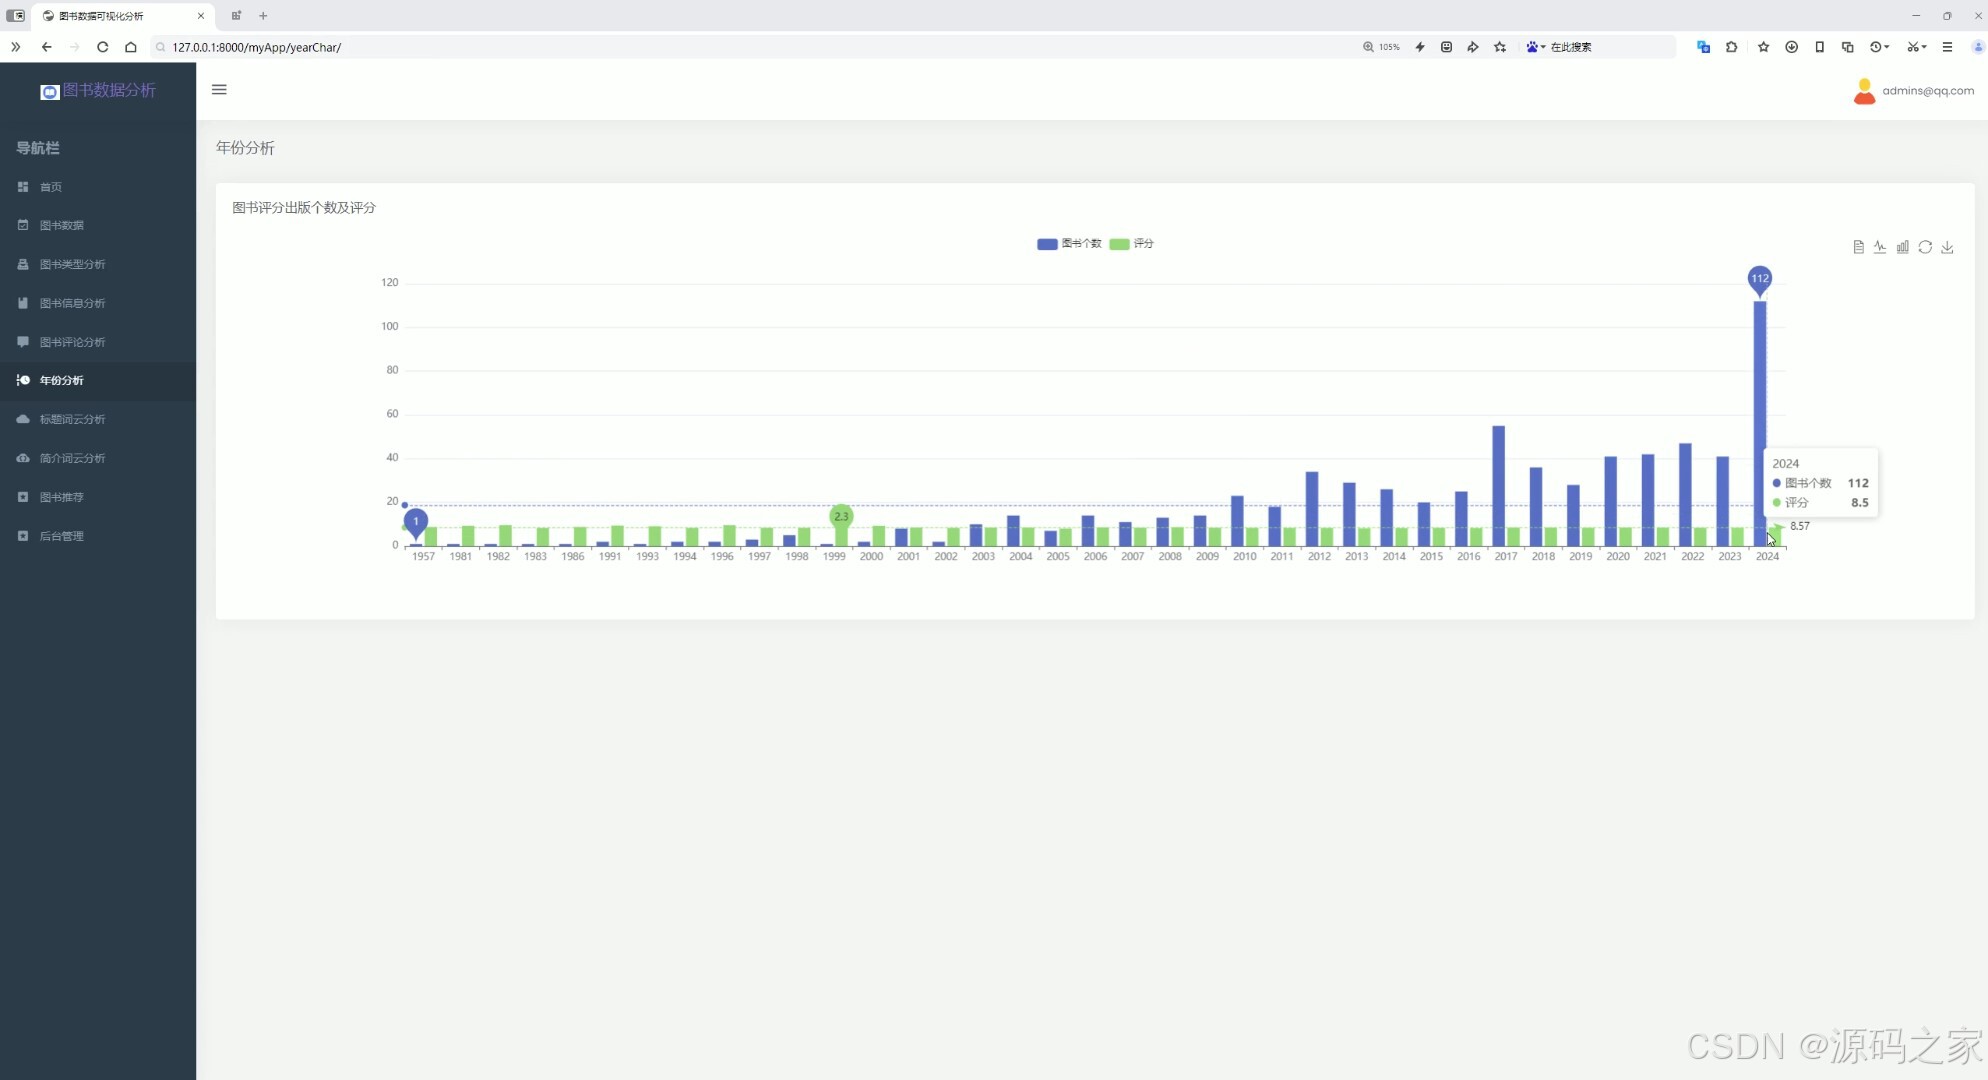
(7)词云图分析
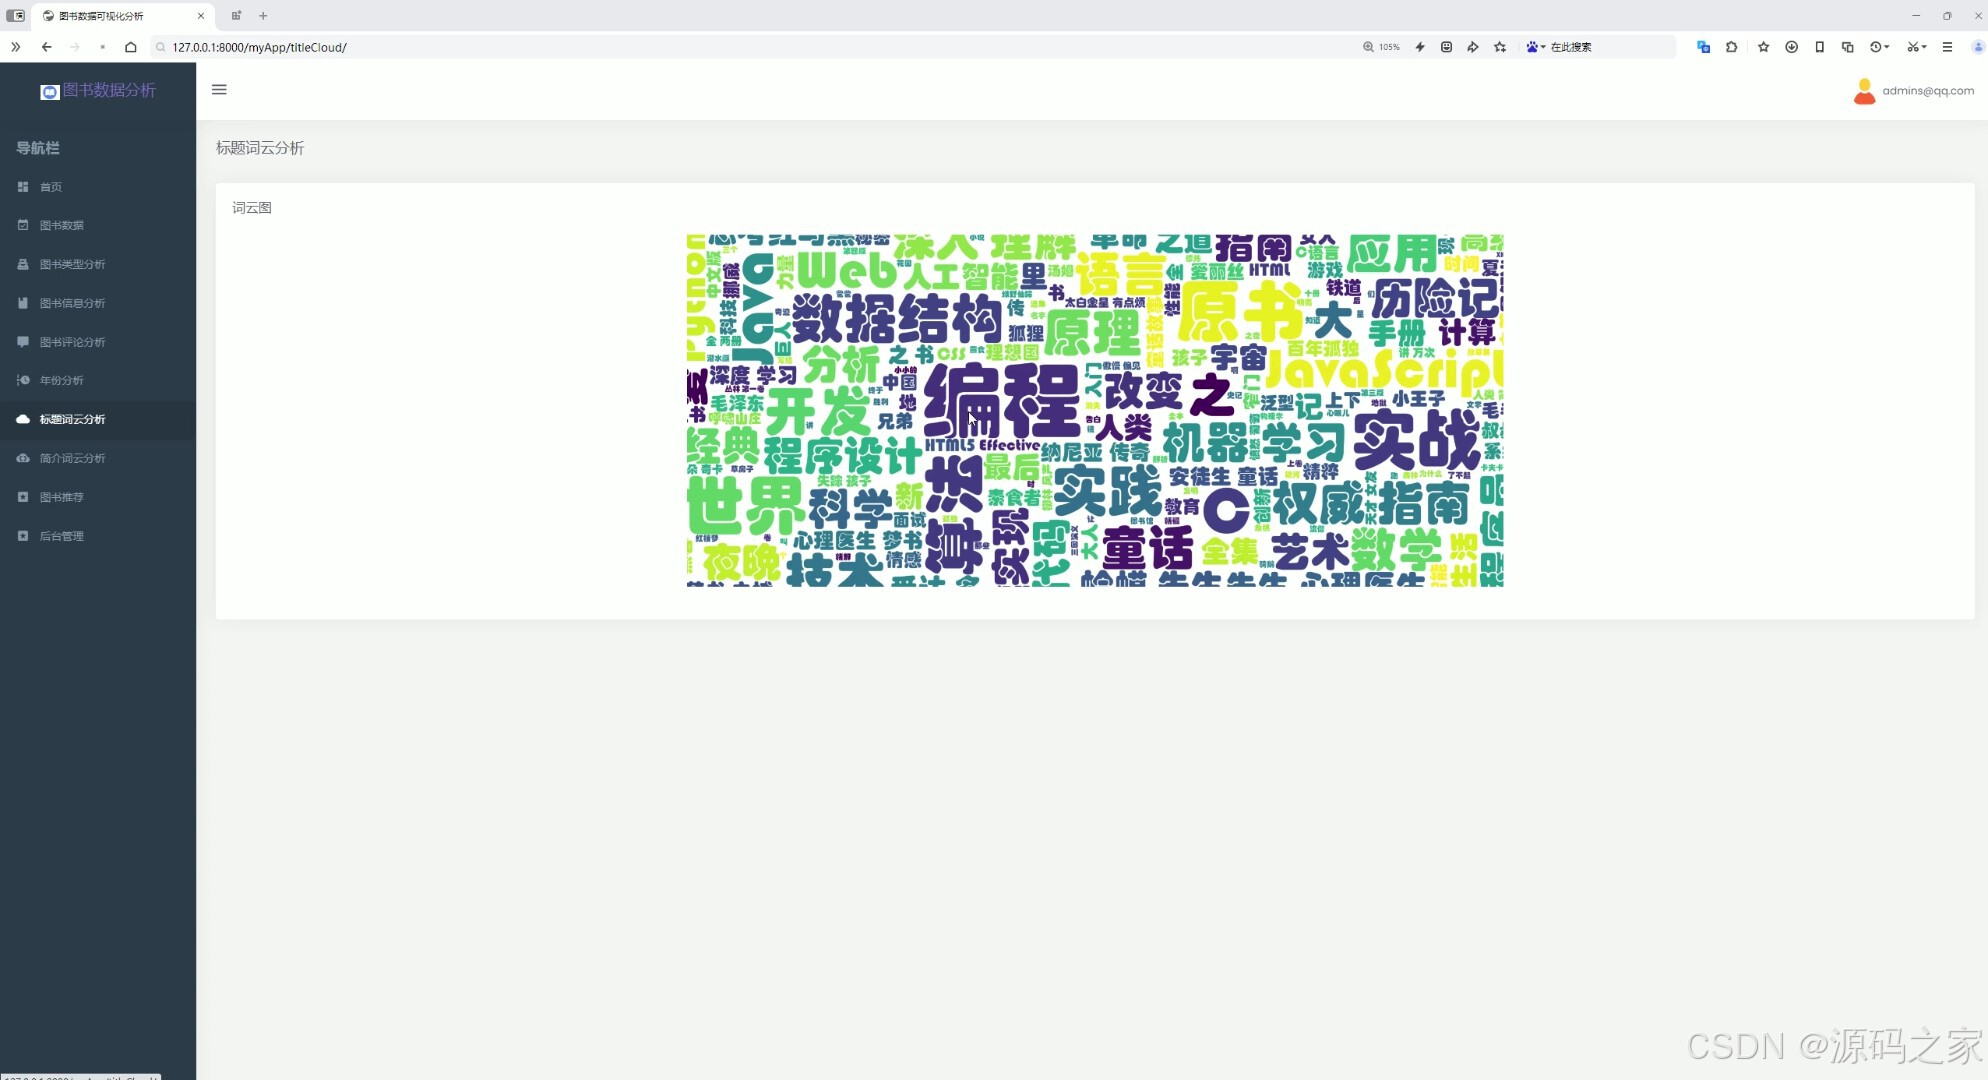
(8)图书推荐
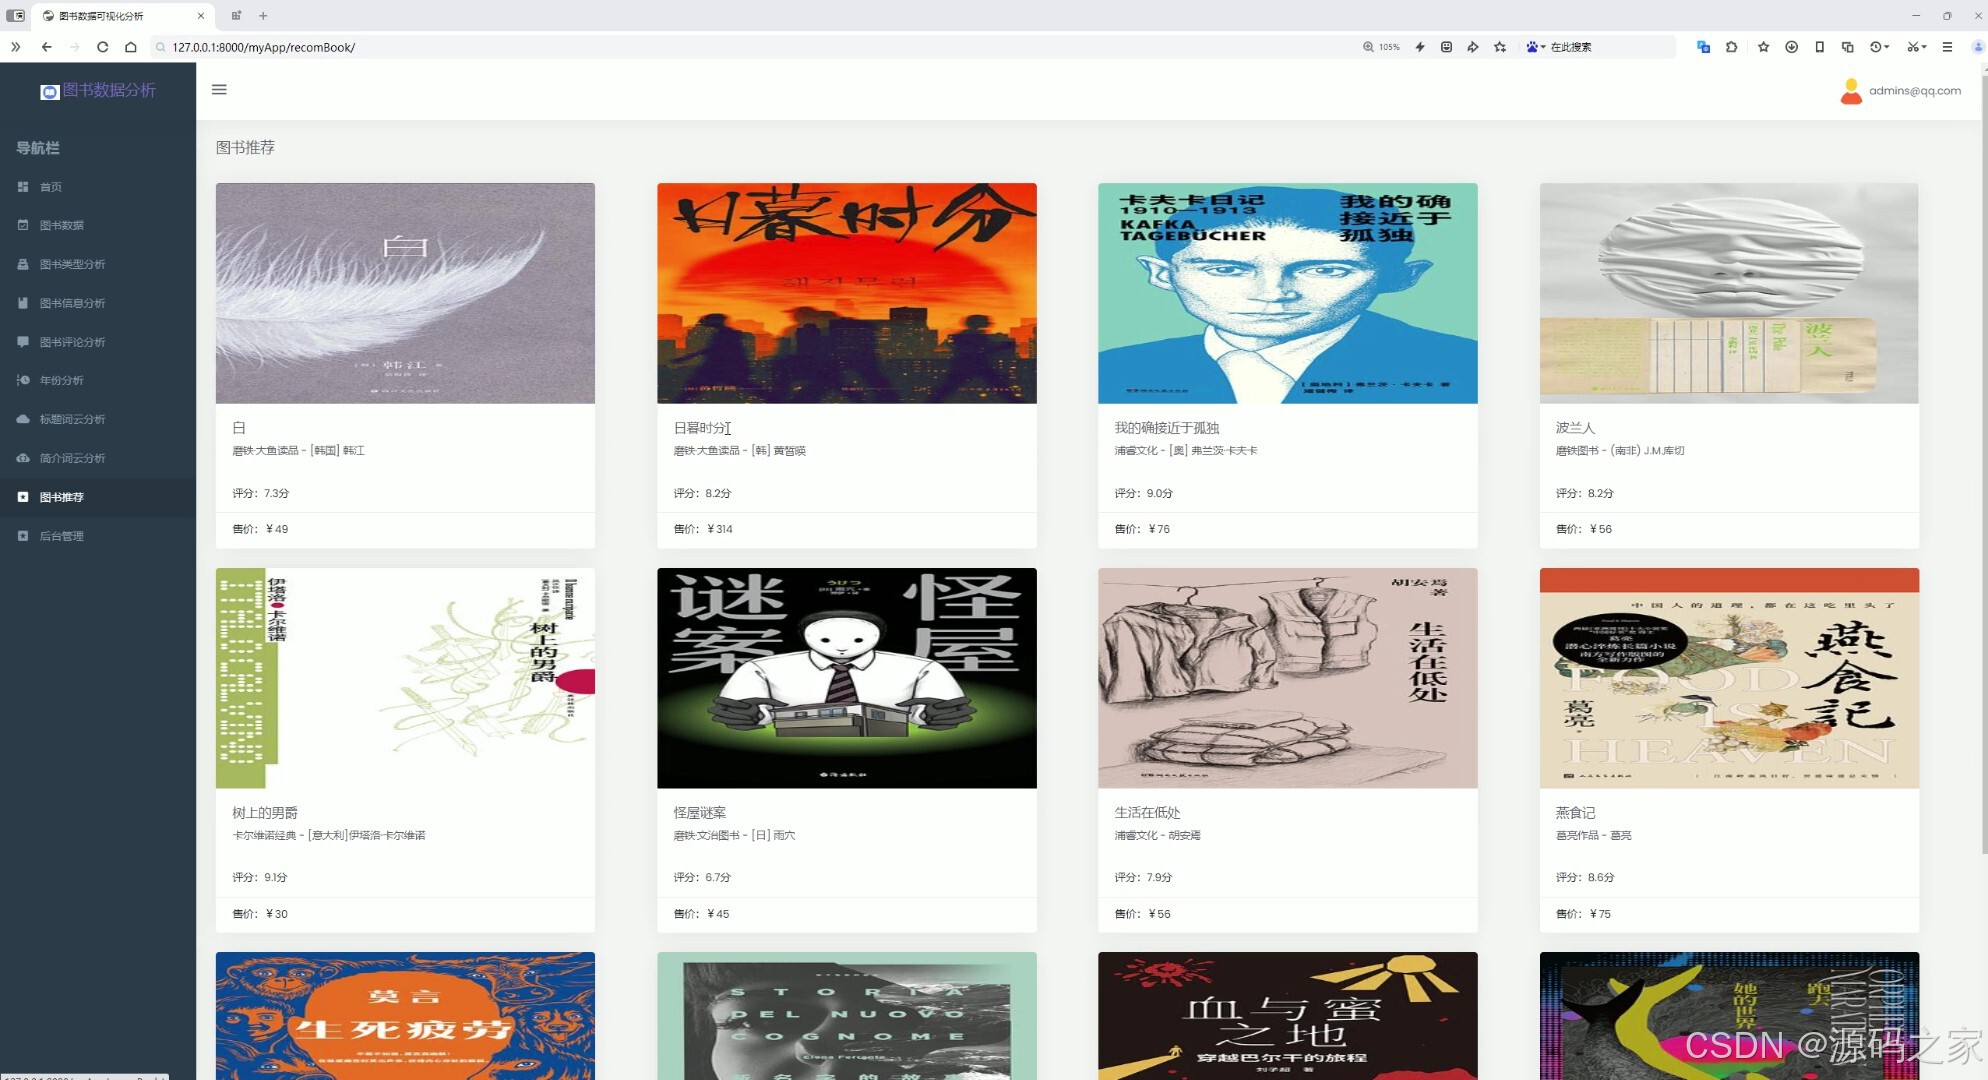
(9)后台数据管理
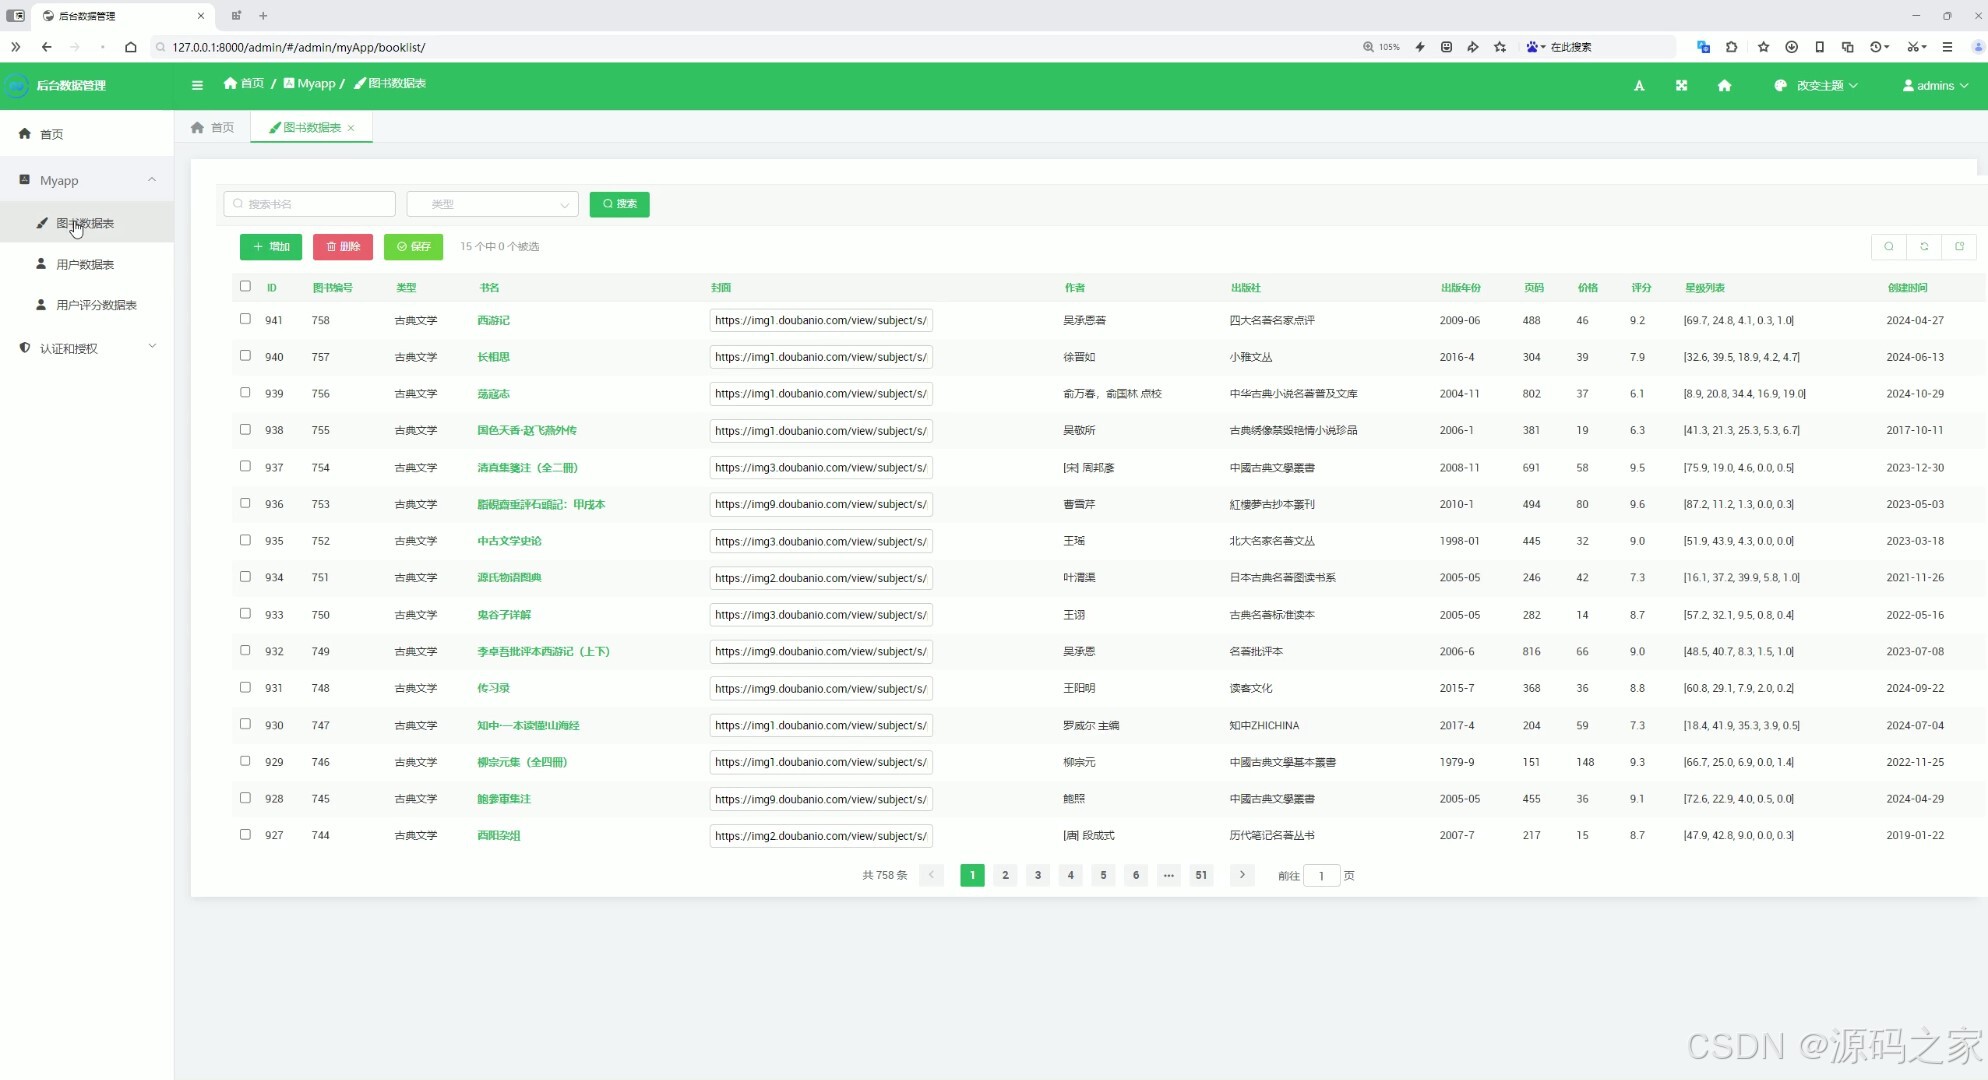
(10)注册登录

(11)数据采集
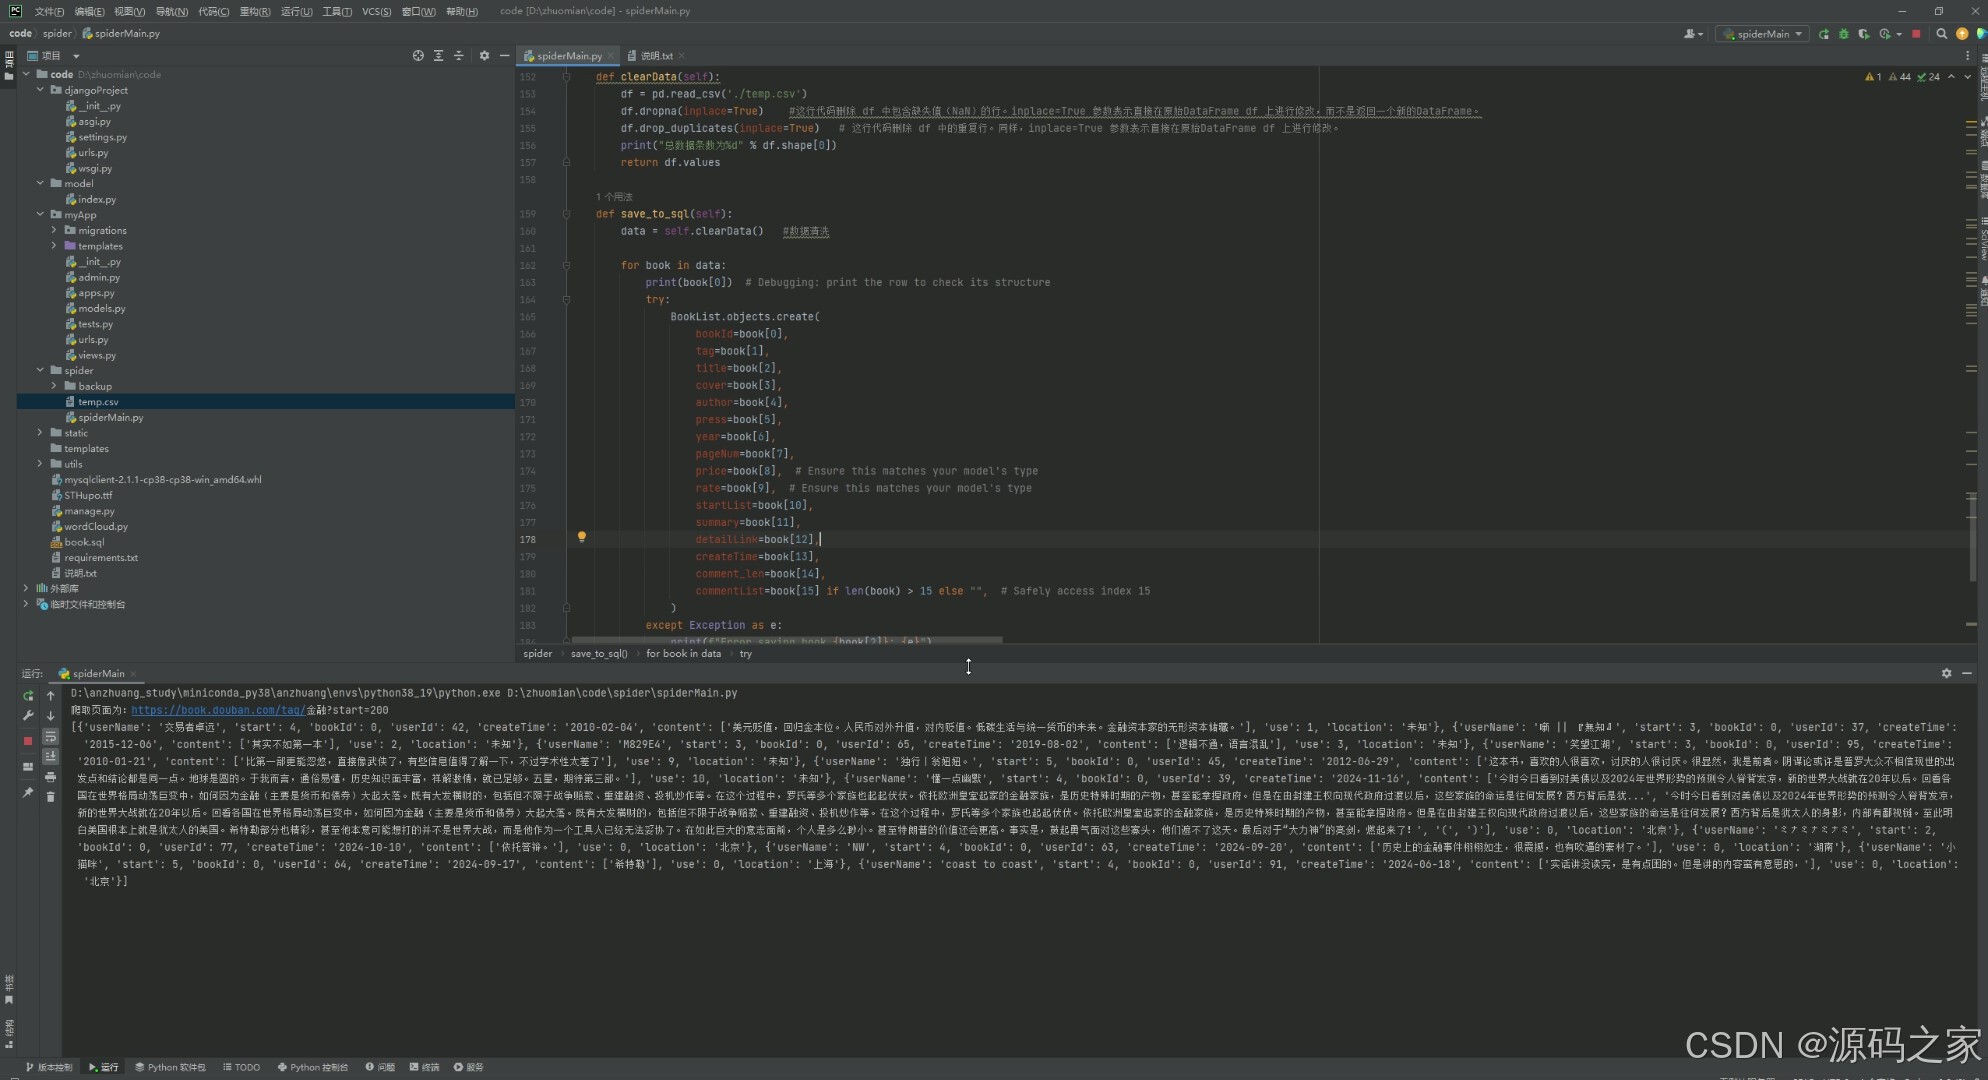
3、项目说明
Python豆瓣图书推荐系统 Django+协同过滤 数据可视化 计算机毕业设计
-
数据采集模块:基于requests爬虫技术,定向抓取豆瓣图书的书名、类型、评分、评论等核心数据,自动同步至系统,为分析与推荐提供全面数据源。
-
个性化推荐模块:采用矩阵分解式协同过滤算法,通过随机梯度下降优化用户与物品特征矩阵,挖掘潜在关联,精准预测用户评分并生成个性化图书推荐列表。
-
多维分析模块:整合图书类型、信息、评论及年份分析,借助Echarts生成柱状图、散点图、词云图等,直观呈现数据分布与趋势,支撑数据洞察。
-
图书查询模块:提供清晰的图书列表展示,涵盖核心图书信息,方便用户快速检索浏览,搭配数据概况页实现信息高效获取。
-
数据管理模块:以MySQL存储用户数据与图书信息,管理员通过后台完成数据清洗、更新与审核,保障数据准确性与系统稳定运行。
-
用户交互模块:支持注册登录功能,实现身份验证与权限管控,为个性化推荐与数据安全提供基础支撑。
-
技术核心:基于Python与Django开发,融合爬虫、协同过滤算法及Echarts可视化,构建“采集-分析-推荐-管理”全流程图书服务平台。
本系统使用的是矩阵分解算法,它是一种协同过滤推荐系统算法。 矩阵分解算法通过将用户-物品评分矩阵分解为两个低秩矩阵来预测用户对物品的评分,从而实现推荐。 MF类实现了矩阵分解算法的核心功能,包括: (1)初始化模型参数(__init__方法)。 (2)计算完整的评分矩阵(full_matrix方法)。 (3)训练模型(train方法),使用随机梯度下降(SGD)来优化用户和物品的特征矩阵。 (4)计算模型的总误差(compute_cost方法)。 modelFn函数用于为指定用户生成推荐列表。它首先获取所有用户的评分数据,然后创建用户-物品评分矩阵,接着使用矩阵分解模型预测评分,并最终生成推荐列表。 这种基于矩阵分解的推荐系统能够有效地处理大规模数据集,并且能够发现用户和物品之间的潜在特征,从而提供个性化的推荐。
随着大数据技术的发展,个性化推荐已成为提升用户体验的关键。图书推荐领域依然依赖传统人工筛选与有限的分类,推荐准确性差,无法满足用户多样化需求,且推荐结果更新滞后,无法根据用户兴趣变化做出及时调整。 本系统基于 Python 语言开发,采用 MySQL 数据库存储用户与图书信息,使用 Echarts 进行数据可视化展示。系统主要由四个模块构成:数据采集模块、数据分析模块、图书推荐模块与数据管理模块。数据采集模块利用 requests 爬虫技术从豆瓣图书网站自动采集图书数据。数据分析模块包括图书类型、信息、评论与年份的分析,并通过 Echarts 展示分析结果。图书推荐模块采用协同过滤算法,基于矩阵分解技术为用户提供个性化的图书推荐。矩阵分解算法通过将用户-物品评分矩阵分解为两个低维矩阵来预测评分,生成推荐列表。数据管理模块用于管理系统内的数据存储与清洗。
4、核心代码
import os
import numpy as np
os.environ.setdefault("DJANGO_SETTINGS_MODULE", "djangoProject.settings")
from django import setup
setup()
from myApp.models import *
class MF:
def __init__(self, R, k=2, alpha=0.1, beta=0.8, iterations=10):
"""
初始化矩阵分解模型
R: 用户-物品评分矩阵
k: 隐藏因子的数量(即矩阵分解后的维度)
alpha: 学习率
beta: 正则化参数
iterations: 训练的迭代次数
"""
self.R = R # 用户-物品评分矩阵
self.k = k # 隐藏因子的数量
self.alpha = alpha # 学习率
self.beta = beta # 正则化参数
self.iterations = iterations # 训练迭代次数
self.num_users, self.num_items = R.shape # 获取用户数和物品数
# 随机初始化用户矩阵P和物品矩阵Q
self.P = np.random.rand(self.num_users, self.k)
self.Q = np.random.rand(self.num_items, self.k)
# 用户和物品的偏置项
self.b_u = np.zeros(self.num_users)
self.b_i = np.zeros(self.num_items)
# 全局偏置项(全体用户对全体物品的平均评分)
self.b = np.mean(R[R > 0])
def full_matrix(self):
"""
计算完整的评分矩阵
该矩阵包含每个用户对所有物品的预测评分
"""
return self.b + self.b_u[:, np.newaxis] + self.b_i[np.newaxis, :] + self.P.dot(self.Q.T)
def train(self):
"""
训练模型
使用随机梯度下降算法(SGD)来优化用户和物品的特征矩阵
"""
for _ in range(self.iterations):
for i in range(self.num_users):
for j in range(self.num_items):
if self.R[i][j] > 0: # 仅考虑用户评分过的物品
# 计算预测评分与实际评分之间的误差
eij = self.R[i][j] – self.full_matrix()[i][j]
for f in range(self.k):
# 更新用户矩阵P和物品矩阵Q的隐因子
self.P[i][f] += self.alpha * (2 * eij * self.Q[j][f] – self.beta * self.P[i][f])
self.Q[j][f] += self.alpha * (2 * eij * self.P[i][f] – self.beta * self.Q[j][f])
# 更新用户和物品的偏置项
self.b_u[i] += self.alpha * (eij – self.beta * self.b_u[i])
self.b_i[j] += self.alpha * (eij – self.beta * self.b_i[j])
# 输出每轮的误差(用于调试和查看训练效果)
cost = self.compute_cost()
# print(f"迭代 {_ + 1}:成本 {cost}")
def compute_cost(self):
"""
计算当前模型的总误差
"""
cost = 0
for i in range(self.num_users):
for j in range(self.num_items):
if self.R[i][j] > 0:
eij = self.R[i][j] – self.full_matrix()[i][j]
cost += eij**2
for f in range(self.k):
cost += (self.beta / 2) * (self.P[i][f]**2 + self.Q[j][f]**2)
return cost
def getAllData():
"""
获取用户评分数据,返回一个列表,每个元素是一个元组 (用户ID, 图书ID, 评分)
这里假设评分数据存储在 UserBookRating 表中
"""
ratings = UserBookRating.objects.all() # 获取所有评分记录
# 将查询结果转化为元组列表,格式为 (用户ID, 图书ID, 评分)
data = [(rating.user.id, rating.book.id, rating.rating) for rating in ratings]
print("格式为 (用户ID, 图书ID, 评分):")
print(data)
return data
def getUIMat(obs_dataset):
"""
将用户评分数据转化为用户-物品评分矩阵
"""
users = list(set([x[0] for x in obs_dataset])) # 获取所有唯一用户
items = list(set([x[1] for x in obs_dataset])) # 获取所有唯一物品(图书)
# 为用户和图书创建索引映射
user_index = {user: idx for idx, user in enumerate(users)}
item_index = {item: idx for idx, item in enumerate(items)}
# 初始化评分矩阵R
R = np.zeros((len(users), len(items)))
for user_id, item_id, rating in obs_dataset:
R[user_index[user_id], item_index[item_id]] = rating # 填充评分矩阵
return R
def modelFn(each_user):
"""
基于协同过滤算法为指定用户推荐图书
"""
startList = getAllData() # 获取所有评分数据
obs_dataset = [(user_id, item_id, rating) for user_id, item_id, rating in startList] # 准备数据
R = getUIMat(obs_dataset) # 创建用户-物品评分矩阵
# 获取用户矩阵的大小
num_users = R.shape[0] # 获取用户数量
# 确保用户ID在有效范围内,自动调整为合法值
each_user = each_user % num_users # 使用模运算来确保用户ID在有效范围内
# 创建并训练MF模型
mf = MF(R, k=10, alpha=0.05, beta=0.02, iterations=50) # 设置参数并训练模型
mf.train() # 训练模型
# 获取指定用户的预测评分
user_ratings = mf.full_matrix()[each_user].tolist()
# 生成推荐的图书列表
topN = [(i, user_ratings[i]) for i in range(len(user_ratings)) if R[each_user][i] == 0] # 只推荐用户未评分的图书
topN = sorted(topN, key=lambda x: x[1], reverse=True) # 根据预测评分排序
topN = [i[0] for i in topN[:12]] # 获取前12本推荐的图书
print(topN)
return topN
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目编程以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻