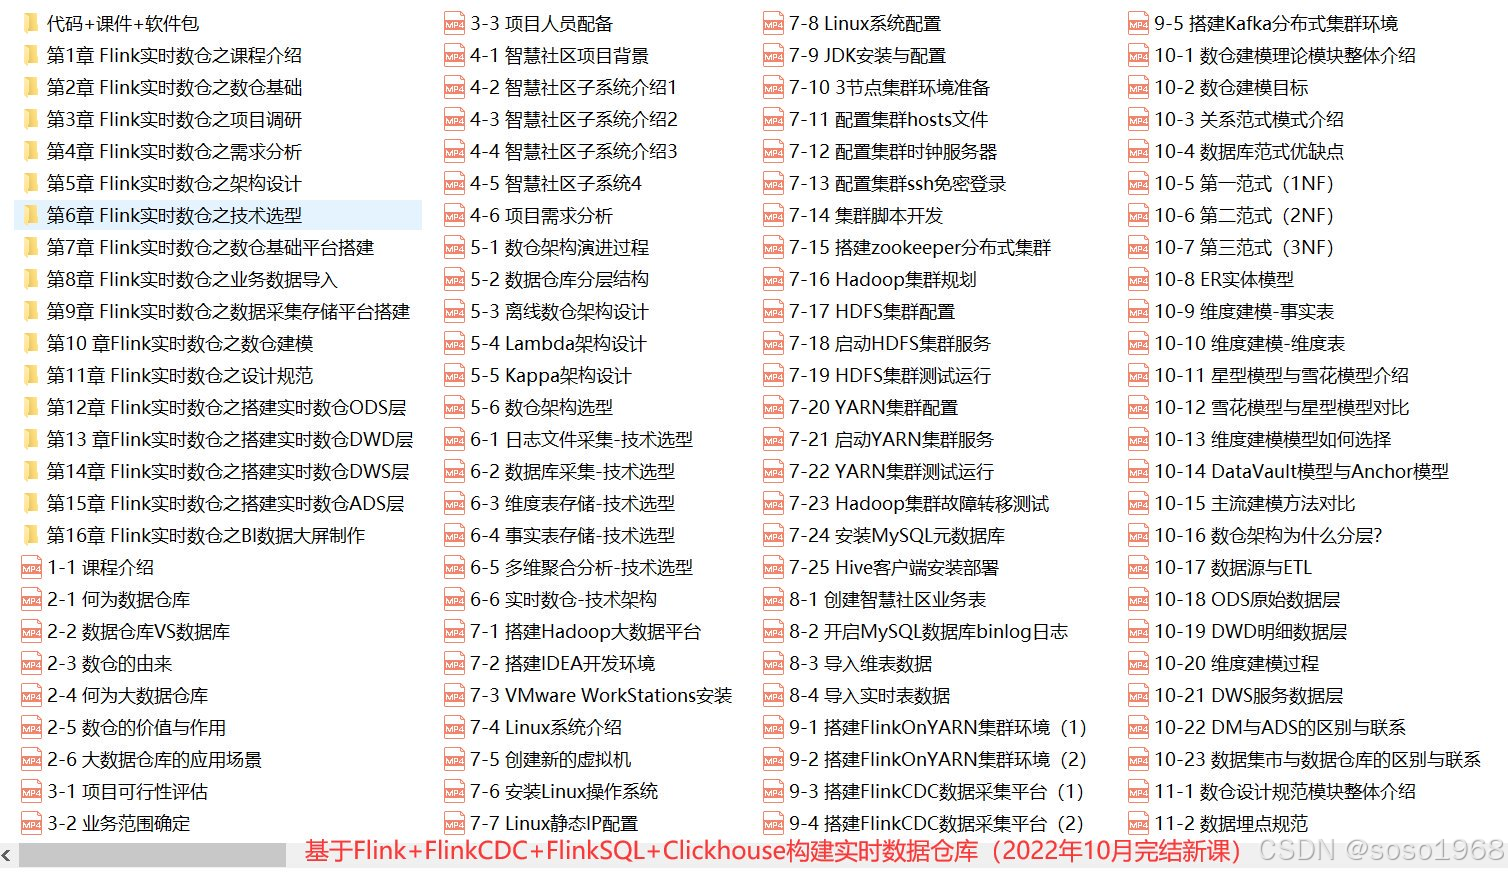
 文件链接: https://pan.baidu.com/s/1DGfYvCSmYSf60wo83-tMCg?pwd=1688 提取码: 1688
该文章的核心干货围绕一套基于 Flink + FlinkCDC + FlinkSQL + ClickHouse 的实时数仓完整建设方案展开,涵盖技术选型、整体架构、核心知识点与实战项目四大部分 。
一、技术栈定位
| Flink | 分布式流处理框架,承担实时计算引擎,负责清洗、转换、聚合等加工 |
| FlinkCDC | 实时捕获 MySQL 等数据库 binlog,将增删改操作转换为流式事件 |
| FlinkSQL | 以 SQL 方式完成流表定义、维表关联、窗口聚合、双流 Join 等逻辑 |
| ClickHouse | 列式存储数据库,作为结果存储与分析引擎,提供秒级查询能力 |
该技术栈的组合逻辑非常清晰:FlinkCDC 负责“数据进得来”,FlinkSQL 负责“数据算得动”,ClickHouse 负责“数据查得快” 。
二、实时数仓整体架构
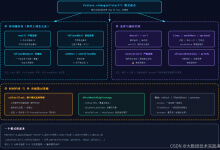
课程将实时数仓划分为三个核心层次 :
- 数据接入层:通过 FlinkCDC 实时监听业务数据库(如 MySQL)的变更日志,将数据以流的形式接入 Flink 计算引擎。
- 实时计算层:基于 FlinkSQL 进行 ETL 清洗、维度关联、指标计算,支持多级分层加工,形成可复用的实时数据模型。
- 数据服务层:将 Flink 计算结果写入 ClickHouse,对外提供高并发实时查询,支撑报表、大屏和即席分析。
这三层构成了实时的数据流转主链路,从源端数据库一直到最终的分析服务,中间没有离线批处理环节,体现了“实时数仓”的核心差异点。
三、核心知识点拆解
文章重点讲解以下四块关键知识 :
1. FlinkCDC 数据同步
- 部署配置;
- 全量加增量同步机制;
- 断点续传原理;
- 支持将 MySQL 多表数据实时同步到 Kafka 或直接进入 Flink 计算任务。
2. FlinkSQL 实时计算
- 流表 Source/Sink 的定义方式;
- 窗口函数:滚动窗口、滑动窗口、会话窗口;
- 维表关联(Lookup Join);
- 双流 Join 实现方法;
- 结合实际业务场景编写实时计算 SQL。
3. ClickHouse 建模与查询优化
- 分布式表与本地表设计;
- MergeTree 引擎家族;
- 分区与排序键设计;
- 常见查询优化手段,确保实时写入和查询性能达到生产要求。
4. 实时数仓分层设计
参照离线数仓分层思想,课程强调实时数仓的 ODS、DWD、DWS、ADS 分层设计,并明确各层之间的数据流转方式,帮助学习者建立规范的实时数仓建模思路 。
| ODS | 原始数据层,承接接入的原始业务数据 |
| DWD | 明细数据层,完成清洗、标准化、维度补充 |
| DWS | 汇总数据层,面向主题做轻度聚合 |
| ADS | 应用数据层,按需求输出最终结果 |
分层设计的价值在于复用与解耦:每一层只依赖下一层的结果,使指标口径可统一维护,同时便于各层独立优化和扩展。
四、实战项目
课程配套一个完整的电商实时数仓实战项目,覆盖订单、用户、商品、支付等核心业务主题。项目流程从环境搭建、数据接入、实时计算,一直到 ClickHouse 报表展示,完整跑通一条实时数仓开发流程 。这意味着学习者不只是学习孤立组件,而是能够将 CDC 接入、SQL 计算、ClickHouse 建模串成一条可落地的生产链路。
五、适用人群与学习建议
文章明确指出该课程适合三类人群 :
- 有一定大数据基础,希望转型实时计算方向的开发工程师;
- 正在从事数仓建设、希望引入实时数仓能力的数据工程师;
- 对 Flink、FlinkCDC、ClickHouse 技术栈感兴趣,希望系统学习的学习者。
学习建议强调动手实践:搭建本地环境、跟随课程完成每个实验环节,并在实战项目中尝试独立完成部分模块开发,以加深对实时数仓整体架构和关键技术点的理解 。
六、整体评价
这篇文章本质上是一门课程的资料介绍,而非源码解析或原理推导,因此核心干货更多体现在“知识地图”而非“代码细节”上。它给出了实时数仓建设中最重要的组件组合方式、分层建模思路和关键实现要点,对于入门实时数仓或规划技术方案有较强的指引作用。若要从这篇文章中拿到可直接上手的产出,还需要将其中提到的 FlinkCDC 配置、FlinkSQL 语法和 ClickHouse 建表语句进一步落到具体工程实践中 。
参考来源
- 【课程资料】基于Flink+FlinkCDC+FlinkSQL+Clickhouse构建实时数据仓库