最近在了解 AI Agent、工作流和 AI 模型时,经常会遇到一个问题:
AI 一定要通过生成文字来完成任务吗?
传统的大语言模型(LLM)通常擅长理解、推理和生成内容。例如让模型写一段文案、总结一份文档、分析一组数据,它最终都会以文本等形式给出结果。
但在很多实际业务中,我们真正需要的可能并不是一段文字,而只是一个判断结果:
- 这条消息是不是售后问题?
- 这个客户是否值得跟进?
- 这条数据属于哪种类型?
- 当前风险处于什么等级?
- 一个请求应该进入哪个业务流程?
这类任务的核心不是“生成什么”,而是应该做出什么决定。
Jev 就是针对这一类问题提出的一种模型。
一、Jev 是什么:从“生成内容”到“做出判断”
Jev 是 TypeSafe 提出的 System One Model。
它的核心理念可以概括为:
Decisions, not strings.
也就是:重点不是生成字符串,而是做出决定。
传统 LLM 可以理解为一个非常强大的通用语言模型,它能够阅读上下文、进行推理,然后生成自然语言结果。
而 Jev 更关注其中一个更窄的环节:
面对当前状态,我应该选择什么结果?
因此,Jev 并不是一个“小型 GPT”,也不是为了取代 LLM。
它更像是一个专门负责判断和决策的模型。
1. System One 和 System Two
Jev 使用了认知科学中 System 1 / System 2 模型的概念来描述自己的定位。
简单理解:
| System One | 快速、直觉式判断 | 分类、选择、评分、是否判断 |
| System Two | 更复杂的分析与推理 | 长文本分析、复杂推理、内容生成 |
主流 LLM 往往更偏向 System Two 类型的任务:理解复杂上下文、进行推理并生成内容。
Jev 则将重点放在 System One 式的判断上。
因此,两者并不是简单的替代关系。
例如:
LLM:分析这位客户最近的聊天记录,并总结他的需求。
Jev:判断这个客户是否值得进一步跟进。
前者需要生成和分析大量内容,后者最终可能只需要一个明确的判断结果。
二、Jev 的三个核心能力:Noul、Score、Choice
Jev 将判断任务抽象成三种基础形式:
Noul、Score 和 Choice。
官方测试示例也正是围绕这三种能力设计的。
与其把它们理解成三个复杂的 AI 功能,不如简单理解成三种问题:
是不是?多少程度?属于哪一个?
1. Noul:判断“是不是”
Noul 用于处理最简单的二元判断。
也就是一个问题最终只有两种结果,例如:
- 是否属于售后问题?
- 是否需要人工介入?
- 是否满足某个条件?
- 是否存在某种风险?
官方测试结构如下:
{
"new_noul_1": {
"type": "noul",
"instructions": "Ask a yes or no question",
"criteria": {
"true": "",
"false": ""
}
}
}
这里的几个字段比较直观:
- type:指定使用 Noul 类型;
- instructions:描述需要模型判断的问题;
- criteria:定义最终可能得到的结果。
Noul 的特点就是不需要生成一段解释性文字,而是直接完成判断。
例如在一个售后工作流中,可以让它判断:
“这条客户消息是否属于售后问题?”
如果判断为 true,后续进入售后流程;如果判断为 false,则可以进入其他流程。
这也是 Jev 和 Agent、工作流结合时比较典型的一种使用方式。
2. Score:判断“处于什么程度”
现实中的很多问题并不是简单的“是”或者“否”。
例如:
- 客户意向有多高?
- 风险有多大?
- 匹配程度如何?
- 当前任务完成到了什么程度?
这时候可以使用 Score。
官方测试结构:
{
"new_score_1": {
"type": "score",
"instructions": "Where does the state fall on the scale?",
"criteria": [
"Lowest level of one dimension",
"Middle level of the same dimension",
"Highest level of the same dimension"
]
}
}
这里的 criteria 定义了一组有顺序的等级。
例如:
低
中
高
模型需要判断当前状态更接近哪个等级。
因此,Score 和传统意义上的“让 LLM 输出一个数字”并不完全一样。
它的重点是:
预先定义一个判断尺度,让模型将当前状态放到这个尺度中。
这样得到的结果更适合直接进入后续程序或工作流。
3. Choice:判断“属于哪一种”
Choice 则是从多个选项中选择一个最符合当前状态的结果。
例如:
- 这条消息属于咨询、售后还是投诉?
- 当前客户属于新客户、意向客户还是成交客户?
- 当前请求应该交给哪个业务流程?
官方测试结构:
{
"new_choice_1": {
"type": "choice",
"instructions": "Which option best fits the state?",
"criteria": {
"option_a": "Description of an option",
"option_b": "Another description of a distinct option",
"option_c": "Another mutually exclusive option"
}
}
}
这里的 criteria 定义了不同的候选项。
例如可以设计成:
{
"option_a": "售前咨询",
"option_b": "售后问题",
"option_c": "投诉反馈"
}
模型需要根据当前状态,从这些选项中选择最符合的一项。
因此,Choice 本质上可以理解成:
让 AI 完成结构化分类,而不是生成一段分类说明。
4. 三种能力放在一起理解
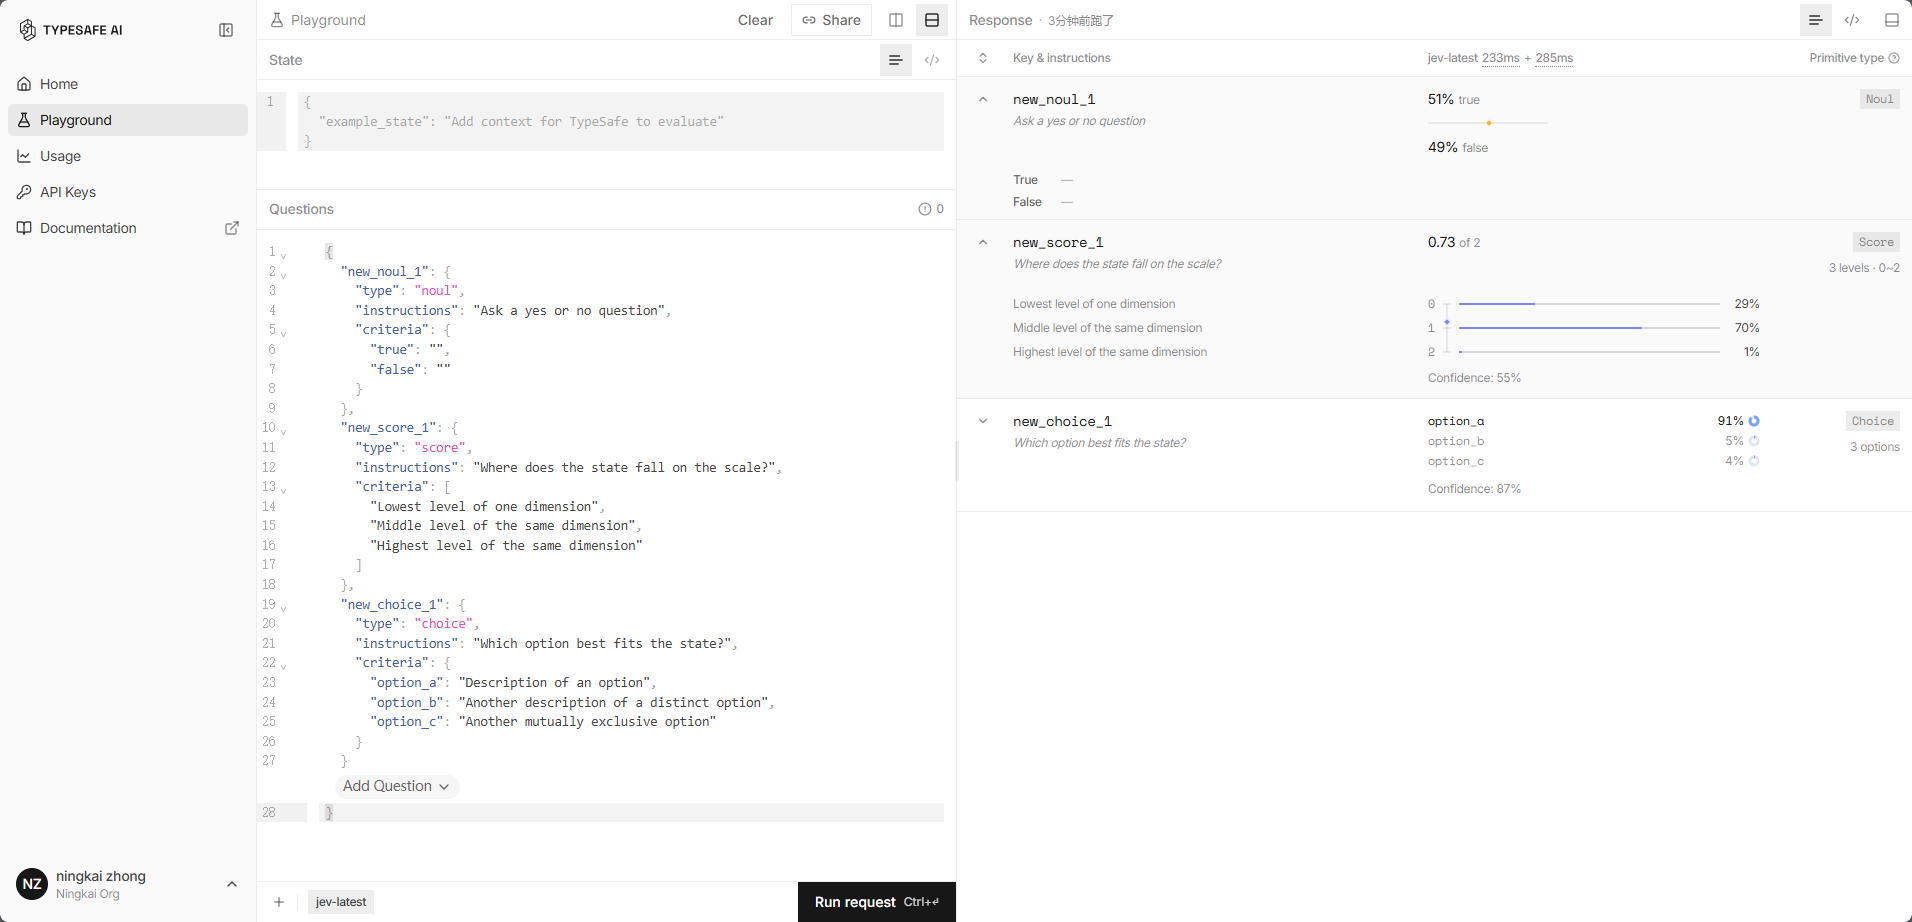
把三个能力放在一起,其实非常容易理解:
| Noul | 是不是? | 是否需要人工介入? |
| Score | 什么程度? | 客户意向有多高? |
| Choice | 属于哪一种? | 这条消息属于哪个业务类型? |
这三个能力覆盖了大量实际业务中的基础判断任务。
而官方测试 JSON 的意义,也就在于通过这种结构,把判断任务明确描述出来。
三、Jev 与 LLM、Agent 是什么关系
可以简单对比:
| 核心能力 | 理解、推理、生成 | 判断、选择、评分 | 调用工具并完成任务 |
| 输出特点 | 文本、结构化内容等 | 决策结果 | 一系列行动 |
| 典型任务 | 写文案、总结、分析 | 分类、评分、判断 | 查询数据、调用 API、执行工作流 |
| 角色 | 大脑 | 判断模块 | 执行者 |
例如一个售后自动化流程:
用户发送一条消息后,可以先由模型理解消息内容,然后由 Jev 判断:
是否属于售后问题?
如果结果为“是”,Agent 或工作流再继续调用:
- 客户信息查询
- 订单查询
- 售后记录查询
- 企业微信通知
- 数据库更新
这里就形成了比较清晰的分工:
LLM 负责理解复杂信息,Jev 负责做判断,Agent 负责执行动作。
当然,这并不是唯一的组合方式。实际项目中也可以直接让 LLM 完成分类和决策,是否引入 Jev,需要根据任务复杂度、成本、稳定性和系统设计来决定。
四、Jev 的优势与边界
Jev 最有意思的地方,并不是“又出现了一个 AI 模型”,而是它尝试把 AI 中的一个常见环节单独抽离出来:
让 AI 专门负责判断。
这样做有几个比较明显的特点。
1. 输出更加面向程序
如果让 LLM 判断一条消息是否属于售后问题,可能得到:
“根据用户描述来看,这应该属于售后问题,因为……”
但程序真正需要的可能只是:
true
Jev 的设计天然更加接近这种机器可以直接消费的结果。
2. 更适合嵌入工作流
工作流中经常存在大量条件判断:
如果 A,则执行流程 1
如果 B,则执行流程 2
如果 C,则执行流程 3
这些判断本身并不一定需要生成长篇文字。
因此,Jev 这类模型比较适合成为工作流中的一个决策节点。
3. 但它不能取代 LLM
Jev 的定位比较明确,它主要解决的是判断问题。
如果任务是:
- 写一篇文章
- 总结几十页文档
- 编写代码
- 进行复杂推理
- 生成营销文案
- 与用户进行长对话
那么仍然需要通用 LLM。
此外,Jev 的判断质量同样依赖于问题设计。
如果 instructions 描述得模糊,criteria 本身就存在重叠,那么模型即使完成了判断,也不一定能够得到理想结果。
所以:
Jev 不是让 AI 变得“什么都能做”,而是把 AI 的“判断能力”单独拿出来进行利用。
五、总结
从整体来看,Jev 可以理解为一种专注于决策的 AI 模型。
它与传统 LLM 的区别,不只是模型大小或者 API 调用方式,而是设计目标不同:
LLM 更关注“生成什么”,Jev 更关注“选择什么”。
Jev 将常见的判断任务抽象成三种核心能力:
- Noul:判断是不是
- Score:判断什么程度
- Choice:判断属于哪一种
再结合 Agent 和工作流,就可以形成比较清晰的分工:
LLM 负责理解和推理,Jev 负责判断,Agent 负责执行。
这种思路也说明了 AI 应用正在逐渐从单纯的“聊天机器人”,向模型能力模块化、工作流自动化和任务决策化发展。
对于实际开发而言,Jev 最值得关注的地方或许不是它能不能替代 LLM,而是:
当一个业务流程中存在大量“判断节点”时,是否需要一种专门负责做决定的 AI 能力。



