摘 要
随着互联网的发展,电视剧的观看方式发生了巨大的变化,观众对热播电视剧的需求日益增长。电视观众面临剧目的海量筛选,思考如何有效地推举热门剧集变成了一个研究焦点,故而基于Python热播推荐电视剧的数据分析与应用。
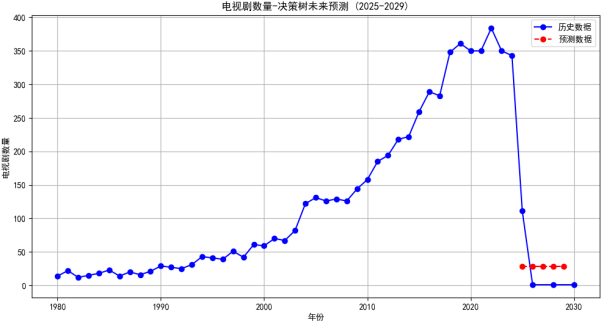
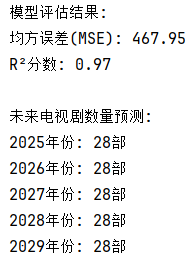
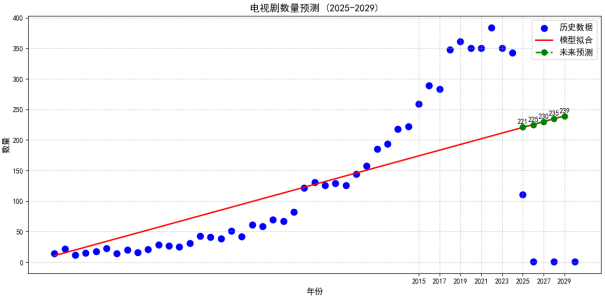
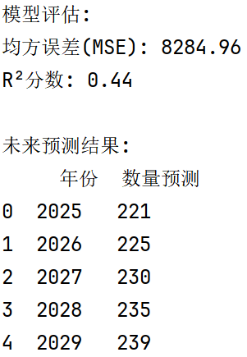
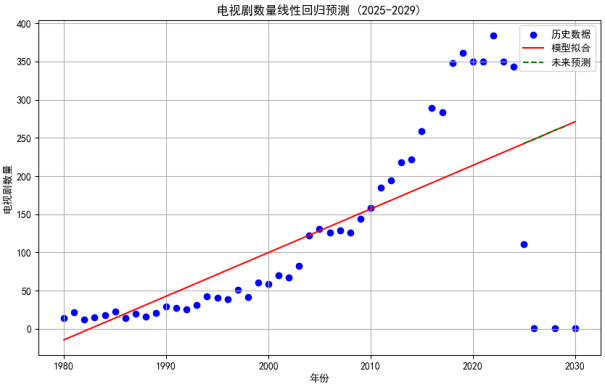
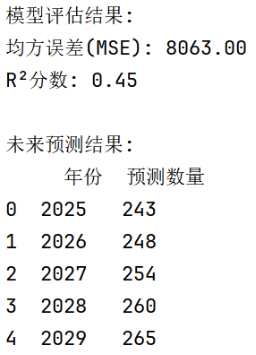
通过网络爬虫技术爬取“全集网”的热播推荐电视剧数据,包含电视剧名称、评分、导演、年份、演员、国家等多种数据。将爬取到的热播推荐电视剧数据进行清洗处理后储存到CSV中,方便后续分析。对热播推荐电视剧数据进行多角度分析,并使用Matplotlib将分析结果以多样的图表形式呈现。同时利用多种机器学习算法(如线性回归、岭回归、决策树)对热播推荐电视剧数据进行预测分析。通过对模型的评估与比较,决策树算法在数量预测的准确性上表现最佳,表明该模型的预测性能最好。
本研究基于Python热播推荐电视剧的数据分析,重点解决热播推荐电视剧预测的关键问题。通过本研究,希望能够为追剧的用户提供推荐电视剧,促进热播剧集的传播。
关键词:Python;热播推荐电视剧数据分析;预测分析
1.1背景与意义
在当今信息爆炸的时代,电视剧成为现代娱乐文化的一大标志,逐渐成为人们生活中不可或缺的一部分[1]。随着网络视频平台的迅速发展,观众的观看资源实现了多样化扩展。这种选择的多样性也带来了困扰,观众常常面临“选择困难症”,难以在众多剧集之中找到符合自己口味的作品。为了解决这个问题,进行基于python的热播电视剧数据分析。
探究热播电视剧的评分、导演、演员等要点,可以为用户提供观看建议,由此提升用户的感官体验。Python作为一种超群的编程平台,依靠其完备的库和功能模块,在数据分析界拔得头筹。利用Python进行数据处理和分析,可以从海量数据中提取出有价值的信息。热播剧数据分析的不仅有助于提升用户的满意度,为影视制作领域提供市场反响分析,指导他们在剧本设计、演员筛选环节作出更合理的决策。
依靠数据分析技术进行挖掘,影视制作可以更到位地捕捉观众的情感走向,从而推动整个行业的健康发展。在这个阶段里面,技术与文化的结合让用户的娱乐体验焕然一新,同样对社会文化的普及与消费模式的良性演变起到了作用。
1.3所做工作及思路
通过梳理国内外关于热播推荐电视剧数据分析与应用、Python领域的学术文献、技术文档及行业报告,深入掌握当前研究成果、技术发展动态及市场需求。这些数据为本项目奠定了坚实的理论基础和技术支撑,为系统架构设计、功能模块划分及数据库构建等核心环节提供了明确指导。
系统的思路是将各种来源的热播电视剧数据进行整合,进行数据清洗和特征提取。对这些热播电视剧数据就行数据分析,预测热播电视剧数据。重视数据的精确度与分析结果的分析性,以确保数据分析的实用性和可靠性。
1.4章节安排
本论文共分为五章,各章节内容安排如下:
第1章绪论:讲述本篇论文的背景与意义。提到热播推荐电视剧数据分析分析对于当前电视剧的影响,通过对比国内外的研究现状,了解到在热播电视剧研究数据在影视界的作用。最后讲述关于本论文的工作与思路可以大致解论文所做的工作。
第2章相关技术介绍:介绍相关技术的基本概念,采取Python技术路径。
第3章需求分析:从可行性上、功能需求分析和非功能需求分析上讲解模型当前需求状况。可行性分析从经济、技术、市场三个方面进行全方位讲解。功能需求分析上讲关于模型的相关数据源和数据处理等方面,非功能需求分析上主要讲解模型的性能要求和准确性要求。
第4章数据获取与处理:讲解对数据收集和预处理的方法,通过分析数据的缺失和数据的错误从而处理数据。
第5章数据预测与应用:此过程分为三步,逻辑模型介绍,介绍模型使用原因等;模型预测结论,介绍模型准确率和模型建立过程。
2.4 Sklearn
Sklearn在Python语言中作为广受欢迎的机器学习工具集,赋予众多算法及辅助工具,提高热播推荐电视剧数据处理的效率化及易操作性。采用Sklearn工具套件,可以轻易地完成数据预处理、特性筛选以及模型搭建等工序。于预测数量这一环节,采取决策树、岭回归、线性回归等模型对热播推荐电视剧、数量与日期等条件的作用进行分析。
2.4.1 决策树
决策树是一种重要的机器学习算法,其在热播推荐电视剧研究中的应用日益广泛。通过将数据集划分为不同的子集,决策树能够帮助用户追加困难现象。在热播推荐电视剧数量预测中,利用决策树分析热播推荐电视剧、数量与日期等因素,可以清晰地揭示出各个因素对产量的影响程度。
2.4.2 岭回归
岭回归被应用于解决变量间高度相关性的回归问题。热播推荐电视剧探究的范畴内,数据一般展现多维度属性,各类变量之间或许呈现出紧密的纽带关系。岭回归利用增设的一项惩罚机制来控制回归系数的规模,进而减小模型的繁重性,增进预测精准性。在热播推荐电视剧数据分析的实际运用中,岭回归技术有助于用户追剧。
2.4.3 线性回归
线性回归通过创立自变量与因变量之间的线性依赖关系,线性拟合技术助力预测特定热播电视剧数量指数的变动。有助于展现各种要素对热播推荐电视剧贡献的大小,为用户打造科学决策的参考库。探讨热播推荐电视剧产品与数量的关联性,用户能够更加精准地追加。尽管线性回归在处理直线关系上有着显著优势,然而在处理繁杂的非线性关联之际,或许会有局限性暴露。
3.2流程分析
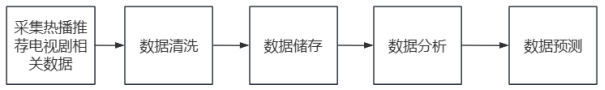
热播推荐电视剧数据分析系统采集热播推荐电视剧数据相关数据,进行相关热播推荐电视剧数据数据分析,借助图形界面直观地审视分析成果,获取透彻的数据洞见。在开发以Python为核心的热播推荐电视剧数据数据梳理框架,构建系统流程的核心地位不可小觑,大幅度增加数据处理水平与准确率。提升针对大量热播推荐电视剧数据数据的处理能力,迅速跟进用户要求,维系系统的灵活运用及高效性。流程分析图如图3-1所示。
3.3功能需求分析
3.3.1数据收集
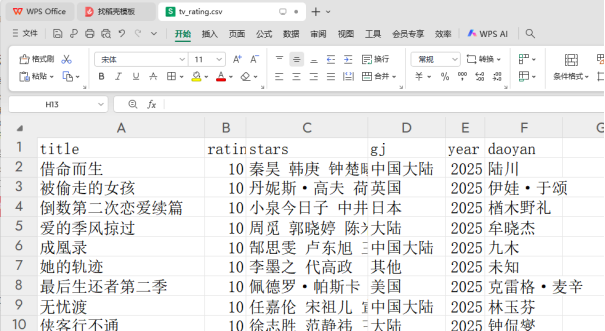
在进行热播推荐电视剧数据分析与应用前,数据采集是至关重要的步骤。高效的数据爬取技术为后续的数据整合带来全面而高质量的信息资源。为探索想要的热播推荐电视剧研究数据,选择“全集网”网站进行热播推荐电视剧数据抓取,“全集网”有大量的热播推荐电视剧数据包括热播推荐电视剧的名称、评分、导演、演员、年份、国家等。运用网络爬取技术,能够自动地检索出这些热播推荐电视剧数据数据。
通过爬虫技术,从“全集网”上提取相关数据是一个有效的途径。爬虫程序可以抓取热播推荐电视剧的名称、评分、导演、演员、年份、国家等信息,从而形成一个庞大的数据集。
第一类数据是名称:指剧集的正式标题,是区分不同作品的核心标识。
第二类数据是评分:对剧集质量的量化评价。
第三类数据是导演,剧集创作的核心负责人。数据分析中可挖掘导演与作品类型/评分的关联性。
第四类数据是演员:包含主演和配角。
第五类数据是年份:剧集首播年份。
第六类数据是国家:可分析不同国家剧集的类型偏好。
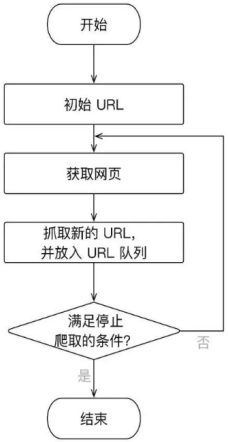
数据爬取流程如图3-2所示。
3.3.2数据整理与选择
热播推荐电视剧研究数据大多显现出复杂与多样的面貌,所以归纳阶段,必须对信息进行精准的筛选及净化。剔除重复及无用的信息是初步操作,这可以锁定分析结果的正确性。应对各式各样数据的类别,采取恰当的规范化手段,推动多样化数据在一体化界面中对照与审查。整理后细致筛选,信息将形成标准化格局,有利于今后的分析及操作,为热播推荐电视剧进步打下扎实的底层。
3.3.3数据储存
在电视剧推荐实施阶段,数据储存是核心要素。选取恰当的数据存储方案直接关系到后续的数据处理与分析效能。针对时下流行电视剧的数据采集,可以探索实施MySQL关系型数据库系统,这些数据库能迅速地处理有序资料,便于进行全面的检索。为了数据分析与预测也可以把数据储存为csv文件,方便数据分析。
3.3.4数据展示
借助Matplotlib以图像形式呈现数据,易于辨识趋势与异常数据。其多变的绘图参数配置能够个性化设定图表的风格,包括颜色、标记和线条样式,进而让最终的图表展现出科学的风范,同样映射出一定的审美光泽。Matplotlib能够与诸如Pandas这类数据分析工具实现联合应用,进一步简化数据处理流程。直接把数据框架数据送入Matplotlib处理区,迅速地绘出相关的图表,加快数据挖掘的效率。呈现各类变量间的互动关系,帮助决策者更好地理解数据背后的故事。
3.3.5数据预测
分析热播推荐电视剧研究数据,结合日期、数量等特征,可以构建相应的预测模型。使用机器学习算法,如线性回归、岭回归等,能够挖掘出潜在的趋势和周期性变化。对大批量热播推荐电视剧数据进行深入挖掘。运用Sklearn预测算法可以打造出更高精度的未来动向预测,这些预测助力用户追剧。
4.3爬取全集网网站
4.3.1爬取步骤
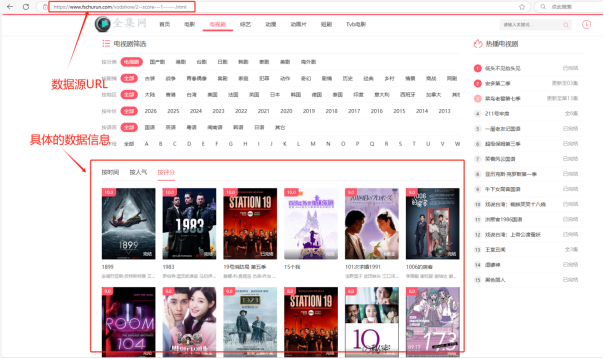
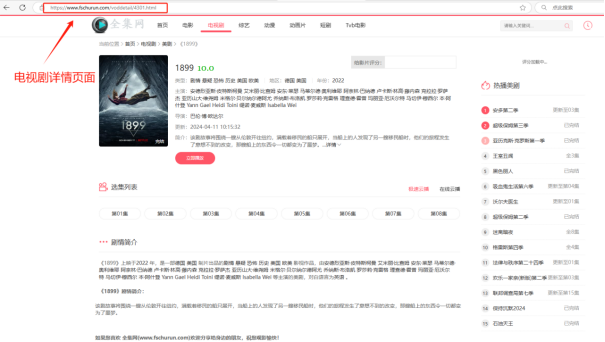
在进行热播推荐电视剧研究数据的爬取时,首先明确爬取“全集网”网站和所需数据的具体类型。利用requests库向目标网站“https://www.fschurun.com/vodshow/2–score——1—.html”和““https://www.fschurun.com/voddetail/id.html””发送HTTP请求,以获取网页的HTML内容。解析网页内容后,可以通过Beautiful Soup提取出所需的字段,如电视剧名称、评分、演员等。
通过查找特定class属性为’ewave-vodlist__detail’的div标签,获取包含对局数据的p。遍历p列表,对每个p标签进行处理,提取热播推荐电视剧研究相关的数据。最后将数据循环遍历存放到csv文件中。爬取“全集网”网站的数据源如图4-2、图4-3所示。
4.3.3爬取结果
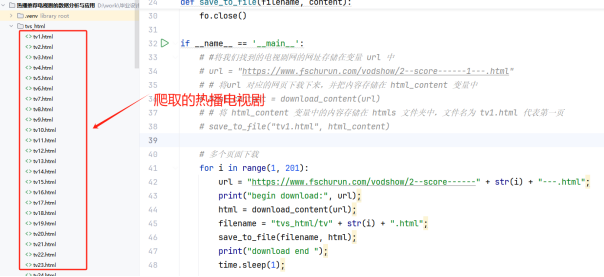
数据源来自国内的“全集网”网站。借助BeautifulSoup工具解析HTML文档,提取出所需的数据字段,爬取结果如图所示4-4。
数据分析与可视化