前三篇把订单链路跑通了:数据从 Kafka 进湖、按窗口聚合、关联维表出宽表。但这些都有一个前提——任务一直活着。生产上这个前提不成立:机器会宕机,大促前要扩容,改个 SQL 也得重启。窗口里算到一半的累加值、Temporal Join 存的商品历史版本,任务一停就全没了。凌晨三点挂了没人管,早上 GMV 报表就少一截。这一篇解决"活着"的问题:State 怎么存、Checkpoint 怎么拍、挂了怎么恢复、参数怎么定。
本文要点
- State 是什么:窗口算到一半的结果存哪了
- RocksDB:生产级的 State 存储,容量按磁盘算
- Checkpoint:不停机给全任务拍一致性快照
- 恢复全流程:凌晨 3 点任务挂了,接下来的几分钟发生了什么
- 生产参数:Checkpoint 间隔、State TTL、迟到数据怎么办(填第二篇的坑)
零 State 是什么:算到一半的结果存哪了
1 这些操作都在悄悄记东西
前三篇的 SQL 看起来都是"来一条、处理一条",其实背后好几个地方在记东西:
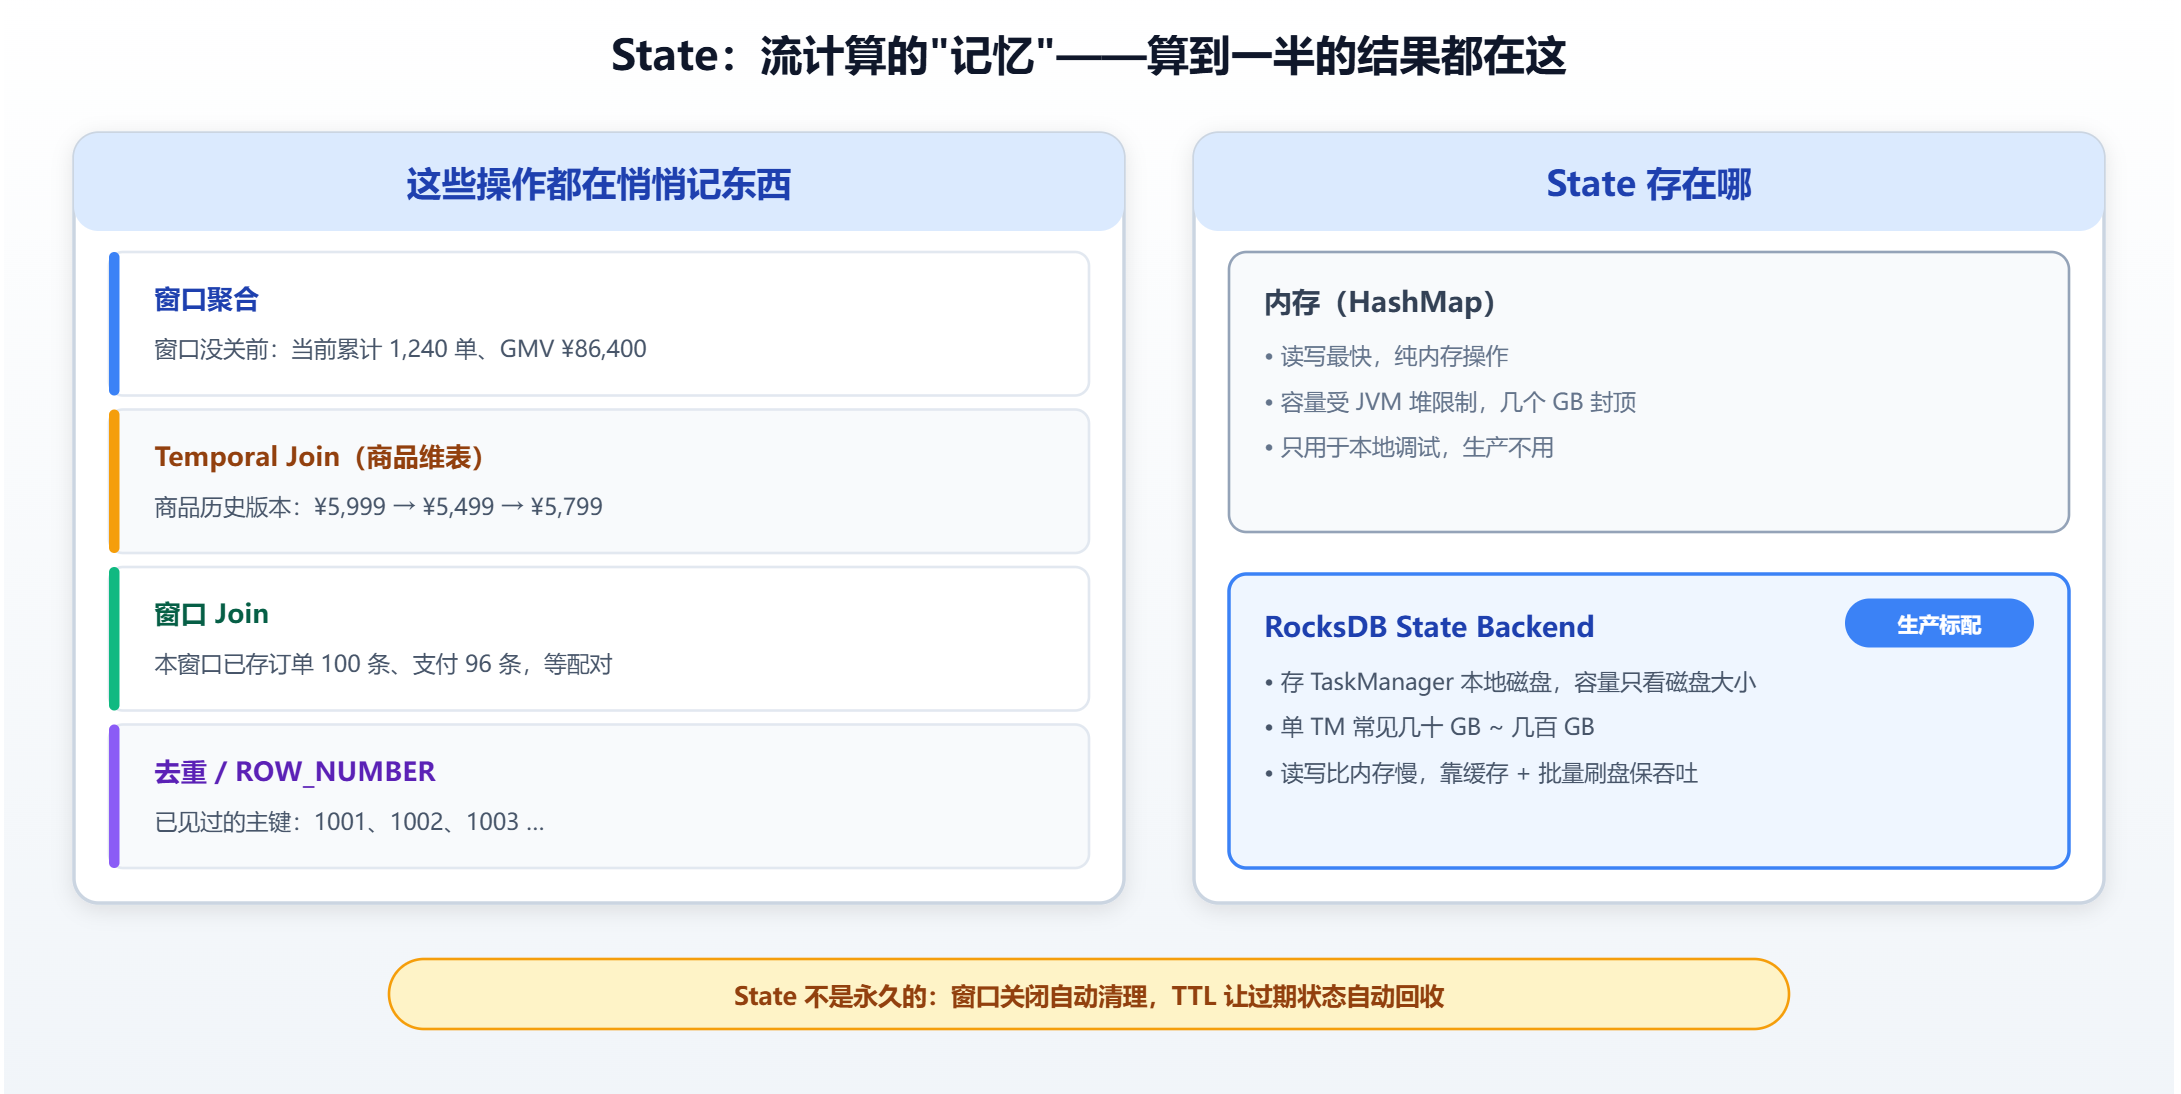
- 窗口聚合:1 分钟窗口没关之前,"当前累计 1240 单、GMV ¥86,400"这个中间值得存着,来一条加一次。这个累加器就是状态
- Temporal Join:商品维表的 changelog 流进 Flink 后,5999 → 5499 → 5799 的历史版本会物化到算子 State 里——维表是版本的来源,State 才是关联时翻版本的地方。按事件时间取"当时的版本"是在 Flink 本地 State 里查的,不是逐条回查维表
- 窗口 Join:窗口关闭前,订单流的 100 条、支付流的 96 条都缓存在状态里,等着配对
- 去重 / ROW_NUMBER:见过的主键要记下来,下一条来了才知道是不是重复
没有 State,Flink 就不知道"这个窗口已经累计了多少",窗口聚合无从谈起。State 就是流计算的记忆。
2 State 存哪:生产用 RocksDB
State Backend 有两种选择。内存(HashMap)读写最快,但容量受 JVM 堆限制,几个 GB 封顶,只够本地调试用。生产标配是 RocksDB State Backend:
- State 存 TaskManager 所在机器的本地磁盘,容量只看磁盘大小
- 单个 TaskManager 的 State 常见几十 GB 到几百 GB
- 读写比内存慢,靠块缓存和批量刷盘保住吞吐
State 也不是只涨不消:窗口关闭后对应的状态自动清理;Join、去重这类没有天然清理时机的,靠 TTL 回收——第三节细说。
一 Checkpoint:不停机给任务拍快照
1 原理
State 在 TaskManager 本地磁盘上,机器一挂就没了。Checkpoint 做的事:定期把整个任务所有算子的 State,拍成一份快照存到远程存储(HDFS/S3)。
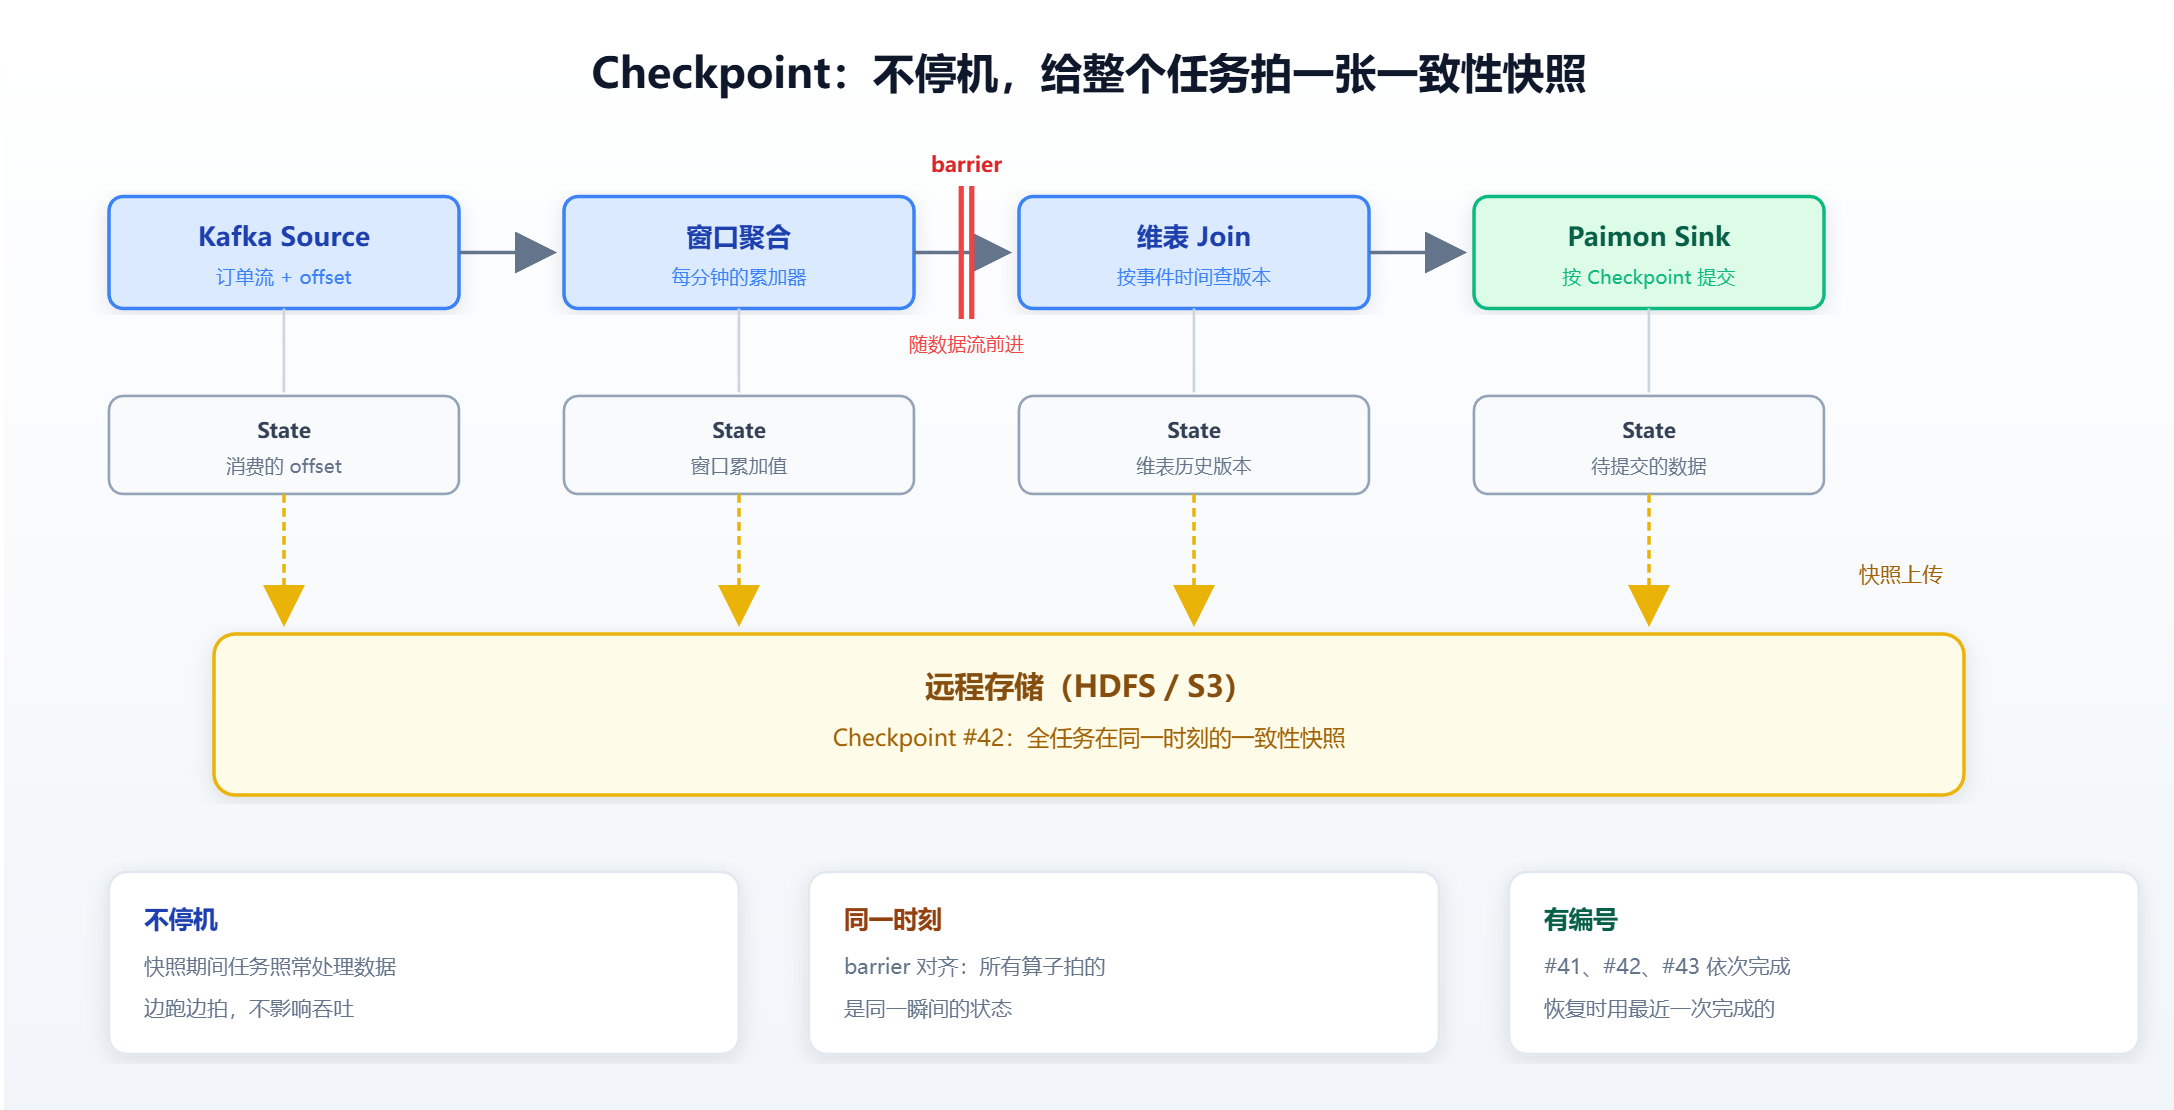
过程一句话:JobManager 往数据流里插一个 barrier(栅栏),barrier 跟着数据流往前走,每个算子收到 barrier 就把自己的 State 拍快照上传。所有算子都拍完、都确认,这次 Checkpoint 才算完成。
不用纠结 barrier 对齐的细节,记住三点:
- 不停机:快照期间任务照常处理数据,边跑边拍
- 同一时刻:所有算子拍的是同一瞬间的状态,拼起来是一份一致性快照
- 有编号:#41、#42、#43 依次完成,恢复时用最近一次完成的
2 回收第一篇的伏笔:Paimon 为什么按 Checkpoint 可见
第一篇说过:Flink 写 Paimon 的数据,Spark 要等一个 Checkpoint 间隔才能查到。现在可以把原因讲透了——Paimon Sink 也参与 Checkpoint:
- 两次 Checkpoint 之间写入的数据,先在 Sink 算子里攒着(这就是 Sink 的 State)
- Checkpoint 完成时,这批数据才正式提交成 Paimon 的新快照,下游 Spark 才看得到
这样保证了一个关键性质:一个 Checkpoint 周期的数据,要么全提交、要么全不提交。任务挂了恢复后重放,已提交的不会重复,没提交的重新提交——端到端的不丢不重,就是这么拼出来的。
从可见性角度看,这其实也是一种"攒批":数据一直在流进来,Sink 也一直在往外部存储写文件,但不提交成快照,下游就看不见——直到 Checkpoint 完成,这一周期的数据统一"放闸"。串起整条链路就是两个闸门:窗口决定结果什么时候算出来(第二篇的攒批写出),Checkpoint 决定算出来的结果什么时候对外可见。但有个边界要划清:攒批只发生在 Sink 提交这一层,算子内部的处理(累加、关联)始终是逐条连续的——这和 Spark Streaming 的微批模型不同,微批是整个计算按批次调度执行,Flink 是计算连续、只是可见性离散。Checkpoint 攒批的目的也不是吞吐,而是原子提交。
二 凌晨三点任务挂了:恢复全流程
理论说完,走一遍真实场景。订单任务 Checkpoint 间隔 1 分钟,凌晨出事:
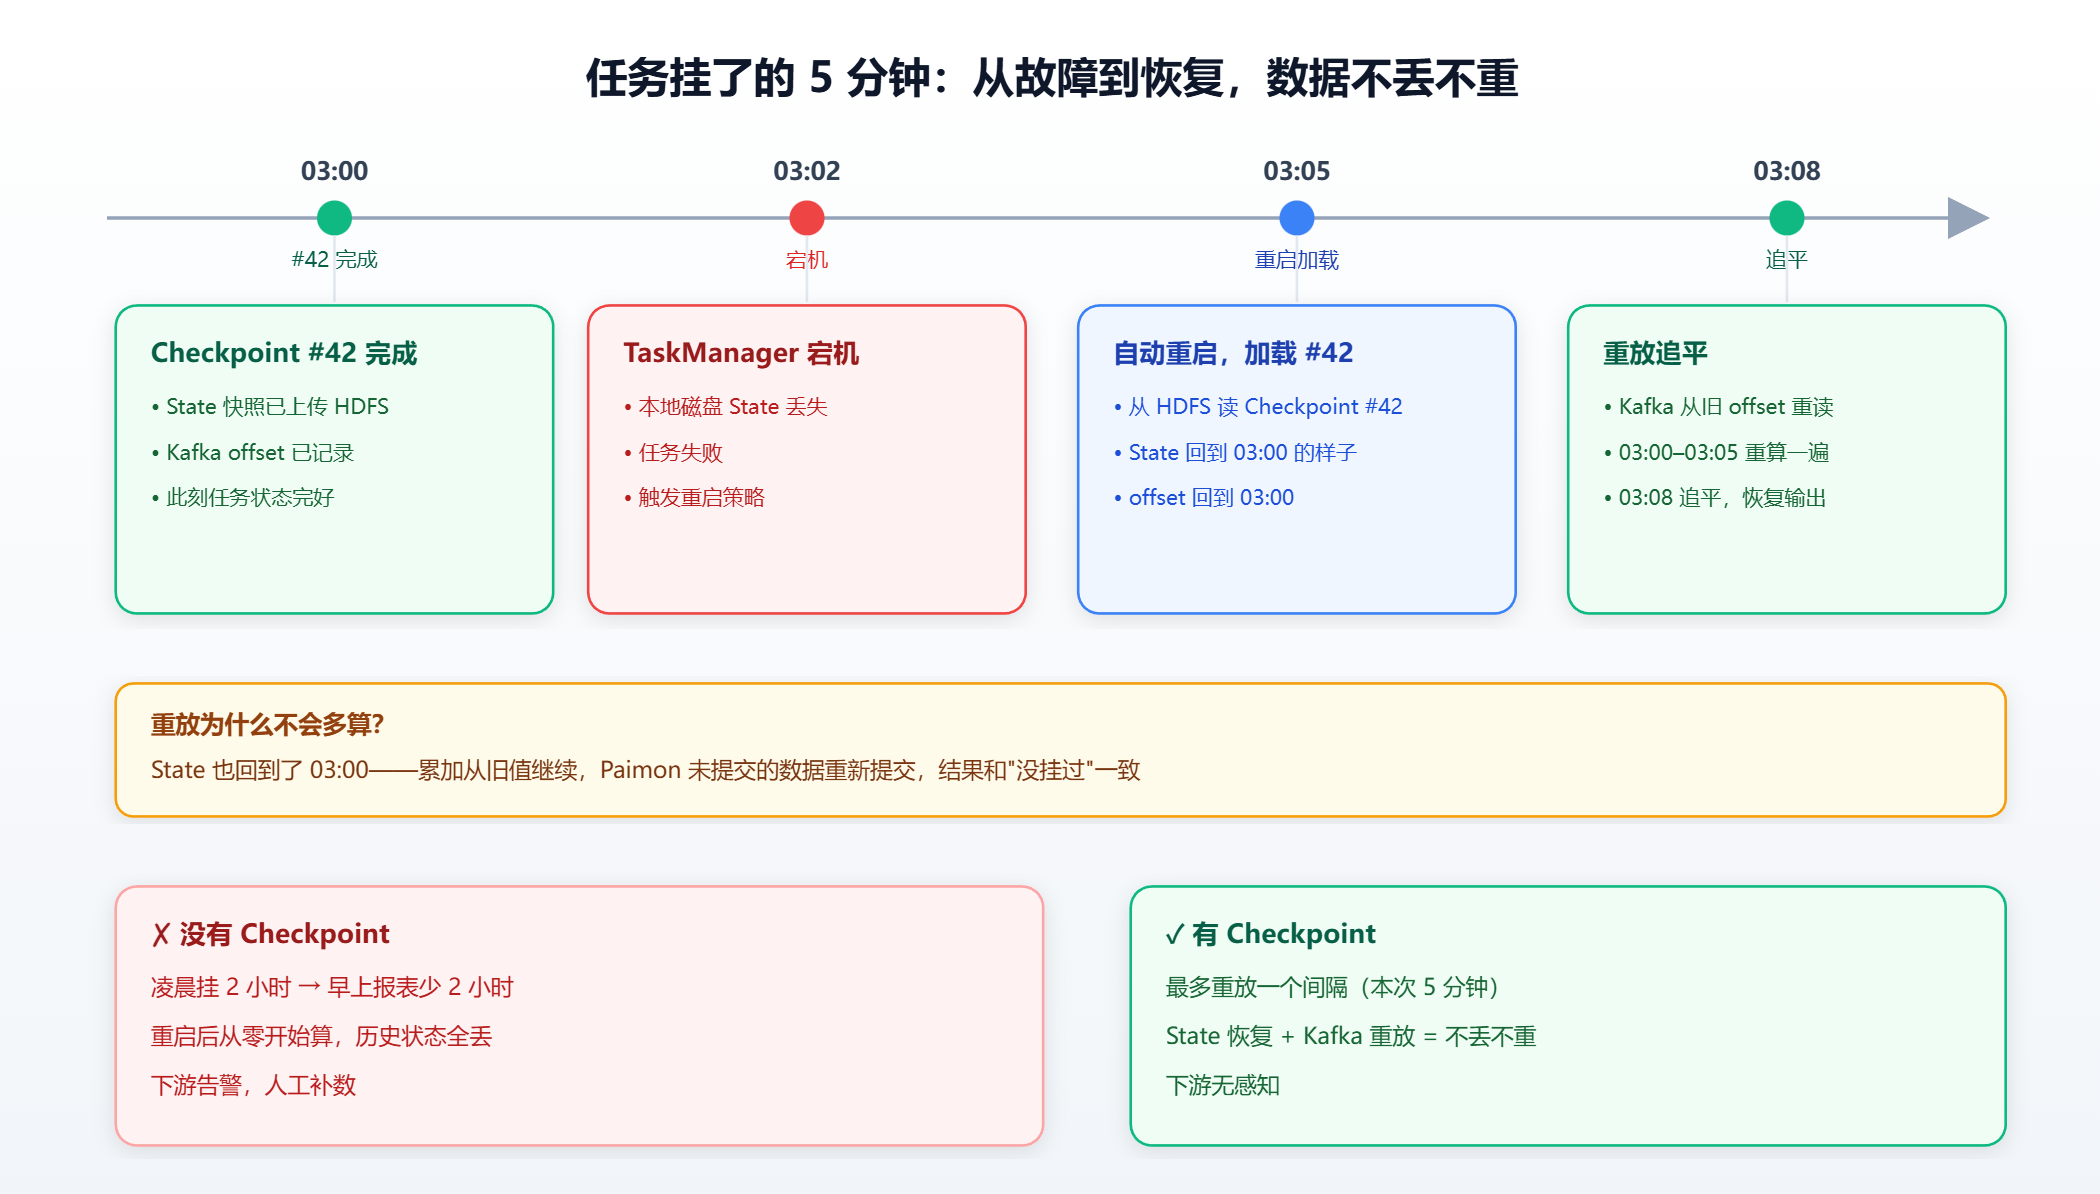
重放为什么不会多算?因为 State 也回到了 03:00——窗口累加器从旧值继续加,Paimon 未提交的数据重新提交,结果和"没挂过"一模一样。故障从"丢了几个小时"变成了"重来几分钟",下游无感知。
那 03:00–03:02 已经写出去的文件呢,会不会多写一遍? 会——物理上这段时间的数据确实写了两遍:失败前 Sink 已经把文件落盘了,重放后又写了一遍新文件。但 Paimon 的可见性单位是快照,不是文件:失败前写的文件没等到 #43 提交任务就挂了,成了"孤儿文件"——不属于任何快照,Spark 永远读不到,只是白占存储,定期跑 remove_orphan_files 清理掉即可。重放后写的文件随 #43 正常提交,可见数据恰好一份。exactly-once 的代价就是这份"多写":用存储空间换可见性层面的不重。
外部存储是 append 流水表时这个机制最关键:append 表没有主键,去重完全依赖提交协议——正常故障恢复不会重复(孤儿文件不可见),但人为从旧 Savepoint 恢复时要小心:那之后已提交的快照还在表里,重新提交就是真重复,需要先把 Paimon 表 rollback 到对应快照(或平时打 tag)再启动任务,让表状态也"回到 03:00"。主键表就没这个烦恼:就算重复提交,同 key 同值写进去也是 upsert,天然幂等。
1 重启策略:别无限重启
任务能自动拉起,靠的是重启策略,生产常用 failure-rate:
# flink-conf.yaml
restart-strategy: failure–rate
restart-strategy.failure-rate.max-failures-per-interval: 3
restart-strategy.failure-rate.failure-rate-interval: 10 min
restart-strategy.failure-rate.delay: 30 s
意思是:10 分钟内失败不超过 3 次,每次隔 30 秒自动重启;超过 3 次说明任务有硬伤(SQL 写错、依赖服务挂了之类),放弃重启等人工介入。免得任务带着硬伤无限重启,告警刷爆。
2 Savepoint:计划内停机的手动快照
Checkpoint 管"意外挂",Savepoint 管"计划内停":
- 改 SQL 重启:先手动做一次 Savepoint,停掉旧任务,新任务从 Savepoint 启动——State 无缝交接,窗口接着算
- 大促扩容:并行度从 4 调到 16,从 Savepoint 恢复,State 自动拆分到 16 个并发上
# 停任务并做 Savepoint
flink stop –savepointPath hdfs://namenode:8020/flink/savepoints <jobId>
# 从 Savepoint 启动新任务
flink run -s hdfs://namenode:8020/flink/savepoints/savepoint-xxx job.jar
一句话:Checkpoint 是自动的、管意外;Savepoint 是手动的、管计划内变更。
三 生产参数怎么定
1 Checkpoint 间隔:最核心的权衡
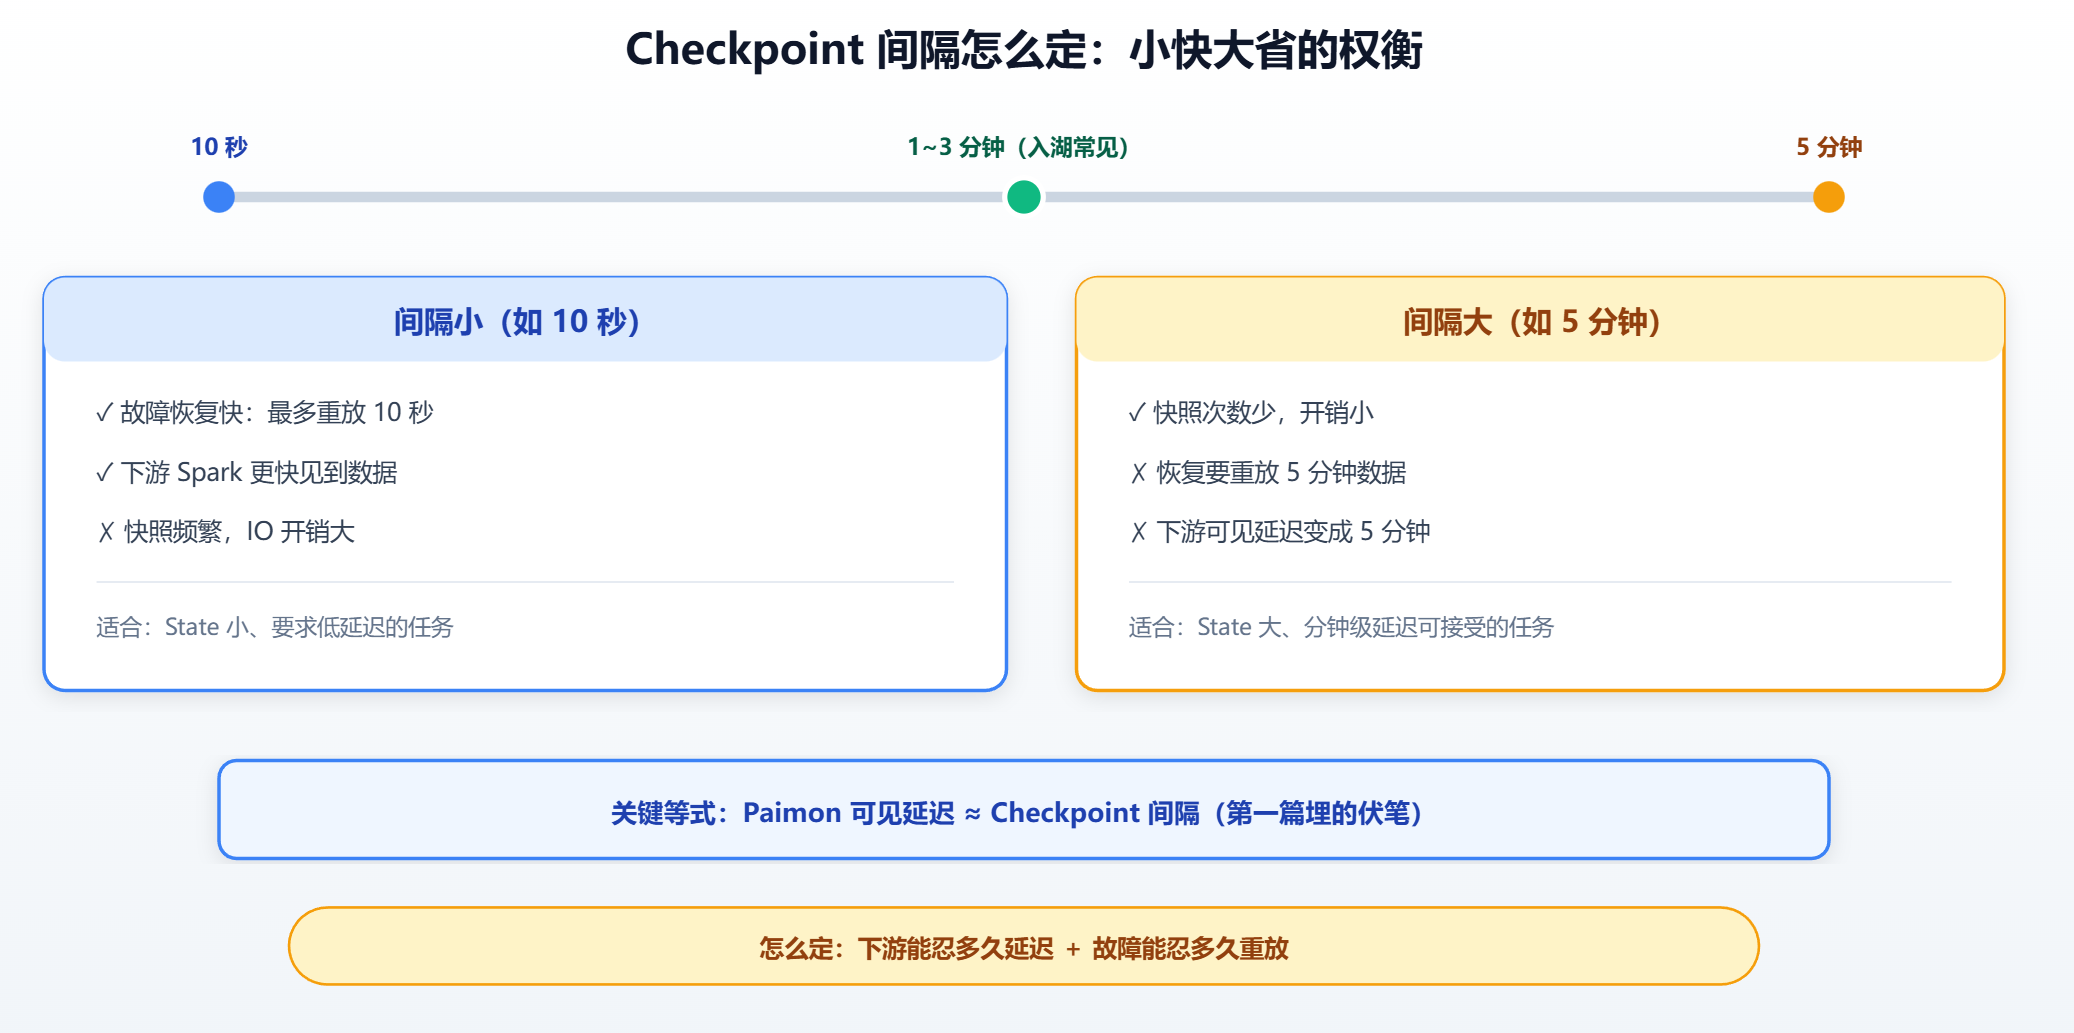
间隔两头是权衡:
- 间隔小(如 10 秒):恢复快(最多重放 10 秒)、下游 Spark 见数据快;但快照频繁,IO 开销大
- 间隔大(如 5 分钟):开销小;但恢复要重放 5 分钟数据,下游可见延迟也变成 5 分钟
中间卡着一个等式:Paimon 可见延迟 ≈ Checkpoint 间隔(第一篇埋的伏笔)。所以间隔怎么定,就看两个问题:下游能忍多久延迟?故障时能忍多久重放?订单入湖、宽表这类 State 几十 GB 的任务,1~3 分钟是常见取值。
— SQL Client 里对当前会话生效
SET 'state.backend' = 'rocksdb';
SET 'execution.checkpointing.interval' = '1min';
SET 'execution.checkpointing.timeout' = '10min';
SET 'execution.checkpointing.min-pause' = '30s';
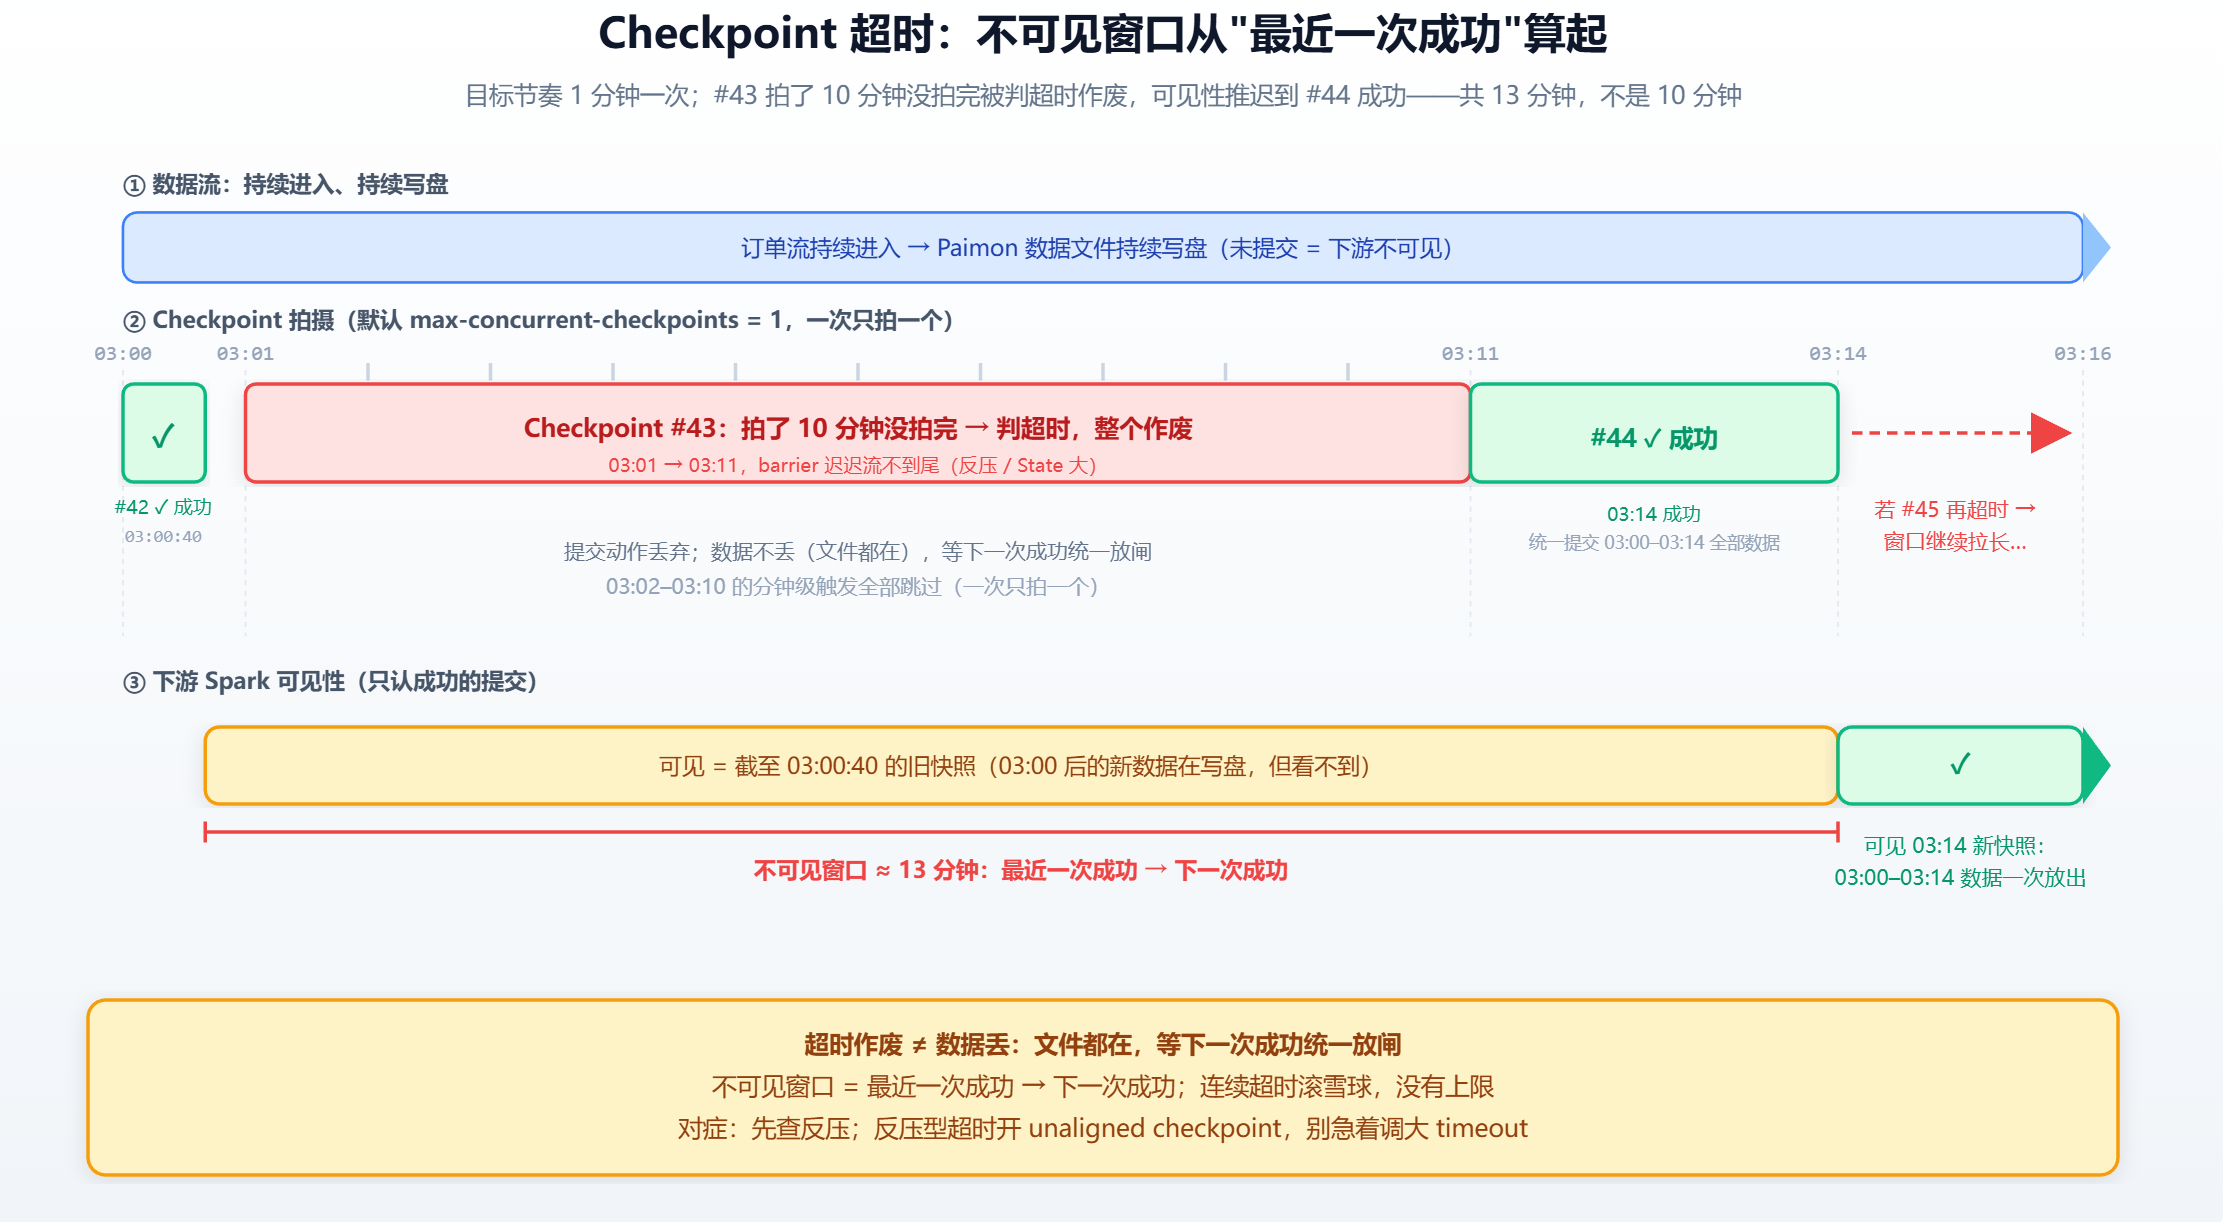
- timeout:一次 Checkpoint 超过 10 分钟没拍完就判失败。State 大、任务反压时 barrier 流得慢,容易超时——遇到这种情况先查反压,别急着把超时调更大
- min-pause:两次 Checkpoint 之间至少隔 30 秒,防止快照一个接一个把任务压垮
超时对可见性的影响要说清:超时的 Checkpoint 整个作废——数据不丢(文件都在),但要等下一次成功的 Checkpoint 才统一提交。所以下游的不可见窗口不是"最多 10 分钟",而是从最近一次成功到下一次成功:连续超时时不可见时间会一直拉长,下游延迟越滚越大。这正是"先查反压"的原因——连续超时几乎都有真因(反压、State 过大、上传慢),调大超时只是把判死线后移。另外注意默认一次只拍一个快照(max-concurrent-checkpoints = 1):拍得慢会直接拖长实际提交节奏,1 分钟的目标间隔退化成实际拍摄时长。
反压导致 barrier 对齐慢的场景,还有一味更对症的药:unaligned checkpoint(execution.checkpointing.unaligned.enabled = true)——barrier 不用排队等对齐,直接对在途数据打快照,反压再大 Checkpoint 也拖不慢,代价是快照体积略大。
2 State TTL:给状态设个保质期
双流 Join、去重这类状态默认永久保存——主键一直涨,State 早晚把磁盘顶爆。给个保质期:
SET 'table.exec.state.ttl' = '1h';
一条状态 1 小时没被访问就自动清理。窗口 Join 场景里,1 小时还没配对上的订单和支付,基本也配不上对了,清掉腾地方。
TTL 是 trade-off:太短,数据还在、状态先过期,配对率下降;太长,磁盘吃不消。按业务上"最大能接受的配对时间"来定。
3 迟到的数据:填第二篇的坑
第二篇留了个坑:窗口关了之后迟到的数据怎么办。当时提到 Allowed Lateness 能让窗口"关了又开"——这里要讲实话:那是 DataStream API 的能力,Flink SQL 的窗口语法(TVF)没有对应的开关。SQL 里窗口被 Watermark 触发后状态就清掉了,之后到的迟到数据进不了这个窗口,默认丢弃。
生产上 SQL 的迟到治理是三层组合:
对大盘看板这种场景,偶尔丢几条迟到数据对整体没影响,第一层就够;对账单级金额,上第三层。
四 完整任务:给订单宽表加上生产配置
第三篇的订单宽表任务,加上这一篇的生产配置,才算真正能上线:
— ===== 启动时先配状态与快照 =====
SET 'state.backend' = 'rocksdb';
SET 'execution.checkpointing.interval' = '1min';
SET 'execution.checkpointing.timeout' = '10min';
SET 'execution.checkpointing.min-pause' = '30s';
SET 'table.exec.state.ttl' = '1h';
— ===== Source / 维表 / Sink DDL:同第三篇 =====
— orders_source(订单流)
— city_dim、product_dim(Paimon 维表)
— dwd_order_wide(Paimon 主键表,提前用 Spark SQL 建好)
— ===== 写入逻辑:同第三篇 =====
INSERT INTO dwd_order_wide
SELECT
o.order_id,
o.city_id,
c.city_name,
c.province,
o.product_id,
p.product_name,
p.price,
o.amount,
o.order_time
FROM orders_source AS o
LEFT JOIN city_dim FOR SYSTEM_TIME AS OF o.proc_time AS c
ON o.city_id = c.city_id
LEFT JOIN product_dim FOR SYSTEM_TIME AS OF o.order_time AS p
ON o.product_id = p.product_id;
每个配置管什么:
| state.backend | rocksdb | State 存本地磁盘,容量按磁盘算 |
| execution.checkpointing.interval | 1min | 每 1 分钟拍一次快照;Paimon 可见延迟也是 1 分钟 |
| execution.checkpointing.timeout | 10min | 快照 10 分钟拍不完判失败 |
| execution.checkpointing.min-pause | 30s | 两次快照至少隔 30 秒 |
| execution.checkpointing.unaligned.enabled | true(按需) | 反压大时 barrier 不对齐直接拍,反压型超时专用 |
| table.exec.state.ttl | 1h | Join 状态 1 小时不访问自动清理 |
验证:真挂一次试试
配置对不对,挂一次才知道:
五 小结
到这篇为止,订单链路从"能跑"到"跑得稳"就齐了:数据进得来(入湖)、算得对(窗口 + Watermark)、看得懂(Join 维表)、挂得起(State + Checkpoint),四篇形成一个闭环,本系列到此结束。