10月7日,旧金山。微软Windows AI和Surface活动上,黄仁勋与纳德拉罕见同台。两人一起宣布了一件酝酿半年的产业事件:搭载英伟达RTX Spark超级芯片的笔记本即日起开放预购,10月16日开售;紧凑型桌面主机11月上市。
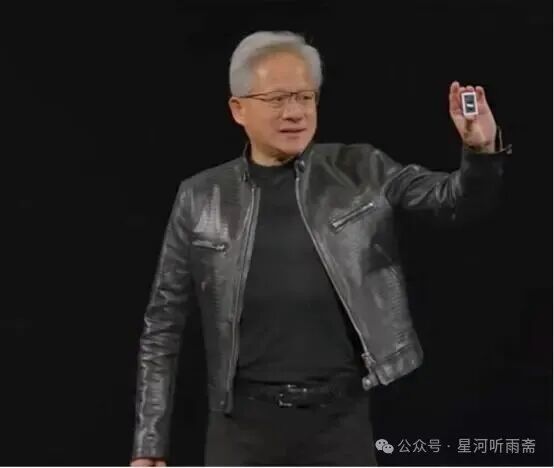
图1:黄仁勋在发布会现场手持RTX Spark超级芯片
过去几年,英伟达的AI版图集中在数据中心,RTX Spark是它第一次把完整的AI算力栈搬进大众Windows设备。用黄仁勋的话说,这是"把33年积累浓缩进一颗芯片"。Agent PC这个品类,从概念正式走向货架。
一、这次发布的不仅仅是一款芯片,还是一个新品类
先看这次发布的全貌。微软宣布Microsoft eXecution Containers(MXC)正式全面可用,这是OS级别的Agent隔离容器,让AI智能体可以在操作系统管控下后台常驻运行。英伟达同步开放RTX Spark笔记本预购,并首次展示面向Windows的DGX Station。两家公司对外公布的OEM阵容覆盖宏基、华硕、戴尔、惠普、联想、微软、微星、技嘉八家,规划的机型超过30款笔记本和10款台式机。
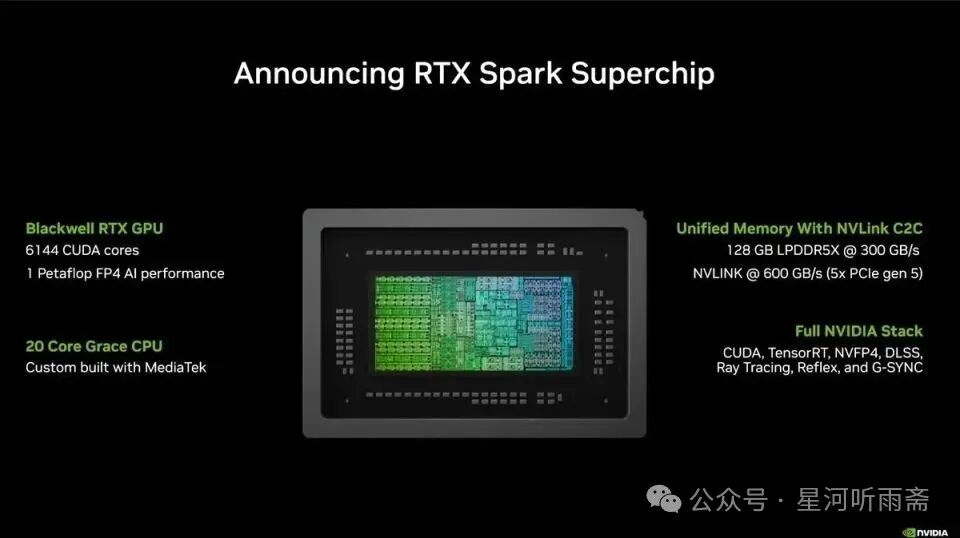
图2:NVIDIA官方RTX Spark Superchip规格宣传图(Blackwell RTX GPU、6144 CUDA核心、1 Petaflop FP4、20核Grace CPU、NVLink-C2C统一内存)
纳德拉在台上说:"我们需要让桌面成为Agent执行最安全的地方。"黄仁勋给出了更直接的表述:"正如Windows和DirectX改变了应用的构建方式,MXC将改变Agent的构建和部署方式。"
两句话放在一起看,事情就清楚了。微软要的是一套让Agent安全落地Windows的操作系统级基础设施,英伟达要的是把算力端到端铺到每一台PC上。两者在这一刻合流,定义的不是某一款产品,而是一个新的计算品类。
二、RTX Spark技术架构拆解:一颗芯片的三合一
RTX Spark超级芯片的核心,是把三种原本分离的组件封进一颗芯片:Blackwell架构RTX GPU、Grace架构CPU、统一内存。
GPU侧,这颗Blackwell RTX GPU拥有6144个CUDA核心,搭载支持FP4精度的第五代Tensor Core,AI算力达到1 Petaflop。CPU侧,是英伟达与联发科联合设计的20核Grace CPU,基于Arm架构,包含10个Cortex-X925大核和10个Cortex-A725小核。内存侧,最高128GB LPDDR5X统一内存,CPU和GPU共享同一片内存池,带宽跑在3000Gbps级别。
连接三者的关键,是NVLink-C2C芯片间互连,带宽600GB/s。这是英伟达把数据中心级互连技术下放到消费级芯片的标志性动作。GPU、CPU、内存不再是主板上各自为政的部件,而是通过高速互连构成一个一致性的计算整体。
这套架构的工程逻辑,和苹果的Apple Silicon同源,都走"统一内存+自研互连"的路线。但英伟达手里多两张牌:一张是CUDA软件栈,另一张是第五代Tensor Core的FP4低精度算力。这两张牌决定了RTX Spark不只服务轻薄本,还能支撑本地大模型推理和创作负载。
此外,英伟达还规划了低配版本RTX Spark N1X,GPU核心降至5120个,CPU降至18核,用于覆盖不同价位段的轻薄设备。
三、Windows智能体基础设施:MXC、OpenShell与Agent安全
RTX Spark只是硬件,真正决定Agent PC能否成立的,是软件层,也就是微软的MXC。
MXC解决的问题很具体:Agent要执行代码、操作文件、调用应用,就必然面临提示注入攻击的风险。如果Agent没有隔离,一个恶意指令就可能让Agent读取用户的全部个人文件。MXC正是为此设计,它在操作系统层定义了一套策略容器,把Agent关在"沙箱"里,Agent只能访问被授权的资源,无法触达整个系统。
英伟达在此基础上做了OpenShell运行时,集成MXC,提供策略创建与管理、推理路由、个人身份信息混淆等能力。OpenClaw、Hermes Agent等主流开源Agent已经接入这套安全机制。
黄仁勋把MXC比作DirectX,不是夸张。DirectX当年统一了Windows图形接口,催生了整个PC游戏生态。如果MXC同样成为Agent的标准执行环境,那么Agent应用的开发方式会被重新定义,所有Agent开发者都要在MXC框架下工作。
这一层基础设施,才是英伟达和微软真正的护城河。芯片可以被追赶,但"操作系统级Agent安全框架+全栈CUDA生态"的组合,短时间内没有第二家能复制。
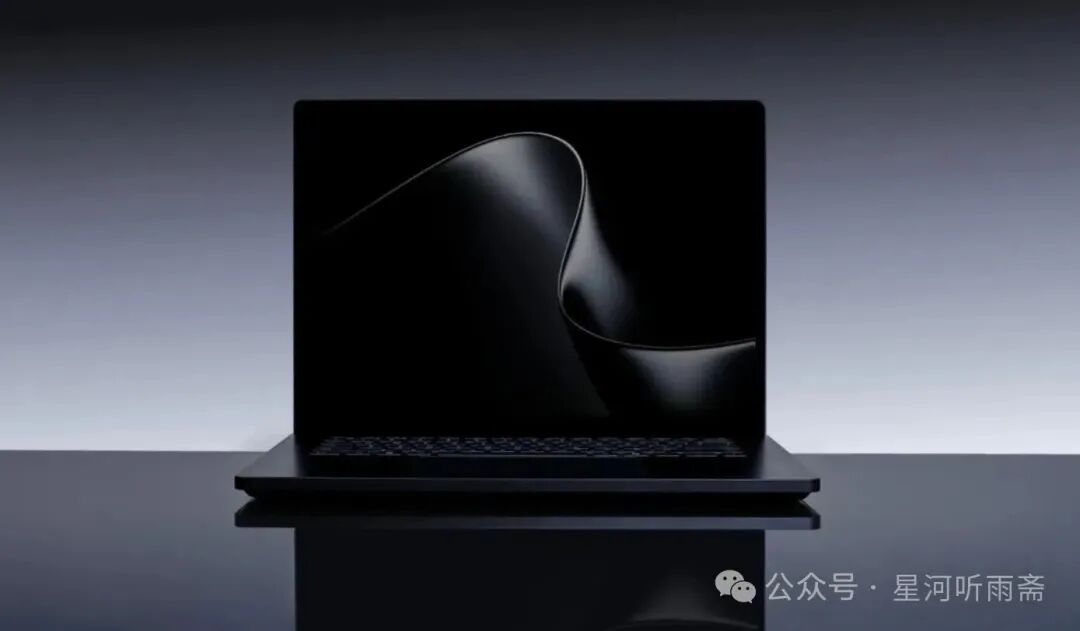
图3:Surface Laptop Ultra官方产品图
四、本地AI技术栈:算力、推理与Agent的协同优化
硬件落地之后,英伟达对本地推理栈做了一轮密集优化。
推理后端层面,llama.cpp对Qwen 3.5和3.6的27B稠密模型实现2倍性能提升,35B MoE模型提升1.6倍。技术手段是两项:多Token预测(MTP),用小型草稿模型一次预测多个Token再由目标模型单次前向验证,输出质量不变但吞吐明显提高;程序化依赖启动(PDL),让同一条CUDA流上的依赖内核可以并发执行。vLLM则通过BF16核选择优化和CUDA Graphs开销削减,推理性能提升2.6倍。
多GPU支持同步扩展。llama.cpp引入张量并行,双GPU可实现约2倍内存容量和约1.8倍算力利用;ComfyUI通过Classifier-Free Guidance实现双GPU约2倍计算性能。这意味着用户可以用两张RTX显卡跑出接近单卡两倍的本地推理能力。
Agent编排层面,NemoClaw现在支持GeForce RTX、RTX PRO、DGX Spark、DGX Station全系客户端,提供一键式Agent沙箱部署。英伟达还推出PAIR技术,自动发现本地网络中的兼容PC,把空闲算力池化,智能体推理请求可以路由到网络中可用算力的设备上。
整套软件栈的最终效果是:一台RTX Spark设备可以本地运行Qwen 3.8 Flash Next这类125B参数模型,且推理不产生云端调用。对数据敏感的场景,这是质的改变。
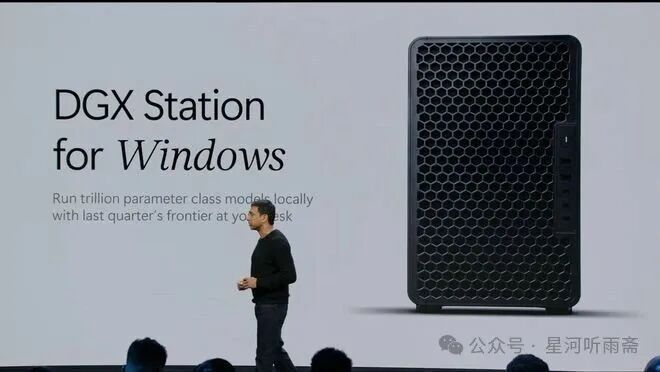
图4:DGX Station for Windows发布会现场图
五、产品矩阵与定位分层:三级算力梯队
这次发布将英伟达的桌面AI产品线补齐,形成完整的三级结构。
第一级,RTX Spark笔记本和紧凑桌面,1 Petaflop算力、128GB内存,面向个人智能体、创作者和开发者,定位"随身AI工作站"。
第二级,DGX Spark,GB10 Grace Blackwell超级芯片,同样1 PFLOP FP4算力,支持200B参数模型,面向个人AI超级计算机场景,主打本地微调和中小模型推理。
第三级,本次发布首次预览的DGX Station for Windows,搭载GB300 Grace Blackwell Ultra桌面超级芯片,748GB一致性内存,20 Petaflops FP4算力,可以本地运行万亿参数级模型。这台设备的定位是"桌面级AI工厂",面向AI原生企业、研究机构和多Agent工作负载团队,目标是把过去需要租赁集群才能完成的工作搬到办公桌上。
三级之间共享同一套CUDA技术栈,模型、工具、工作流从低到高无缝迁移。这种"一套软件栈贯穿全产品线"的设计,是英伟达在客户端市场复制数据中心成功路径的核心策略。
六、产业链拆解:从芯片设计到生态分发
沿产业链看,RTX Spark的商业化牵动的不只是英伟达一家。
上游,芯片设计由英伟达与联发科联合完成。联发科是Arm SoC设计领域市场份额领先的厂商,负责Grace CPU的定制实现;英伟达提供GPU、互连和AI加速部分。制造环节延续台积电先进工艺。这种"GPU巨头+移动SoC龙头"的组合,是消费级AI芯片设计分工的新范式。
中游,八家OEM同步铺货。微软自己的Surface Laptop Ultra首发RTX Spark,联想推出Yoga Pro 9n、Yoga 9n二合一和YOGA Pro 15 RTX Spark,华硕ProArt创16创作本10月8日登场。30余款笔记本、10款台式机的规划,意味着这已经是一轮全行业的产品换代,而非单家旗舰试水。
软件生态,微软提供MXC、Windows Agent框架和Agent 365;开源社区贡献llama.cpp、vLLM、LM Studio的优化;Agent应用层聚集了OpenClaw、Hermes Agent、H Company的Holo 3.1系列。游戏侧,EA、育碧、KRAFTON、网易、拳头、XBOX都已宣布支持,RTX Spark兼顾AI与游戏双场景。
值得注意的是:英伟达第一次以"算力平台方"而非"显卡供应商"的角色,深度介入Windows设备的产品定义。从芯片、互连、内存到操作系统级安全框架,再到OEM产品形态,全链条被重新组织了一遍。
七、竞争格局:三条战线的交错
第一条,对苹果Apple Silicon的正面冲击。Mac系列凭借统一内存和自研芯片,在AI笔记本市场占据先发位置。RTX Spark用同样的架构逻辑,叠加CUDA生态和Windows办公生态,第一次给Windows阵营提供了对等甚至更强的本地AI算力。爱范儿用"跟Mac宣战"来概括,并不夸张。
第二条,对传统AI PC的降维打击。过去两年AI PC的主流路线是NPU补位,高通骁龙X、英特尔、AMD都在笔记本里集成数十TOPS的NPU,用于轻量AI任务。RTX Spark的1 Petaflop算力比NPU路线高出两个数量级,两者已不在同一竞争维度。RTX Spark定义的Agent PC,是"GPU级主算力"路线,NPU路线退居辅助。
第三条,与云计算的互补而非替代。本地推理的价值在隐私、延迟和边际成本。模型不出设备,数据不传云端,推理不产生API费用。对Agent这种需要高频、持续、后台运行的工作负载,本地算力是不可替代的执行底座。云端继续承担训练和超大模型推理,端侧承担实时Agent执行,端云协同成为新常态。
八、产业趋势判断
第一,Agent PC成为一个独立品类。硬件形态、OS级安全框架、推理优化栈、OEM产品线四个要素同时到位,意味着这个品类不是概念炒作,而是有完整支撑的产业落地。
第二,端侧AI算力从"补位"走向"主算力"。过去端侧AI靠NPU做辅助,RTX Spark把数据中心级GPU架构搬进笔记本,端侧首次具备运行百亿级参数模型的完整能力。
第三,Windows生态与英伟达算力深度绑定。微软把MXC、Agent 365押注在英伟达硬件上,英伟达把消费级产品押注在Windows生态上,两家公司形成事实上的战略同盟。这一同盟对高通、英特尔、AMD形成结构性压力。
第四,产业链价值向"算力平台+软件生态"集中。硬件差异化空间收窄,真正决定产品竞争力的是CUDA技术栈、MXC安全框架、推理优化能力和OEM协同深度。未来AI PC的竞争,同样是生态竞争。
不过,产品能否真正成功还有待市场的检验。RTX Spark的定价、Windows Agent生态的成熟度、MXC的开发者接受度、竞品跟进速度,都会影响这一品类的放量节奏。但方向上,一个由英伟达和微软共同定义的Agent PC时代,已经开启。
——————
免责声明:本文仅用于芯片半导体领域的技术研究与行业分析,不构成任何投资建议,亦不作为任何投资决策的参考依据。文中信息均基于公开渠道的官方与权威资料整理。
张星河
每天一份高质量研报,持续聚焦芯片半导体、AI基础设施、AI智能硬件、具身智能、光通信等硬科技方面的行业研究、产业链分析与技术拆解。欢迎您的关注!