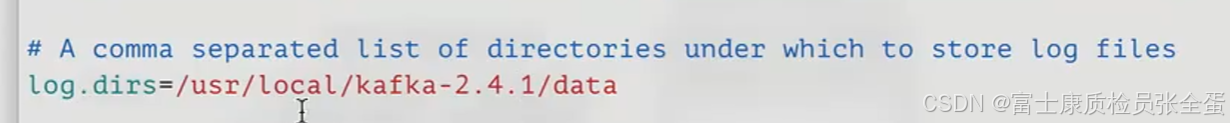
消息是要在Kafka中存储起来的,保存的形式是以log的形式保存的。
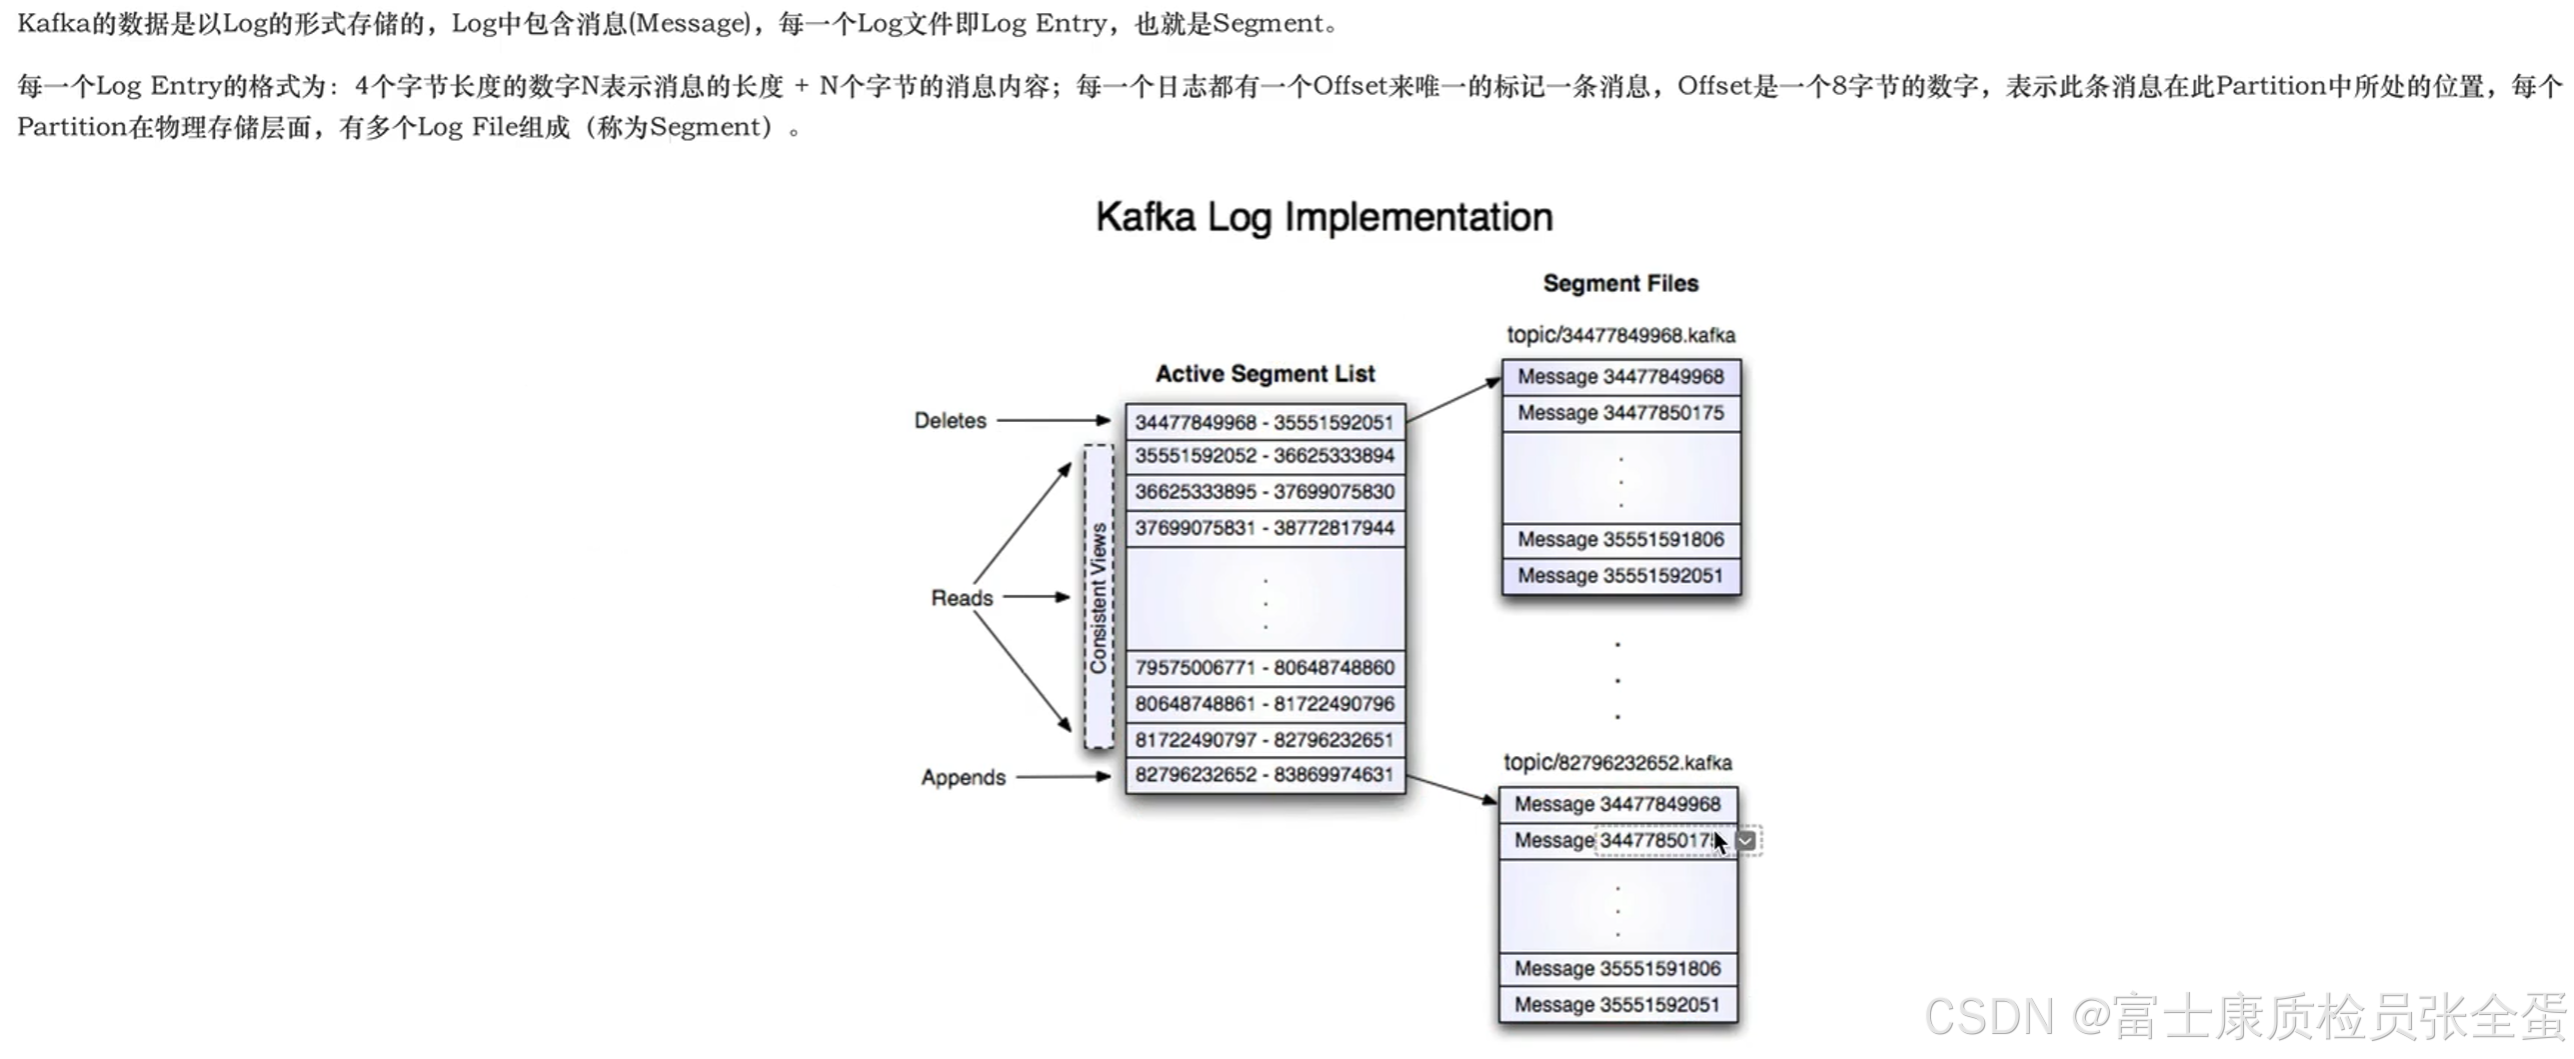
每个log文件以及对于的index文件称作为segment,也就是消息分布在多个文件当中进行存储。
一个分区当中是可以有多个segment的。
而这些log文件里面有deletes,这些segment是有一个保存时间的,或者说每条消息是有一个保存时间的,到了一定的时间之后,旧的消息是要被清除掉的。deletes表示某个区间的消息被标记要被清除,要腾出空间。
reads表示要去操作的消息。
appsends是要去添加一条新的消息,永远是在最新的log文件中往后去做添加的操作。而每一个log文件当中又是有多个message的。
消息在发送到分区之后并不是马上就给其写到文件当中去了,不会来一条消息就写入一条消息,这样对于磁盘IO来说是一个非常大的消耗。
它其实会在内存当中缓存一部分消息,m如果消息缓存到1000条,那么就会找到指定的log文件将这些数据写进去。还有一种方式就是向分区当中发送消息,假设到了10s,那么这区间发送的消息也是要保存下来的。M强制刷新到文件缓存的数量,s代表的是强制刷新的时间。
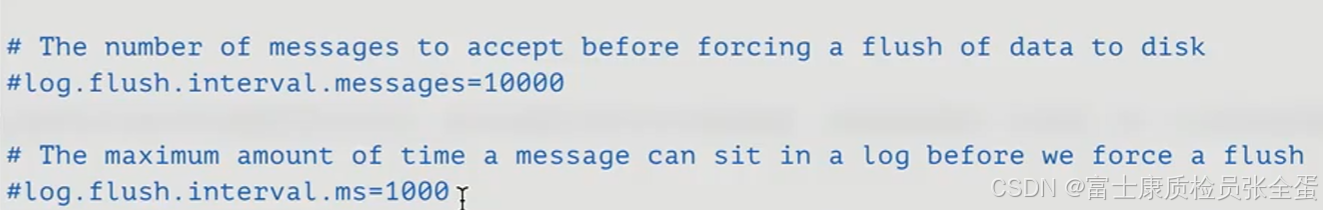
缓存1w条消息一下写入到文件当中,或者将消息缓存到内存当中1s。1s时间到了也会批量将消息去写到文件中去。
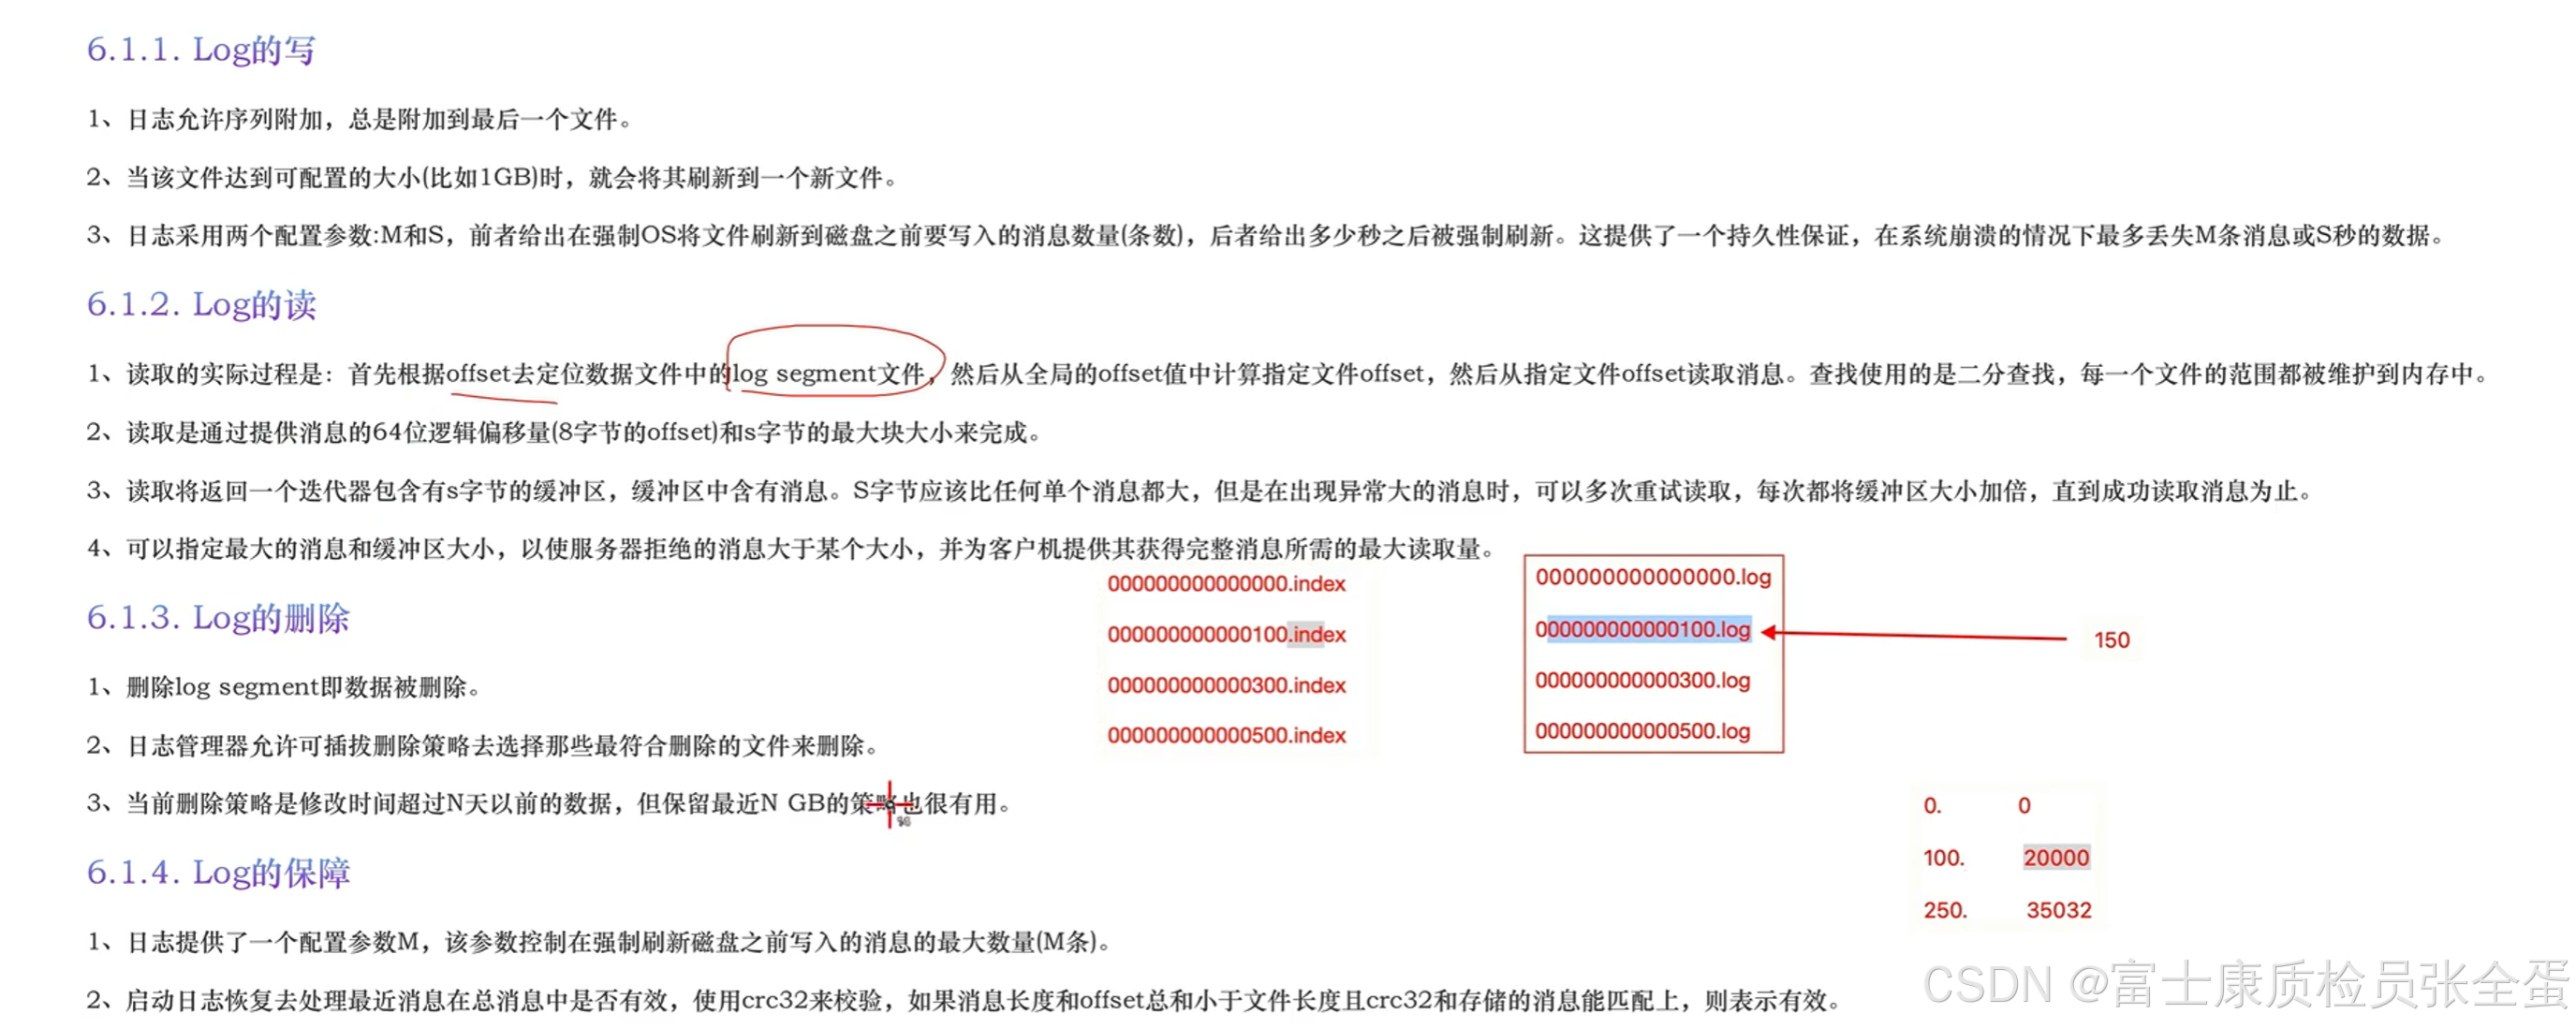
怎么快速的从1G文件当中去找到想要的那条消息呢?index文件当中就记录了这样的映射,第0条消息对应的物理位置是0字节,第100条消息偏移量20000字节,等等等。
这样记录了offset和物理偏移量。
第150个偏移量在这个文件中是第50条消息,第50条消息可以在index文件当中找到物理地址偏移量。拿到物理位置偏移量就可以到log文件中进行查找了,是这样一个读取逻辑。
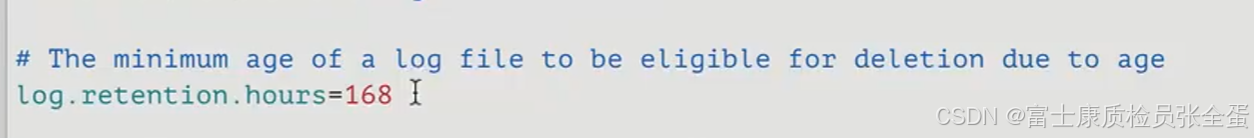
日志是默认保留7天,7天之后就被默认的删除掉,Kafka认为这条消息过期了。