/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
🏆 本文收录于 《YOLOv10实战:从入门到深度优化》 专栏。
该专栏系统复现并深度梳理全网主流 YOLOv10 改进方法与工程实战案例,覆盖分类、目标检测、实例分割、多目标追踪、关键点检测、旋转目标检测等多个方向,坚持 持续更新 + 深度解析 + 工程验证。
专栏将围绕 YOLOv10 的网络结构、训练策略、标签分配、损失函数、数据增强、模型压缩、推理加速与部署落地等内容展开,重点分析 Consistent Dual Assignments(一致性双重标签分配)、NMS-Free End-to-End Detection(无 NMS 端到端检测)、Holistic Efficiency-Accuracy Driven Model Design(整体效率-精度驱动模型设计) 等核心设计思想,并结合实际项目讲解其改进方式与应用价值。
部分章节还会结合国内外前沿论文与 AIGC 大模型技术,对主流改进方案进行重构与再设计,使内容更加贴近真实业务场景,适合希望深入研究 YOLOv10 或具有工程落地需求的开发者学习与参考。
🎯限时特惠:当前活动一折秒杀,一次订阅,终身有效,后续所有更新章节全部免费解锁 👉 传送门 👈️
🎉 本专栏还不够过瘾?别急,好戏才刚刚开始!我已经为你准备了一整套 YOLO 进阶实战大礼包🎁:
👉 《YOLOv8实战》 👉 《YOLOv9实战》 👉 《YOLOv10实战》 👉 《YOLOv11实战》 👉 《YOLOv12实战》 👉 以及最新上线的 《YOLOv26实战》
想一次搞定所有版本?直接冲 《YOLO全栈实战合集》,一站式涵盖 YOLO 各版本实战教学!
🚀 想学哪个版本?直接找 bug 菌“许愿”,安排!必须安排!🚀
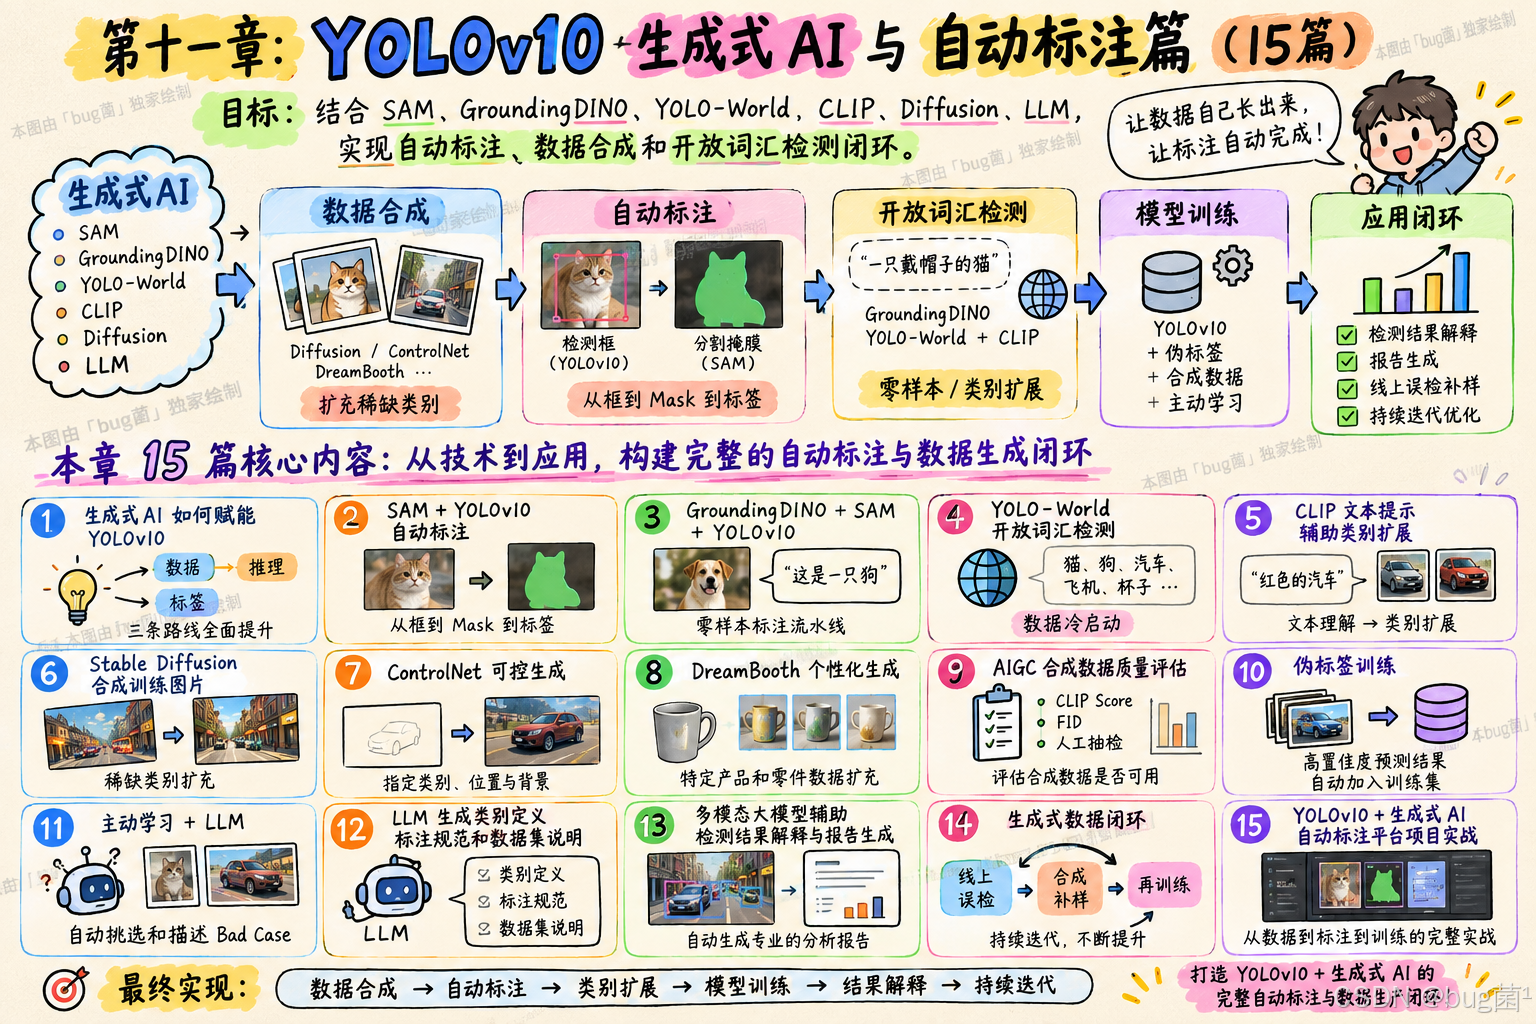
🎯 本文定位:计算机视觉 × YOLOv10 生成式 AI 与自动标注篇 📅 预计阅读时间:约 45~60 分钟 🏷️ 难度等级:⭐⭐⭐⭐☆(高级) 🔧 技术栈:Python 3.9+ · PyTorch 2.0+ · YOLOv10 · ByteTrack · OpenCV · NumPy
全文目录:
-
- 上期回顾
- 本节主题:伪标签训练——高置信度预测结果自动加入训练集
-
- 一、为什么需要伪标签训练?
- 二、伪标签训练的理论基础
-
- 2.1 半监督学习视角
- 2.2 熵最小化视角
- 2.3 目标检测中的特殊挑战
- 三、YOLOv10 伪标签训练整体流程
- 四、置信度阈值策略:不只是拍一个数字
-
- 4.1 固定阈值的局限
- 4.2 类别自适应阈值
- 4.3 动态阈值调度
- 五、伪标签生成的工程实现
- 六、数据合并与训练集构建
-
- 6.1 数据集目录结构设计
- 6.2 数据合并脚本
- 七、Student 模型训练配置
- 八、确认偏差问题与缓解策略
- 九、伪标签质量评估与可视化
- 十、伪标签与软标签的结合
- 十一、实战案例:工业质检中的伪标签训练
- 十二、常见错误与避坑指南
- 十三、伪标签与主动学习的结合
- 十四、性能评估与对比实验
- 本节内容小结
- 下期预告
- 📌 附录
- 🧧🧧 文末福利,等你来拿!🧧🧧
- 👨💻 About Me · 关于作者
上期回顾
在上期《YOLOv10【第十一章:生成式 AI 与自动标注篇·第9节】AIGC 合成数据质量评估:CLIP Score、FID、人工抽检》内容中,我们深入探讨了 AIGC 合成数据的质量评估体系。说实话,数据生成这件事并不难,难的是怎么判断生成出来的数据到底\”好不好用\”。我们引入了三条评估路线:
CLIP Score 衡量图文语义对齐程度——生成的图片和你给的文本描述到底有多贴近。这个指标很直观,一张标注为\”红色消防栓\”的图如果生成出来是蓝色水桶,CLIP Score 会毫不留情地给你打低分。
FID(Fréchet Inception Distance) 则站在统计分布的角度,衡量合成图像与真实图像在特征空间上的距离。FID 越低,说明合成数据的视觉分布越贴近真实数据,模型训练时产生的域偏移也就越小。我们详细讲解了如何用 pytorch-fid 工具计算 FID,以及为什么需要至少几千张图才能让 FID 估计稳定。
人工抽检 是最后一道防线。自动化指标再好,也代替不了人眼看一遍。我们设计了一套抽检流程:按类别分层随机抽样,逐张标注\”可用 / 疑似 / 报废\”三档,统计可用率,设置准入阈值。只有通过质量关卡的合成数据,才被允许进入训练集。
三条路线组合使用,构成了一个从自动到人工的质量闭环。这套体系不仅适用于 Stable Diffusion