Transformer拆解02:从Token到输出,一条数据经历了什么
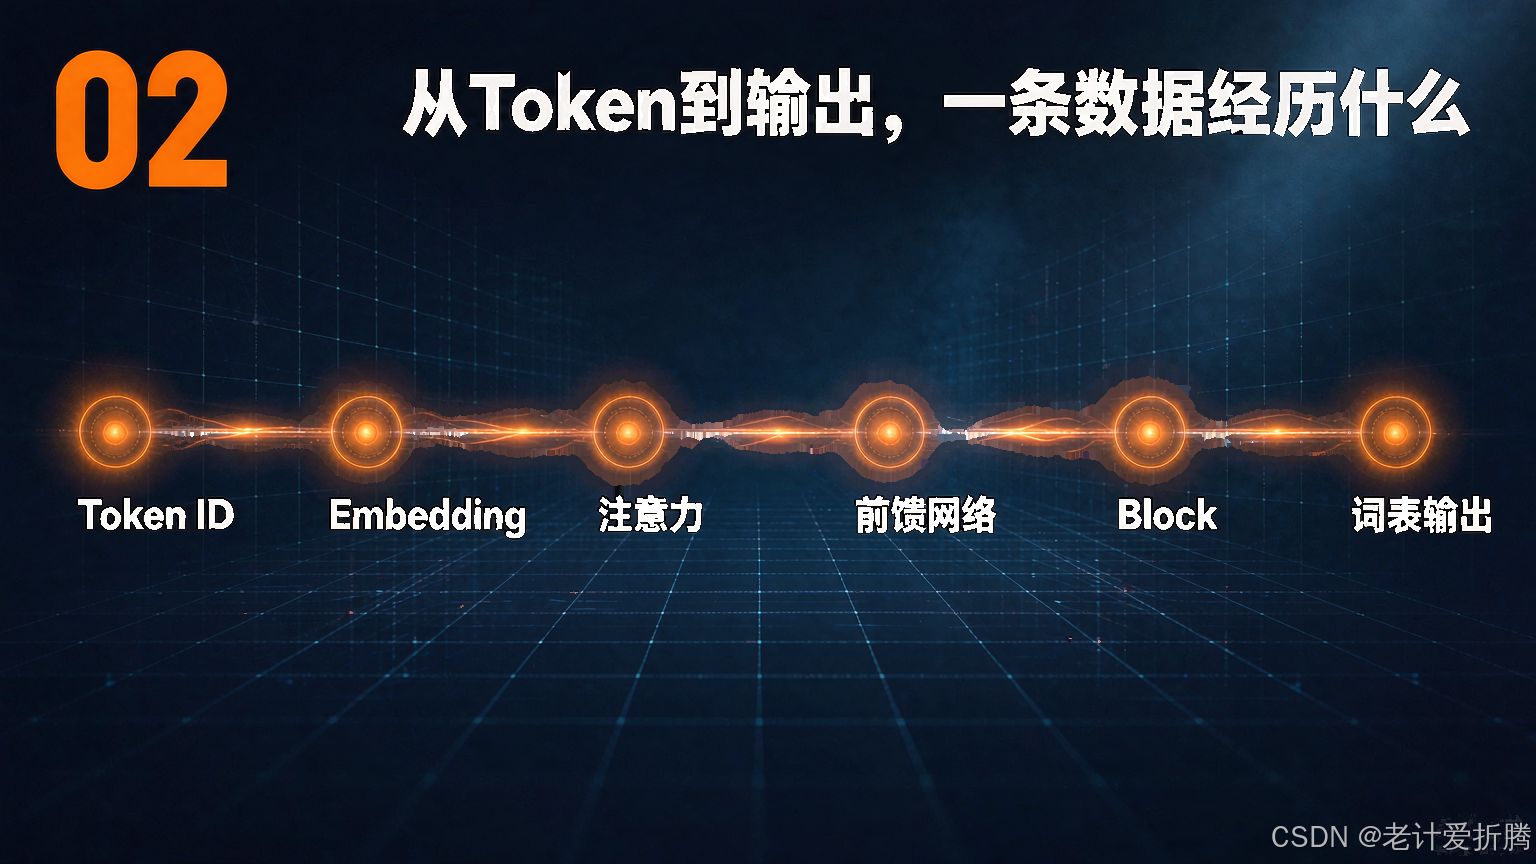
我是老计。第一次打开 Transformer 结构图,很容易产生一种感觉:左右两座高楼,里面塞满 Multi-Head Attention、Add、Norm、Feed Forward、Mask,还有一堆箭头绕来绕去。每个词都认识,连在一起却不知道数据到底怎么走。
这篇先不钻注意力公式,也不急着手算 Q、K、V。我们只做一件事:跟着一批 Token,从进入模型一直走到输出,先把整机地图搭起来。
学复杂系统,先看数据流,再拆零件。没有全景时,每个公式都是孤岛;知道输入从哪来、输出到哪去以后,每个零件才有位置。
一,先纠正一张容易混淆的地图
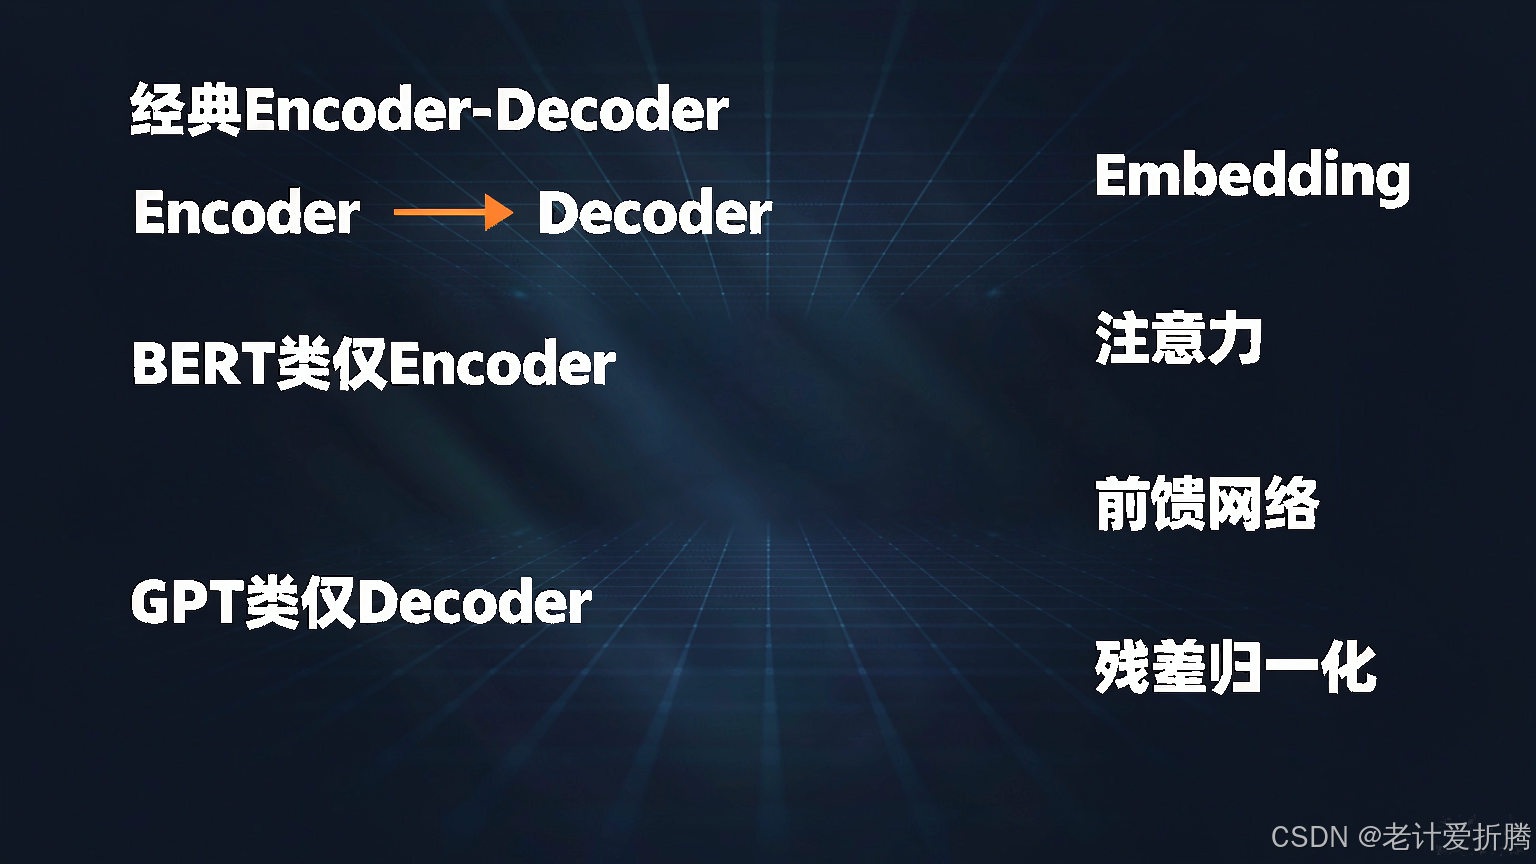
经典论文《Attention Is All You Need》提出的是 Encoder-Decoder Transformer,最初面向机器翻译:Encoder读取源语言,Decoder在Encoder结果和已生成文本的条件下输出目标语言。
后来主流模型走出了不同分支:
- BERT类模型主要使用Encoder,擅长双向理解、分类、抽取等任务;
- GPT类模型主要使用带因果Mask的Decoder结构,按从左到右的方式预测下一个Token;
- T5等模型保留Encoder-Decoder,输入先编码,输出再逐步生成。
因此,“Transformer的数据流”不是只有一个固定版本。全系列会先讲共同零件,再在第12篇专门比较三条路线。本篇主要用共同主干建立地图,并在涉及输出时说明GPT式自回归模型怎么做。
二,第一站,文字先变成Token ID
模型不能直接处理汉字和英文单词。输入文本先经过分词器,被拆成 Token,再映射成整数编号。
假设输入一句话,分词后得到5个Token,一个批次有2句话,则 Token ID 的形状是:
token_ids:[batch, seq_len] = [2, 5]
这里的两个维度分别表示:
- batch=2:一次并行处理2条序列;
- seq_len=5:每条序列暂时有5个位置。
Token ID只是一串索引,不带模型可计算的语义空间。编号7并不比编号3“更大”或“更重要”,它们只是去Embedding表里取哪一行的地址。
为什么还需要Mask
批次里的句子长度不同,通常要补齐到同一长度。补出来的Padding位置不是真实内容,后续注意力不能把它当有效Token,所以需要Padding Mask把它遮住。
GPT式生成还有另一种Mask,也就是Causal Mask。位置 t 在训练时不能偷看未来位置,否则“预测下一个Token”就失去意义。这两种Mask目的不同,第08篇会单独拆。
三,第二站,Token ID变成向量
模型根据每个ID查询Embedding矩阵,把一个整数变成一个长度为 d_model 的向量。
如果词表大小是32、隐藏维度是8,则Embedding矩阵形状为:
embedding_table:[vocab_size, d_model] = [32, 8]
token_ids:[batch, seq_len] = [2, 5]
embedding_output:[batch, seq_len, d_model] = [2, 5, 8]
查表后,每条序列不再是5个整数,而是5个8维向量。批次、序列长度和隐藏维度这三个轴,会贯穿模型主干。
还要加入位置信息
自注意力本身只看内容关系,不天然知道谁在前、谁在后。模型必须用位置编码、可学习位置向量或RoPE等方式补充顺序。
经典结构可以把位置表示与Token Embedding相加。两者最后都要对齐到 [batch, seq_len, d_model],才能逐位置相加。
Embedding回答“这个Token大致是什么”,位置表示回答“它出现在什么位置”。内容和顺序合在一起,才构成送进Transformer Block的输入。
四,第三站,进入Transformer Block
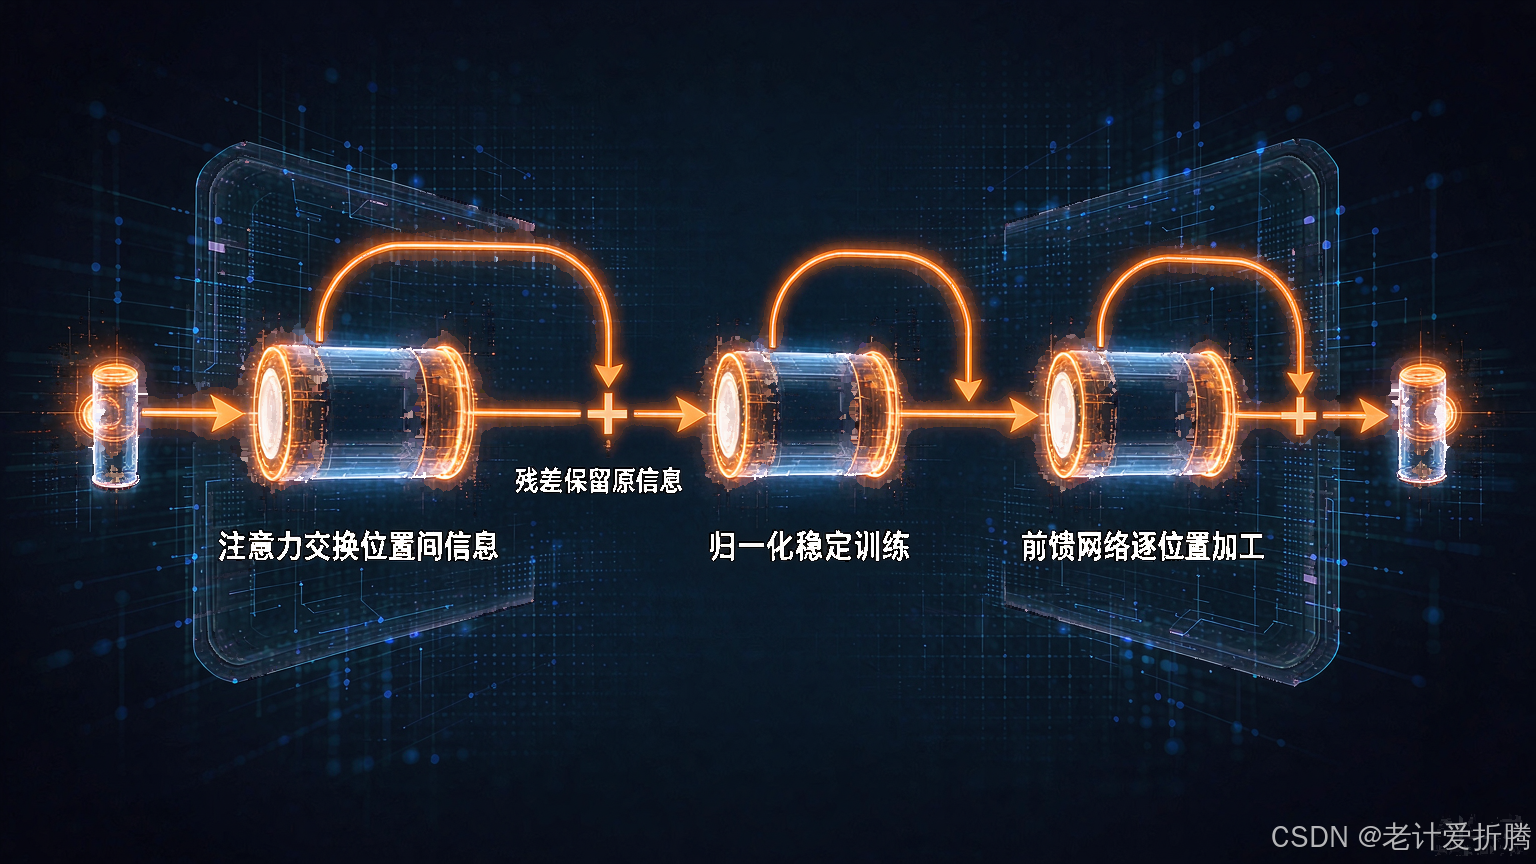
Transformer的主体不是一个孤零零的注意力层,而是一组重复堆叠的 Block。不同模型细节会变,但共同主干通常包含:
现代模型可能采用Pre-Norm、RMSNorm、SwiGLU等改造,但“注意力负责位置间交换信息,前馈网络负责逐位置加工信息”的基本分工仍然成立。
注意力子层做什么
注意力让每个位置根据当前任务,从其他位置取回有用信息。输入和输出通常都保持主隐藏维度:
input:[batch, seq_len, d_model]
attention_output:[batch, seq_len, d_model]
内部会拆成Q、K、V、多头和关系矩阵,但经过拼接与输出投影后,形状回到 d_model,这样才能与原输入做残差相加。
前馈网络做什么
前馈网络对每个位置独立使用同一组参数,通常先把隐藏维度扩到更大的 d_ff,经过激活后再压回 d_model:
[batch, seq_len, d_model]
到[batch, seq_len, d_ff]
再到[batch, seq_len, d_model]
注意力是在位置之间传消息,前馈网络是在每个位置内部做更深的特征变换。两者分工不同,缺一块都不是完整的Transformer Block。
为什么形状契约是整机骨架
理解Transformer,不能只记模块名称,还要盯住每个模块对形状的承诺。一个Block能重复堆几十层,前提是它接收 [batch, seq_len, d_model],处理完还交回同样的主干形状。
注意力内部会把 d_model 拆成多个头,每个头使用 head_dim;前馈网络内部会临时扩到 d_ff;这些都是子层内部的变形。走出子层以后,输出必须重新回到 d_model,否则:
- 无法与子层输入做逐元素残差相加;
- 下一层不能沿用同一种Block结构;
- 多层堆叠时,每层都要增加额外的适配投影,结构会变得混乱。
所以,d_model 可以理解成Transformer主干上的统一接口宽度。多头注意力和前馈网络可以在内部用各自需要的形状工作,但进入和离开Block时,要遵守共同契约。
残差连接要求什么
若输入 x 的形状是 [2, 5, 8],注意力输出也必须是 [2, 5, 8],才能计算:
x_after_attention = x + attention_output
前馈网络同理。它可以先扩成 [2, 5, 16],但第二次线性变换必须压回 [2, 5, 8],才能与主路径相加。
形状不是代码打印出来的附属信息,而是架构设计本身。看懂每一步的形状,就能判断矩阵能否相乘、残差能否相加、多个头能否拼回主干。
五,用代码跑一遍形状闭环
下面不实现完整注意力,只验证整条主干的形状契约。注意力子层在这里用同形状随机输出代替,目的是观察数据经过Embedding、位置、残差、前馈和词表投影后,维度如何闭合。
import numpy as np
rng = np.random.default_rng(11)
batch, seq_len = 2, 5
vocab_size, d_model, d_ff = 32, 8, 16
token_ids = rng.integers(0, vocab_size, size=(batch, seq_len))
embedding_table = rng.normal(scale=0.1, size=(vocab_size, d_model))
position = rng.normal(scale=0.1, size=(seq_len, d_model))
x = embedding_table[token_ids] + position[None, :, :]
# 这里只模拟注意力子层保持输入输出形状一致
attention_out = rng.normal(scale=0.1, size=x.shape)
x_after_attention = x + attention_out
w1 = rng.normal(scale=0.1, size=(d_model, d_ff))
w2 = rng.normal(scale=0.1, size=(d_ff, d_model))
ffn_hidden = np.maximum(0, x_after_attention @ w1)
ffn_out = ffn_hidden @ w2
block_out = x_after_attention + ffn_out
output_weight = rng.normal(scale=0.1, size=(d_model, vocab_size))
logits = block_out @ output_weight
print("token_ids:", token_ids.shape)
print("embedding + position:", x.shape)
print("after attention:", x_after_attention.shape)
print("FFN hidden:", ffn_hidden.shape)
print("block output:", block_out.shape)
print("vocabulary logits:", logits.shape)
运行环境:Python 3,NumPy 1.26.4,CPU。实际输出:
token_ids: (2, 5)
embedding + position: (2, 5, 8)
after attention: (2, 5, 8)
FFN hidden: (2, 5, 16)
block output: (2, 5, 8)
vocabulary logits: (2, 5, 32)
可以看到两个重要规律:
- Transformer Block内部可以临时扩维、拆头,但主干输入输出通常回到 d_model;
- 最后一层线性投影把每个位置的8维隐藏表示映射成32维词表分数,因此输出是 [batch, seq_len, vocab_size]。
这里的 logits 还不是概率。通常还要沿词表维度做Softmax,得到每个位置对各Token的概率分布。训练时把它与目标Token计算损失;生成时根据最后一个位置的分布选择下一个Token。
输出头和权重共享
语言模型的输出投影矩阵形状通常是 [d_model, vocab_size]。它把每个位置的隐藏向量,映射为词表中每个Token的分数。
不少语言模型会让输入Embedding矩阵和输出投影共享权重。输入查表时,Embedding表形状是 [vocab_size, d_model];输出投影时,可以使用它的转置 [d_model, vocab_size]。这样做能够减少参数,也让输入和输出使用同一个Token表示空间。
权重共享不是Transformer数学定义的必选项,不同模型可以采用不同实现。这里要区分:
- Embedding是架构主干进入连续向量空间的步骤;
- 输出头是把隐藏表示送回任务空间的步骤;
- 是否共享权重是模型实现选择,不是所有Transformer都必须相同。
一个位置为什么会输出整张词表
GPT式语言模型对序列中每个训练位置都产生一组词表Logits。若输入形状为 [batch, seq_len, d_model],投影后就是 [batch, seq_len, vocab_size]。
训练时,每个有效位置都有一个“下一个Token”目标,因此可以并行计算多个位置的损失。推理时通常只使用当前最后一个有效位置的Logits,选出下一个Token,再把它接回序列继续计算。
六,GPT式模型如何学习下一个Token
假设一条Token序列是:
[7, 12, 5, 9, 3]
训练GPT式模型时,可以把输入和目标错开一个位置:
import numpy as np
tokens = np.array([[7, 12, 5, 9, 3]])
decoder_input = tokens[:, :–1]
target = tokens[:, 1:]
print("tokens:", tokens.tolist())
print("decoder input:", decoder_input.tolist(), decoder_input.shape)
print("next-token target:", target.tolist(), target.shape)
实际输出:
tokens: [[7, 12, 5, 9, 3]]
decoder input: [[7, 12, 5, 9]] (1, 4)
next-token target: [[12, 5, 9, 3]] (1, 4)
位置1看到Token 7,要预测12;位置2看到前两个有效Token,要预测5。训练时可以并行计算各位置的损失,但Causal Mask必须阻止每个位置读取未来答案。
这解释了一个看似矛盾的问题:GPT训练时能并行处理整段序列,生成时却仍然要一个Token接一个Token。 训练时整段目标已知,只需用Mask防偷看;推理时下一个Token尚不存在,必须先生成出来,才能继续下一步。第14篇讲KV Cache时会再次回到这个区别。
Transformer消除了网络层内部按时间步更新隐藏状态的依赖,却没有消除自回归生成中“下一个Token依赖前面结果”的任务依赖。
七,一张从输入到输出的地图
现在把完整路径收拢起来。
共同输入主干
- 原始文本经过分词得到Token ID;
- Token ID查Embedding表得到向量;
- 加入位置信息;
- 经过多层Transformer Block;
- 每个Block交替进行位置间信息交换和逐位置特征加工。
不同架构的出口
- Encoder模型可以取特定位置或所有位置表示做分类、标注、检索;
- Decoder模型把隐藏表示投影到词表,预测下一个Token;
- Encoder-Decoder模型让Decoder额外关注Encoder输出,逐步生成目标序列。
三条路线内部看见的信息不同
三种架构不只出口不同,注意力能看见的范围也不同。
Encoder自注意力通常是双向的。 一个位置可以同时读取左边和右边的上下文,因此适合理解整段输入。例如做句子分类时,模型可以综合整句话后再判断。
GPT式Decoder使用因果Mask。 每个位置只能读取自己和左侧已经出现的Token,不能看右侧未来内容。否则训练时会偷看到目标答案,生成能力就没有意义。
Encoder-Decoder还有交叉注意力。 Decoder除了对已生成目标文本做因果自注意力,还会用自己的查询去读取Encoder输出。机器翻译中,Encoder先理解源句,Decoder生成目标词时,再动态读取源句相关位置。
这三者共享注意力思想,却有不同的信息流约束。把它们都画成“Token进入几个Block再输出”,会漏掉最重要的差异:谁能看见谁。 第12篇会把自注意力、因果注意力和交叉注意力放在同一张图里详细比较。
数据流中的状态保存
训练时,一批输入经过网络得到当前批次输出,梯度用于更新模型参数。模型不会自动把上一批对话的隐藏状态永久保留下来。推理服务中的“上下文”,来自再次把历史Token送入模型,或利用KV Cache复用历史注意力的Key和Value。
因此不要把Transformer上下文理解成数据库式记忆。它处理的是当前上下文窗口里的Token;长期记忆、会话存储和RAG是模型外部系统提供的能力。 这也解释了为什么应用框架仍要单独管理历史和知识库。
数据流不难,难的是Block内部每个零件的细节。接下来几篇会沿这张地图逐个拆,不会再迷路。
八,常见误区
误区一:Token ID就是词的数值表示
ID只是查表索引。真正送进模型计算的是Embedding向量。
误区二:Transformer只有注意力
注意力很关键,但完整Block还包含前馈网络、残差、归一化等结构。模型最后还要有任务头或词表投影。
误区三:所有Transformer都是论文里的双塔结构
经典论文是Encoder-Decoder。BERT、GPT等只采用其中一类主体并做了不同改造,不能用一张图概括所有模型。
误区四:训练和生成的数据流一样
训练时可以用整段目标并行计算,依靠Causal Mask防止未来泄漏;自回归生成时,未来Token还不存在,必须逐步生成。
误区五:每经过一层,隐藏维度都会变大
前馈网络内部会扩到 d_ff,多头注意力会拆分维度,但Block主干通常回到 d_model,以便残差连接和多层堆叠。
小结
一条文本进入Transformer后,先被分词成Token ID,再查Embedding表变成 [batch, seq_len, d_model] 的向量,并加入位置信息。随后数据进入重复堆叠的Block:注意力负责位置间信息交换,前馈网络负责逐位置加工,残差与归一化帮助深层网络稳定训练。主干形状通常保持 d_model,最后再按任务投影到类别或词表空间。
经典Transformer、BERT类Encoder、GPT类Decoder和T5类Encoder-Decoder共享许多零件,但信息流向和训练目标不同。尤其要分清:Transformer层内可以并行处理序列位置,不代表自回归生成也能一次生成所有未来Token。
下一篇,我们拆这条数据流的第一块基础零件:Embedding。一个整数ID是怎么变成向量的,这个向量又到底学到了什么?
延伸阅读
- Vaswani等,《Attention Is All You Need》,arXiv:arxiv.org/abs/1706.03762
- Devlin等,《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》,arXiv:arxiv.org/abs/1810.04805
- Radford等,《Language Models are Unsupervised Multitask Learners》,OpenAI技术报告
- PyTorch官方文档,Transformer模块:pytorch.org/docs/stable/generated/torch.nn.Transformer.html
(本文为技术学习与经验分享,代码用于理解机制。框架与实现可能随版本变化,具体用法请以官方最新文档为准。)
版权声明:本文版权归作者老计个人所有。欢迎个人学习阅读,未经授权,禁止转载、摘编、搬运或用于任何商业用途,违者将追究责任。转载请联系作者Jich。