/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
拆解 Otter AI 会议助手:实时转录与多方动作项提取的架构与延迟瓶颈
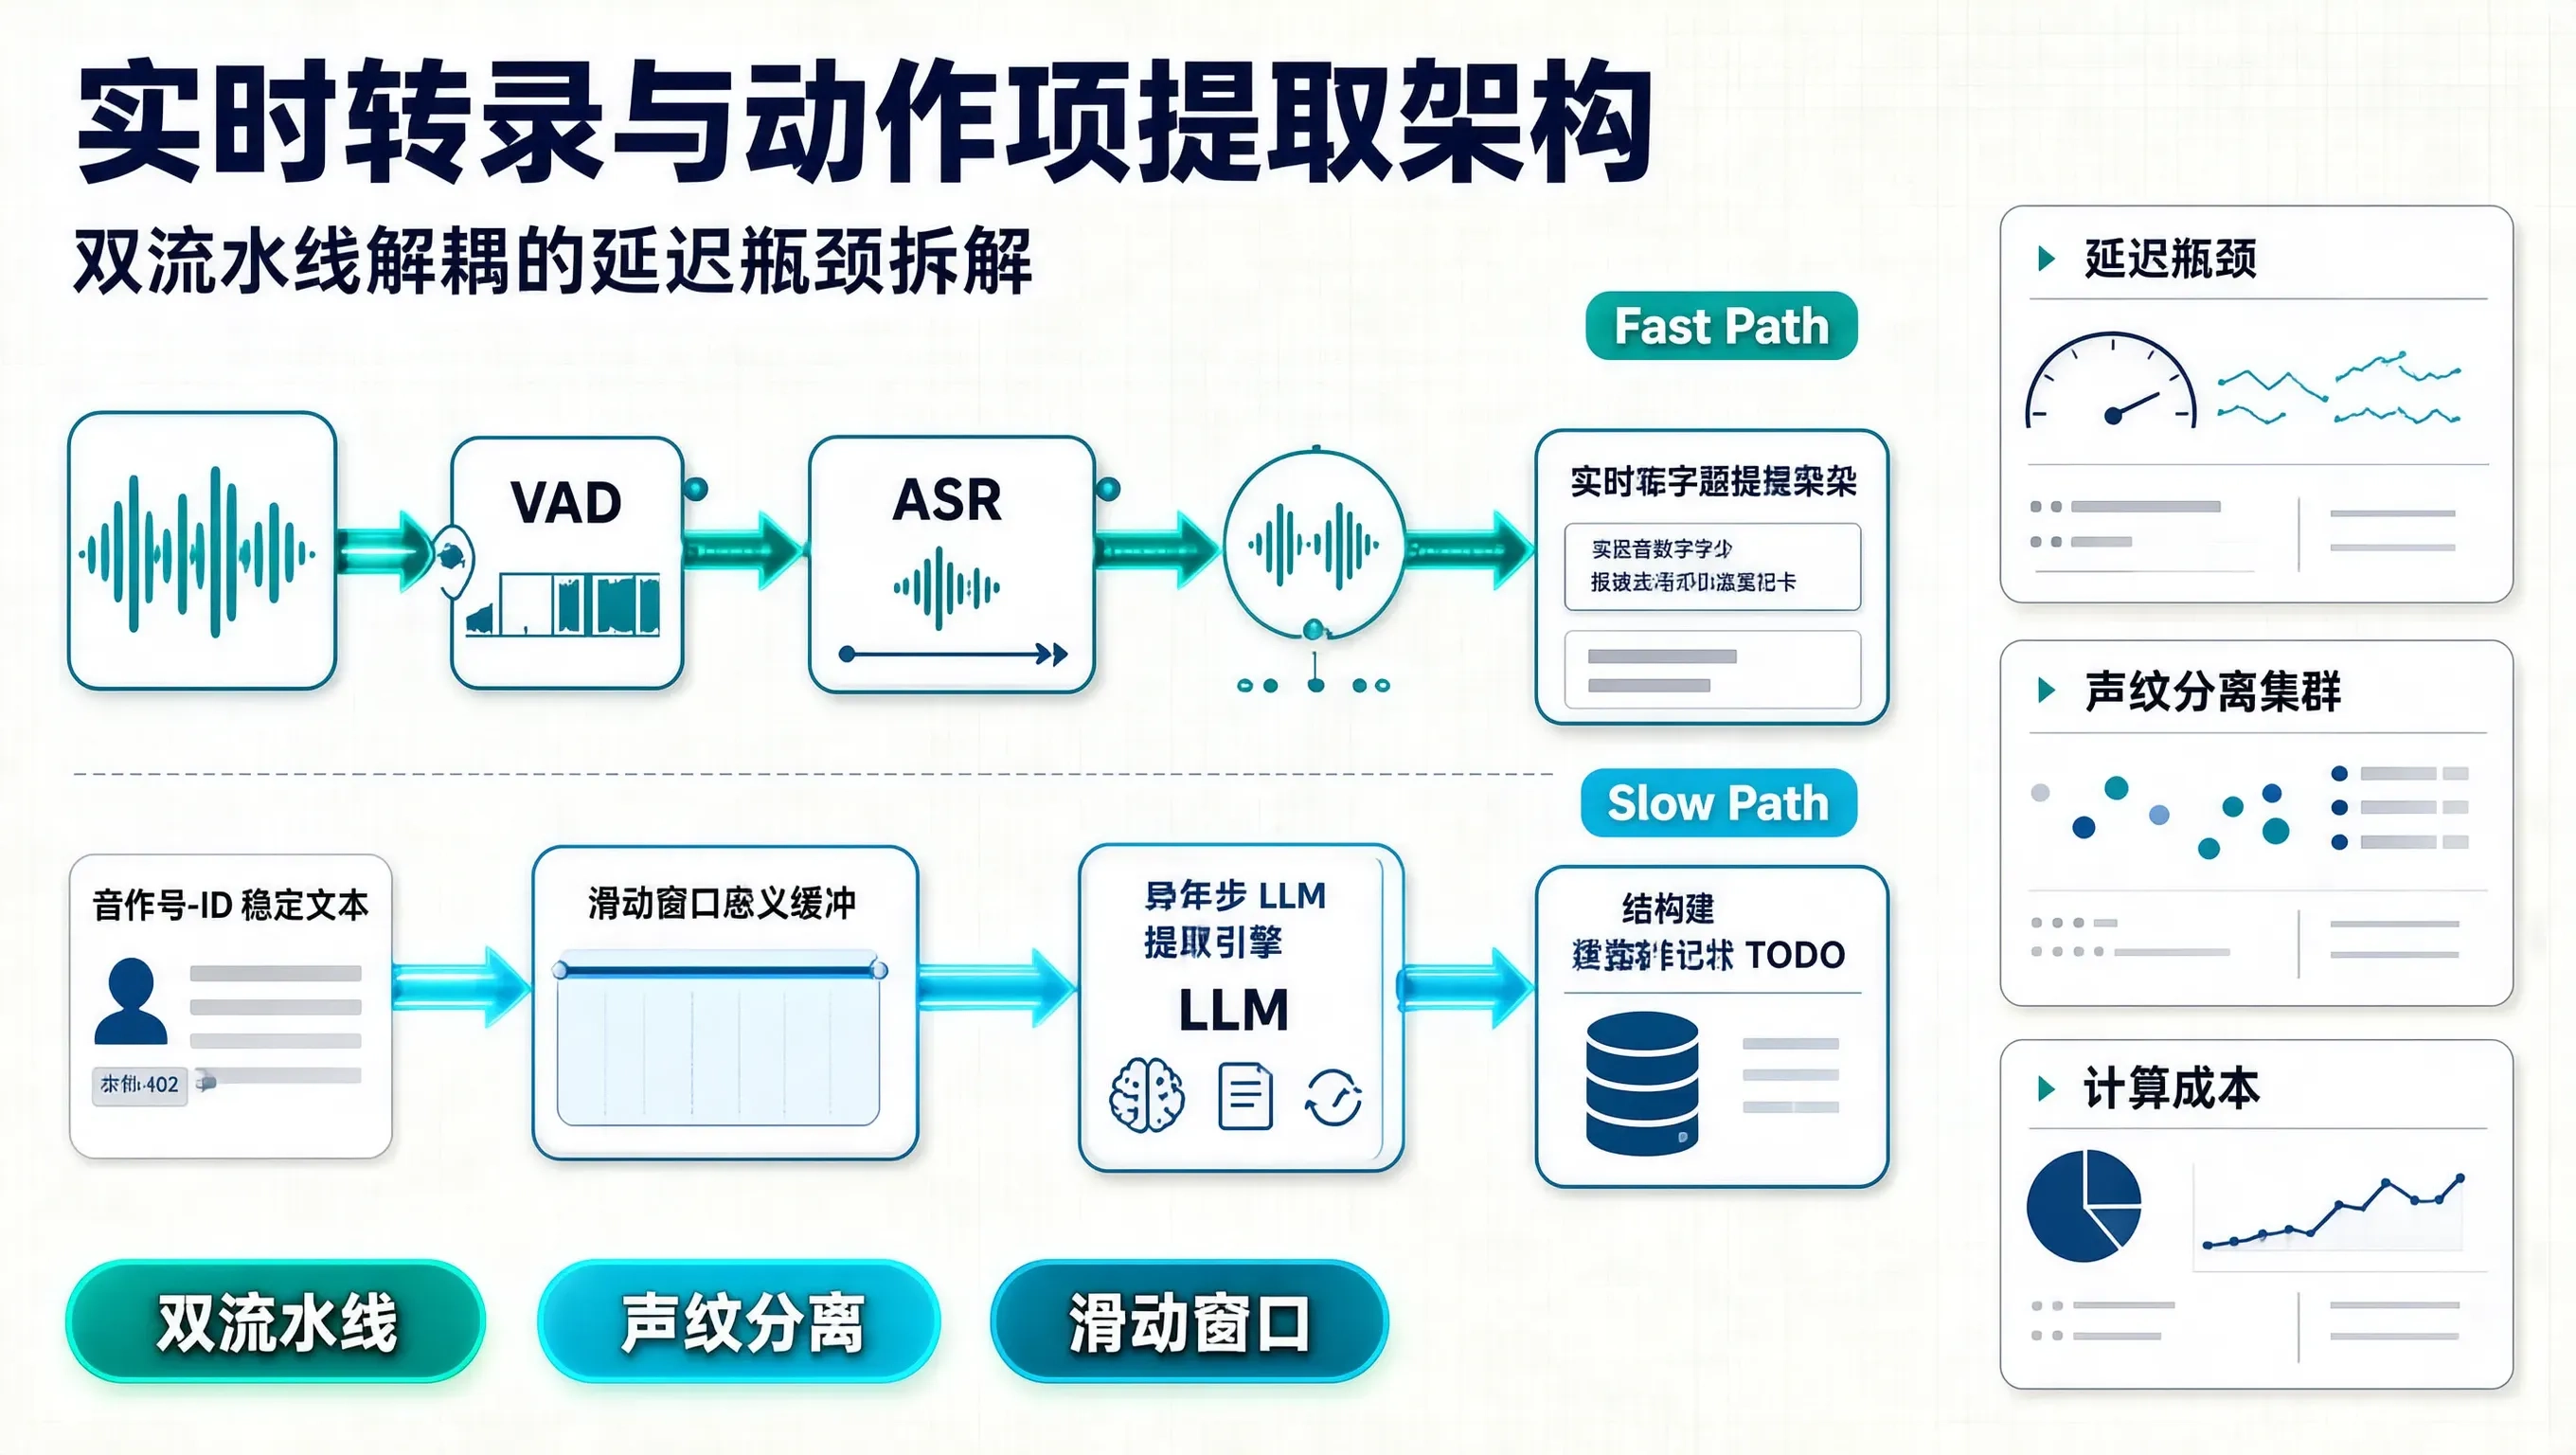
在企业级 AI 效率工具赛道中,Otter.ai 是将“实时会议转录”与“协作动作项提取”结合得最早、工程化程度最高的产品之一。很多团队在自研类似产品时,往往以为只要接一个开源的 Whisper 或云厂商的 ASR 接口,再套一个大语言模型做总结就大功告成。
但一旦进入真实的多人在线会议场景,系统就会被几座大山瞬间击穿:多说话人实时分离(Speaker Diarization)的计算延迟、流式语音识别的上下文漂移与纠错抖动、以及在长对话流中如何精准捕获跨发言人的 TODO 动作项而不产生漏报或重复。
今天我们从系统架构、流式流水线设计、延迟瓶颈与算力成本四个维度,拆解 Otter 类似架构的核心工程实现。
一、整体系统拓扑:双流水线解耦架构
实时会议助手最核心的架构原则是**“实时感知”与“语义理解”物理隔离**。实时展示字幕要求端到端延迟控制在 500ms800ms 以内,而多方决策提炼和动作项提取依赖较宽的语义上下文,通常允许 35 秒的异步延迟。
[会议客户端 (Zoom/Meet/Teams WebRTC 音频流)]
│ (Opus/PCM 音频流, WebSocket)
▼
┌───────────────────────────────┐
│ Ingress Gateway & VAD 切片 │
└──────────────┬────────────────┘
│
┌──────────────┴───────────────┐
▼ ▼
┌──────────────┐ ┌────────────────┐
│ 实时 ASR 流流水线 │ │ 声纹聚类与跟踪 │
│ (CTC/Conformer)│ │ (ECAPA-TDNN) │
└──────┬───────┘ └───────┬────────┘
│ │
└──────────────┬───────────────┘
▼
[实时对齐与重打标 (Alignment Engine)]
│ (带说话人 ID 的流式文本)
├──────────────────────────► [前端客户端 (实时字幕流)]
▼
[滑动窗口语义缓冲区 (Token Buffer)]
│ (基于发言轮次聚类)
▼
[异步 LLM 动作项提取引擎 (Action Pipeline)]
│
▼
[结构化 TODO 数据库 (Webhook/Jira/Notion)]
系统主要由两条核心链路构成:
二、实时流式处理中的三大延迟瓶颈
1. 说话人分离(Diarization)的在线流式难题
离线场景下,聚类算法(如 Spectral Clustering)可以纵览整场会议的全局声纹特征分布,准确率极高。但在实时流式场景中,系统必须在用户开口后 200ms 内确定“这是谁在说话”。
- 冷启动问题:会议刚开始的前 3 分钟,声纹库中样本极少,容易将同一人的不同语气判定为新说话人(Speaker Over-segmentation)。
- 重叠语音(Overlapped Speech):当两人同时争论时,传统单声道特征向量会产生严重漂移。
- 解法:采用两级缓存机制。前端使用轻量级声纹编码器(如 ECAPA-TDNN)提取 192 维 Embedding,与本地动态声纹池计算余弦相似度;后台异步维护一个全局重聚类任务,每隔 30 秒对历史发言轮次进行一次置信度重新标定(Retroactive Relabeling),并向前台静默推送修正事件。
2. 流式 ASR 的上下文漂移与最终定稿(Finalization)
流式 ASR 为了降低延迟,通常采用因果卷积(Causal Conformer)或基于分块注意力的 Transformer。这类模型在处理句子未结束的末尾词汇时,容易根据不完整的声学线索给出临时预测,随着后续词汇输入,前面的词汇会被推翻。
如果前端每次变动都直接刷写 DOM,会导致字幕疯狂跳动,破坏阅读体验。工程上必须设计一个定稿判定算法(Finalization Heuristic):
- 设定固定长度的回退窗口(如 1.2 秒)。
- 结合 VAD 检测到的微小停顿(>300ms)作为强制断句切片点(Commit Point)。
- 只有经过 Commit 的文本段才会被标记为不可变,并推入 LLM 语义缓冲区。
3. 动作项提取的语义截断与跨轮次丢失
真实的会议动作项往往跨越多个发言轮次。例如:
- Speaker A (产品):“我们需要在周五前把支付网关的超时时间改成 5 秒。”
- Speaker B (后端):“没问题,这块我来改,顺便把重试次数降到 2 次。”
如果采用固定时间切片(如每 60 秒切一次送给 LLM),极易在 A 和 B 的发言中间发生硬截断,导致模型无法将“修改超时时间”与“Speaker B 承接”进行语义关联。
三、核心工程实现:流式滑动窗口与动作项提取调度器
以下是使用 Python 实现的基于语义轮次(Turn-based)的滑动窗口与动作项提取调度核心逻辑:
import asyncio
import time
from typing import List, Dict, Optional
from dataclasses import dataclass, field
@dataclass
class Utterance:
speaker_id: str
text: str
start_time: float
end_time: float
is_final: bool = True
@dataclass
class ActionItem:
task: str
assignee: Optional[str]
due_date: Optional[str]
context_segment: str
confidence: float
class MeetingActionScheduler:
def __init__(self, meeting_id: str, window_turns: int = 8, overlap_turns: int = 3):
self.meeting_id = meeting_id
self.window_turns = window_turns
self.overlap_turns = overlap_turns
self.utterance_buffer: List[Utterance] = []
self.processed_turn_count = 0
self.extracted_actions: List[ActionItem] = []
self._lock = asyncio.Lock()
async def ingest_utterance(self, utterance: Utterance):
async with self._lock:
# 相同说话人的连续发言进行合并
if self.utterance_buffer and self.utterance_buffer[-1].speaker_id == utterance.speaker_id:
prev = self.utterance_buffer[-1]
# 停顿小于 1.5 秒视为同一轮次
if utterance.start_time – prev.end_time < 1.5:
prev.text += " " + utterance.text
prev.end_time = utterance.end_time
return
self.utterance_buffer.append(utterance)
# 判断是否触发慢链路 LLM 分析
current_turns = len(self.utterance_buffer)
if current_turns – self.processed_turn_count >= (self.window_turns – self.overlap_turns):
# 异步派发任务,不阻塞快链路
asyncio.create_task(self._trigger_extraction(self.utterance_buffer[-self.window_turns:]))
self.processed_turn_count = current_turns
async def _trigger_extraction(self, window_slice: List[Utterance]):
formatted_dialogue = "\\n".join(
[f"[{u.speaker_id} ({u.start_time:.1f}s)]: {u.text}" for u in window_slice]
)
prompt = self._build_action_prompt(formatted_dialogue)
# 调用大模型执行结构化抽取(此处模拟调用)
actions = await self._call_llm_extractor(prompt)
async with self._lock:
for action in actions:
# 基于语义相似度与时间戳去重,避免滑动窗口重叠部分产生重复 TODO
if not self._is_duplicate(action):
self.extracted_actions.append(action)
print(f"🎯 [提取到新动作项] 负责人: {action.assignee} | 任务: {action.task}")
def _build_action_prompt(self, dialogue: str) -> str:
return f"""
你是一个资深技术会议分析引擎。请从以下对话片段中提取明确的动作项(Action Items)。
严格要求:
1. 必须是明确承诺或指派的任务,排除模糊意向;
2. 准确提取责任人(若未指名则填 NULL);
3. 提取截止时间(若有);
4. 输出 JSON 格式。
对话记录:
{dialogue}
"""
async def _call_llm_extractor(self, prompt: str) -> List[ActionItem]:
# 生产环境中调用如 Claude 3.5 Haiku 或 GPT-4o-mini
await asyncio.sleep(0.5) # 模拟网络 I/O
return []
def _is_duplicate(self, new_action: ActionItem) -> bool:
for exist in self.extracted_actions:
# 简易相似度判定:任务文本重合度高且责任人一致
if exist.assignee == new_action.assignee and exist.task in new_action.task:
return True
return False
四、性能指标与算力账本
评估一个会议 AI 助手的工程成熟度,核心看以下关键链路指标:
| ASR 字符端到端延迟 | 1200ms ~ 2000ms | 350ms ~ 500ms | Causal Conformer 流式推理 + WebSocket 帧压缩 |
| 说话人误判率 (DER) | 18% ~ 25% | 8% ~ 12% | 预注册声纹特征池 + 离线轻量重聚类修正 |
| 动作项抽取准确率 (Precision) | 65% (大量虚假 TODO) | 88% | 动态滑动窗口 + 语义去重过滤器 |
| 单并发单小时算力成本 | ~$0.15 / 小时 | ~$0.035 / 小时 | 端侧 VAD 过滤 30% 静音 + 小模型蒸馏抽取 |
在自研方案中,如果盲目将全量音频不断转写为全量文本并整段喂给通用大模型,一场 1 小时的 6 人技术会议可能会消耗高达 50k tokens 的上下文,API 成本迅速吞噬产品毛利。
通过端侧 VAD 过滤无声帧、ASR 本地私有化集群切片、以及基于轮次的滑动窗口增量分析,不仅能将服务器开销压减 70% 以上,更能把真正有价值的架构决策与任务分配以毫秒级的响应反馈给团队。




