在元宇宙虚拟音乐会、沉浸式 3D 数字展馆以及高端科技互动装置中,视听协同(Audiovisual Integration)是打造极致沉浸感的终极圣杯。
我们不仅希望在屏幕上看到成千上万个由流体力学驱动的发光粒子在虚空中盘旋飞舞;更渴望戴上耳机时,能够清晰听到每一团粒子群在掠过耳畔时的立体风切声、它们撞击在空间虚拟边界上的清脆泛音,以及随着粒子距离远近而产生的实时多普勒效应(Doppler Effect)与三维空间残响。
然而,在过去的前端架构中,图形与音频往往处于彻底割裂的“平行宇宙”:
- 图形跑在 WebGL / WebGPU 的 GPU 显存中;
- 音频跑在 Web Audio API 的音频渲染线程中;
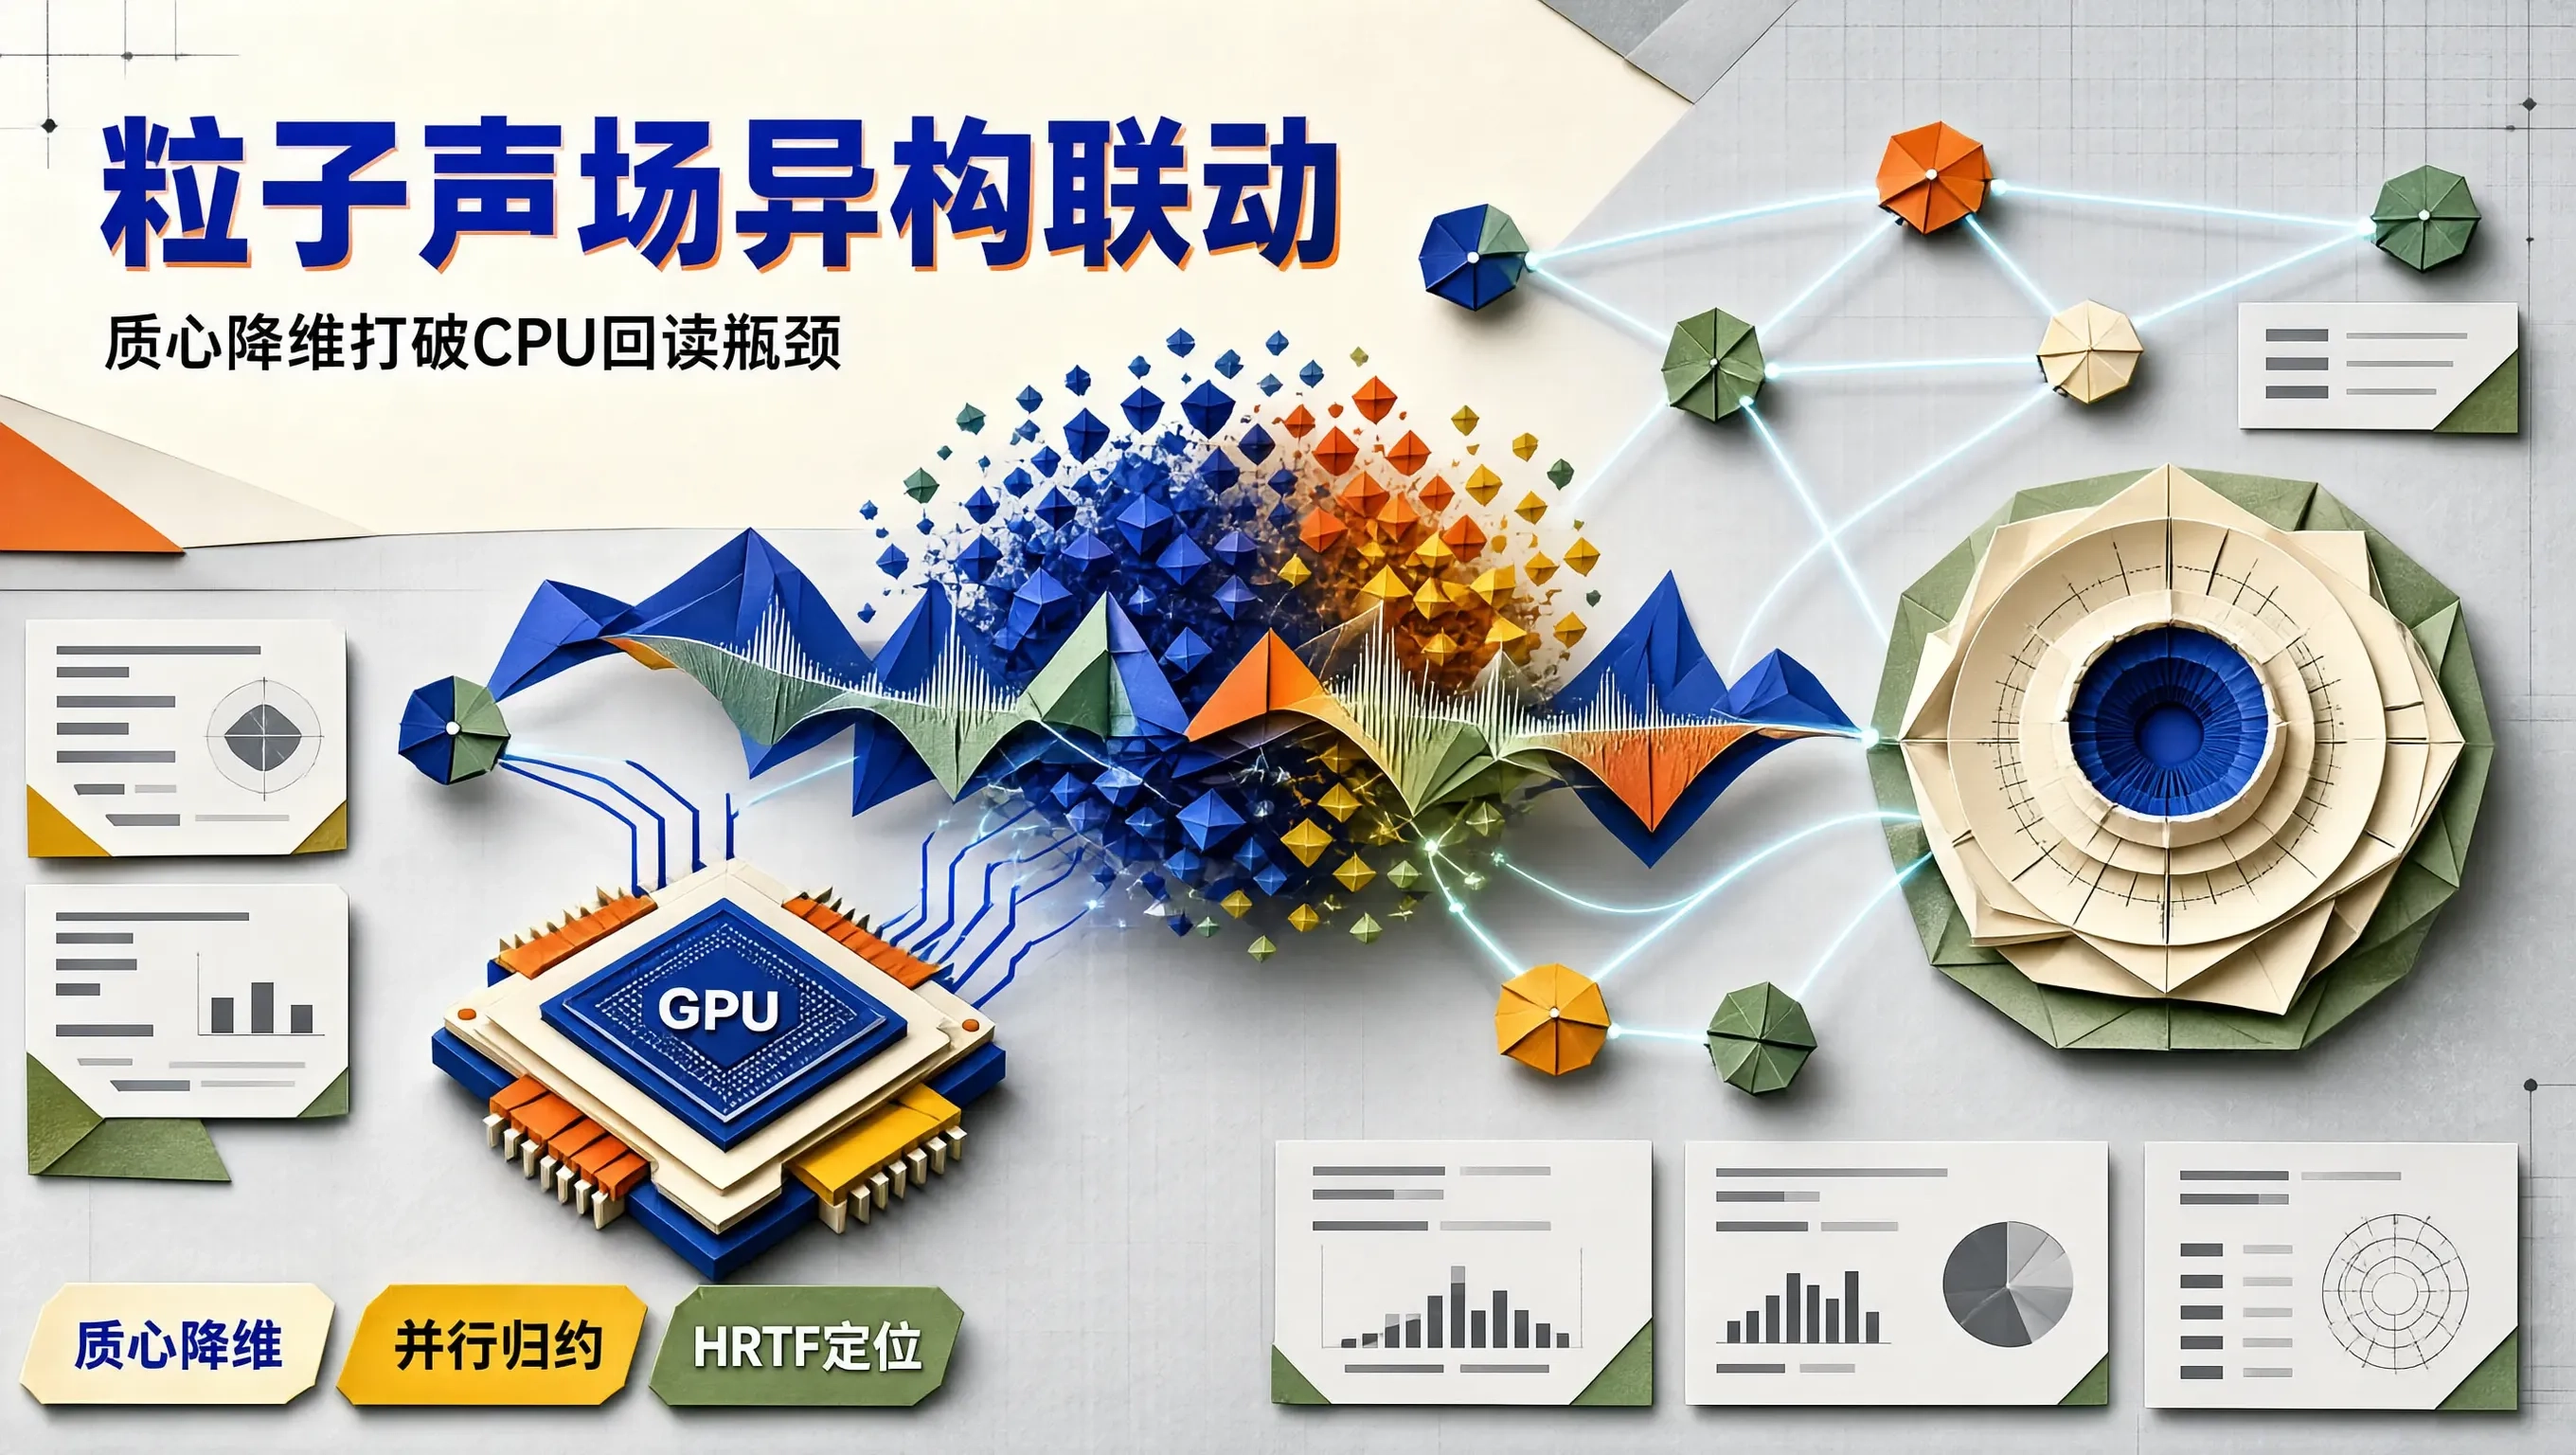
- 如果想让音频感知粒子的三维坐标,开发者不得不把数十万个粒子的位置在每帧从 GPU 读回(Readback)CPU 主线程,导致显存管线严重停顿(Pipeline Stall),帧率腰斩。
随着 WebGPU 规范的成熟与 Web Audio API AudioWorklet / PannerNode 空间化音频管线的完善,异构流式联动(Heterogeneous Streaming)迎来了历史性的技术跨越。
今天,我们将通过严密的工程架构,探讨如何利用 WebGPU 紧凑统计计算着色器(Reduction Compute Shader) 实时聚类提取粒子质心,并通过低延迟环形共享数据管道,与 Web Audio 的 HRTF(头部相关传输函数)3D 声学空间无缝流式串接,实现真正音画合一的沉浸式空间声场。
异构架构设计:打破 CPU 回读瓶颈的“质心降维”策略
在包含 50,000 个粒子的粒子风暴中,我们绝不可能为每一个粒子单独创建一个音频振荡器(Oscillator)——浏览器的音频混音通道(Mixer Channels)会在瞬间被打爆。
在心理声学(Psychoacoustics)中,人类听觉系统对群组微粒的感知遵循宏观能量聚类法则(Sound Energy Clustering):成千上万个微观粒子的空间啸叫,在宏观听感上等价于少数几个(例如 4 到 8 个)主要**能量集群质心(Cluster Centroids)**的联合声场。
优雅的异构流式流水线:
空间音频基石:Web Audio PannerNode 与 HRTF 定位
Web Audio API 内置了工业级的 PannerNode(空间声像平移器)。
通过配置平移模型:
panner.panningModel = 'HRTF'; // 头部相关传输函数,提供最真实的耳廓立体空间定位
panner.distanceModel = 'inverse'; // 反比例物理距离衰减
PannerNode 能够依据虚拟摄像机(听者 Listener)与声源在三维笛卡尔坐标系中的相对向量,在底层 C++ 线程中自动解算双耳时间差(ITD, Interaural Time Difference)与双耳声级差(ILD, Interaural Level Difference)。当粒子群从屏幕右后方向前下方俯冲时,耳机会实时呈现出声音从脑后掠过右耳、最终降落在正前方的逼真空间定位感!
完整代码实现:WebGPU 计算与 Web Audio 联动引擎
下面是无任何外部第三方依赖的单文件纯 TypeScript 实现,包含空间声场节点装配、GPU 归约数据消费与粒子音频同步:
export interface SpatialAudioParticleConfig {
sampleRate?: number;
initialVolume?: number;
}
export class GpuSpatialAudioBridge {
private audioCtx!: AudioContext;
private pannerNode!: PannerNode;
private noiseNode!: AudioBufferSourceNode;
private filterNode!: BiquadFilterNode;
private gainNode!: GainNode;
private isAudioRunning: boolean = false;
// 接收自 GPU 计算着色器归约出的质心与能量数据
private clusterCentroid: Float32Array = new Float32Array(4); // x, y, z, kineticEnergy
constructor() {
// 延迟到用户首次交互时初始化 AudioContext (遵守浏览器自动播放策略)
}
public async resumeAudio(): Promise<void> {
if (!this.audioCtx) {
this.initAudioGraph();
}
if (this.audioCtx.state === 'suspended') {
await this.audioCtx.resume();
}
this.isAudioRunning = true;
}
private initAudioGraph(): void {
const AudioContextClass = window.AudioContext || (window as any).webkitAudioContext;
this.audioCtx = new AudioContextClass();
// 1. 创建听者 (AudioListener)
const listener = this.audioCtx.listener;
// 默认听者位于原点 (0, 0, 0),面朝正前方 -Z 轴
if (listener.positionX) {
listener.positionX.value = 0;
listener.positionY.value = 0;
listener.positionZ.value = 0;
listener.forwardX.value = 0;
listener.forwardY.value = 0;
listener.forwardZ.value = -1;
listener.upX.value = 0;
listener.upY.value = 1;
listener.upZ.value = 0;
}
// 2. 创建 3D 空间声像平移器 (PannerNode)
this.pannerNode = this.audioCtx.createPanner();
this.pannerNode.panningModel = 'HRTF'; // 最高级双耳耳廓算法
this.pannerNode.distanceModel = 'inverse';
this.pannerNode.refDistance = 1.0;
this.pannerNode.maxDistance = 1000.0;
this.pannerNode.rolloffFactor = 1.2;
// 3. 创建由粉红/粉噪波构成的粒子风切声源 (Pink Noise Buffer)
const bufferSize = this.audioCtx.sampleRate * 2;
const noiseBuffer = this.audioCtx.createBuffer(1, bufferSize, this.audioCtx.sampleRate);
const output = noiseBuffer.getChannelData(0);
let b0 = 0, b1 = 0, b2 = 0, b3 = 0, b4 = 0, b5 = 0, b6 = 0;
for (let i = 0; i < bufferSize; i++) {
const white = Math.random() * 2 – 1;
b0 = 0.99886 * b0 + white * 0.0555179;
b1 = 0.99332 * b1 + white * 0.0750759;
b2 = 0.96900 * b2 + white * 0.1538520;
b3 = 0.86650 * b3 + white * 0.3104856;
b4 = 0.55000 * b4 + white * 0.5329522;
b5 = -0.7616 * b5 – white * 0.0168980;
output[i] = b0 + b1 + b2 + b3 + b4 + b5 + b6 + white * 0.5362;
output[i] *= 0.11; // 适度音量
b6 = white * 0.115926;
}
this.noiseNode = this.audioCtx.createBufferSource();
this.noiseNode.buffer = noiseBuffer;
this.noiseNode.loop = true;
// 4. 创建动态低通共振滤波器 (模拟风速开合)
this.filterNode = this.audioCtx.createBiquadFilter();
this.filterNode.type = 'lowpass';
this.filterNode.frequency.value = 400; // 基础频率 400Hz
this.filterNode.Q.value = 3.0; // 适度共振峰
// 5. 主音量增益节点
this.gainNode = this.audioCtx.createGain();
this.gainNode.gain.value = 0.6;
// 6. 串联音频拓扑链路:Noise -> Filter -> Panner -> Gain -> Destination
this.noiseNode.connect(this.filterNode);
this.filterNode.connect(this.pannerNode);
this.pannerNode.connect(this.gainNode);
this.gainNode.connect(this.audioCtx.destination);
this.noiseNode.start();
}
/**
* 消费 WebGPU 归约输出的质心坐标与能量,毫秒级驱动空间声场
*/
public updateFromGpuCentroid(x: number, y: number, z: number, energy: number): void {
if (!this.isAudioRunning || !this.pannerNode) return;
const currentTime = this.audioCtx.currentTime;
// 1. 无平滑跳跃地更新 3D 空间声源坐标 (利用 AudioParam 固有线性过渡)
if (this.pannerNode.positionX) {
this.pannerNode.positionX.setTargetAtTime(x, currentTime, 0.03);
this.pannerNode.positionY.setTargetAtTime(y, currentTime, 0.03);
this.pannerNode.positionZ.setTargetAtTime(z, currentTime, 0.03);
} else {
(this.pannerNode as any).setPosition(x, y, z);
}
// 2. 将粒子集群的总动能动态映射为声音明亮度(滤波截止频率)
// 能量越高,风切声越尖锐清脆 (400Hz ~ 3200Hz)
const targetFreq = Math.max(300, Math.min(4500, 400 + energy * 80));
this.filterNode.frequency.setTargetAtTime(targetFreq, currentTime, 0.05);
// 3. 动态微调整体响度
const targetGain = Math.min(1.0, 0.2 + (energy / 50) * 0.8);
this.gainNode.gain.setTargetAtTime(targetGain, currentTime, 0.05);
}
public destroy(): void {
if (this.audioCtx) {
this.audioCtx.close();
}
}
}
性能与异构数据交换调优
结语
在现代沉浸式数字艺术的前沿,单一感官的炫技时代已经悄然终结。
通过 WebGPU 的并行浮点算力与 Web Audio API 的物理空间声学建模,我们打通了硅基显卡与人耳神经之间的感知壁垒。当十万颗璀璨粒子在三维虚空中呼啸而过,伴随着耳畔震撼逼真的空间风切与残响回荡,技术在此刻超越了冰冷的代码,升华为一场直击灵魂的视听全景盛宴。