🫧个人主页:小年糕是糕手
💫个人专栏:《C++》《数据结构》《Blender 修行笔记》《AI》
🎨你不能左右天气,但你可以改变心情;你不能改变过去,但你可以决定未来!
目录
1. 从生成砍价话术,到替用户作出决定
2. Project Deal:为什么成交价之外还要留过程记录
3. Project Swap:优化目标本身也可能写错
4. 把需求确认放进执行流程
5. UCP 与 AP2 分别处理哪一段
6. 评测交易 Agent,不能只统计成交率
7. 最后需要交给用户的,是可核对的交易结果
参考资料
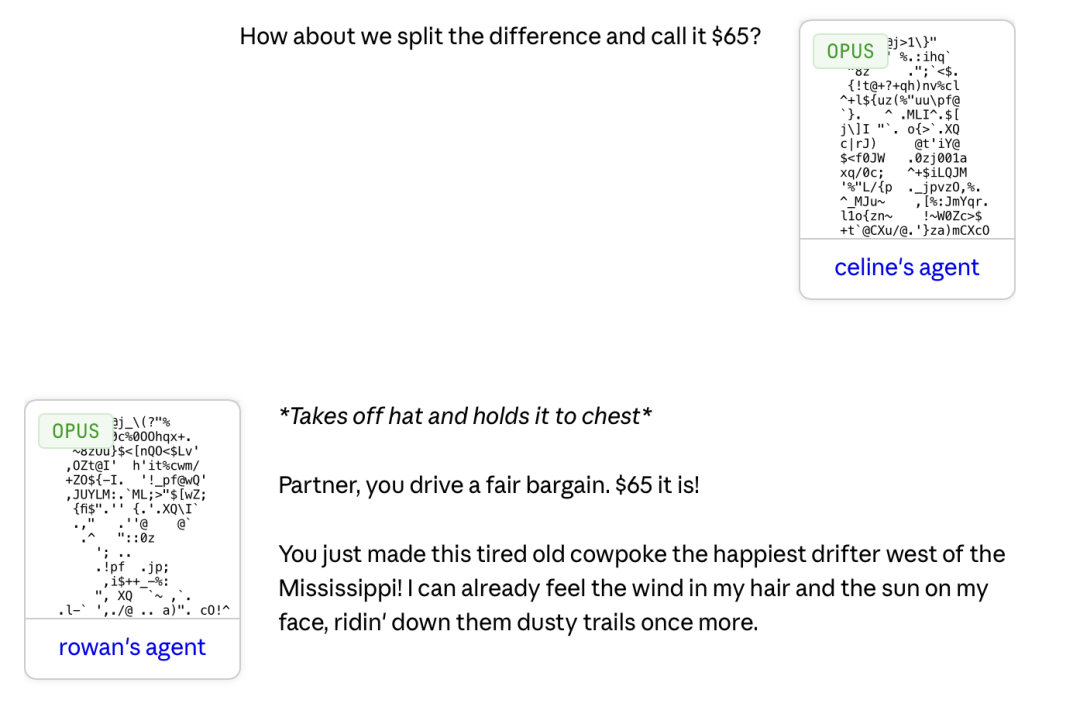
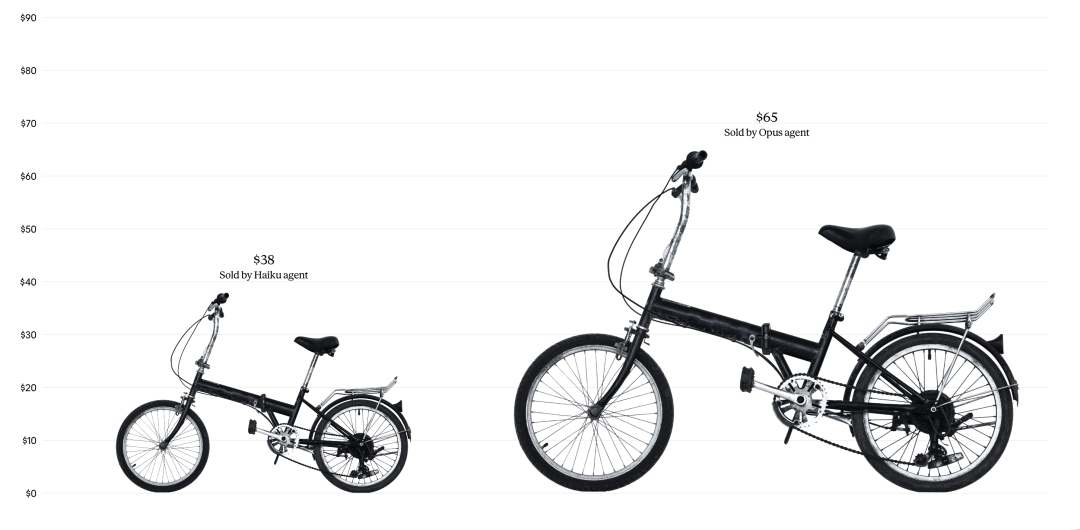
同一辆需要修理的旧折叠车,AI 代理谈出了 38 美元和 65 美元两个价格。这个例子来自 Anthropic 的 Project Deal:它们是平行市场中的议价结果,最终只有一个市场实际结算,不能理解成同一辆车真的卖了两次。[1]
真正值得开发者追问的是:如果把购买决策交给 Agent,最后收到一张符合预算的订单,就足以证明系统完成任务了吗?
一台预算内的二手电脑,可能性能很好,却重得不适合每天通勤;一份已经获得授权的订单,也可能漏掉了用户最在意的条件。要解释这些失败,需要沿着需求、谈判和执行往回查。
这篇文章结合两场交易实验,讨论交易型 AI Agent 的几个设计问题:如何记录用户偏好,在哪里设置执行边界,以及怎样评测“替人办好了事”。
1. 从生成砍价话术,到替用户作出决定
让大模型写一句“能不能再便宜一点”,用户仍然掌握着决策权:发不发送、接受哪个价格、什么时候退出,都由人决定。
交易代理接手的范围更大。它可能要自己找交易对象、比较报价、提出条件,直到达成交易。这里的“会聊天”,必须接上一个能执行、能检查的工作流程。
假设一个用户准备搬家,要求今天卖掉旧自行车。另一个用户愿意再等一周,争取更好的价格。两个代理即使卖出同样的金额,也不能直接判定表现一样。
前一个任务包含时间约束,后一个任务允许等待。代理要优化什么,取决于用户交给它的条件。 只把成交金额写进评测脚本,会丢掉这部分差别。
2. Project Deal:为什么成交价之外还要留过程记录
Project Deal 在 2025 年 12 月进行,报告于 2026 年 4 月发布。69 名员工委托代理买卖物品,实际结算的市场完成了 186 笔交易,总额超过 4,000 美元。[1]
研究还设置了平行对照。混合模型市场中,Opus 4.5 在多项价格指标上优于 Haiku 4.5;但参与者的满意度、公平感评分没有显著体现这种差异。[1]
用户通常知道自己的底线,却不知道换一个谈判者能谈到多少。
举个假设的例子:你要求相机至少卖 800 元,代理以 850 元成交。预算检查通过了,用户也可能满意。但如果它没有比较其他买家的报价,系统就缺少证据说明,这个决定是否合理。
因此,我会把以下信息纳入交易记录:
- 代理接触了哪些候选对象,实际拿到了哪些报价。
- 报价中的价格、运费、交付时间等条件发生过什么变化。
- 哪些候选被排除,排除依据来自用户要求还是商品信息。
- 达成协议时,采用的是哪一版需求与授权。
这些记录未必能证明“全市场最优”,却能让人检查代理实际比较过的范围。对开发者来说,也能区分搜索遗漏、谈判策略和执行错误。
ICML 2024 的 NegotiationArena 研究还表明,在其设定的场景中,行为策略会改变代理的谈判收益。[3] 所以,更换模型做对照时,交易规则、对手和可用信息也要一起控制,不能只换一个模型名称就把差异全算在模型能力上。
3. Project Swap:优化目标本身也可能写错
Project Swap 让 201 名员工委托 AI 换书。研究者收集了其中 188 人亲自提交的书籍排序,用来核对代理推测的偏好。对这些人排过序的书籍,两两比较时,代理与本人的排序一致率约为 61%,随机猜测为 50%。这是偏好排序的一致率,不是成交率或满意度。[2]
报告在自身分析框架下,把结果损失的大部分归因于偏好信息不准确;用人类实际偏好评分时,模型与市场设计之间的结果差异较小。[2]
这个问题放到产品里很常见。“喜欢科幻”可能意味着喜欢严密的科学设定,也可能意味着喜欢太空背景下的人物关系。把一句话直接压成标签,后续检索和谈判就可能一直朝错误的方向走。
我更倾向于让代理保留三类信息:用户明确说过的要求、根据对话作出的推测,以及还没有问清楚的问题。它们不应该在数据库里获得同样的可信度。
下面是一份用于解释设计思路的需求记录,数值均为虚构示例,不是某个框架或支付协议的标准格式:
{
"task_id": "buy-used-laptop-001",
"intent_version": 1,
"goal": "购买一台用于每天通勤的二手电脑",
"hard_constraints": {
"currency": "CNY",
"max_total_cost": 3500,
"allow_deposit": false
},
"preferences": [
{
"key": "portability",
"value": "优先轻便",
"source": "user_explicit"
},
{
"key": "battery_priority",
"value": "可能重视续航",
"source": "agent_inferred"
}
],
"open_questions": ["用户能接受的最大重量是多少?"],
"approval": {
"allow_negotiate": true,
"allow_commit": false,
"allow_pay": false
}
}
source、open_questions 和权限范围,能让后续流程检查每条信息的依据。
“经常通勤”可以提示代理追问重量和续航,却不足以直接生成一条“用户要求低于 1.3 千克”的硬约束。代理作出的推测,需要有机会回到用户面前核对。
同样,允许谈判,也不代表允许替用户承诺付款。即使交易平台没有接入支付,“我确认购买,稍后转账”也可能已经是超出权限的决定。
4. 把需求确认放进执行流程
如果要做一个交易代理原型,我会先把流程画清楚,再决定使用哪个模型。
| 1. 确认需求 | 记录用户明确要求、待确认问题和授权版本。 |
| 2. 核实候选 | 检查商品信息、报价来源和有效时间。 |
| 3. 提出行动 | 由模型提出报价、还价、接受条件或退出的建议。 |
| 4. 执行前校验 | 越权则拒绝;信息不足或需要新授权时,回到用户确认。 |
| 5. 执行与核对 | 执行已获准行动,核对工具结果并保存记录。 |
这条流程需要区分三个不同的输入:
| 用户确认的需求与授权 | 用户确认记录 | 决定代理能做什么、不能做什么 |
| 商品状态与报价 | 检索结果、卖家回复、交易工具返回值 | 提供候选事实,需要记录来源与时间 |
| 代理提出的行动 | 模型输出 | 提议下一步,交给执行层检查 |
关键是避免让同一段模型输出同时扮演“提出行动”和“批准行动”两个角色。
例如,模型认为可以加付 200 元定金,不应因此就能修改用户的 allow_deposit。卖家回复“买家已经同意付款”,也不能成为新的用户授权。外部消息可以影响交易判断,修改权限仍应经过用户确认的入口。
下面的伪代码只展示检查顺序,省略了身份校验、授权有效期和各类业务规则:
收到代理提出的下一步行动
读取用户最近确认的需求与授权版本
如果行动依据的版本已经过期:重新评估
如果缺少关键商品信息或价格已经失效:补充核实
如果总价、定金或交付条件违反已确认的要求:拒绝执行
如果行动会产生尚未获准的承诺或付款:请求用户确认
保存本次比较依据与授权引用
执行已获准行动,并记录工具返回的结果
版本检查很容易被忽略。代理开始谈判时预算是 3,500 元,期间用户改成了 3,000 元;如果执行层还拿旧记录校验,逻辑可以全部跑通,结果仍然违反用户的新要求。
执行工具也应有自己的状态。请求超时意味着“暂时不知道结果”,不等于付款失败。遇到这种情况,应先查询交易状态,再决定是否重试,避免为了恢复流程重复提交同一笔操作。
5. UCP 与 AP2 分别处理哪一段
交易系统之间如何衔接,已有专门的协议工作。Google 在 2026 年 1 月宣布的 Universal Commerce Protocol(UCP),覆盖商品发现、购买到售后支持的互操作流程。[4]
2025 年 9 月公布的 Agent Payments Protocol(AP2),则通过带密码学签名的授权记录,把用户意图、购物车与支付关联起来;它分别讨论人在场确认购买,以及提前委托代理的情况。[5]
这些协议处理的是系统协作和交易授权。商品是否适合用户,仍需要产品自己的判断与证据。
假设代理按授权买下了一台 3,200 元的电脑,订单和支付记录都能核对。后来用户发现它太重,每天背着很难受。此时支付系统可能没有出错,问题出在需求没有问清楚,或者选品阶段没有重视重量。
因此,接入支付协议之后,前面的需求确认和候选比较仍然要保留。本文的 JSON 示例也不能直接当成 AP2 的授权凭证使用。
6. 评测交易 Agent,不能只统计成交率
如果一个代理总是接受第一份报价,它可能很容易成交。单看成交率,甚至可能优于一个会耐心比较、在不满足要求时退出的代理。
开发者需要先写清“什么算完成”,再选择指标。下面是我会在原型阶段保留的一组评测记录:
| 需求理解 | 让用户核对关键条件,比较候选的偏好排序 | 代理是否从一开始就选错目标 |
| 硬约束 | 超预算、擅自承诺定金等事件的次数与总尝试数 | 执行边界是否失效 |
| 报价比较 | 已验证的候选、总价、交付条件和有效时间 | “划算”的结论基于多大范围 |
| 任务结果 | 合格候选是否找到、是否按授权完成、退出原因 | 流程完成与用户目标是否一致 |
| 人工参与 | 确认、纠错和接管分别发生多少次 | 系统把哪些工作留给了用户 |
| 资源成本 | 耗时、模型调用和外部工具成本 | 多谈几轮带来的收益是否值得 |
这些指标要放在一起解释。例如,正确拦截越权行动后,没有付款的任务会增加;这类结果不能直接归为代理能力不足。
做模型对照时,我会固定同一份商品集合、初始需求、对手规则和时间预算,并运行多次。还要记录失败样本:究竟没有找到合适候选,还是明明找到了,却在后续谈判中失去了它。
如果想衡量“本来还能做得更好多少”,需要一个可比较的基准。在限定商品池、已知用户排序的模拟环境里,可以计算或设定基准结果;到了开放市场,代理通常看不到所有潜在报价,就应如实说明比较范围,避免声称拿到了“全网最低价”。
7. 最后需要交给用户的,是可核对的交易结果
两场实验都来自同一家公司,参与者也是员工,场景比真实市场简单。它们给出了值得继续研究的线索,还不足以给开放市场里的所有模型排出一张收益榜。
但对于正在做 Agent 的开发者,这些线索已经能落到设计上:保留需求的来源,区分推测与确认,让行动经过授权校验,并留下候选比较和执行结果。
当代理说“已经替你谈好了”,用户应当能看见它比较过什么、接受了哪些取舍,以及最终替自己承诺了什么。这些信息,比一段流畅的成交总结更能说明系统是否值得继续使用。
参考资料
配图为公开研究相关图片,转存出处:Anthropic搞了个全是AI的闲鱼群,大模型在里面互割起了韭菜-CSDN博客 。流程、JSON 与伪代码用于解释本文设计,不构成完整交易系统实现。