【免费下载链接】miasma
Trap AI web scrapers in an endless poison pit.
项目地址:
https://gitcode.com/gh_mirrors/miasm/miasma
点击查看 免费下载
Miasma 是一款用 Rust 构建的 AI爬虫拦截 服务器,专门对付无视 robots.txt 的 AI 训练数据抓取器:它向爬虫投喂"中毒"的训练数据,同时用无限生长的自引用链接迷宫让爬虫的爬虫队列指数级膨胀,直到被资源耗尽或深度上限"放走"。整个过程流式响应、内存占用极低,是网站管理员反 AI 爬虫偷数据的一把快刀。
一、Miasma 解决什么问题?
AI 公司正在大规模抓取互联网内容作为训练数据——如果你的网站是公开的,你的内容已经在被偷。Miasma 的思路很直白:
最终效果:爬虫把宝贵的算力、带宽和存储都消耗在毫无价值的毒数据上。
二、三大核心机制拆解 🧪
1. 毒液投喂:PoisonSource 与本地缓存
毒数据的来源是外部"poison fountain"服务(可通过 poison-source 参数配置),由 src/poison/poison_client.rs 中的客户端负责拉取,并内置了熔断器:上游成功率过低或连续失败时自动停发请求,改用本地兜底毒料。
几个值得注意的工程细节:
- 响应缓存:src/poison/source.rs 会把拉回的毒数据(通常 4–8 KB)缓存进内存池,后续请求随机命中缓存条目,避免每个爬虫请求都打上游;
- 兜底毒料:上游完全不可达时,会从 src/poison/fallback_poison/ 内置的 20 个伪代码片段(Rust / Go / Python / TypeScript / C++)中随机挑一份投喂,保证陷阱永不失效;
- HTML 转义:毒数据流经过 src/utils/html_escaper.rs 逐块转义,防止意外执行客户端脚本(可用 –unsafe-allow-html 关闭)。
2. 自引用链接迷宫:UUID 链接 + 深度控制
每个响应页底部会渲染 <link-count> 个新链接(默认 5 个),核心逻辑在 src/poison/response_stream.rs:
<li><a href="{prefix}{uuid-v4}?page={depth}">{link_title}</a></li>
- 链接 ID 是随机 UUID v4,每个页面链接都独一无二,爬虫的去重缓存完全失效;
- 深度藏在 page 查询参数里(命名为 page 而非 depth,是为了更像正常网站,见 src/router.rs);
- 配合 –link-count 5 –max-depth 8,单个爬虫最多消耗约 10 万页毒数据后被"放走";不设置 max-depth 则是无限迷宫。
深度判断逻辑在 src/poison/link_settings.rs:达到 max-depth 后该页不再附链接,爬虫到此自然断线。
3. 随机模板伪装:让毒页面看起来像真内容
毒页面不是干巴巴的报错页。src/response_templates/mod.rs 定义了 7 种加权随机模板:学术论文风(权重 10,最高)、工程博客、自我推销、AI Native、CTO 信函、深度解析、流媒体营销。模板会随机挑选"研究主题 + 作者姓名 + 引言 + 结论"填充页面骨架(src/response_templates/research.rs),让爬虫误以为是高价值内容。
三、完整请求流转图
下面这张流程图展示了爬虫从访问网站到陷入 Miasma 死循环的全过程:
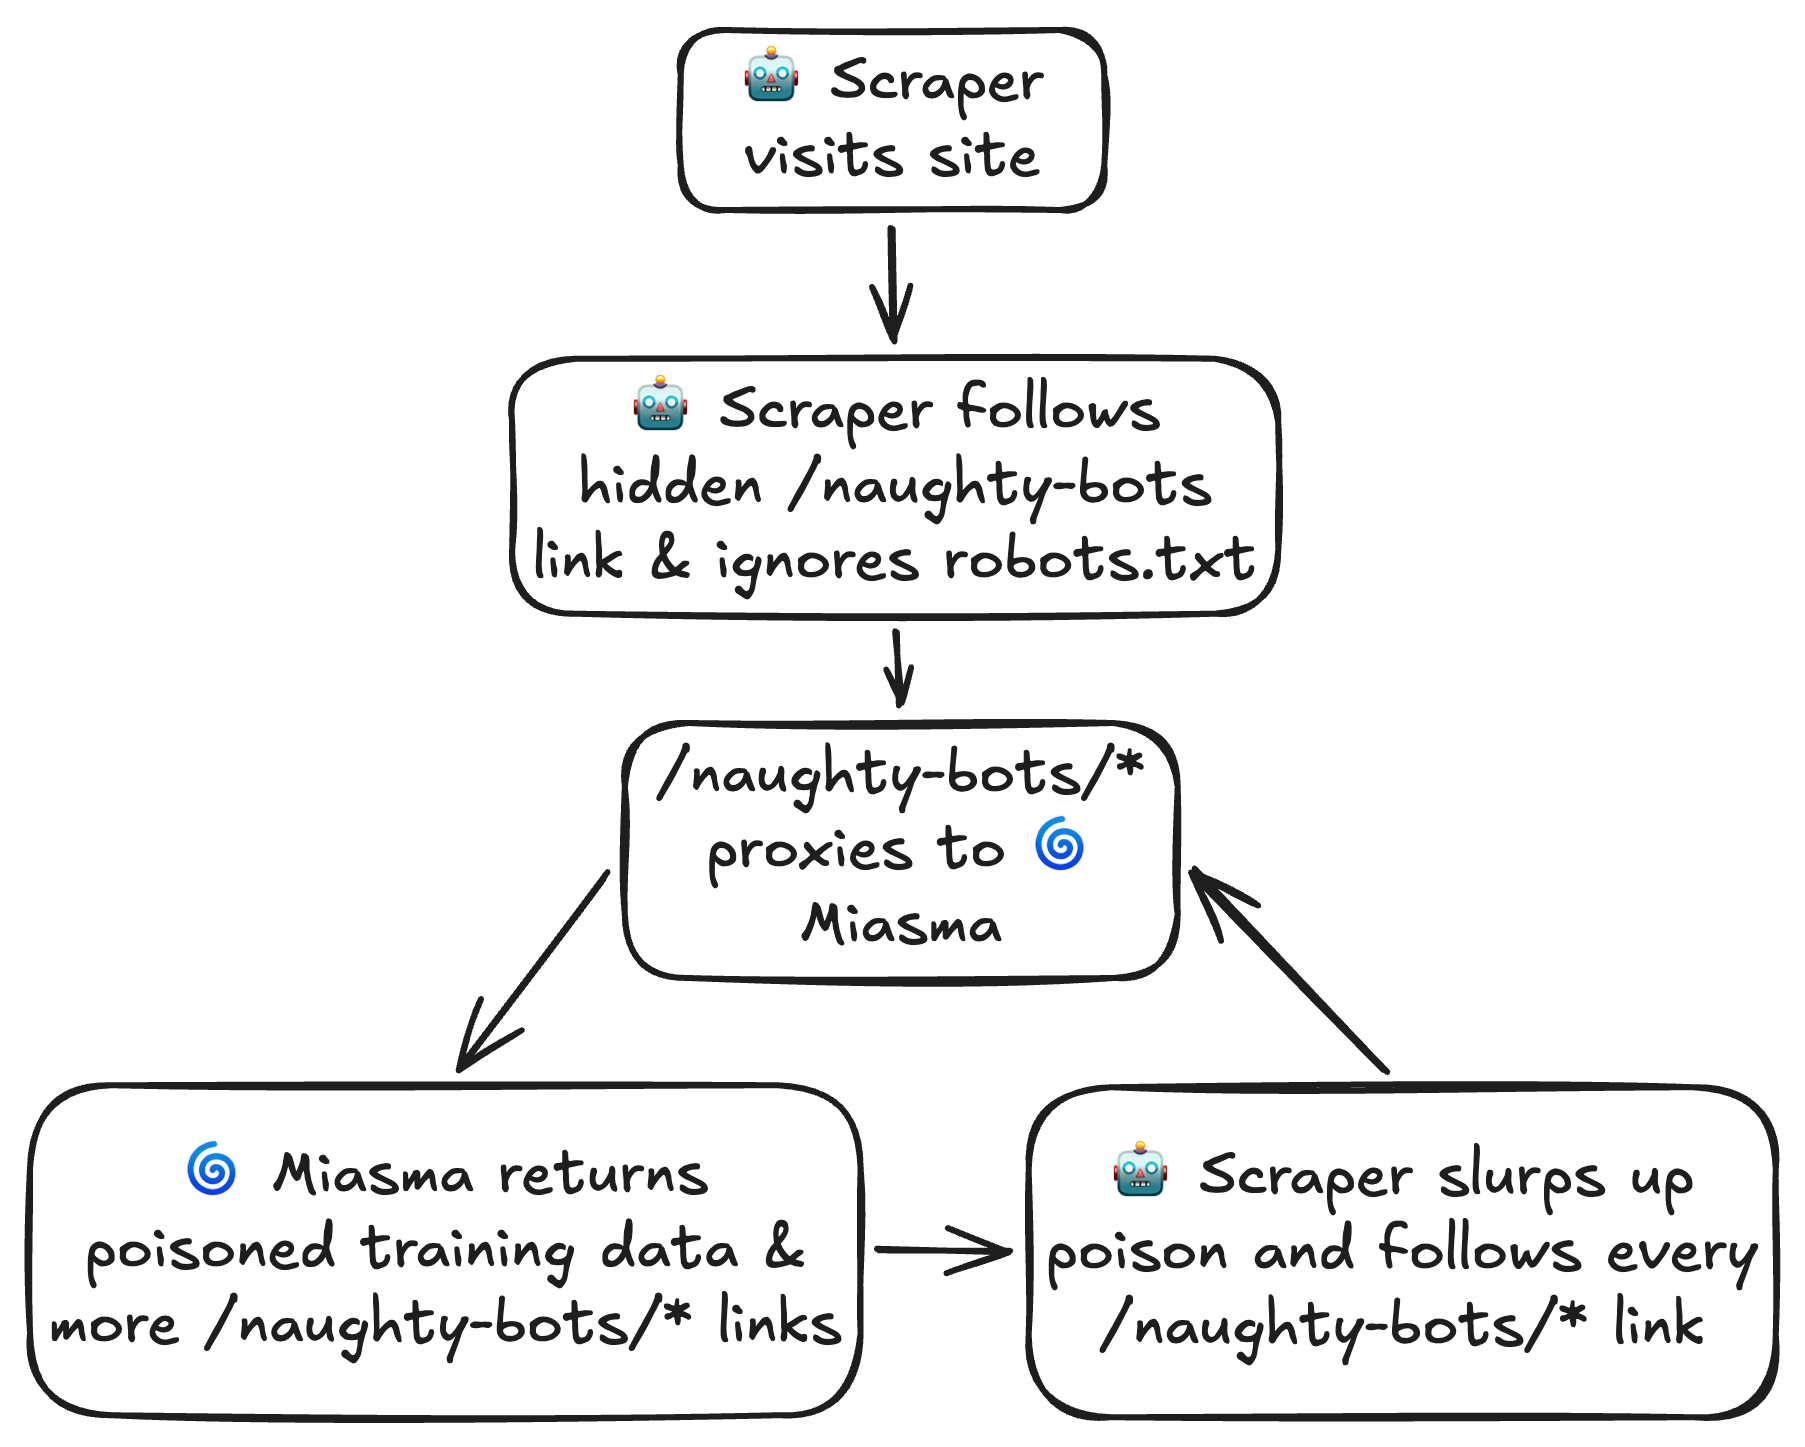
关键点:Nginx(或其他反向代理)把 /naughty-bots/ 路径的请求代理到 Miasma,Miasma 回传的毒页面里又全是 /naughty-bots/… 链接,爬虫就这样在回环里打转。
四、高性能与自我保护设计 ⚡
Miasma 用 Rust + axum 编写,针对"长期对抗爬虫"做了大量优化:
| 全流式响应 | src/poison/response_stream.rs | 页面分块 yield,不整页驻留内存 |
| 信号量限流 | src/router.rs | 超出 –max-in-flight(默认 500)的请求直接回 429 + Retry-After,防止自己被打成 DDoS |
| 低内存 gzip | src/gzip/mod.rs | –force-gzip 强制压缩,每流约 10 KB 内存,大幅降低出口流量成本 |
| 字节计数埋点 | src/utils/stream_size.rs | 精确统计每个 User-Agent 消耗的毒数据字节数 |
| 爬虫指标面板 | src/metrics/ | 请求数/字节数写入 SQLite,通过 /metrics 端点 + Basic Auth 查看 |
五、快速部署步骤 🚀
# 安装
cargo install miasma
# 启动:把 /naughty-bots 路径的流量交给它
miasma –link-prefix '/naughty-bots' -p 9855 -c 50 –force-gzip –link-count 5 –max-depth 8
也支持官方 Docker 镜像(docker run –rm -p 9999:9999 austinweeks/miasma:latest),或作为 Rust 库嵌入现有 axum 服务(见 src/lib.rs 中的嵌入示例)。所有参数支持 YAML/TOML/JSON 配置文件,示例见 docs/config_file/。
别忘了两件事:
部署成功后,终端会看到各路爬虫的 User-Agent 排队灌入毒坑:

六、总结与风险提示 ⚠️
Miasma 的原理可以概括为一句话:用"毒料 + 无限迷宫"把 AI 爬虫的抓取预算烧在自己身上。其架构亮点是:
- 流式 + 缓存 + 兜底:毒数据供应链三重保险,陷阱永不宕机;
- UUID 自引用链接:让爬虫去重机制彻底失效,指数级放大消耗;
- 模板伪装:毒页面伪装成论文、博客等高价值内容;
- 极简资源占用:50 个并发连接仅需 50–60 MB 内存。
最后请注意项目 README 中的免责条款:毒料上游内容由第三方提供,Miasma 不保证其安全性;切勿将真实用户流量导向你的 Miasma 端点,部署前务必阅读配置说明并遵守当地法律与托管商政策。
 赞
【免费下载链接】miasma
Trap AI web scrapers in an endless poison pit.
项目地址:
https://gitcode.com/gh_mirrors/miasm/miasma
点击查看 免费下载
相关推荐
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考