/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
▍同一个模型,一半的内存,4%的成本
10月15日,Meta发布开放权重模型Muse Spark Open:总参数816B、每次推理激活42B的MoE架构,支持100万 token 上下文,权重分BF16与NVFP4两个版本挂在Hugging Face上。
它最出圈的不是能力,而是部署门槛——官方给的自托管路径是4张Blackwell Ultra或8张H200(部署成本400万+);而真正让它刷屏的,是另一套"平民方案":两台搭载M5 Ultra、各配512GB统一内存的 Mac Studio,通过MLX框架跨机协同,凑出约1TB内存,把816B跑了起来。国内每台售价22.9万,综合部署成本58万。
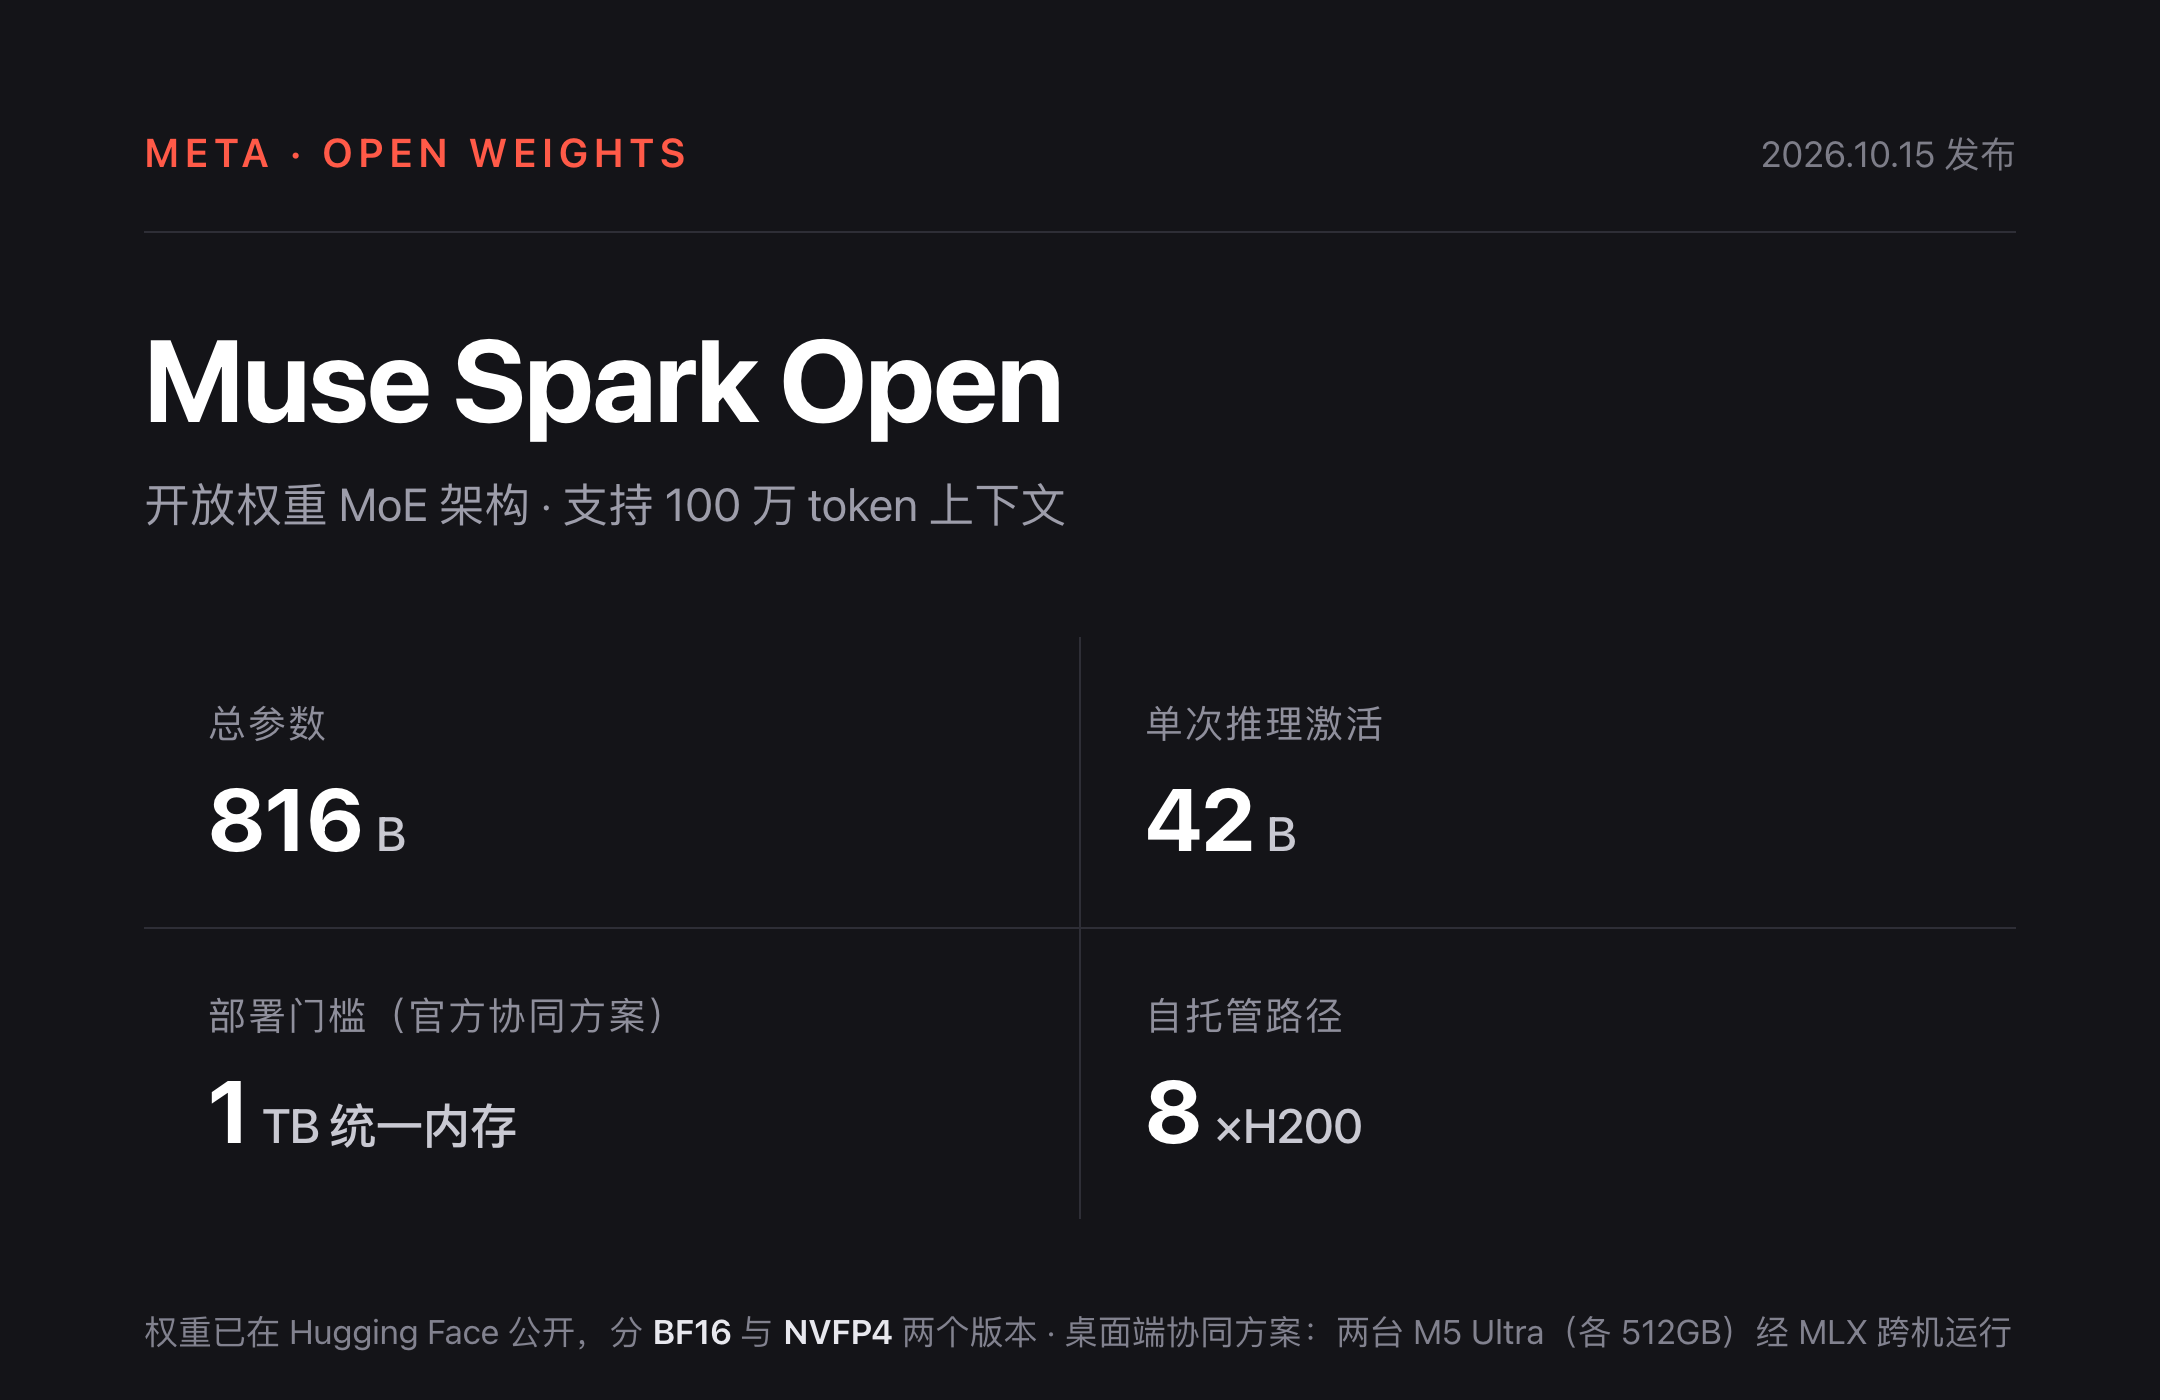
▲ Muse Spark Open 关键参数(据 Meta 公开信息整理)
科技圈在惊叹“816B 能跑在桌面端了”。我们想说另一件事:同一个模型,不需要1TB。
11月2日,2026年世界互联网大会乌镇峰会开幕当天,我们在“互联网之光”博览中心红亭馆发布了四层 SI 基础设施体系。其中伏羲超级计算系统给出的方案是:两台256GB 统一内存的工作站,共512GB,运行816B 参数的Muse Spark Open,推理速度25.5 tok/s;同参数规模的部署成本,由约400万元降至24 万元,降幅93%。
▍内存砍一半,成本砍93%
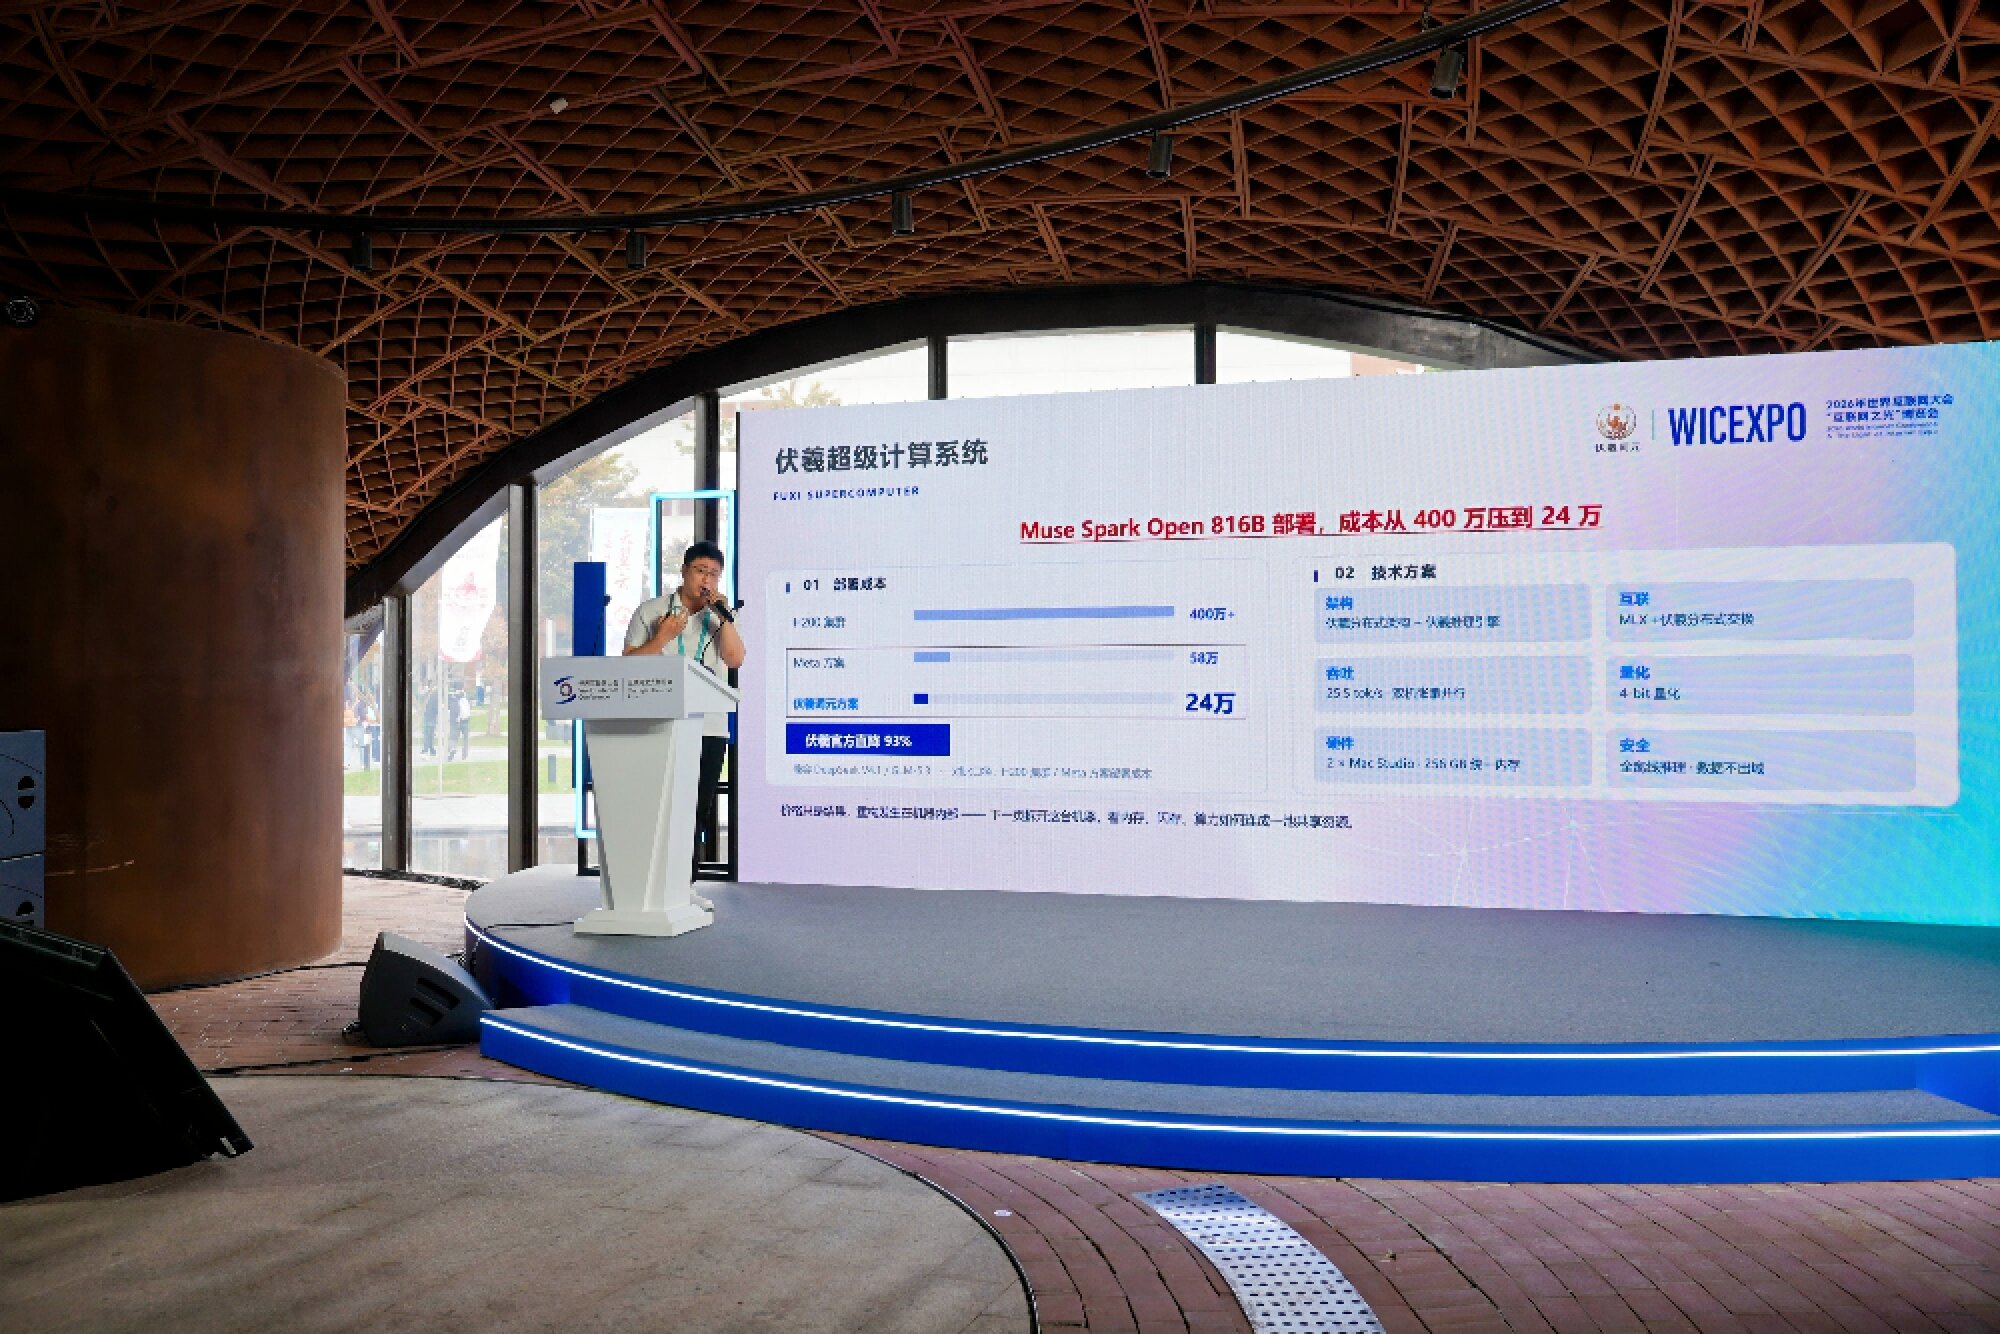
▲ 乌镇互联网之光博览会红亭馆发布会现场:伏羲超级计算系统展板——Muse Spark Open 816B部署,成本从400万到24万
01 先看账本:三个方案的部署成本
把三条路线放在同一张表里,差别一目了然:
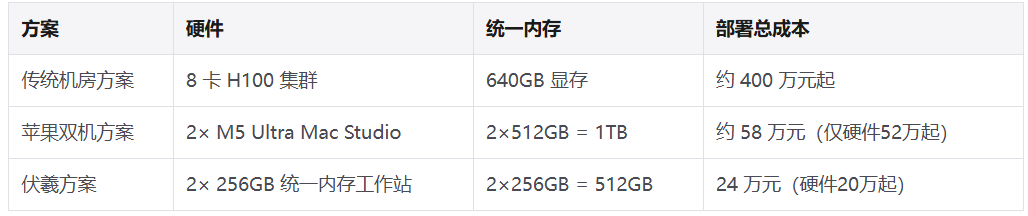
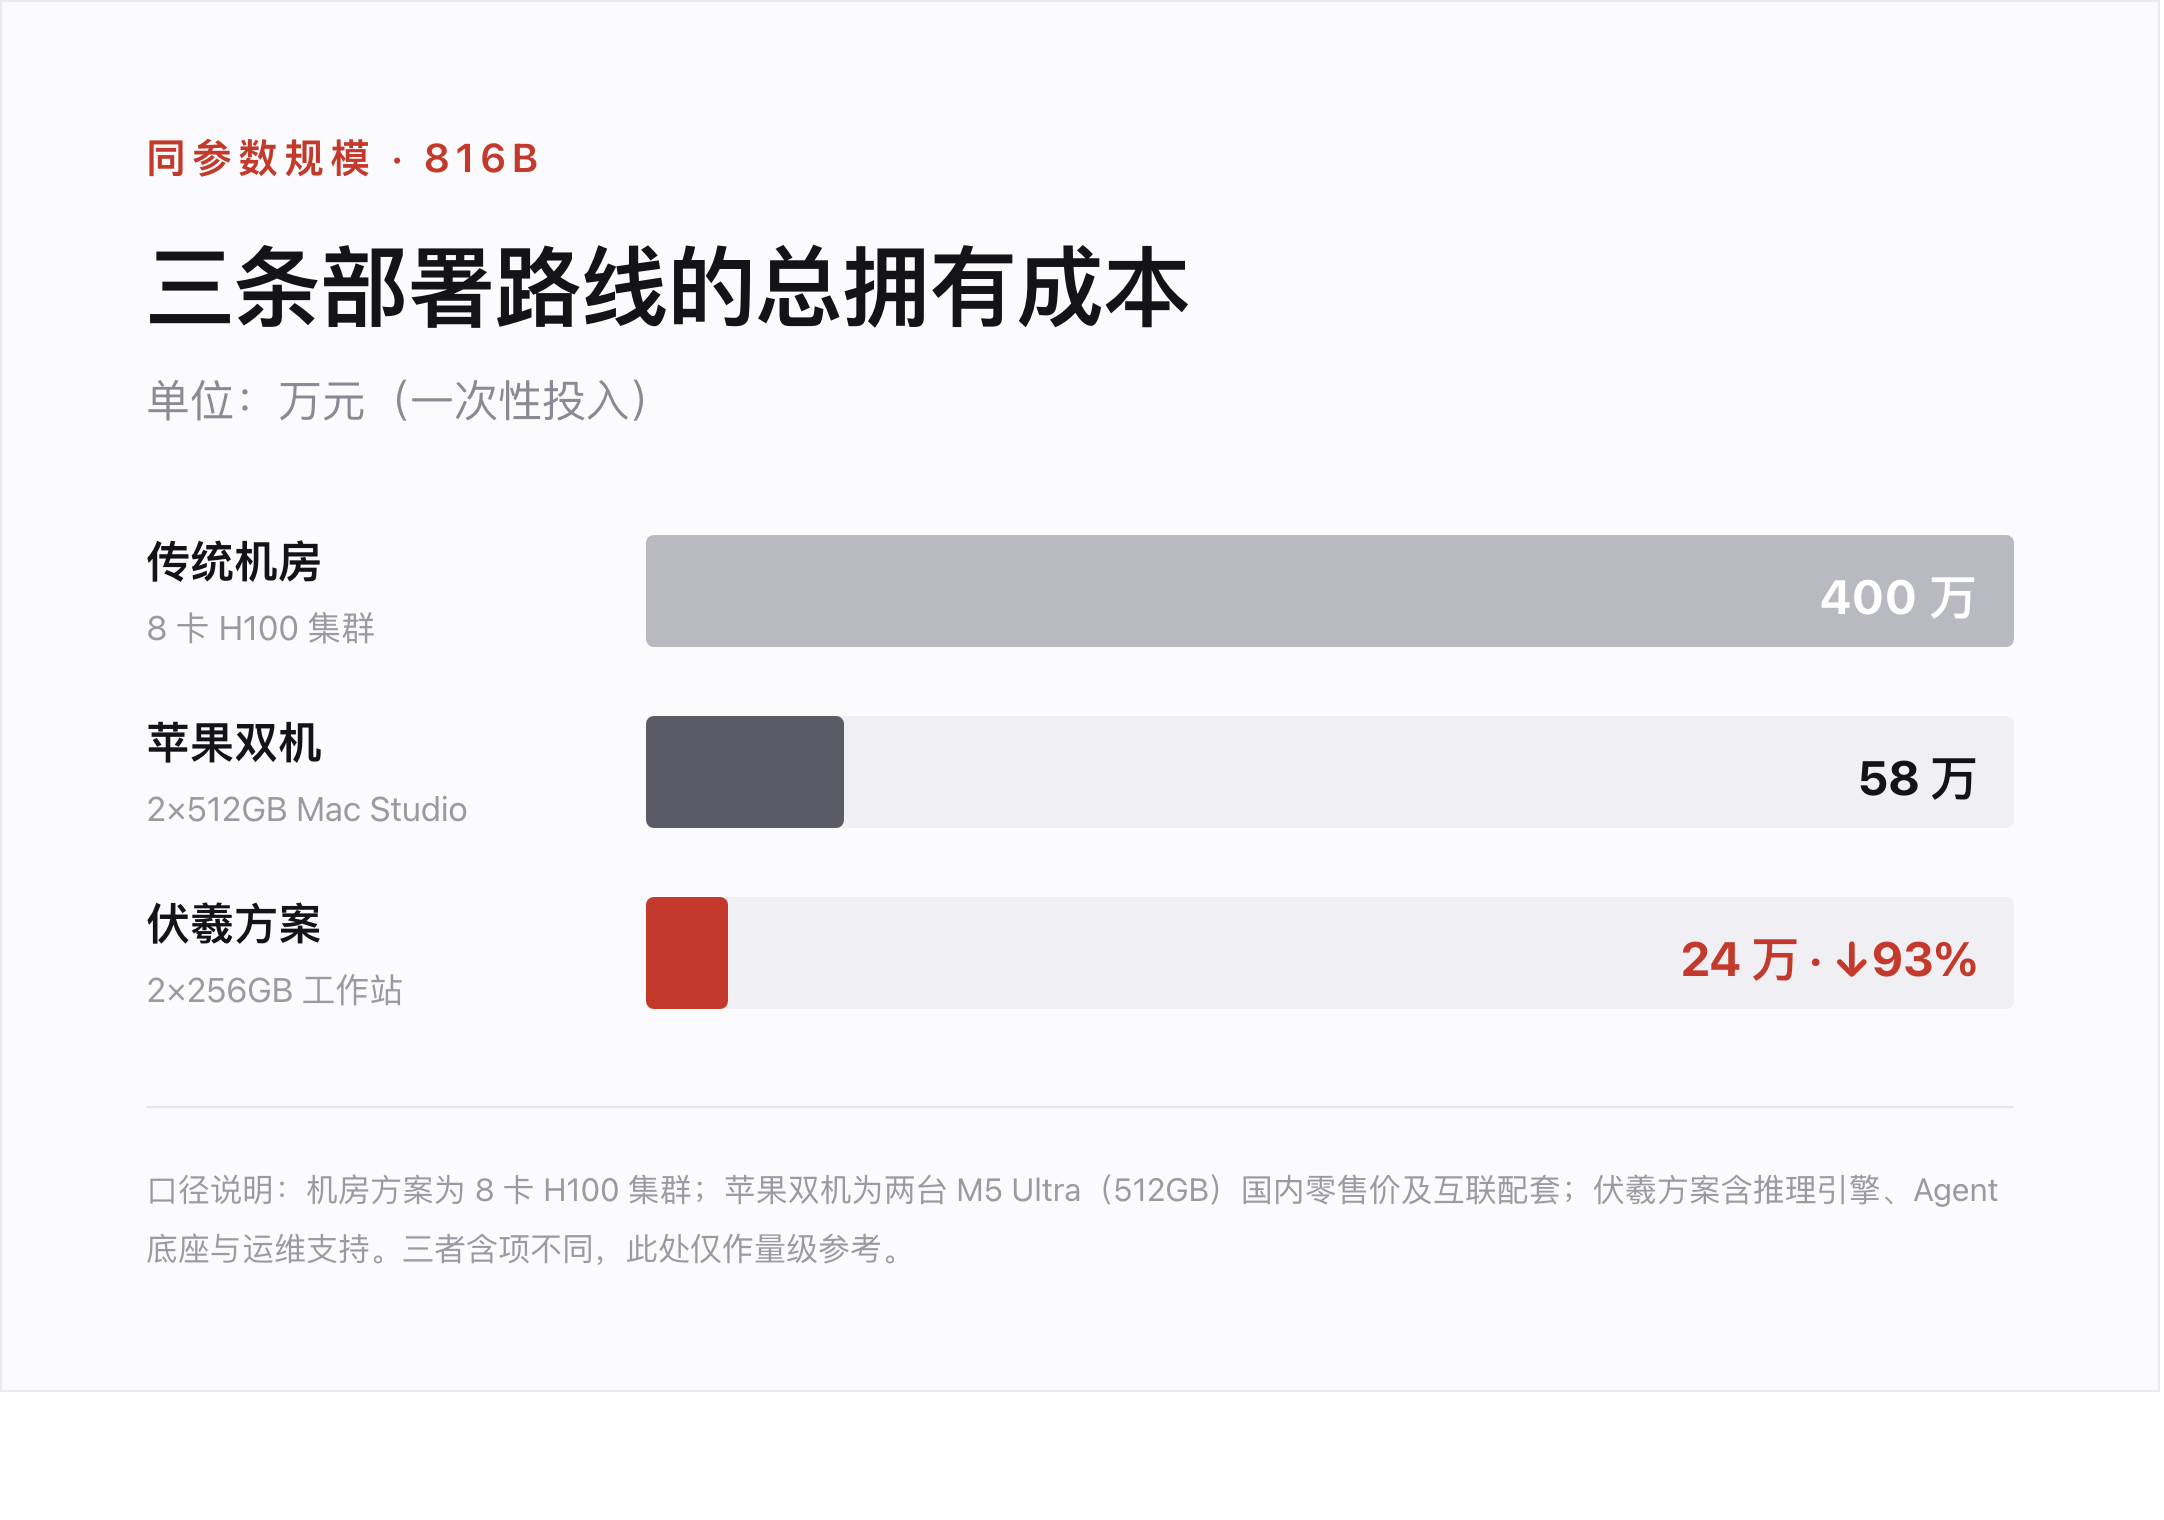
▲ 同参数规模(816B)下,三条部署路线的总拥有成本对比
口径说明:93% 的对比基准是传统8卡H100机房方案的约400万元起。苹果双机的58万元是两台机器官方零售价加价以及其他部分硬件,不含调度软件、量化调优与运维;按国内现货价约25万元起。
换句话说,同样一台“能跑816B”的机器,价差不在硬件上——我们在卖的,是让512GB跑出1TB效果的那层调度。
苹果方案证明了一件事:跑 816B 不一定需要 GPU 机房,这值得尊敬。但它把答案写成了“买更大的内存”——两台顶配Mac Studio 凑 1TB,仅硬件就58万元起步,加上配套投入,距离普通企业仍然不近。
伏羲方案想回答的是另一个问题:1TB里,真正被用到的有多少?
02 瓶颈不是容量,是利用率
一个816B 的 MoE 模型,每次推理只激活42B参数。这意味着,约95%的参数在大部分时间是"沉睡"的。如果按传统思路把权重原样全塞进内存,你确实需要1TB。
但这 1TB 的账,是按"最坏情况"算的。真正的解法不是把内存堆得更大,而是让每一 GB 内存都物尽其用。我们在伏羲超级计算系统里做了最核心的两件事。
第一、让两台 256GB 机器像一台512GB机器一样协同工作,而不是各自为战。权重按层切开分布,两机通过 MLX 分布式通信互联+伏羲分布式架构,对上层模型来说它就是一台"512GB 逻辑机器"。
第二、伏羲推理引擎的弹性缩容时间做到300 秒,行业平均是900 秒——闲时释放、忙时秒级拉起,集群端到端推理性能提升可达35%,接入开销控制在5% 以内。
这两件事做完,512GB就够了。
03 这不只是省了一台机器的钱
对政务、金融、医疗、能源这些"数据不能出域"的行业来说,部署成本每降一个数量级,可落地的场景就多一批。400 万的门槛,把大多数机构挡在本地大模型之外。24 万,意味着一家区级医院、一个地市政务云节点都部署得起。
这也是我们把方案带到乌镇峰会的原因。算力不应该只是巨头的资产,它应该像水和电一样,可计量、可结算、可调度。
行业在比谁的内存更大。我们在比每一 GB 内存能产出多少词元。
内存是成本,调度才是能力。




