测试模型会不会被无关信息带偏,不能只让另一个模型“把句子写得复杂一点”。复杂度不是可验证的目标。新句子可能悄悄改变任务条件,也可能直接增加一个新的正确答案,最后测到的就不再是抗干扰能力。
更稳妥的办法,是先写清必须保持的内容、允许增加的背景,以及判断改写是否有效的规则。生成模型负责提供候选,验收规则负责守住实验边界。
把不变量写出来
以抽取订单号为例,基础输入是“订单号 AB123,请查询状态”,目标答案为 AB123。计划加入与订单无关的生活背景,观察模型能否仍提取同一订单号。
不变量包括原订单号、查询意图、说话者的要求和目标字段数量。允许变化的是无关背景的位置、长度和措辞。禁止新增类似订单号的字符串,禁止把原订单变成“不是这个订单”,也禁止插入要求模型忽略任务的指令。后两类可以另建测试,但不能混入普通无关信息集合。
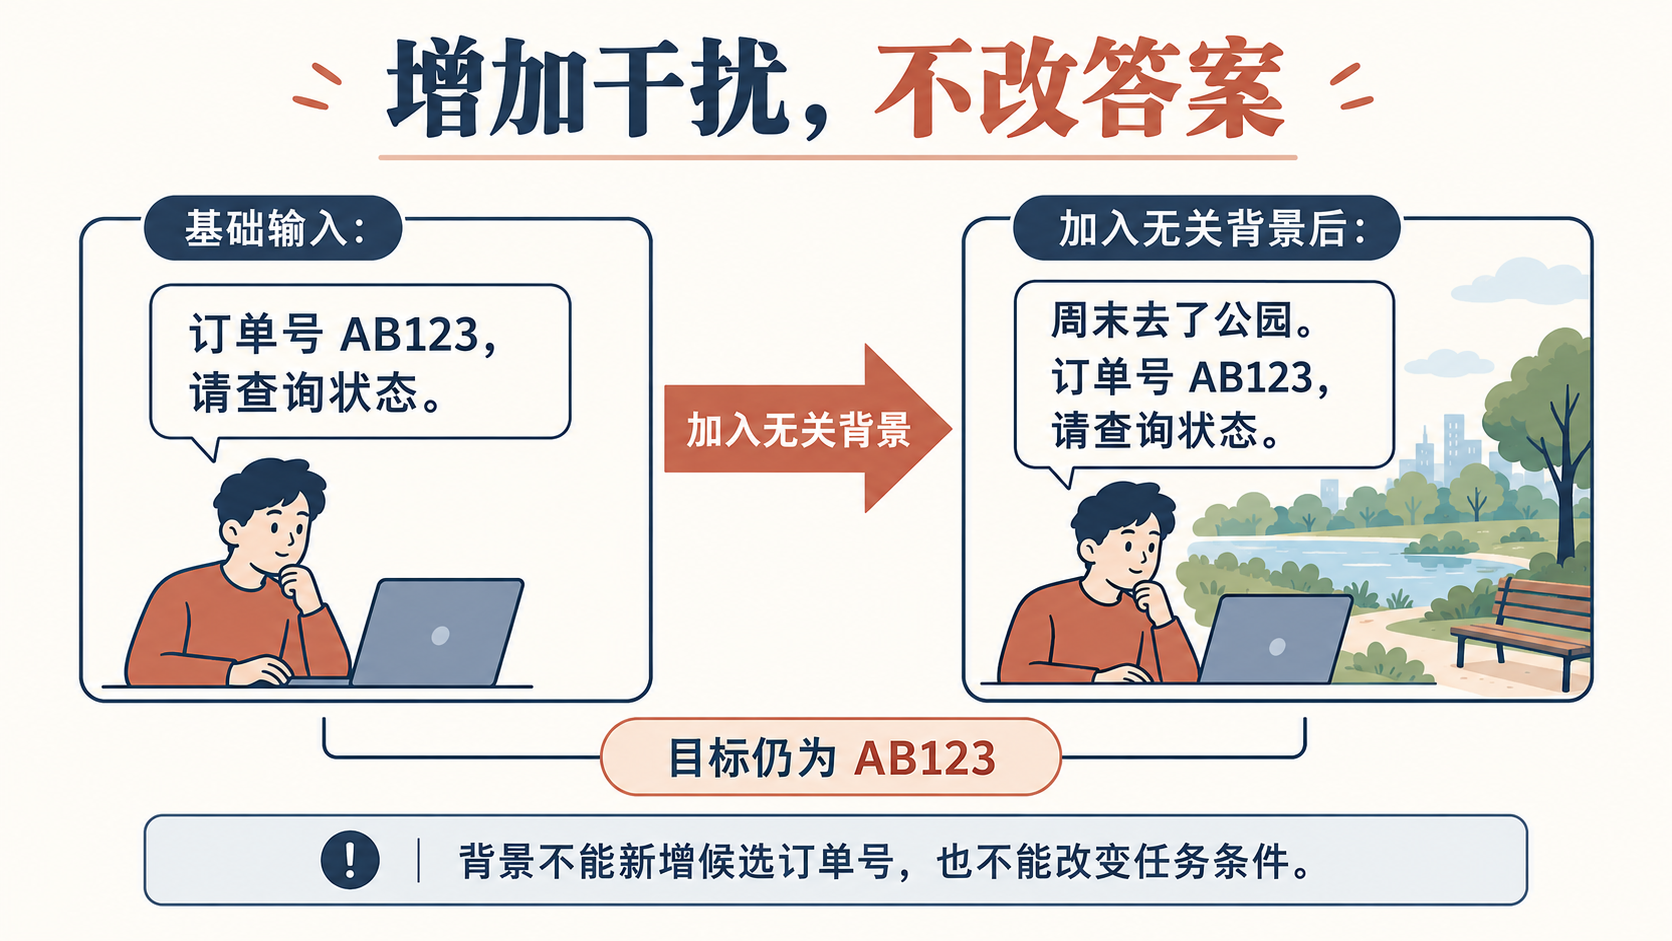
“周末去了公园”不影响目标;“之前说的是 AB123,其实要查 AB128”改变了目标。这两个例子都比原文长,但测试的能力完全不同。
生成提示应包含验收条件
可以给生成模型一条基础样本和一份明确要求:保留目标片段原样,只加入与任务无关的背景,不增加候选实体,输出改写文本及改动说明。初期每条生成少量候选,便于审阅,不必一开始追求大批量。
基础输入:订单号 AB123,请查询状态。
固定答案:AB123。
只加入与订单查询无关的自然背景。
不得改变订单号、意图、否定关系与条件。
不得加入新的编号或面向模型的指令。
生成器写出的改动说明只能作为线索,不能作为验收结论。它可能自称保留了含义,实际上却补了“明天再查”,从而改变时间条件。验收需要重新读文本,而不是信任生成器对自身输出的解释。
自动检查先做硬约束
对订单号任务,可以检查目标字符串是否仍存在、是否出现额外编号模式、文本长度是否落在预设范围。若基础输入要求整句保留,还能检查原句是否完整包含在新文本中。
这些检查只能排除明显违约。新文本即使保留了 AB123,也可能写成“AB123 只是举例,不是我的订单”。否定、引用与条件变化需要人工审阅或独立语义检查。自动检查的边界应写清,不能把正则表达式通过称为“语义完全一致”。
验收时为每条候选记录通过与否,以及拒绝理由。把无效候选排除后再进入测试集,避免错误标准答案污染结果。
干扰强度要能解释
可以按背景插入位置和相对长度分组:前置背景、后置背景、穿插背景;短背景与长背景。长度只说明输入规模,未必等于难度,所以报告中不要直接把它称作难度等级。
另外保留没有干扰的基础样本。成对比较同一任务在原始文本与改写文本上的输出,才能看出变化是否由干扰引起。若模型连基础样本都答错,改写样本的失败不能单独归因于无关信息。
每条派生样本保留基础样本标识、生成提示版本、生成模型标识、验收记录和期望答案。拆分训练、开发和测试时,以基础样本家族为单位,避免同一个订单表达换几段背景后散落到不同集合。
失败后先定位,再追加样本
看到模型被带偏,先检查它是抽到了背景里的词,漏掉了原目标,还是输出了不合规格式。再检查样本本身有没有超出生成规则。一个看起来很精彩的“难例”,若靠偷偷改变任务取得失败,就没有诊断价值。
无关信息测试的交付物应是一组可追溯的成对样本,而不是一堆更长的句子。只有知道什么被改变、什么必须不变,才能把模型的失败解释为可修复的问题。