Kimi K3 2.8T:超稀疏 MoE、百万上下文与真实部署边界(2026)
TL;DR
- 场景:Kimi K3(2.8T 总参数 / Stable LatentMoE 激活 16/896 专家)于 2026-07-17 在 WAIC 2026 前夕发布,采用 Kimi Delta Attention(KDA)混合线性注意力 + Attention Residuals(AttnRes),原生 1M Token 上下文 + 视觉理解,API 缓存命中 $0.30/M、未命中 $3/M、输出 $15/M,编码场景缓存命中率 > 90%,官方推荐 supernode ≥ 64 加速器,完整权重计划 2026-07-27 公开。[S1]
- 结论:K3 不是"一个更大的聊天模型",而是一套需要模型架构、推理基础设施、Agent Harness 和成本控制共同配合的生产系统。2.8T 表示总参数规模,不是每 Token 激活参数、不是权重显存、不是单卡可装、不是可服务吞吐、更不是 Agent 任务成功率。
- 产出:覆盖 5 个被混淆的问题(总参数 vs 激活、4-bit vs 显存、稀疏 vs 通信、缓存 vs 上下文、Harness vs Benchmark)、三种部署路径(官方 API / 托管 Dedicated / 自建 Supernode)、10 步验证顺序、可执行评测框架 YAML 模板,作为生产团队评估"开放权重"开源模型的工程蓝本。
版本矩阵
| Kimi K3 发布时间 2026-07-17(WAIC 2026 前夕) | ✅ 已验证 | Moonshot AI 官方 Blog + 新华社 7-17 报道 + 腾讯新闻 + CSDN 深度解析 |
| 总参数 2.8 万亿(2.8T) | ✅ 已验证 | Moonshot AI Blog 标题 “world’s first open 3T-class model” + 官方标题为 2.8T |
| Stable LatentMoE 激活 16/896 专家 | ✅ 已验证 | Moonshot AI Blog “896 experts / 16 activated” |
| Kimi Delta Attention(KDA)混合线性注意力 | ✅ 已验证 | Moonshot AI Blog + Limitations 段 |
| Attention Residuals(AttnRes)注意力残差 | ✅ 已验证 | Moonshot AI Blog + Moonshot AI GitHub 公开项目 |
| 1M Token 上下文原生支持 | ✅ 已验证 | Moonshot AI Blog 副标题 + API Quickstart |
| 原生视觉理解(native vision) | ✅ 已验证 | Moonshot AI Blog + Benchmark 段 |
| 完整权重计划 2026-07-27 公开 | ✅ 已验证 | Moonshot AI Blog “Availability” 段 |
| API 缓存命中输入 $0.30/M,未命中 $3/M,输出 $15/M | ✅ 已验证 | Moonshot AI Pricing 页 + CSDN 7-18 定价解析 |
| 编码场景缓存命中率 > 90% | ✅ 已验证 | Moonshot AI Blog 报告 |
| 官方推荐 supernode ≥ 64 加速器部署 | ✅ 已验证 | Moonshot AI Blog “Availability” 段 |
| Always-on Thinking + reasoning_effort 可调 | ✅ 已验证 | Moonshot AI Blog Limitations 段 |
| K3 训练在 preserved thinking history mode,Harness 必须完整回传 thinking | ✅ 已验证 | Moonshot AI Blog Limitations 段 |
| 推荐使用 KimiCode Harness,避免中途切到 K3 | ✅ 已验证 | Moonshot AI Blog Limitations 段 |
| K3 在 user experience 上与 Claude Fable 5 / GPT 5.6 Sol 有可见 gap | ✅ 已验证 | Moonshot AI Blog Limitations 段 |
| Moonshot AI GitHub 包含 Attention Residuals / Kimi Linear / Mooncake 等开源项目 | ✅ 已验证 | github.com/moonshotai 自述 |


研究快照:2026-07-21。完整权重、许可证、模型配置和技术报告在该日期尚未公开。本文讨论的是已经确认的架构与部署边界,不是完整本地部署实测。
摘要
Kimi K3 最容易被误读的数字是 2.8T。它说明模型拥有巨大的总参数容量,却不能单独回答每个 Token 的计算量、权重需要多少显存、跨节点通信是否可接受、百万上下文如何计费,也不能说明现有 Coding Agent Harness 能否正确保存它需要的状态。
官方资料已经确认:K3 使用 Kimi Delta Attention、Attention Residuals 和 Stable LatentMoE,每次激活 896 个专家中的 16 个;API 原生提供 1M Token 上下文、始终开启的 Thinking、严格 JSON Schema、Partial Mode、Tool Choice 和 Dynamic Tool Loading;官方建议使用拥有 64 个或更多加速器的 Supernode,并计划在 2026 年 7 月 27 日前公开完整权重与技术报告。[S1][S2][S3]
这些信息支持一个更重要的判断:K3 不是“一个更大的聊天模型”,而是一套需要模型架构、推理基础设施、Agent Harness 和成本控制共同配合的生产系统。
1. 先拆开五个经常被混为一谈的问题
1.1 总参数不是每 Token 激活参数
2.8T 表示全部专家和共享模块的参数规模。Stable LatentMoE 每次只激活 16/896 个专家,说明单 Token 的主要专家计算远低于全参数密集执行。它降低的是每步计算量,不会让未激活专家的权重从存储和分布式路由中消失。
因此需要分别回答:
“每次只激活 16 个专家”不能推出“几张消费卡即可部署完整模型”。
1.2 4-bit 权重也不等于工作站可装下
仅计算 2.8T 权重本体:
| FP16/BF16 | 约 5.6 TB | 每参数 2 Byte |
| INT8/FP8 近似 | 约 2.8 TB | 每参数 1 Byte,仅作容量量级 |
| 4-bit | 约 1.4 TB | 每参数 0.5 Byte,未计量化元数据 |
常见设备的总显存:
| 8×RTX A6000 48GB | 384 GB | 约为下限的 27% |
| 8×RTX 5090 32GB | 256 GB | 约为下限的 18% |
| 8×RTX PRO 6000 96GB | 768 GB | 约为下限的 55% |
| 64×H100 80GB | 5.12 TB | 容量足够,但通信与运行时仍是核心 |
| 64×H200 141GB | 9.024 TB | 容量更宽裕,不代表自动达到高吞吐 |
这里还没有加入量化 scale、路由与通信缓冲、CUDA Graph、KV/状态缓存、冗余和故障恢复。完整部署至少需要“权重容量 + 运行时余量 + 高带宽通信域”三个条件。
1.3 稀疏计算仍然需要高带宽通信
MoE 把 Token 分发给不同专家。专家分布在多张卡或多个节点时,路由会把推理问题变成通信问题。官方推荐 64+ 加速器 Supernode,核心信号不是“64 是唯一答案”,而是 K3 预期运行在一个拥有大容量、低延迟、高带宽互联的通信域中。[S1]
一个系统即使在容量上勉强装下全部权重,也可能因为以下原因没有生产价值:
- Expert All-to-All 占用主要时间;
- 热门专家负载不均;
- 跨节点拓扑破坏局部性;
- 批量太小,无法摊薄通信;
- 批量太大,首 Token 延迟失控;
- 容错或副本策略进一步放大资源需求。
因此,K3 的部署问题应从“显存够不够”升级为“拓扑、并行、路由和服务目标是否匹配”。

2. KDA 与百万上下文改变了缓存问题
K3 采用 Kimi Delta Attention。官方同时说明,KDA 对传统 Prefix Cache 实现提出挑战,并计划随模型公开相应的 vLLM 实现。[S1] 这意味着 1M Context 不只是“把窗口调大”,而是同时要求:
- Attention 状态表示适配 KDA;
- 请求前缀保持稳定;
- Agent Harness 不随意改写历史;
- 缓存键能够覆盖模型、参数和工具状态;
- 缓存命中、驱逐、TTL 和计费可观测。
官方 API 的缓存命中输入价格为每百万 Token 0.30 美元,未命中输入为 3 美元,输出为 15 美元;官方还称 Coding Workload 的缓存命中率超过 90%。[S4] 这是一条厂商运行数据,不是所有代码仓库都能复现的常量。
一个简化例子:请求包含 1M 输入 Token、20k 输出 Token,其中 90% 输入命中缓存。按公开单价粗略计算:
缓存输入:0.9M × $0.30 / M = $0.27
未缓存输入:0.1M × $3.00 / M = $0.30
输出:0.02M × $15.00 / M = $0.30
合计:约 $0.87
如果全部输入未命中,合计约为 $3.30。这个差异说明:百万上下文的经济性主要取决于前缀稳定性,而不是窗口上限本身。实际账单还受请求结构、缓存实现和输出长度影响。
3. Agent Harness 是模型兼容层
K3 的 API 文档要求在多轮对话和 Tool Calling 中完整回传 assistant message,不能只保留 content;Thinking 始终开启,reasoning_effort 可调整;Dynamic Tool Loading 允许先只提供搜索工具,再按需要注入工具定义。[S2][S3]
这使 Harness 成为一等公民。一个成熟 Harness 至少要保存:
Conversation Messages
+ Assistant Thinking State
+ Tool Calls and Tool Results
+ Tool Registry Version
+ System / Repository Instructions
+ Model Parameters
+ Cache-Relevant Prefix
中途切换模型时,另一个模型未必理解 K3 的思考状态、工具调用语义和消息字段;反向切回 K3 时,缺失历史也可能降低稳定性。这不是简单的 OpenAI-compatible endpoint 就能消除的问题。
“协议兼容”应拆成四层:

4. 为什么 Benchmark 不能直接做排行榜
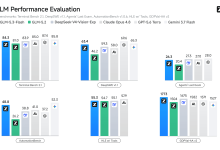
官方技术博客的表格脚注显示,不同测试可能使用 Kimi Code、Claude Code、Codex 或其他 Harness,部分结果来自第三方或不同硬件。[S1] 对 Coding Agent 而言,Harness 会决定:
- 仓库索引方式;
- Tool 集合;
- Patch 应用策略;
- 自动测试与重试;
- 上下文压缩;
- 权限与 Sandbox;
- Token 和时间预算。
因此“模型分数”往往是 Model × Harness × Budget × Environment 的系统结果。真正可比较的评测需要固定 Harness、任务集、推理预算、工具、硬件和失败重试规则。
5. 三种部署路径
5.1 官方 API
适合快速验证模型能力、Tool Calling 和缓存设计。主要风险是供应商依赖、缓存语义不可完全控制、数据合规和费用波动。
5.2 托管 Dedicated Endpoint
适合希望获得容量隔离、稳定配额和更清晰延迟 SLO 的团队。需要确认模型版本固定、缓存可观测、请求日志和数据保留策略。
5.3 自建 Supernode
适合有大量稳定吞吐、硬件和运行时团队、数据隔离要求的组织。真正成本包括:
- 权重与格式转换;
- Expert/Tensor/Pipeline Parallel;
- 高带宽互联;
- 故障域和副本;
- 在线调度;
- 正确性回归;
- 运维和版本升级。
对单个 8 卡工作站,更现实的用途是:验证小型衍生模型、运行组件级实验、测试 Harness 和缓存策略,而不是完整承载 2.8T 权重。
6. 权重发布后的验证顺序
不要在权重出现后直接运行一个 Demo 就宣布“可部署”。应按以下顺序:

7. 可执行评测框架
model_snapshot: null
runtime: null
hardware:
accelerator: null
count: null
topology: null
precision:
weights: null
activations: null
parallelism:
expert_parallel: null
tensor_parallel: null
pipeline_parallel: null
workloads:
– short_chat
– repository_edit
– tool_calling
– strict_json
– vision
– long_context
metrics:
– startup_time
– ttft
– tokens_per_second
– cache_hit_rate
– task_success_rate
– invalid_tool_call_rate
– cost_per_successful_task
关键指标不是每秒 Token,而是“每个成功任务的总资源和成本”。
8. 结论
Kimi K3 的价值在于把四个趋势放到同一系统中:超稀疏 MoE、百万上下文、Agent Tool Runtime 和缓存计费。它也暴露了四个新成本:权重与通信、状态兼容、缓存治理和统一评测。
在完整权重和技术报告公开前,最可信的写法不是宣称本地部署成功,而是明确区分:
模型容量
≠ 单 Token 计算
≠ 显存容量
≠ 服务吞吐
≠ Agent 任务成功率
开放权重降低的是获取和控制门槛,不会自动消除基础设施门槛。

来源
- [S1] Kimi, “Kimi K3: Open Frontier Intelligence”, 2026-07-16: https://www.kimi.com/blog/kimi-k3
- [S2] Kimi API Platform, “Kimi K3 Quickstart”: https://platform.moonshot.ai/docs/guide/kimi-k3-quickstart
- [S3] Kimi API Platform, “Kimi K3 Tool Calling Best Practice”: https://platform.moonshot.ai/docs/guide/kimi-k3-tool-calling-best-practice
- [S4] Kimi API Pricing: https://platform.moonshot.ai/docs/pricing/chat-k3
- [S5] NVIDIA RTX A6000 Datasheet: https://www.nvidia.com/content/dam/en-zz/Solutions/design-visualization/quadro-product-literature/proviz-print-nvidia-rtx-a6000-datasheet-us-nvidia-1454980-r9-web%20%281%29.pdf
- [S6] NVIDIA H100: https://www.nvidia.com/en-us/data-center/h100/
- [S7] NVIDIA H200: https://www.nvidia.com/en-us/data-center/h200/
- [S8] NVIDIA RTX PRO 6000 Blackwell: https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-6000/
- [S9] NVIDIA GeForce GPU Comparison: https://www.nvidia.com/en-us/studio/compare-gpus/
错误速查卡
| “K3 也就 2.8T,我有 8 张 A6000,能跑” | 把总参数当可装显存,没算激活专家、量化 scale、通信缓冲、KV 状态 | 看权重容量(2.8T) vs 单机总显存(384GB @ 8×A6000) | 用 5 个被混淆的问题清单逐项拆开;完整 4-bit 权重下限 1.4 TB,单工作站无法装下 |
| “MoE 每次只激活 16 专家,肯定能跑” | 把"低激活"等同于"低资源需求";没看到未激活专家的权重仍要存储与路由 | 算激活 vs 总参数 vs 显存 vs Expert Parallel 通信 | 把"显存够不够"升级为"拓扑、并行、路由和服务目标是否匹配" |
| “我有 1M context,随便就能写长文档” | 把窗口上限等同于实际能力;KDA + Harness 缓存命中率才是关键 | 看 Harness 是否回传 thinking、是否保留 prefix、缓存键是否覆盖工具状态 | 在 Harness 完整保存 Conversation + Thinking + Tool Calls + Tool Registry + Cache-Relevant Prefix |
| “API 调通了,Harness 兼容” | 把 OpenAI-compatible HTTP 等同于协议兼容;K3 需要 preserved thinking history | 看 K3 Limitations 段:中途切模型会高度不稳定 | 走官方 KimiCode Harness,避免中途切模型;Harness 必须把历史 thinking content 完整回传 |
| “Benchmark 第一名,就是最好” | 误把 Model × Harness × Budget × Environment 的系统结果当模型分数 | 看官方脚注:不同 Benchmark 使用 KimiCode / Claude Code / Codex 之一 | 固定 Harness、任务集、推理预算、工具、硬件、失败重试规则再比 |
| “Coding Workload 缓存命中率 90% 是普适值” | 误把官方厂商运行数据当成所有代码仓库的常量 | 看 K3 Limitations 段是否声明仅 coding workload | 缓存治理按 Harness、prefix 稳定性、cache key 覆盖度分别评估 |
| “K3 训练在 preserved thinking history mode,中途切过来应该没问题” | K3 明确警告:中途切到 K3 会导致生成质量高度不稳定 | 看 Limitations 段 Sensitivity to thinking history | 推荐使用 KimiCode Harness,避免中途切换;新开会话从干净状态启动 |
| “K3 训练强调长程任务,小问题也会给我做更多” | K3 训练侧重长程任务,小问题/意图模糊时会过度主动 | 看 Limitations 段 Excessive proactiveness | 在 system prompt 或 AGENTS.md 中显式约束行为边界,而不是信任默认行为 |
| “64 卡 H100 就能完整部署” | 把 64 当成唯一数字;没看到 Supernode 实际指"大容量、低延迟、高带宽互联" | 看官方推荐 64+ 加速器 Supernode 的实际定义 | 把 64+ 加速器理解为 Supernode 通信域,而不仅是"卡够多" |
| “开放权重 = 本地可跑” | 把开放权重的获取门槛下降等同于基础设施门槛消失 | 用 5 个不等式逐项核对 | 开放权重降低获取门槛,不消除 Supernode + Harness + 评测成本 |
| “2.8T / FP16 = 5.6 TB / 4-bit = 1.4 TB,直接算就行” | 没考虑量化 scale、路由、CUDA Graph、KV 缓存、冗余 | 用 5 个问题清单逐项核对 | 实际部署至少需要"权重 + 运行时 + 通信"三件套,而不是单看权重 |
| “4-bit 量化后 1.4 TB,8 张 RTX PRO 6000 768 GB 不就够” | 没考虑运行时余量、Expert Parallel 通信、路由表、状态缓存 | 用 5 个问题清单 + Supernode 通信需求 | 完整 Supernode ≥ 64 加速器,而不是单节点 8 卡 |