Python 处理 100行×75万列超宽数据:字符串转数值的6种策略实测对比
标签:Python 数据分析 性能优化 pandas numpy polars
一句话结论:字符串→数值转换只做一次,Polars 在大规模下完胜,结果缓存为 Parquet(float32),后续读取快 8~700 倍。
一、问题背景
在测试/测量领域,一次全面测试可能产生 75万个测试项 的测量数据。100次采样就是 100行 × 75万列 的超宽表。更棘手的是——仪器导出的原始数据是 字符串格式,必须转成数值才能计算、图等参数。
这个数据形状非常极端:
| 行列数 | 100 行 × 750,000 列 |
| 总单元格 | 75,000,000(7500万) |
| CSV文件大小 | 577.9 MB |
| 字符串内存(实测) | 1065 MB |
| float64 内存 | 572 MB |
| float32 内存 | 286 MB |
直接用 pandas 的 read_csv + 逐列 to_numeric 转换,在真实 75 万列规模下 10 分钟都无法完成。这不是 pandas 不努力,而是这种超宽+字符串的场景已经远远超出了它的舒适区。
本文用真实数据实测 6 种策略,给出耗时、内存、代码和踩坑记录。
二、测试环境
| 系统 | macOS (Apple Silicon) |
| Python | 3.13.12 |
| pandas | 2.x |
| polars | 1.x |
| numpy | 2.x |
| pyarrow | 17+ |
| 数据文件 | raw_100x750000.csv,577.9 MB |
三、6种策略实测
策略 S0:pandas 逐列转换(基准)
最直觉的写法:
df = pd.read_csv(csv_path, dtype=str) # 全部读为字符串
for col in df.columns: # 75万列循环
df[col] = pd.to_numeric(df[col]) # 逐列转换
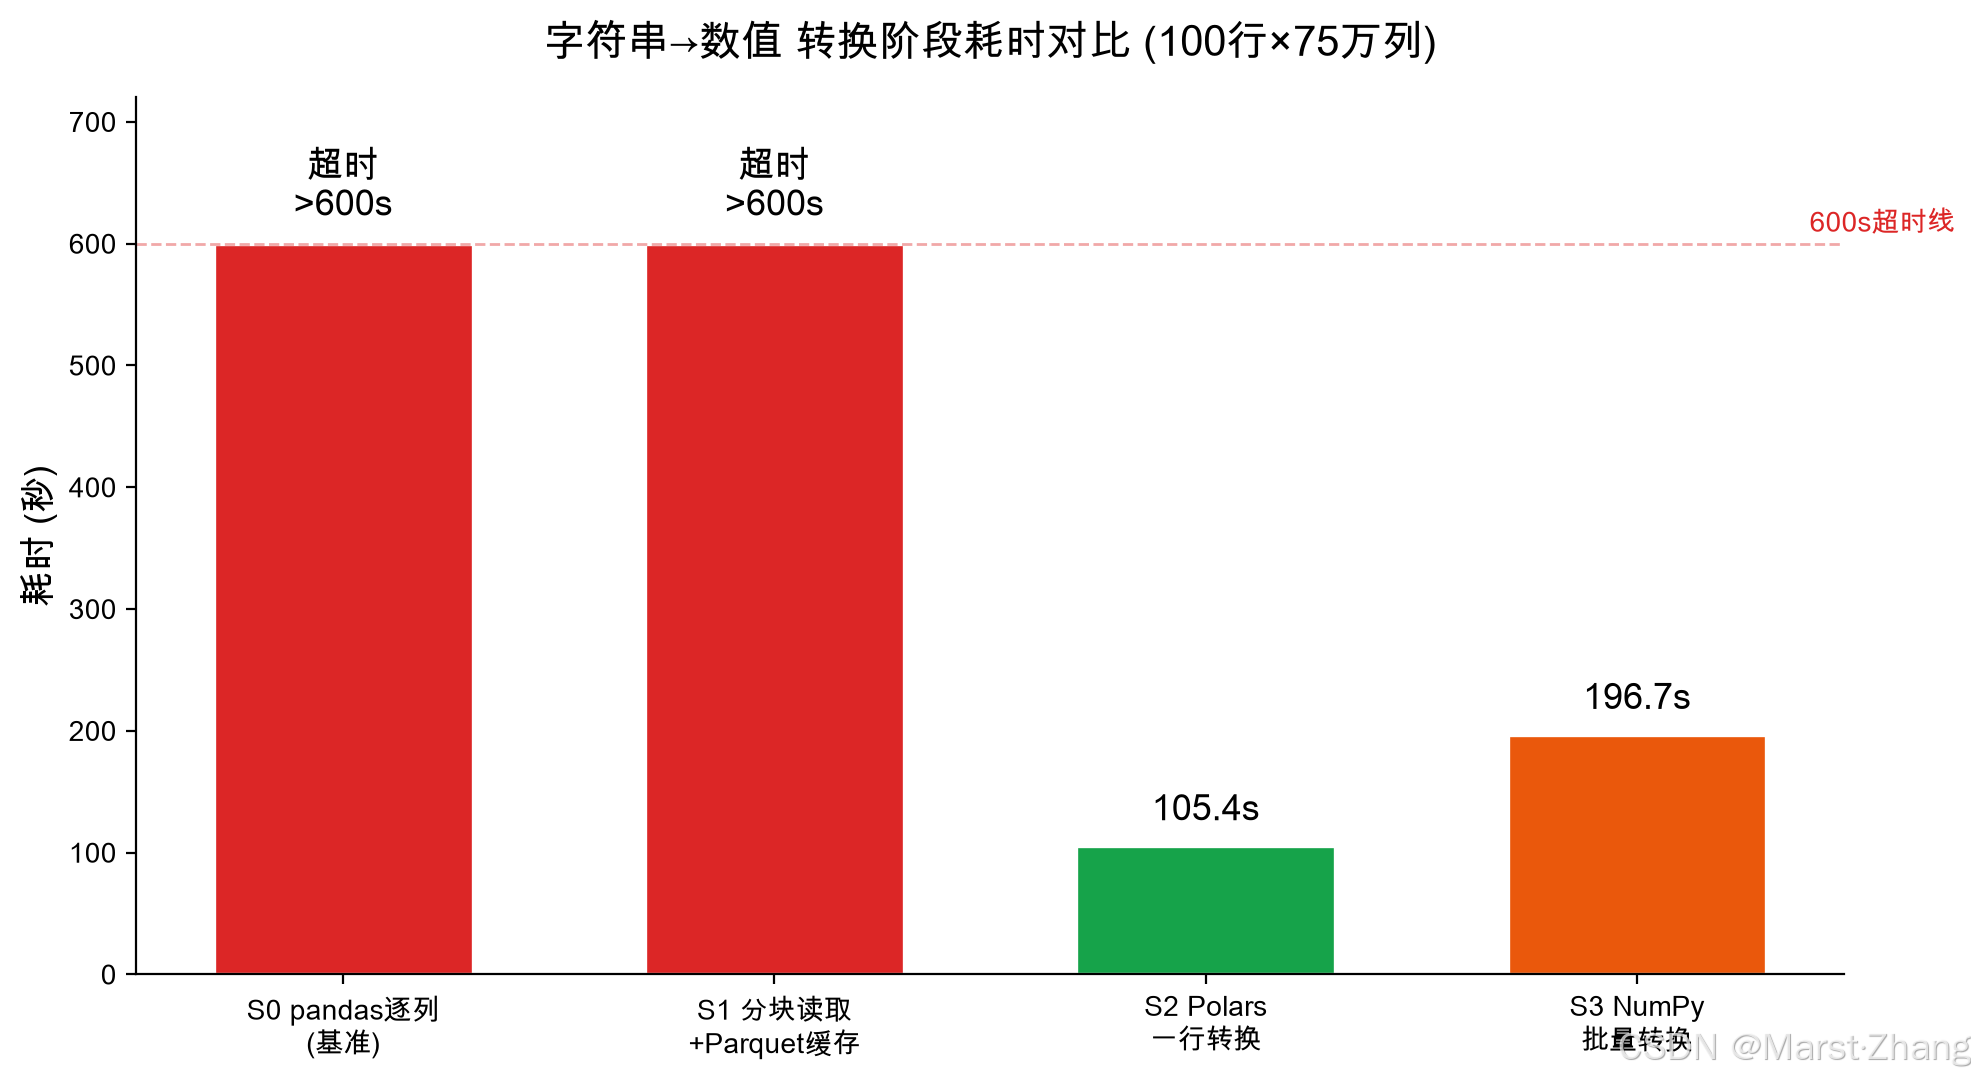
实测结果:超时(10 分钟未完成)
原因:
策略 S1:分块读取 + 批量转换 + Parquet 缓存
思路:每次只读 5000 列,转完释放,降低内存峰值。
all_cols = pd.read_csv(csv_path, nrows=0).columns.tolist()
chunk_size = 5000
chunks = []
for start in range(0, len(all_cols), chunk_size):
col_subset = all_cols[start:start+chunk_size]
df_chunk = pd.read_csv(csv_path, usecols=col_subset, dtype=str)
arr_float = df_chunk.to_numpy(dtype=str).astype(np.float32)
chunks.append(pd.DataFrame(arr_float, columns=col_subset))
del df_chunk
gc.collect()
df_final = pd.concat(chunks, axis=1)
df_final.to_parquet("converted.parquet")
实测结果:超时(10 分钟未完成)
原因很意外:每次 pd.read_csv(usecols=…) 都要 重新扫描整个 CSV 文件。75 万列 / 5000 列 = 150 次全文件读取 ≈ 86 GB 的 I/O。分块省内存的代价是 I/O 爆炸。
教训:对超宽 CSV 做列分块,如果每次都要重读文件,不如一次性读完。
策略 S2:Polars 一行搞定(转换阶段最佳)
import polars as pl
cols = pl.read_csv(csv_path, n_rows=0).columns
schema = {c: pl.Utf8 for c in cols}
df = (
pl.read_csv(csv_path, schema_overrides=schema)
.with_columns(pl.all().cast(pl.Float32))
)
df.write_parquet("data.parquet")
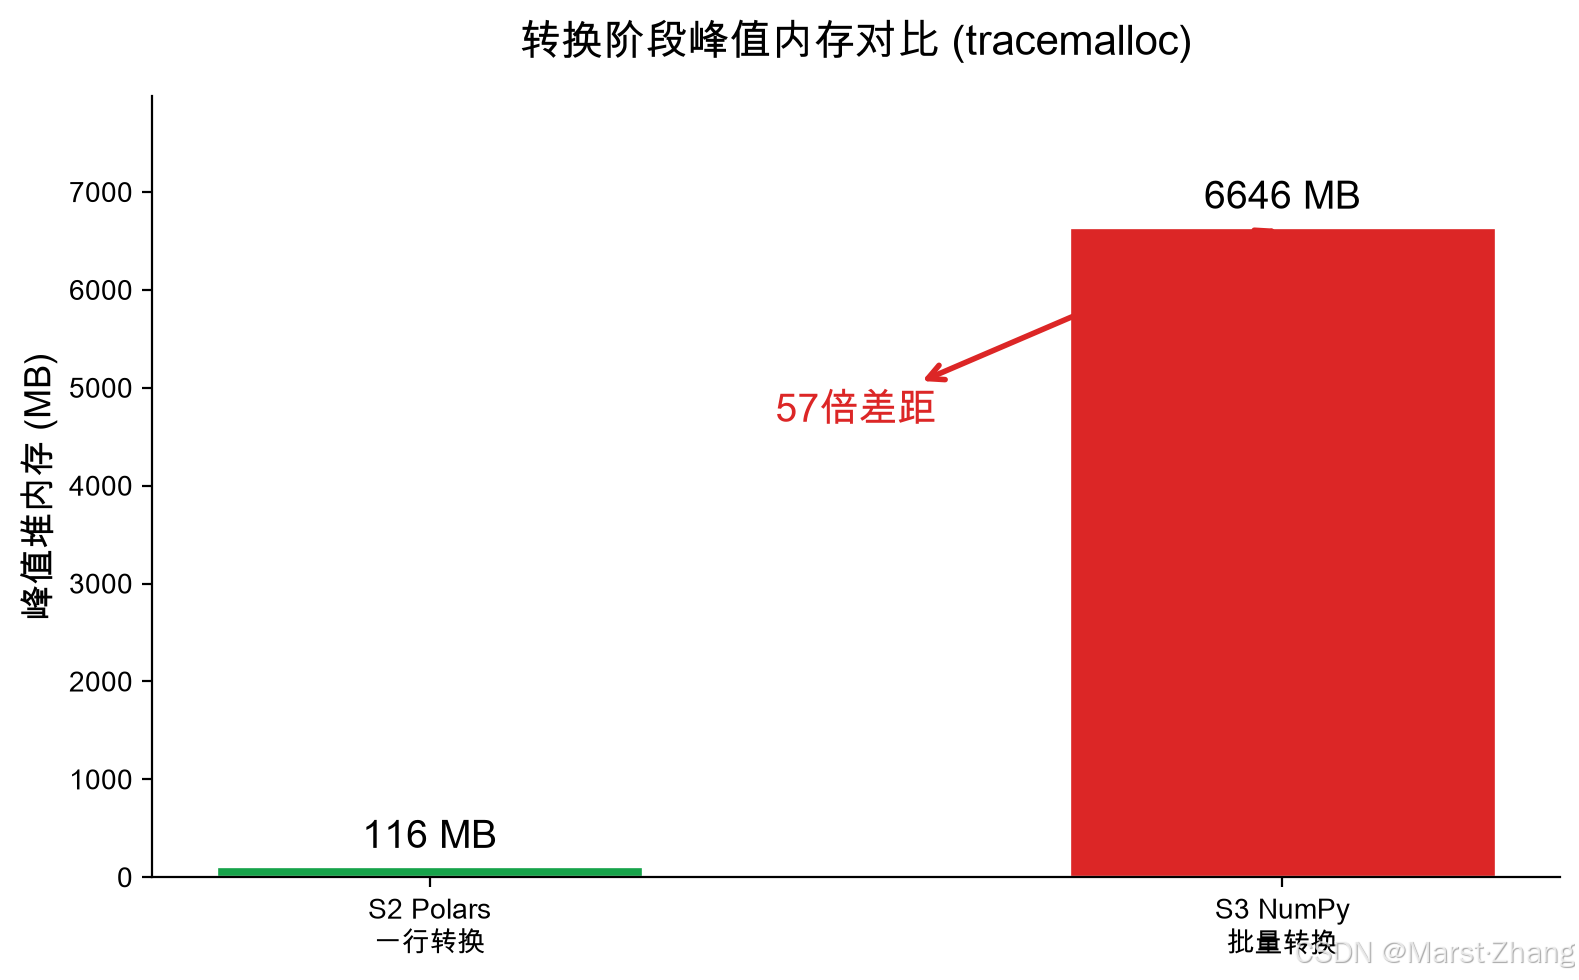
实测结果:105.4 秒,峰值堆内存 116 MB
为什么 Polars 在大规模下反超 NumPy?
- 字符串用 Arrow 连续内存存储,不是每个单元格一个 Python 对象
- 类型转换用 Rust 表达式引擎并行执行
- 7500 万个字符串在 Polars 里只占用 Arrow buffer,内存极低
这是 75 万列真实数据下最快的转换方案。
策略 S3:NumPy 直接操作(小规模无敌,大规模翻车)
with open(csv_path, 'r') as f:
f.readline() # 跳过表头
lines = f.readlines()
str_arr = np.array([line.strip().split(',') for line in lines], dtype=str)
float_arr = str_arr.astype(np.float32)
np.save("data.npy", float_arr)
实测结果:196.7 秒,峰值堆内存 6646 MB(6.4 GB)
在 1 万列的演示测试中,NumPy 是最快的。但到了 75 万列,[line.strip().split(',') for line in lines] 会创建 7500 万个 Python 字符串对象,光是对象头就占数 GB 内存。内存暴增拖累了速度。
策略 S4-S6:转换后的读取方式
转换完成后,数据已缓存为 Parquet(float32) 或 .npy。日常读取有三种选择:
# S4: 全量读 Parquet
df = pd.read_parquet("data.parquet")
# S5: 只读需要的列(超宽表杀手锏)
sample_cols = all_cols[::7500][:100]
df = pd.read_parquet("data.parquet", columns=sample_cols)
# S6: memmap 零内存加载
arr = np.load("data.npy", mmap_mode="r")
col_means = arr.mean(axis=0)
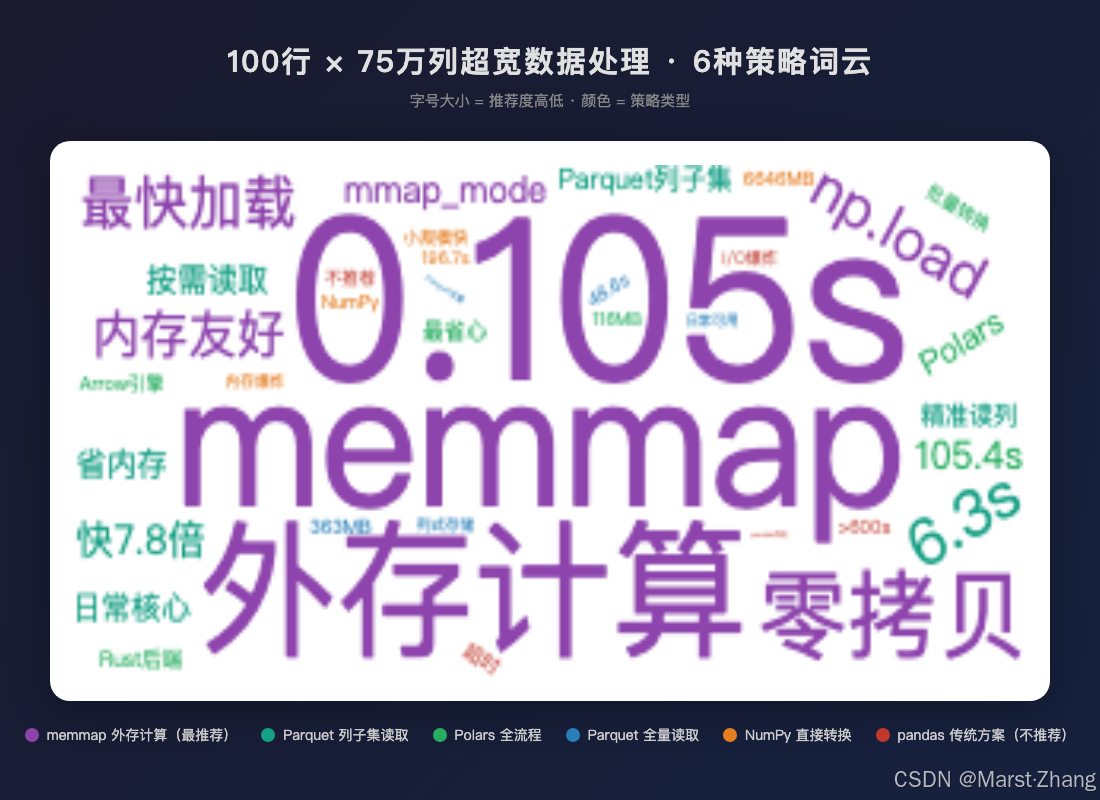
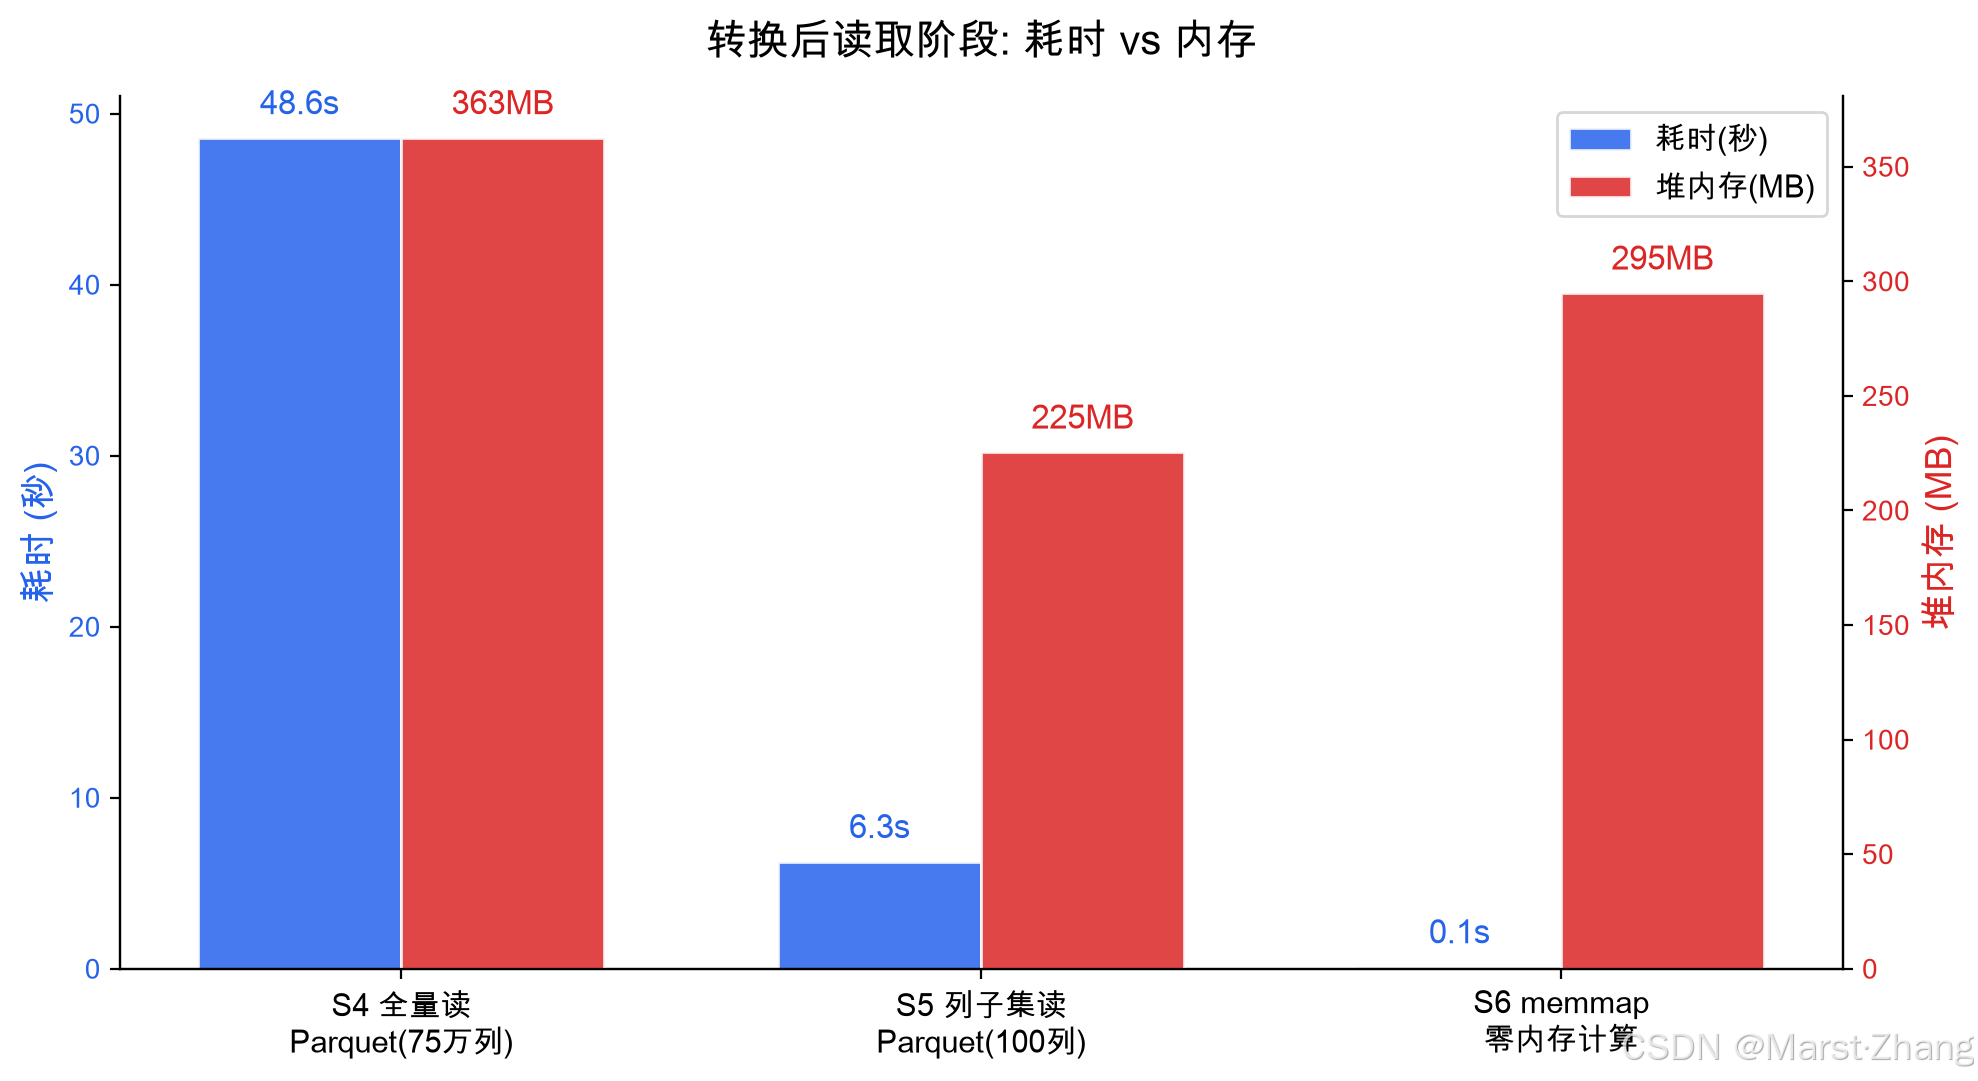
| S4 全量读 Parquet | 48.6s | 363 MB | 需要全部列 |
| S5 列子集读 Parquet | 6.3s | 225 MB | 只读 100 列,快 7.8 倍 |
| S6 memmap 加载 | 0.105s | 295 MB | 数据在磁盘,快 460 倍 |
策略 S7:数据类型内存对比
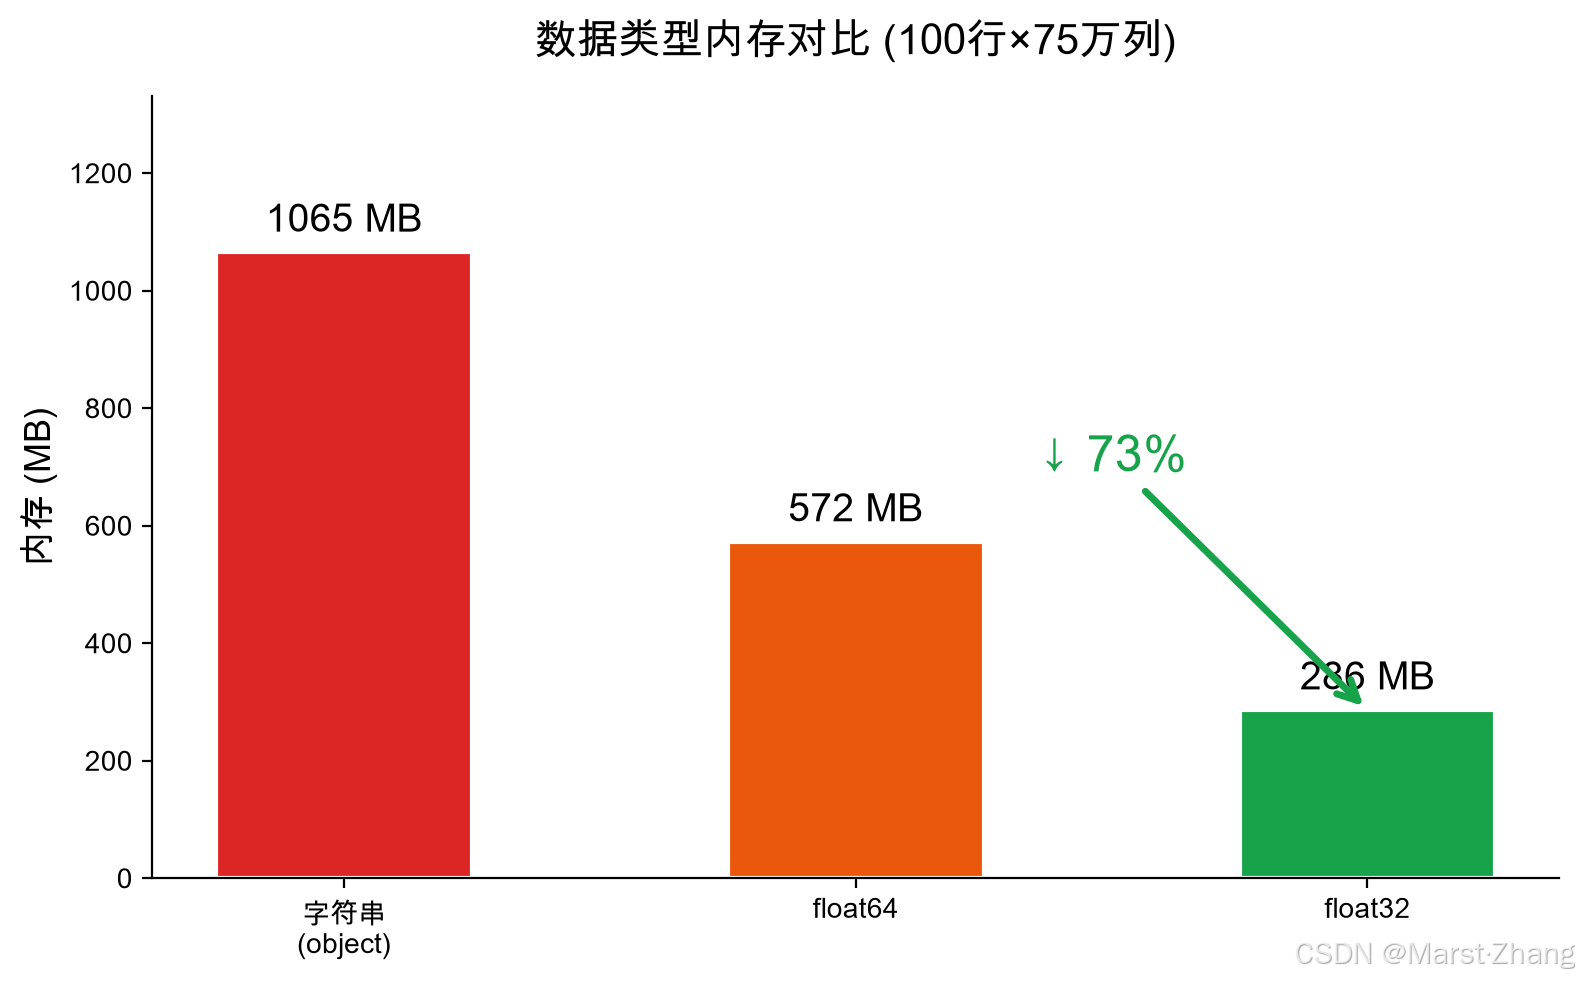
实测 75 万列同一份数据的内存占用:
| 字符串(object) | 1065 MB | 3.7x |
| float64 | 572 MB | 2.0x |
| float32 | 286 MB | 1.0x |
字符串 → float32 减少 73% 内存。测量数据(dB 值、)float32 精度完全够用。
四、结果汇总
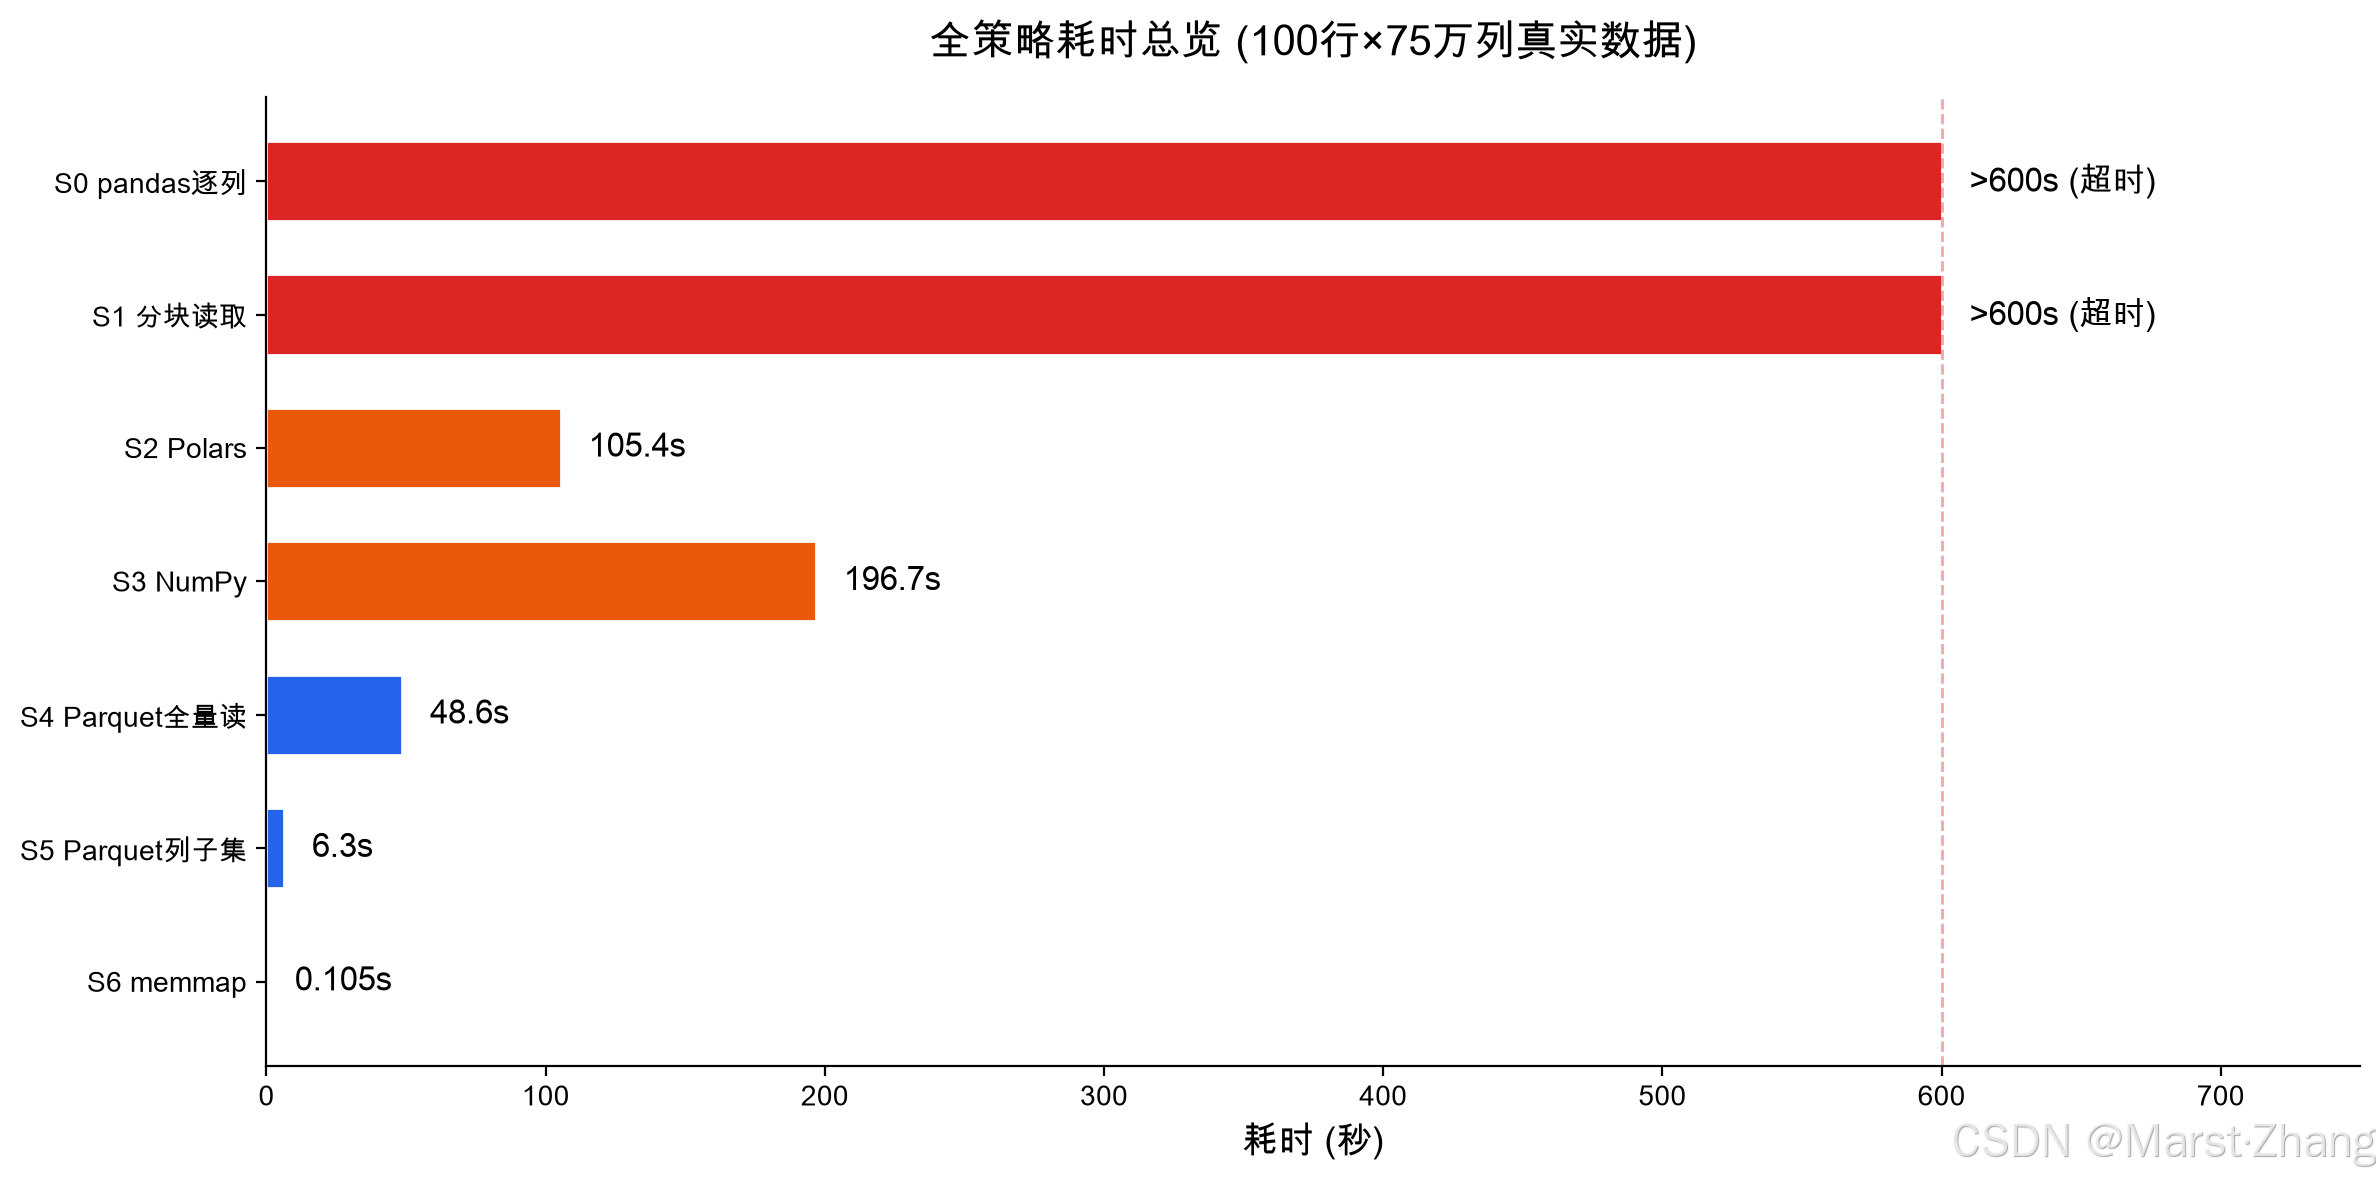
| S0 pandas 逐列转换 | >600s | – | 超时 ❌ | 75 万列不可行 |
| S1 pandas 分块读取 | >600s | – | 超时 ❌ | I/O 重复读取致命 |
| S2 Polars 一行转换 | 105.4s | 116 MB | ✅ | 转换阶段最佳 |
| S3 NumPy 批量转换 | 196.7s | 6646 MB | ✅ | 内存代价高 |
| S4 Parquet 全量读 | 48.6s | 363 MB | ✅ | 日常使用 |
| S5 Parquet 列子集读 | 6.3s | 225 MB | ✅ | 只读需要列 |
| S6 memmap 零内存 | 0.105s | 295 MB | ✅ | 最快加载 |
五、推荐方案
┌─────────────────────────────────────────────────────────────┐
│ 推荐处理流程 │
│ │
│ CSV(字符串) │
│ │ │
│ ▼ │
│ ┌──────────────┐ 首次转换(只做一次) │
│ │ Polars cast │ ← 75万列下最快,内存最低 │
│ │ Float32 │ │
│ └──────┬───────┘ │
│ │ │
│ ▼ │
│ ┌──────────────┐ │
│ │ Parquet(f32) │ ← 持久化缓存 │
│ └──────┬───────┘ │
│ │ │
│ ┌────┼────┬────────────┐ │
│ ▼ ▼ ▼ ▼ │
│ 全量 列子集 memmap 统计计算 │
│ 读取 读取 零内存 numpy向量化 │
└─────────────────────────────────────────────────────────────┘
| 首次 CSV → 数值转换 | Polars cast(Float32) | ⭐⭐⭐⭐⭐ |
| 转换后持久化 | Parquet(float32) | ⭐⭐⭐⭐⭐ |
| 日常读取使用 | read_parquet(columns=[…]) | ⭐⭐⭐⭐⭐ |
| 内存不足时 | numpy memmap .npy | ⭐⭐⭐⭐ |
| 纯数值计算 | numpy ndarray | ⭐⭐⭐⭐ |
| 必须使用 pandas API | 先转 Parquet,再读 pandas | ⭐⭐⭐ |
核心原则:转换只做一次 → 缓存 Parquet(float32) → 后续零转换
六、踩坑记录
坑1:pandas read_csv 默认类型推断
不指定 dtype=str 时,pandas 会对 75 万列逐列推断类型,耗时远超想象。
坑2:分块读取 CSV 导致 I/O 爆炸
如果分块是每次 read_csv(usecols=…) 重新读文件,I/O 会按分块数翻倍。75 万列分 5000 列一块,就是 150 次全文件扫描。
坑3:NumPy 在小规模和大规模表现相反
1 万列时 NumPy 最快,75 万列时反而被 Polars 反超,原因是 Python str 对象的内存爆炸。
坑4:float64 浪费内存
测量数据通常 0.01 dB 精度足够,默认用 float32,内存减半。
坑5:Parquet 列子集读取的列名问题
不要用 pd.read_parquet(parquet_path, columns=[]) 去读列名。正确做法:
import pyarrow.parquet as pq
all_cols = pq.read_schema(parquet_path).names
七、总结
| 转换速度 | Polars | 105.4s,Arrow 后端内存效率碾压 |
| 转换内存 | Polars | 仅 116 MB,比 NumPy 低 57 倍 |
| 读取速度 | memmap | 0.1s 加载 75 万列 |
| 实际场景 | Parquet 列子集 | 只读需要的列,跳过其余 74.99 万列 |
| 内存不足 | memmap + float32 | 数据在磁盘,堆内存≈0 |
一行结论:对于 100 行×75 万列的字符串型超宽数据,用 Polars 一次性转 float32 → 存 Parquet → 后续按需列子集读取,是工程上最平衡、最省心的方案。如果纯追求读取速度或内存最小化,就用 numpy memmap。
如果觉得有用,点赞收藏关注三连~
专注于//数据处理与工程优化