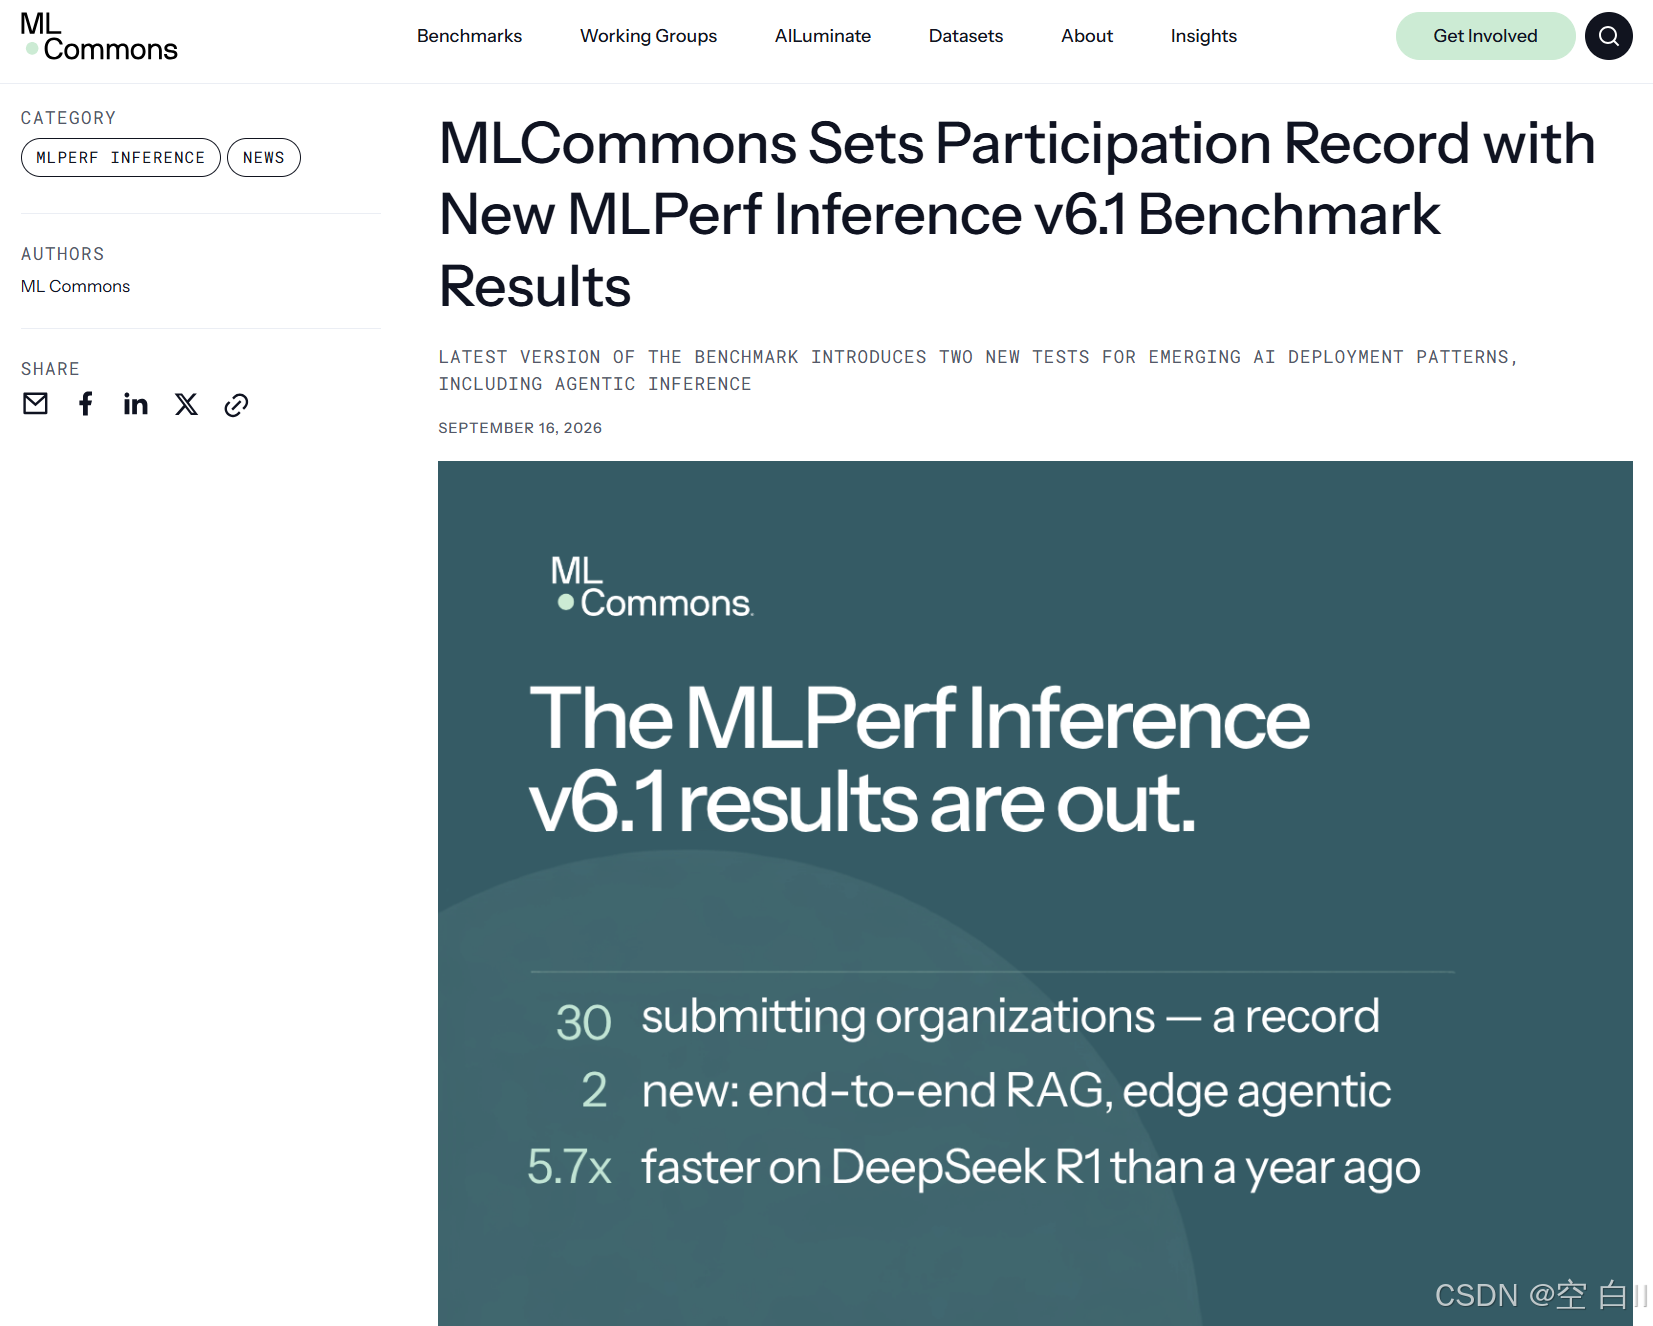
北京时间 2026 年 9 月 16 日 23:00,MLCommons 正式公布 MLPerf Inference v6.1 Benchmark Results。
此次更新不仅创下了参与机构数量的新纪录,更重要的是,MLPerf 开始明显把评测对象从传统的“单模型推理性能”扩展到更加完整的 AI 系统级推理(AI System Inference)。
官方表示,本轮结果首次提供了多个近期发布或即将发布 AI 平台的同行评审性能数据;部分工作负载的最佳单位加速器性能,相比一年前的结果最高提升约 5.7 倍。
对大模型推理而言,这次更新真正值得关注的并不是单纯的“跑得更快”,而是 MLPerf 正在重新定义应该如何衡量现代 AI 系统的推理性能。
MLPerf Inference v6.1 更新了什么?
此次 v6.1 最值得关注的是两个新的 Workload:
除此之外,MLPerf Inference v6.1 还正式加入了对 Speculative Decoding(推测解码) 的支持。
简单对比如下:
| 传统 LLM Inference | 单个大模型 | Prompt → Prefill → Decode | TTFT、TPOT、Tokens/s | Chat、文本生成 |
| End-to-End RAG | 完整 RAG 系统 | Embedding → Retrieval → Reranking → LLM Reasoning | 端到端延迟、吞吐、检索与生成综合效率 | 企业知识库、搜索增强生成 |
| Edge Agentic Inference | Agent 执行系统 | Growing Context → Tool Calling → Evidence Gathering → Reasoning | 单用户延迟、长轨迹执行效率 | Coding Agent、Edge Agent |
| Speculative Decoding | LLM 解码系统 | Draft Model → Verification → Decode | 解码吞吐、延迟 | 高性能 LLM Serving |
可以看到,评测重点已经从:
单模型一次推理有多快?
逐渐变成:
一个完整 AI 系统完成一次真实任务需要多少时间和资源?
这背后的变化非常重要。
1. End-to-End RAG:不再只测 LLM Decode
传统的大模型 Benchmark 通常更加关注模型本身,例如:
Prompt
↓
Prefill
↓
Decode
↓
Answer
因此常用的指标也是:
- TTFT(Time To First Token)
- TPOT(Time Per Output Token)
- Tokens/s
- Throughput
但真实的 RAG 系统远比这个复杂。
一个典型的 Retrieval-Augmented Generation Pipeline 可能是:
User Query
↓
Embedding
↓
Vector Retrieval
↓
Reranking
↓
Context Construction
↓
LLM Reasoning
↓
Final Answer
MLPerf Inference v6.1 新增的 End-to-End RAG Benchmark,开始把这整个流程纳入性能测量。
也就是说,Benchmark 不再只是:
“LLM 每秒能够生成多少 Token?”
而开始回答:
“一个完整的 RAG 系统,从收到用户问题到得到最终答案,到底需要多少时间?”
为什么 End-to-End RAG 很重要?
在实际系统中,LLM Decode 往往只是整个 Pipeline 的一部分。
一次 RAG 请求的总延迟可以近似写成:
Ttotal=Tembedding+Tretrieval+Treranking+Tprefill+Treasoning+Tdecode
T_{total}
=T_{embedding}
+
T_{retrieval}
+
T_{reranking}
+
T_{prefill}
+
T_{reasoning}
+
T_{decode}
Ttotal=Tembedding+Tretrieval+Treranking+Tprefill+Treasoning+Tdecode
如果只优化:
Tdecode
T_{decode}
Tdecode
并不能保证:
Ttotal
T_{total}
Ttotal
真正降低。
例如:
LLM Decode:200 ms
Embedding:50 ms
Retrieval:300 ms
Reranking:250 ms
Prefill:400 ms
即使把 Decode 优化一倍:
200 ms → 100 ms
整个系统的用户体验也不会发生数量级变化。
因此,End-to-End RAG Benchmark 的意义在于把评测对象从 Model 扩展到了 Pipeline。
2. Edge Agentic Inference:开始评测真正的 Agent Trajectory
相比 RAG Benchmark,我认为 Edge Agentic Inference 更值得长期关注。
原因在于,Agent 的执行方式和传统 LLM Chat 有本质区别。
传统 Chat 更接近:
Prompt
↓
LLM
↓
Answer
而 Agent 则可能是:
User Request
↓
Reasoning
↓
Tool Call
↓
Observation
↓
Reasoning
↓
Tool Call
↓
Observation
↓
…
↓
Final Answer
整个过程可以形成很长的 Agent Trajectory:
τ=(o1,a1,o2,a2,…,on,an)
\\tau =
(o_1,a_1,o_2,a_2,\\dots,o_n,a_n)
τ=(o1,a1,o2,a2,…,on,an)
其中:
- oio_ioi:环境 Observation
- aia_iai:Agent Action
随着 Agent 不断执行任务,它的 Context 通常还会持续增长。
Agent 的成本并不是简单的 Tokens/s
对于一个长期 Agent,实际成本可能由以下部分组成:
Growing Context
↓
Repeated Prefill
↓
KV Cache Growth
↓
Reasoning
↓
Tool Calling
↓
Tool Waiting
↓
Evidence Retrieval
↓
More Reasoning
↓
Final Response
因此 Agent 的真实延迟更接近:
Tagent=∑i=1N(Tprefill(i)+Tdecode(i)+Ttool(i)+Tretrieval(i))
T_{agent}
=\\sum_{i=1}^{N}
(
T_{prefill}^{(i)}
+
T_{decode}^{(i)}
+
T_{tool}^{(i)}
+
T_{retrieval}^{(i)}
)
Tagent=i=1∑N(Tprefill(i)+Tdecode(i)+Ttool(i)+Tretrieval(i))
这和传统的一次 LLM 推理完全不同。
Agent Benchmark 开始关注 Long Trajectory
MLPerf v6.1 的 Agentic Edge Benchmark 特别强调:
- Growing Context
- Long Agent Trajectory
- Tool Calling
- Evidence Gathering
- Multi-turn Reasoning
- Single-user Latency
其参考 Workload 甚至包括:
Agentic Coding
这意味着 MLPerf 已经开始尝试测量类似 Coding Agent 这样的真实系统:
读取代码
↓
分析问题
↓
搜索文件
↓
修改代码
↓
运行测试
↓
读取错误
↓
再次修改
↓
最终完成任务
这种任务的性能显然无法用单一的:
Tokens / Second
来描述。
3. Speculative Decoding 正式进入 MLPerf
此次 MLPerf Inference v6.1 还正式支持:
Speculative Decoding
这是目前大模型推理加速中非常重要的一条技术路线。
基本思想是:
Small Draft Model
↓
快速预测多个 Token
↓
Large Target Model
↓
并行验证
↓
Accept / Reject
传统 Autoregressive Decoding 是:
Token 1
↓
Token 2
↓
Token 3
↓
Token 4
而 Speculative Decoding 尝试一次预测多个候选 Token:
Draft:
Token1 Token2 Token3 Token4
↓
Target Model
↓
Verification
如果大部分 Draft Token 被接受,就可以显著减少大模型 Forward Pass 的数量。
因此 Speculative Decoding 已经成为现代 LLM Serving Stack 中非常重要的优化方向之一。
MLPerf 正式支持该技术,也意味着 Benchmark 正在逐渐适应真实工业推理系统中的优化方案。
4. 推理研究的核心指标正在变化
过去谈 LLM Inference Optimization 时,我们通常关注:
TTFT
TPOT
Tokens/s
Throughput
GPU Utilization
这些指标当然仍然重要。
但是随着 RAG 和 Agent 成为主要应用形态,真正值得关注的指标正在变成:
Task Completion Latency
↓
Trajectory-level Latency
↓
Trajectory-level Cost
↓
End-to-End System Efficiency
也就是说:
推理优化的基本单位正在从 Token 逐渐转向 Task。
从 Token-level Optimization 到 Task-level Optimization
传统 LLM Serving:
$$
\\text{Optimization Target}
\\frac{\\text{Tokens}}{\\text{Second}}
$$
而 Agent 系统可能更加关注:
Optimization Target=Completed TasksTime
\\text{Optimization Target}
=\\frac{\\text{Completed Tasks}}{\\text{Time}}
Optimization Target=TimeCompleted Tasks
或者:
Cost Per Successful Task
\\text{Cost Per Successful Task}
Cost Per Successful Task
甚至:
Energy Per Successful Task
\\text{Energy Per Successful Task}
Energy Per Successful Task
这实际上是一个非常大的 Benchmark 范式变化。
5. 从 Model Inference 到 AI System Inference
过去 MLPerf 更多把一个模型看作一个独立 Workload:
Model
↓
Input
↓
Inference
↓
Output
但现代 AI 应用正在越来越系统化:
┌─ Embedding Model
│
├─ Vector Database
│
User ───────→├─ Reranker
│
├─ LLM
│
├─ Tools
│
└─ Memory
↓
Agent
真正影响用户体验的已经不再只是某一个模型,而是:
整个 AI System。
因此 MLPerf Inference v6.1 一个非常重要的信号就是:
Model Inference
↓
Pipeline Inference
↓
Agent Inference
↓
AI System Inference
6. 对推理系统研究意味着什么?
这次更新对于以下几个研究方向尤其值得关注:
| Agent Systems | 开始直接关注长 Trajectory 与 Tool Calling |
| RAG Systems | 从单模型评测扩展到 Retrieval + Generation 全流程 |
| KV Cache Management | Growing Context 使 KV Cache 成本更加关键 |
| Long Context | 多轮 Agent 会不断增加 Context 长度 |
| Speculative Decoding | 正式进入标准化 Benchmark |
| LLM Serving | 优化目标开始从 Token Throughput 转向 End-to-End Latency |
| Edge AI | Agentic Workload 开始进入 Edge Benchmark |
| AI System Benchmarking | Benchmark 对象从单模型扩展到完整 AI Pipeline |
总结
MLPerf Inference v6.1 最值得关注的地方,并不是简单刷新了多少性能纪录,而是它释放出了一个非常明显的信号:
大模型推理 Benchmark 正在从“测模型”逐渐走向“测系统”。
随着 RAG、Agent、Tool Calling、Long Context 和 Memory 等技术逐渐成为真实 AI 应用的基础组件,仅仅衡量:
TTFT
TPOT
Tokens/s
已经不足以描述一个 AI 系统的真实效率。
未来更加重要的指标可能会是:
Trajectory-level Latency
Task Completion Time
Cost Per Task
Energy Per Task
End-to-End Throughput
因此,从研究角度来看,MLPerf Inference v6.1 代表的可能不仅仅是一次 Benchmark 更新,而是一种评价范式的变化:
从 Model Inference Benchmark,逐渐走向 AI System Inference Benchmark。
这对于 Agent 系统、RAG、KV Cache 管理、Long Context、Speculative Decoding 和 LLM Serving 等方向,都值得持续关注。