一、K8s 很香,但对数据库一直不太友好
这几年 Kubernetes 基本成了应用部署的事实标准:写一份 YAML,kubectl apply 一下,部署、扩缩容、自愈、滚动升级全部搞定。无状态应用迁进 K8s 的体验可以用"丝滑"来形容。
但数据库是另一回事。
数据库是典型的有状态应用——数据要落盘、节点有角色之分(主/备)、启停有顺序要求。把它塞进 K8s 之后,问题接踵而至:
- 部署繁琐:拉起一套数据库集群,要协调 StatefulSet、PV/PVC、Service、ConfigMap 一大堆资源对象,哪个配错了都起不来;
- 两套运维体系打架:K8s 侧用 kubectl 管理,数据库侧还要进容器执行脚本、跑备份命令,运维人员来回切换;
- 规模一大就失控:集群数量上去了,靠人工逐台配置、逐项检查,既慢又容易出事故。
换句话说,数据库进了 K8s,但管理方式还停留在"手工时代",没有真正享受 K8s 的管理红利。
针对这个问题,电科金仓近期正式推出了 KES 的 K8s 运维工具——KES-Operator,思路就是把 KES 数据库集群完整纳入 Kubernetes 的原生管理体系。
二、先补课:Operator 到底解决什么问题
理解 KES-Operator 之前,得先明白 Kubernetes Operator 这个模式为什么会出现。
K8s 原生擅长管理的是 Pod、Deployment 这类"通用"资源,它并不懂"一个数据库集群"是什么、主备怎么切换、备份怎么做。Operator = CRD + 控制器:
- CRD(自定义资源):在 K8s 里定义一种新资源,比如"一个 KES 集群",让用户可以用一份配置文件描述自己想要的集群长什么样——几个节点、多少资源、什么版本;
- 控制器(Controller):一个常驻的控制回路,不停地对比期望状态(你配置文件里写的)和实际状态(集群真实运行的),一旦发现偏差,就自动执行操作把实际状态"调和"回期望状态。
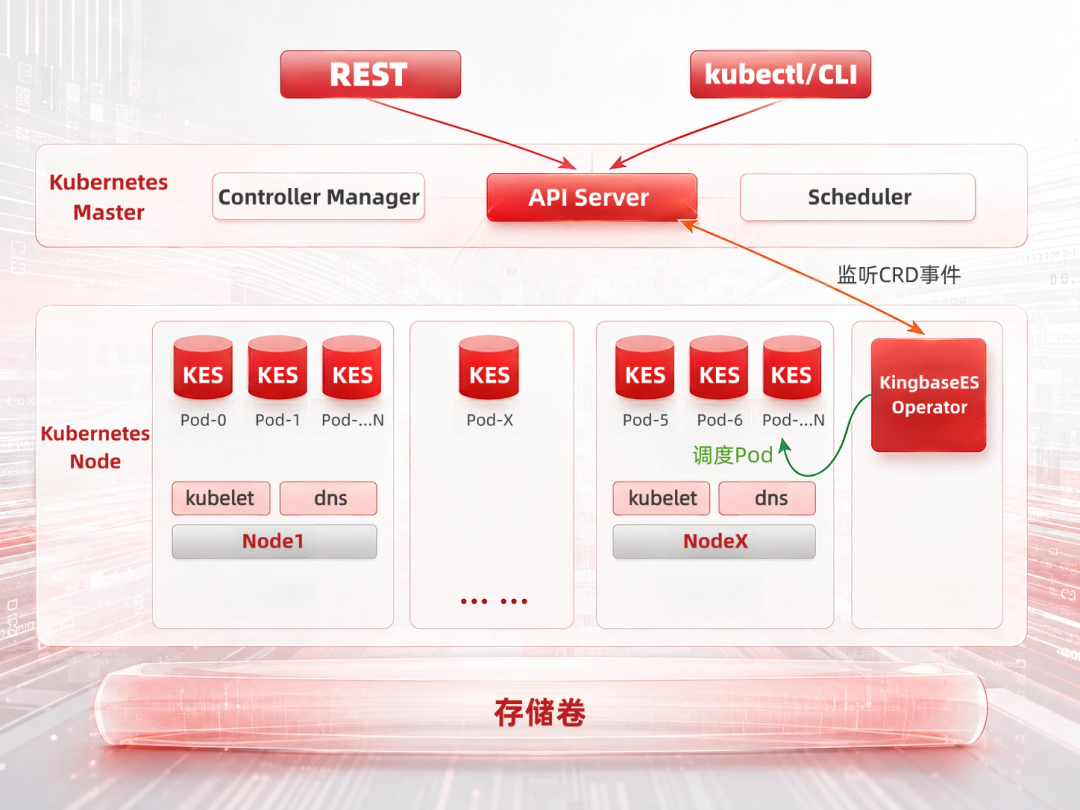
这套"声明式 + 控制回路"的模式,最初就是为数据库这类复杂有状态应用发明的。KES-Operator 正是基于这套模式设计,通过 CRD 扩展 K8s 的管理能力,让 KES 集群变成 K8s 里一个可声明、可观测、可自愈的资源对象。
三、四大能力:从部署到备份,覆盖 KES 日常运维主线
1. 声明式部署:一份配置拉起一套集群
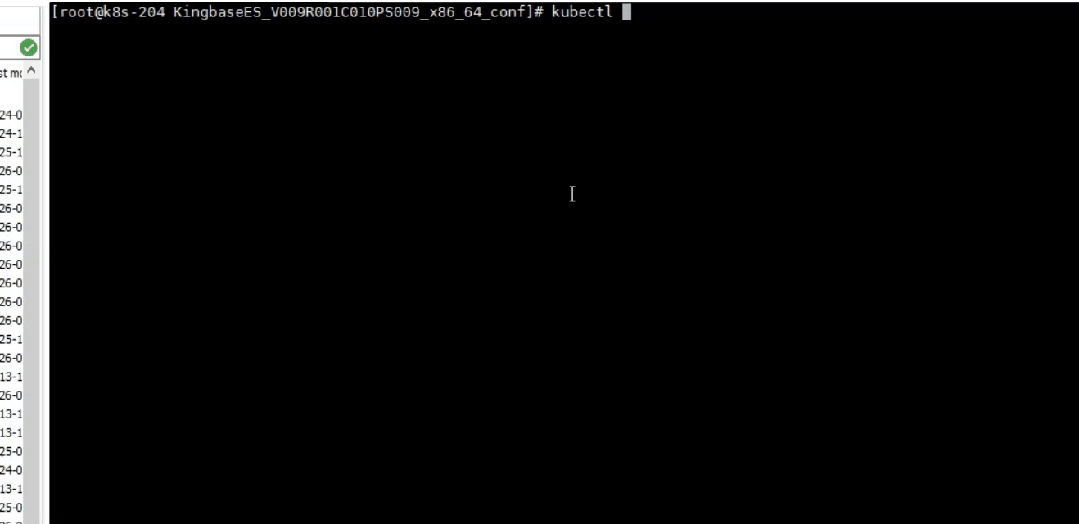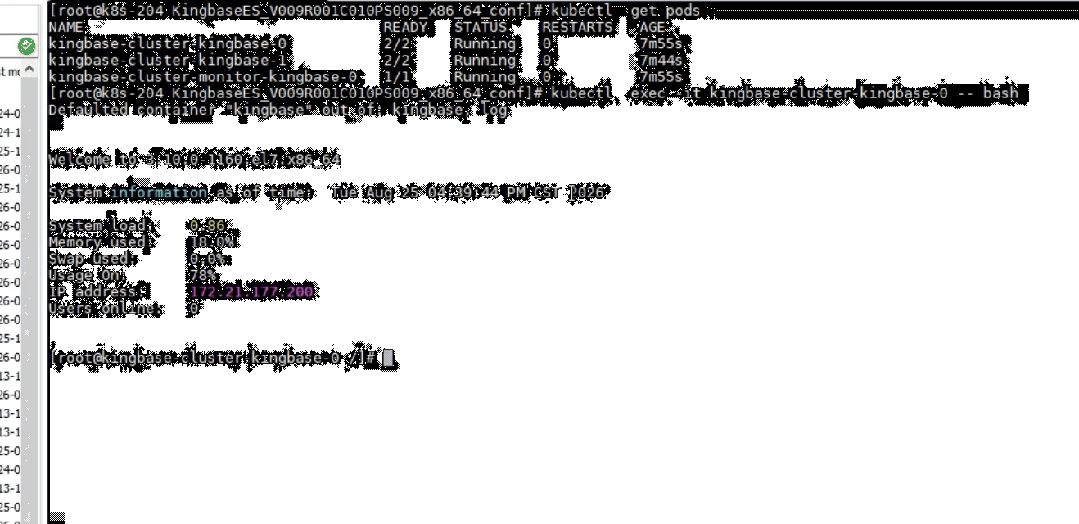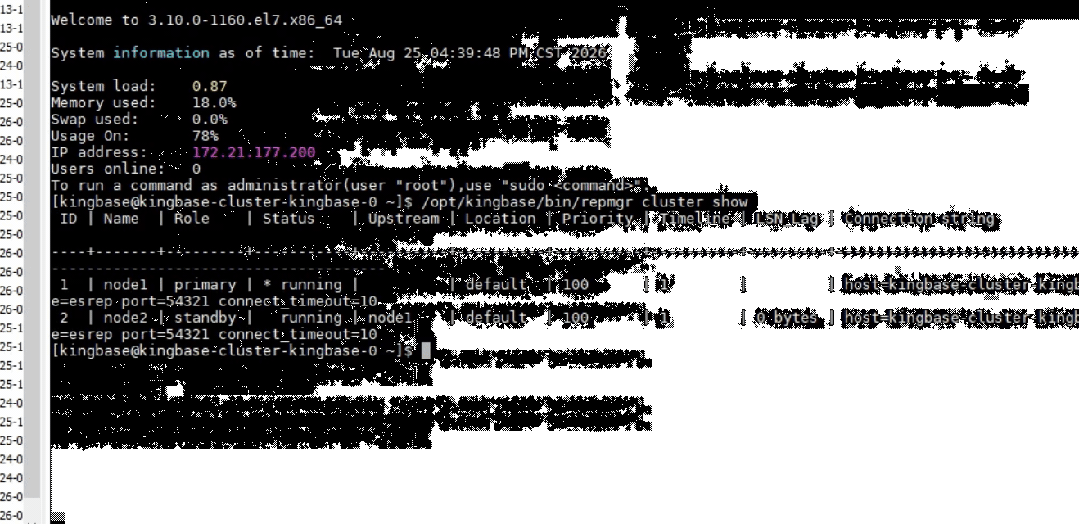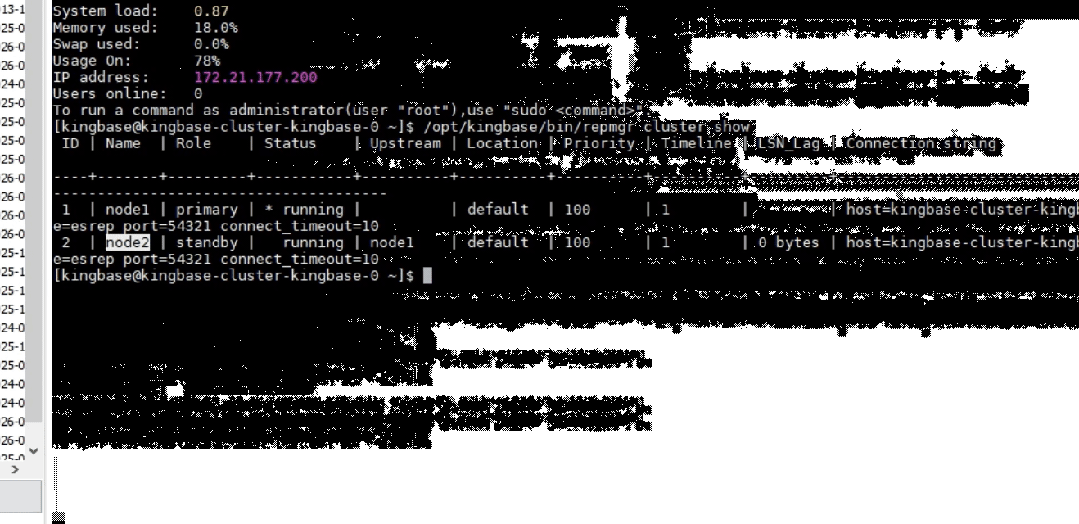
传统方式部署数据库集群,要在 K8s 里逐个创建和调试资源对象。KES-Operator 把这个过程声明式化:用户只需在配置文件里定义 KES 集群的期望状态,提交后由 Operator 自动创建所需的全部资源对象,把集群拉起来。
对运维人员来说,部署一套集群从"N 步手工操作"变成"1 次配置提交"。
2. 状态持续调和:集群跑偏了自动拽回来
部署完成只是开始,长期运行中的状态维护才是运维的大头。
KES-Operator 借助 K8s 控制器机制,持续监测数据库集群的实际运行状态,并与用户定义的期望状态做比对。一旦两者出现偏差,Operator 会根据配置协调相关 K8s 资源,让集群回到稳定的目标状态——这正是 K8s"调和"思想在数据库上的落地,大量原本需要人工巡检、人工介入处理的工作被控制回路接管了。
3. 弹性扩缩容:改配置,不改流程
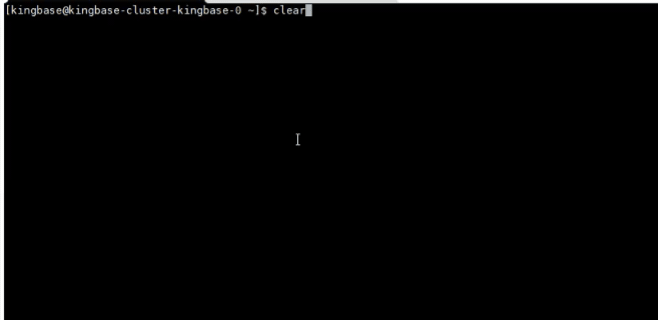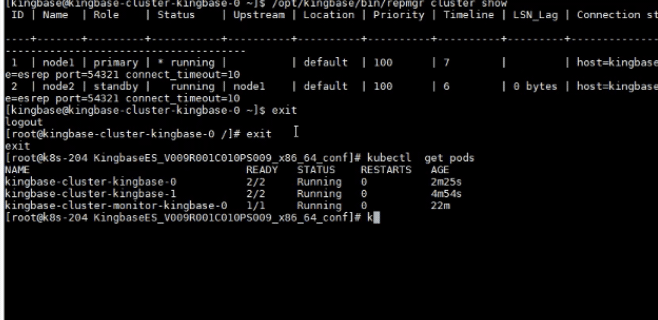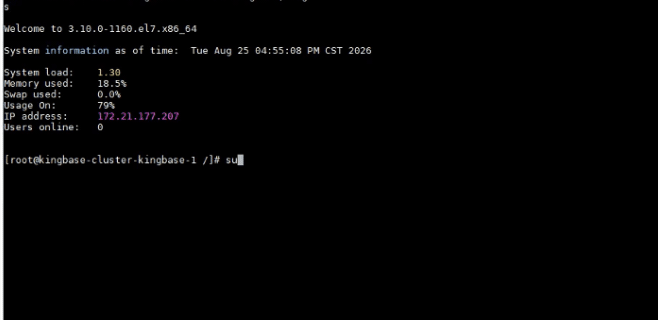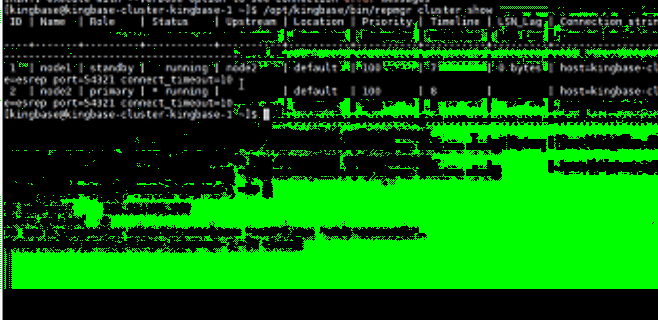
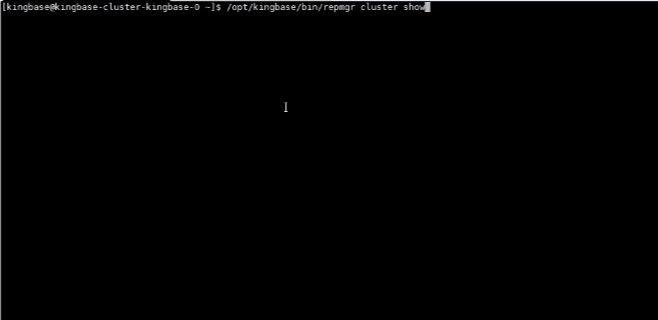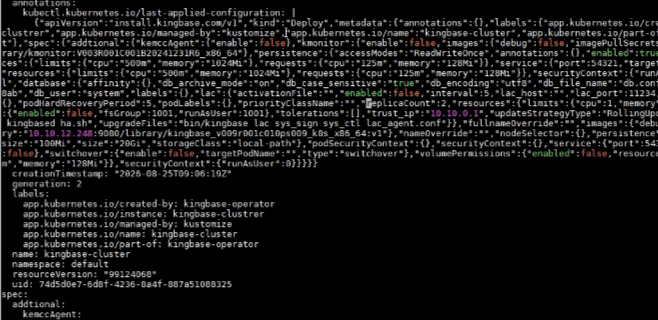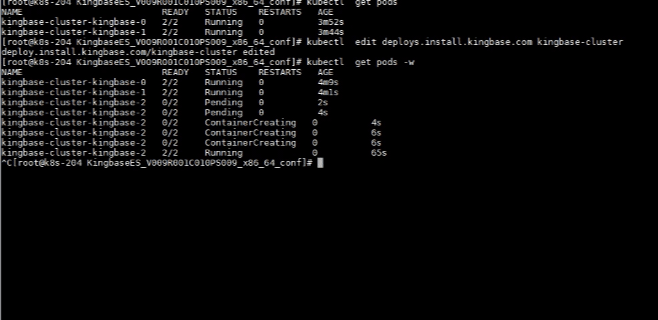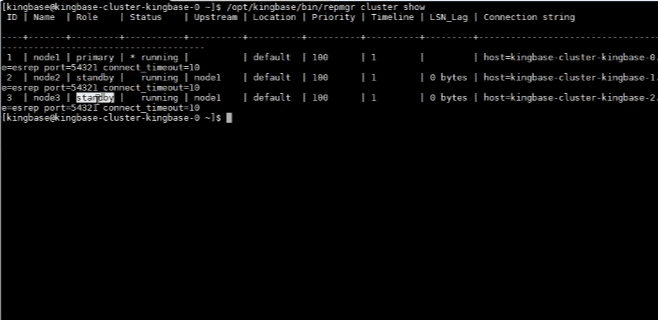
业务量涨了要加节点,业务收缩要减节点。KES-Operator 支持对 KES 集群进行扩容与缩容管理:用户按需修改集群配置中的节点规模,Operator 根据新配置自动完成相应的资源调整,不需要重新走一遍部署流程。
4. 物理备份 + 监控:数据保护也纳入 K8s 统一管理
备份和监控是数据库长期稳定运行的两道保险。KES-Operator 支持两项能力:
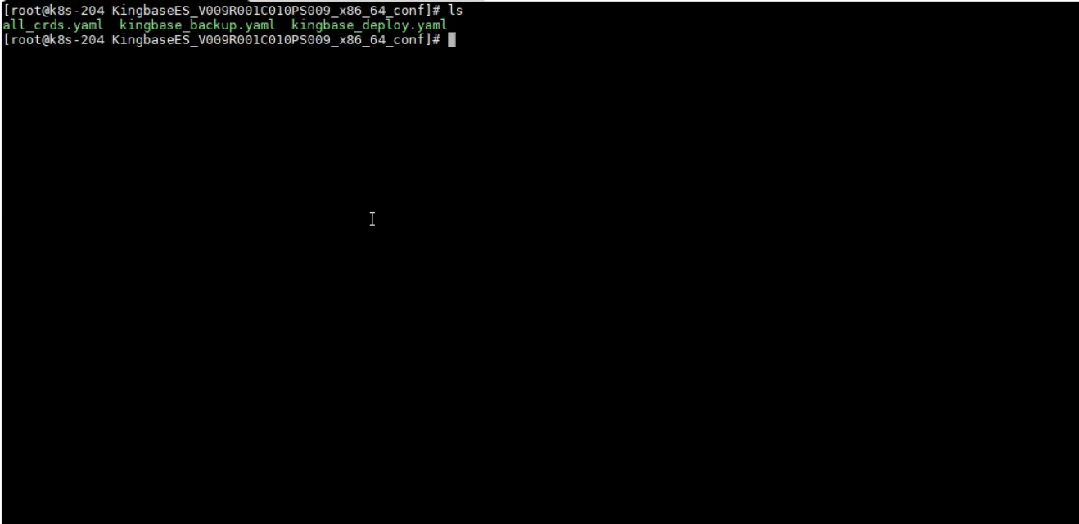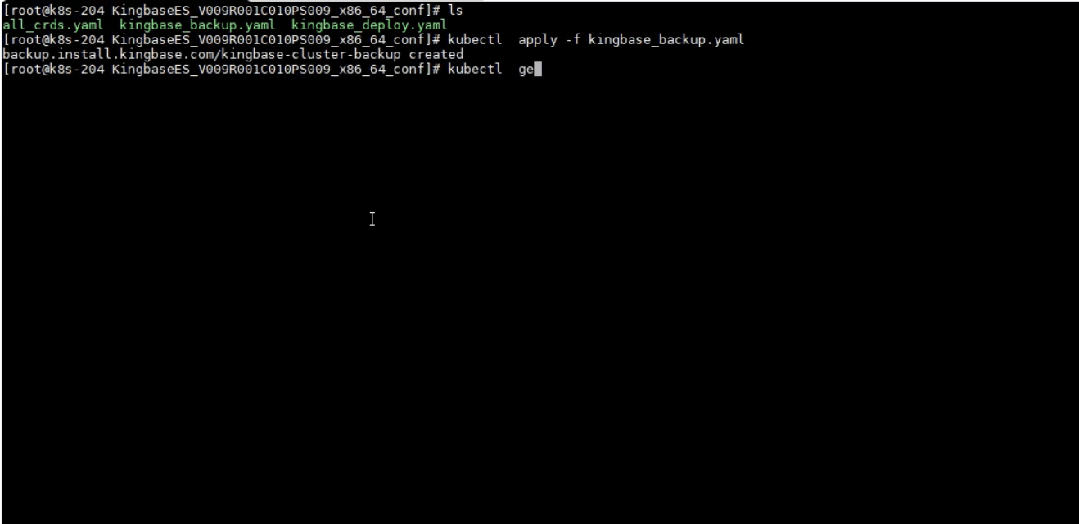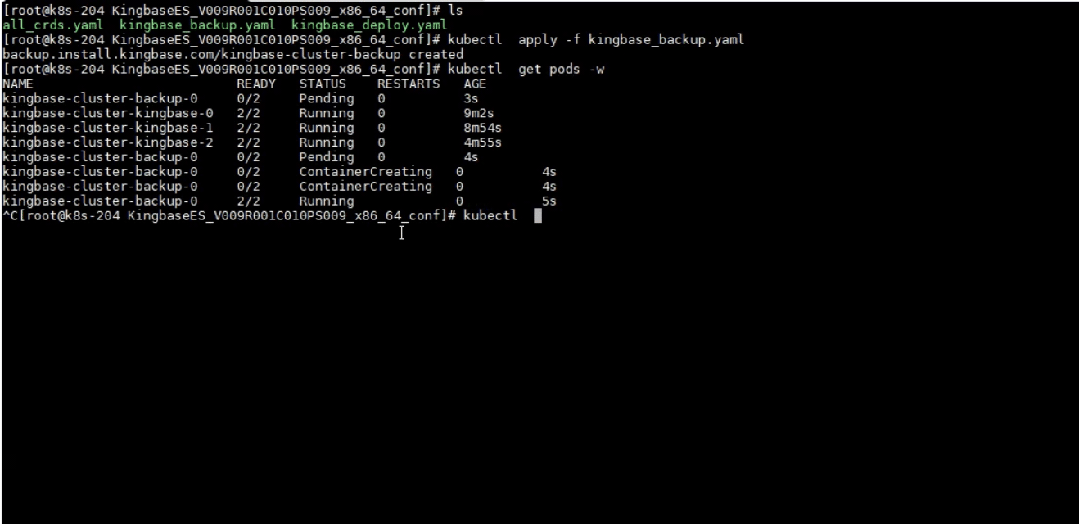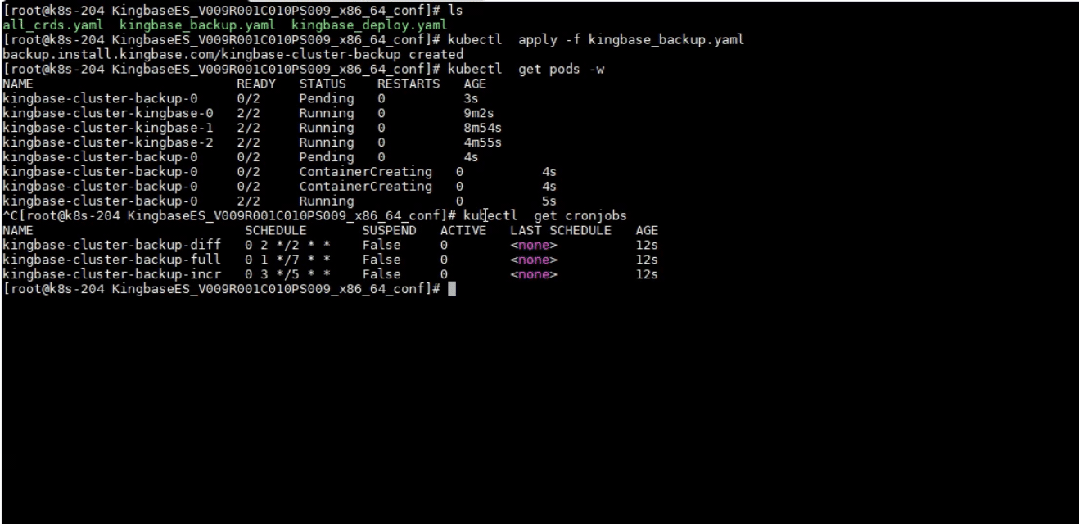
- 物理备份管理:通过配置创建和管理 KES 物理备份任务,不用再单独维护备份脚本和计划任务;
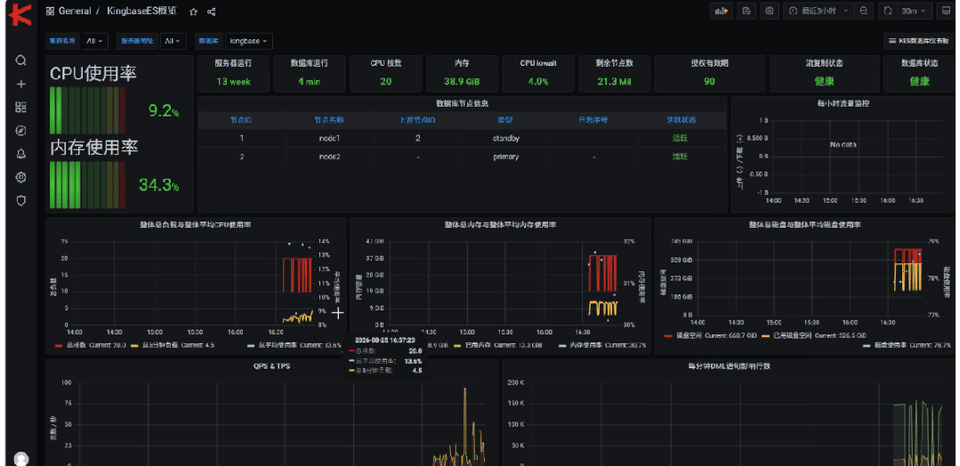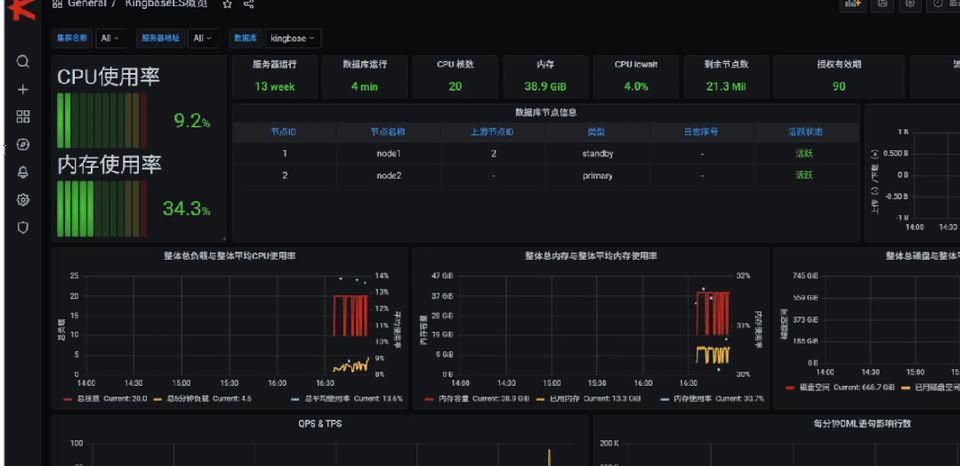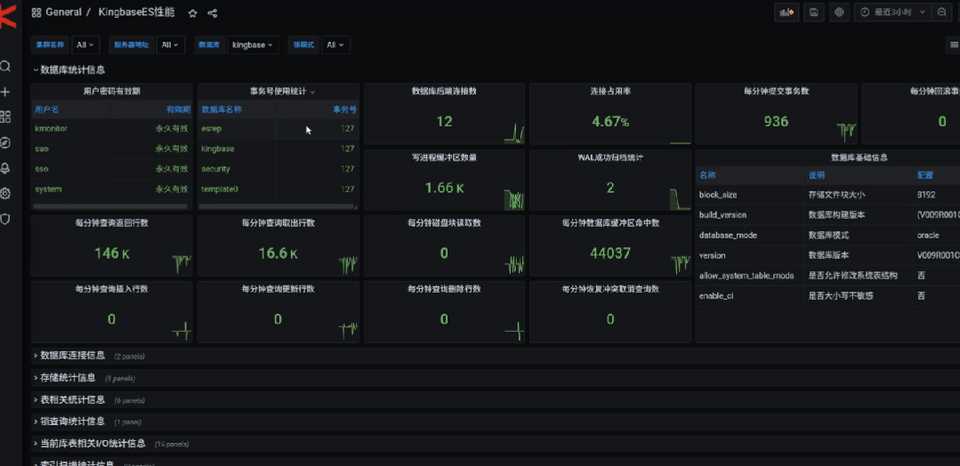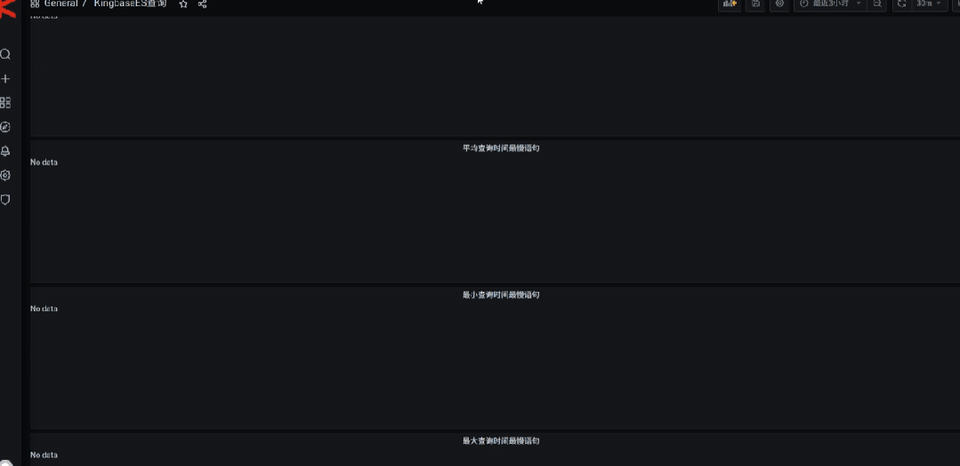
- KMonitor 监控组件管理:通过配套的 KMonitor 监控组件查看 KES 集群运行状态。
备份任务和监控信息都在 K8s 环境里统一管理,日常维护入口集中,不用在 K8s 控制台和数据库工具之间来回跳。
四、写在实际使用前
KES-Operator 的发布,意味着 KES 集群的部署、状态维护、扩缩容、备份、监控这些高频运维操作,终于可以统一收口到 Kubernetes 的管理范式下。对于已经在 K8s 上跑业务、又用金仓数据库的团队来说,DBA 可以把更多精力放在容量规划、性能调优这些真正需要人的事情上,而不是重复执行部署脚本和巡检命令。
按照官方口径,后续还会继续完善 KES-Operator 的相关能力,覆盖更多 K8s 环境下的使用和运维场景。工具已在官方渠道开放下载,感兴趣的可以直接上手体验。