2026 最新 YouTube 数据采集实战指南!本文深度解析如何使用 Python 结合 IPFoxy 动态代理,高效突破防封限制,安全抓取 YouTube 视频元数据、评论区与频道信息。含完整代码、配置教程与常见风控避坑 QA,助你零基础搭建高可用数据爬虫!
一、 YouTube 平台与数据生态介绍
YouTube 作为全球最大的视频分享平台,拥有超过 25 亿的月活跃用户。这里不仅是视频创作者的舞台,更是海量公开数据的宝库。从数据结构的角度来看,YouTube 的内容主要分为三大核心模块:
-
视频元数据(Videos): 包含视频标题、播放量、点赞数、发布时间、分类标签(Tags)与字幕。
-
互动评论(Comments): 用户在视频下方的真实反馈、讨论情感、回复树以及点赞数。
-
频道信息(Channels): 创作者的粉丝量、视频总数、历史发布的所有视频列表及其社区动态。
二、 为什么要收集 YouTube 数据?
在数据驱动决策的今天,采集并分析 YouTube 公开数据能够为多个业务场景提供强力的支撑:
出海市场与竞品分析: 通过批量监测同赛道竞品频道的更新频率、播放增长曲线与爆款视频标签,快速掌握海外用户的喜好与市场趋势。
KOL 达人筛选与营销定位: 品牌在寻找带货达人时,采集频道的粉丝互动率、评论区口碑以及历史视频表现,能精准筛选出高 ROI 的合作创作者。
社媒情感与舆情监测: 评论区是用户最真实的声音。通过对特定产品或事件相关的视频评论进行文本挖掘,可以实时感知市场舆情变化。
AI 模型训练与内容创作: 采集热门领域的视频字幕与元数据,可用于构建行业知识库,或者为大语言模型(LLM)提供高质量的语料支持。
三、 YouTube 数据采集实战教程
在实际采集过程中,频发的 IP 封禁与频率限制是最大的阻碍。为了解决这一痛点,我们需要引入 IPFoxy 动态代理,通过自动轮换干净的住宅 IP,将请求分散到全球不同节点,从而绕过平台的 IP 限制。
1、前置准备与环境配置
首先,确保 Python 环境已就绪,并安装必备的基础库:
Bash
pip install requests beautifulsoup4
2、配置 IPFoxy 动态代理
在正式发包前,我们需要将 IPFoxy 提供的代理节点集成到 Python 的请求中。使用动态住宅代理,它的每个请求都会自动分配全新的真实住宅 IP。
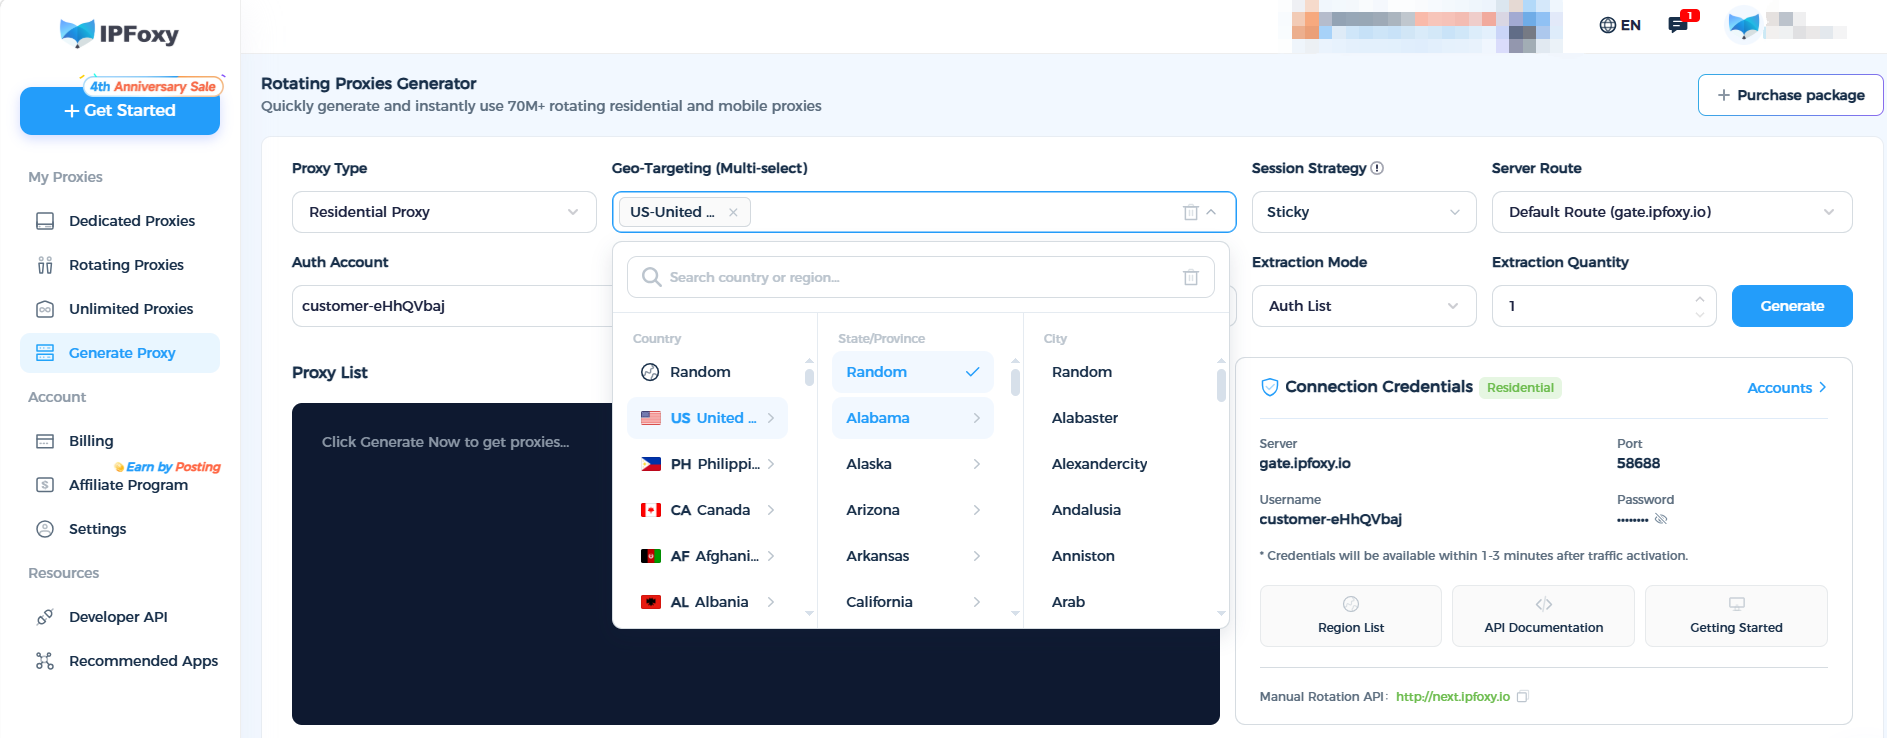
配置 IPFoxy 动态代理信息(请替换为你自己的凭据)
PROXY_USER = "your_username"
PROXY_PASS = "your_password"
PROXY_HOST = "proxy.ipfoxy.com" # IPFoxy 代理服务器地址
PROXY_PORT = "10000" # IPFoxy 动态代理端口
构建带鉴权的代理字典
proxy_url = f"http://{PROXY_USER}:{PROXY_PASS}@{PROXY_HOST}:{PROXY_PORT}"
proxies = {
"http": proxy_url,
"https": proxy_url
}
测试代理连通性与 IP 轮换
try:
response = requests.get("https://api.ipify.org?format=json", proxies=proxies, timeout=10)
print("当前使用的代理 IP:", response.json().get("ip"))
except Exception as e:
print("代理连接失败:", e)
3、核心数据采集代码 下面以获取视频元数据及解析页面嵌入数据为例,演示完整抓取逻辑:
import requests
import re
import json
def fetch_youtube_video_data(video_url, proxies):
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
"Accept-Language": "en-US,en;q=0.9"
}
try:
# 发送带代理的请求
response = requests.get(video_url, headers=headers, proxies=proxies, timeout=15)
if response.status_code == 200:
# 提取 YouTube 页面内嵌的初始化数据 JSON
match = re.search(r"var ytInitialData\\s*=\\s*({.*?});</script>", response.text)
if match:
data = json.loads(match.group(1))
print("成功解析页面数据,代理工作正常!")
return data
else:
print(f"请求失败,状态码: {response.status_code}")
except Exception as e:
print(f"抓取发生异常: {e}")
return None
# 测试抓取
target_video = "https://www.youtube.com/watch?v=dQw4w9WgXcQ"
video_data = fetch_youtube_video_data(target_video, proxies)
4、优化采集逻辑的防封小贴士
-
请求间隔随机化: 使用 time.sleep(random.uniform(1, 3)) 为代码加入随机延时,模拟真人浏览行为。
-
Header 请求头轮换: 准备多个常见的 User-Agent 组合,配合代理轮换实现双重伪装。
四、 常见问题解答(QA)
Q1:为什么使用官方 API 还经常遇到配额不足?如何解决?
A1:YouTube Data API v3 每日免费配额仅有 10,000 单位,执行几次复杂搜索或批量拉取就会耗尽。使用“无头浏览器/网络爬虫 + 动态代理”的自建采集方案,不仅不受官方 Quota 限制,还能灵活获取更多前端页面展示的细粒度数据。
Q2:数据采集过程中出现验证码(CAPTCHA)怎么处理?
A2:弹验证码通常是因为同一 IP 在短时间内触发了频繁请求。引入 动态代理 后,请求会被自动分发到不同的真实 IP 上,从根本上降低单个 IP 的风险值,大幅减少验证码触发概率。
Q3:抓取 YouTube 评论区有什么特殊技巧?
A3:YouTube 评论区采用异步滚动加载(Lazy Loading)。如果是纯 Python 请求,需要分析其后台 continuation token 的 RPC 接口;若追求开发效率,建议配合 yt-dlp 开源工具或 Playwright 无头浏览器,并挂载 IPFoxy 代理进行自动化滚动采集。
五、 总结
通过本文的技术实战,可以看到:利用现代化的底层解析工具处理复杂的协议提取,配合高性能的动态住宅代理应对严苛的 IP 风控,开发者只需极少量的代码即可建立起覆盖视频元数据、互动评论与频道全量视频的高可用数据 pipeline。这套架构能为你后续的出海竞品分析、达人营销选品以及 AI 语料库建设提供持续、稳定的数据保障。