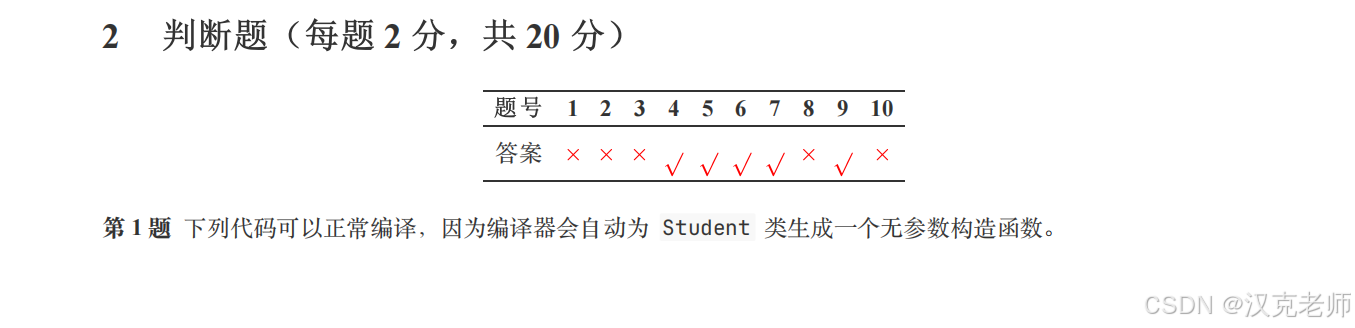
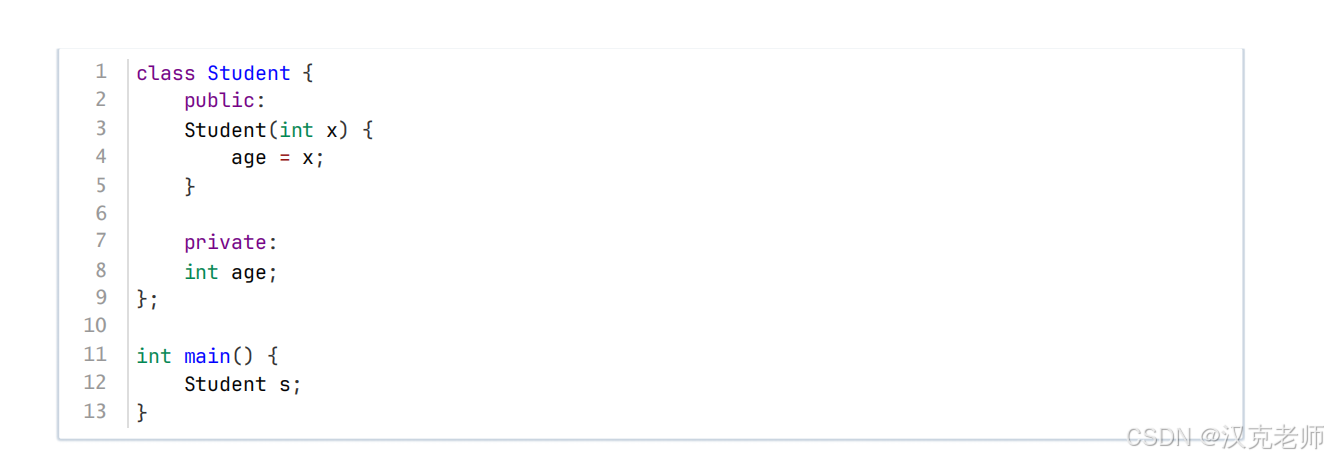
第1题:构造函数——编译器会自动送我们一个无参数构造函数吗?
题目
题目给出:
class Student {
public:
Student(int x) {
age = x;
}
private:
int age;
};
int main() {
Student s;
}
判断:
下列代码可以正常编译,因为编译器会自动为 Student 类生成一个无参数构造函数。
正确答案:错误(×)。
一、先认识构造函数
同学们,假设我们正在制作一个学生信息管理系统。
每个学生对象都有一个年龄:
int age;
我们希望创建学生时,就给他设置好年龄。
于是编写了构造函数:
Student(int x) {
age = x;
}
例如:
Student s(10);
表示创建一个学生对象,并把年龄设置为10。
注意,这个构造函数需要一个整数参数:
int x
因此,它是一个带参数的构造函数。
二、编译器什么时候会自动生成无参数构造函数?
如果我们没有声明任何构造函数,编译器通常会为类隐式声明一个默认构造函数。
例如:
class Student {
public:
int age;
};
这时:
Student s;
可以正常编译。
但是,本题不一样!
我们已经自己写了一个构造函数:
Student(int x)
此时,编译器不会再自动为我们生成无参数构造函数。
所以:
Student s;
找不到合适的构造函数,编译会失败。
三、怎样修改才能正常编译?
方法一:创建对象时传入参数。
Student s(10);
方法二:自己添加无参数构造函数。
class Student {
public:
Student() {
age = 0;
}
Student(int x) {
age = x;
}
private:
int age;
};
这样,两种写法都可以:
Student s1;
Student s2(10);
本题记忆口诀
自己写了带参数构造函数,编译器就不会自动补上无参数构造函数。
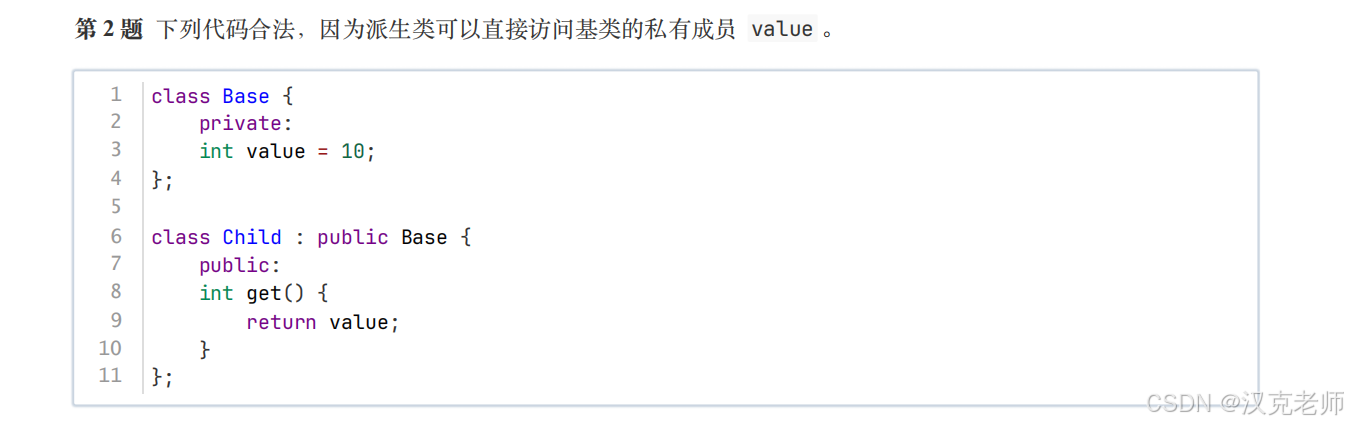
第2题:继承与访问权限——孩子能随便打开父亲的私人保险箱吗?
题目
class Base {
private:
int value = 10;
};
class Child : public Base {
public:
int get() {
return value;
}
};
判断:
下列代码合法,因为派生类可以直接访问基类的私有成员 value。
正确答案:错误(×)。
一、理解 private
想象基类 Base 是一位收藏家。
他有一个私人保险箱:
private:
int value = 10;
private 就像保险箱的密码锁。
这个成员只能由 Base 类自己的成员函数直接访问。
即使 Child 继承了 Base,也不能直接访问这个私有成员。
所以:
return value;
在 Child 的成员函数中是不合法的。
二、继承是不是把所有东西都变成 public?
不是!
继承并不意味着派生类可以随意访问基类的所有成员。
要特别区分:
| public | 可以 |
| protected | 可以 |
| private | 不可以 |
注意:这里讨论的是派生类成员函数能否直接访问基类成员,而不是对象是否继承了相应的基类部分。
三、怎样修改?
可以把 private 改为 protected:
class Base {
protected:
int value = 10;
};
class Child : public Base {
public:
int get() {
return value;
}
};
也可以保留 private,在基类中提供一个公共接口:
class Base {
private:
int value = 10;
public:
int getValue() {
return value;
}
};
class Child : public Base {
public:
int get() {
return getValue();
}
};
本题记忆口诀
继承不是万能钥匙,private 仍然是私人区域。
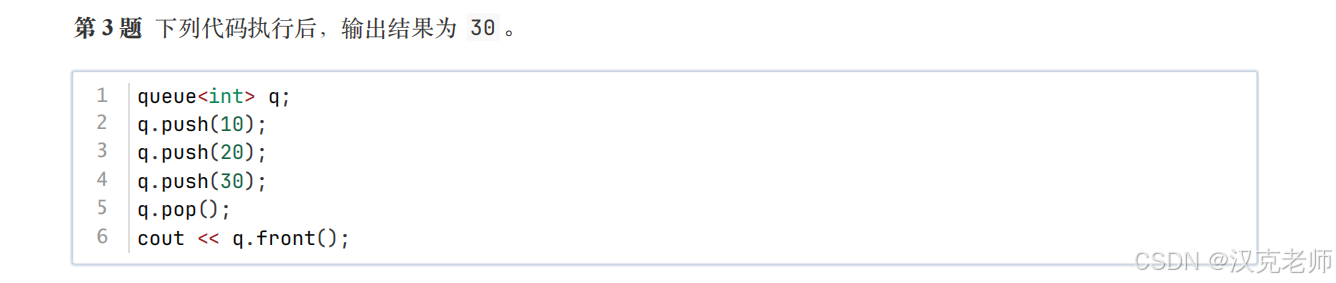
第3题:队列——出队的是谁?
题目
queue<int> q;
q.push(10);
q.push(20);
q.push(30);
q.pop();
cout << q.front();
判断:
下列代码执行后,输出结果为30。
正确答案:错误(×)。
一、队列像排队买票
队列遵循:
先进先出(FIFO)。
谁先进入队列,谁就先离开。
依次执行:
q.push(10);
q.push(20);
q.push(30);
队列变成:
队头 队尾
↓ ↓
┌────┬────┬────┐
│ 10 │ 20 │ 30 │
└────┴────┴────┘
二、执行 pop()
q.pop();
队列删除的是队头元素,也就是最先进入的 10。
删除后:
队头 队尾
↓ ↓
┌────┬────┐
│ 20 │ 30 │
└────┴────┘
三、执行 front()
cout << q.front();
front() 读取队头元素。
现在队头是 20。
因此输出:
20
不是30。
本题记忆口诀
队列先进先出,pop 删除队头,front 读取队头。

第4题:完全二叉树的数组存储——左孩子住在哪个位置?
题目
判断:
一棵完全二叉树按照从上到下、从左到右的顺序,将节点依次存储在数组 tree[1]、tree[2]、……中。若节点 tree[i] 存在左孩子,则其左孩子存储在 tree[2 * i] 中。
正确答案:正确(√)。
一、先画一棵完全二叉树
例如:
A
/ \\
B C
/ \\ /
D E F
如果按照从上到下、从左到右的顺序存储:
| tree[1] | A |
| tree[2] | B |
| tree[3] | C |
| tree[4] | D |
| tree[5] | E |
| tree[6] | F |
我们发现:
-
A 的左孩子 B 在下标2。
-
B 的左孩子 D 在下标4。
-
C 的左孩子 F 在下标6。
二、找出规律
对于下标为 i 的节点:
左孩子的下标是:
2 * i
右孩子的下标是:
2 * i + 1
例如,节点 B 在:
tree[2]
它的左孩子就在:
tree[2 * 2]
也就是:
tree[4]
正好是 D。
因此,题目中的说法正确。
本题记忆口诀
完全二叉树从1开始编号:左孩子2i,右孩子2i+1。
注意:这套公式依赖题目规定的数组存储方式和从1开始的编号。
第5题:二叉搜索树的中序遍历——为什么结果是从小到大的?
题目
代码:
void inorder(TreeNode *root) {
if (!root)
return;
inorder(root->left);
cout << root->val << " ";
inorder(root->right);
}
判断:
对任意一棵二叉搜索树执行中序遍历,得到的关键字序列一定是非递减的。
正确答案:正确(√)。
一、二叉搜索树的规则
二叉搜索树 BST 的基本性质是:
-
左子树的关键字小于当前节点的关键字。
-
右子树的关键字大于当前节点的关键字。
这里先按照关键字互不相同的常见情况理解。
例如:
8
/ \\
3 10
/ \\ \\
1 6 14
左边比根小,右边比根大。
二、中序遍历的规则
中序遍历:
左 → 根 → 右
我们先访问左子树。
左子树中的关键字都比根节点小。
然后访问根节点。
最后访问右子树。
右子树中的关键字都比根节点大。
而且左右子树内部也遵循同样的规则。
因此,中序遍历会按照关键字从小到大的顺序访问节点。
上面这棵树的中序遍历结果是:
1 3 6 8 10 14
这就是一个递增序列。
如果 BST 的定义允许重复关键字,并且重复值的放置规则也符合相应的搜索树性质,中序结果则是非递减序列,即允许相等。
本题记忆口诀
二叉搜索树中序遍历:左边小,根居中,右边大,结果有序。

第6题:BFS广度优先搜索——为什么第一次到达就是最短路?
题目
代码:
vector<int> tree[100];
bool visited[100];
int dist[100];
void search(int start) {
queue<int> q;
q.push(start);
visited[start] = true;
dist[start] = 0;
while (!q.empty()) {
int u = q.front();
q.pop();
for (int v : tree[u]) {
if (!visited[v]) {
visited[v] = true;
dist[v] = dist[u] + 1;
q.push(v);
}
}
}
}
判断:
若使用下列代码从节点 start 开始访问一棵树,则第一次到达某个节点时所经过的边数,一定是从 start 到该节点的最少边数。
正确答案:正确(√)。
一、先理解 BFS
BFS 的中文名称是:
广度优先搜索。
我们可以把它想象成往池塘里扔一颗小石子。
水波会一圈一圈向外扩散:
第0层:起点
第1层:距离起点1条边的节点
第2层:距离起点2条边的节点
第3层:距离起点3条边的节点
BFS 使用队列,按照发现节点的先后顺序处理它们。
二、为什么第一次到达就是最短的?
假设从 A 出发:
A
/ \\
B C
/ \\
D E
BFS 首先访问 A。
然后发现 B、C。
再访问 B、C,发现 D、E。
访问顺序是:
A → B → C → D → E
距离分别是:
| A | 0 |
| B | 1 |
| C | 1 |
| D | 2 |
| E | 2 |
BFS 是按距离一层一层扩展的。
因此,在无权图中,节点第一次被发现时,就已经通过最少边数的路径到达了它。
本题讨论的是树。树中任意两个节点之间只有一条简单路径,因此从起点到某个节点的路径本身也是唯一的。
代码中:
dist[v] = dist[u] + 1;
就是在记录从起点到新发现节点的距离。
本题记忆口诀
BFS像水波,一层一层扩散;无权图中,第一次发现就是最短距离。
注意:这里的最短距离指的是边数最少。如果边有不同的长度或代价,就不能直接套用这个结论。

第7题:哈夫曼编码——频率高的字符,编码一定更短吗?
题目
判断:
哈夫曼编码的生成过程基于贪心算法,出现频率越高的字符,其编码长度一定不会比出现频率更低的字符更长。
正确答案:正确(√)。
一、先理解编码长度
想象我们要给一组字符设计二进制编码。
每个字符对应一条从根节点走到叶子节点的路径。
例如:
根
/ \\
0 1
如果一个字符对应的路径只有1条边,那么它的编码长度就是1。
如果路径有3条边,那么编码长度就是3。
在哈夫曼编码中,我们希望出现频率高的字符尽量使用较短的编码,从而降低整体的带权路径长度。
二、为什么高频字符不会比低频字符更长?
假设有两个字符:
-
字符 A 的频率是10。
-
字符 B 的频率是2。
假设某个编码树中:
-
A 的编码长度是4。
-
B 的编码长度是2。
那么它们对 WPL 的贡献分别是:
A:10 × 4 = 40
B: 2 × 2 = 4
如果交换 A、B 在树中的位置:
A:10 × 2 = 20
B: 2 × 4 = 8
总贡献从:
40 + 4 = 44
变成:
20 + 8 = 28
WPL 变小了。
所以,原来的安排不可能是最优的哈夫曼编码。
一般来说,如果一个字符频率更高,却拥有更长的编码,那么交换它与较低频字符的编码位置,就会使 WPL 下降,与哈夫曼编码的最优性矛盾。
因此,在最优哈夫曼编码中,频率较高的字符不会比频率较低的字符拥有更长的编码。
本题记忆口诀
哈夫曼追求总成本最小:高频字符不能被安排得比低频字符更深。

第8题:格雷编码——任意两个编码都只差一位吗?
题目
判断:
在 n 位格雷码中,任意两个编码之间都只相差一个二进制位。
正确答案:错误(×)。
一、格雷编码的真正性质
格雷编码有一个重要特点:
按照格雷编码的排列顺序,相邻的两个编码恰好只有一位不同。
例如,2位格雷码:
00
01
11
10
比较相邻编码:
00 → 01
只有最后一位不同。
01 → 11
只有第一位不同。
11 → 10
也只有一位不同。
二、题目错在哪里?
题目说的是:
任意两个编码之间都只相差一个二进制位。
“任意两个”比“相邻两个”范围大得多。
例如:
00
11
这两个编码相差两位:
00
11
↑↑
所以,任意两个格雷编码之间不一定只差一位。
题目把“相邻编码”偷换成了“任意编码”,因此错误。
本题记忆口诀
格雷码只保证相邻编码差一位,不保证任意两个编码都差一位。
第9题:完全背包——为什么容量从小到大,就能重复选择物品?
题目
代码:
for (int i = 0; i < n; ++i) {
for (int w = weight[i]; w <= W; ++w) {
dp[w] = max(dp[w],
dp[w – weight[i]] + value[i]);
}
}
判断:
下列一维动态规划代码实现的是完全背包问题,因为在处理第 i 种物品时,同一种物品可能被重复选择。
正确答案:正确(√)。
一、先认识完全背包
想象你有一个魔法背包,容量是 W。
现在有一些种类的物品,每种物品都有:
-
重量 weight[i]。
-
价值 value[i]。
完全背包允许:
每种物品可以选择任意多次,只要背包容量允许。
例如,有一种重量为2、价值为3的宝石。
如果背包容量为6,那么我们可以选择:
1颗:重量2,价值3
2颗:重量4,价值6
3颗:重量6,价值9
因此,同一种物品可以重复选择。
二、代码为什么使用从小到大的循环?
关键代码:
for (int w = weight[i]; w <= W; ++w)
容量从小到大枚举。
转移公式:
dp[w] = max(dp[w],
dp[w – weight[i]] + value[i]);
假设:
物品重量 = 2
物品价值 = 3
当计算:
w = 2
我们可以选择一颗宝石:
dp[2] = 3
接着计算:
w = 4
这时:
dp[4] = max(dp[4], dp[2] + 3);
由于 dp[2] 已经在本轮更新为3,所以:
dp[4] = 6
这相当于选择了两颗宝石。
继续计算:
w = 6
此时:
dp[6] = max(dp[6], dp[4] + 3);
得到:
dp[6] = 9
相当于选择了三颗宝石。
所以,从小到大更新容量,允许当前物品的最新状态继续参与后面的计算,从而实现重复选择。
本题记忆口诀
完全背包容量正序,可以重复选择;0/1背包容量倒序,避免重复选择。
第10题:斐波那契递归——代码简短,运行就一定快吗?
题目
int fib(int n) {
if (n <= 1)
return n;
return fib(n – 1) + fib(n – 2);
}
判断:
下列递归程序能得到正确的斐波那契数,其时间复杂度和空间复杂度都是 O(n)。
正确答案:错误(×)。
一、先认识斐波那契数列
斐波那契数列规定:
fib(0) = 0
fib(1) = 1
从第三项开始:
fib(n) = fib(n – 1) + fib(n – 2)
例如:
0、1、1、2、3、5、8、13……
题目中的程序正是按照这个定义编写的。
因此,对于正常的非负整数输入,它能够计算正确的斐波那契数。
但是,程序能够算对,不代表它运行得快。
二、为什么时间复杂度不是 O(n)?
看这句:
return fib(n – 1) + fib(n – 2);
为了计算 fib(n),程序需要计算:
fib(n – 1)
fib(n – 2)
而计算 fib(n – 1),又会继续计算:
fib(n – 2)
fib(n – 3)
于是,许多相同的子问题被重复计算。
例如:
fib(5)
├── fib(4)
│ ├── fib(3)
│ └── fib(2)
└── fib(3)
├── fib(2)
└── fib(1)
你发现了吗?
fib(3) 被计算了不止一次,fib(2) 也被计算了不止一次。
当 n 增大时,递归调用的数量会快速增长。
所以,这种朴素递归的时间复杂度是指数级的,常用上界表示为:
O(2^n)
三、空间复杂度为什么是 O(n)?
虽然程序会产生很多递归调用,但这些调用不一定全部同时留在内存中。
程序执行:
fib(n – 1)
时,会先深入计算这条递归分支。
递归调用需要等待下层函数返回,因此函数调用栈会逐层增加。
最深时,调用层数与 n 成正比。
所以递归调用栈所需要的额外空间是:
O(n)
因此:
| 时间复杂度 | 指数级,常用上界表示为 O(2ⁿ) |
| 空间复杂度 | O(n) |
题目说时间复杂度和空间复杂度都是 O(n),由于时间复杂度不正确,所以整句话错误。
本题记忆口诀
朴素斐波那契递归:重复计算很多次,时间指数级;递归深度与 n 成正比,栈空间 O(n)。
第二部分判断题1~10题答案汇总
| 1 | × | 自定义带参数构造函数后,不会自动生成无参数构造函数 |
| 2 | × | 派生类不能直接访问基类的 private 成员 |
| 3 | × | 队列先进先出,pop 删除队头,front 读取队头 |
| 4 | √ | 完全二叉树数组存储:左孩子下标为 2i |
| 5 | √ | 二叉搜索树中序遍历得到非递减序列 |
| 6 | √ | BFS 在无权图中按距离逐层扩展,第一次发现即为最短距离 |
| 7 | √ | 最优哈夫曼编码中,高频字符不会比低频字符拥有更长编码 |
| 8 | × | 格雷码只保证相邻编码相差一位 |
| 9 | √ | 完全背包容量正序更新,允许重复选择物品 |
| 10 | × | 朴素斐波那契递归时间复杂度为指数级,空间复杂度为 O(n) |
给同学们的最后提醒:判断题最怕三个字——“想当然”
做判断题时,建议大家养成三个习惯:
第一,遇到“自动生成”,先检查有没有特殊条件。
例如,类中已经声明了带参数构造函数,就不能想当然地认为编译器还会自动提供无参数构造函数。
第二,遇到“一定”“任意”,主动寻找反例。
例如,格雷编码相邻的编码只差一位,但任意两个编码不一定只差一位。
第三,遇到算法复杂度,不要只看代码有几行。
例如,斐波那契递归只有几行代码,却会产生大量重复计算。代码短,不代表运行快。
真正的编程能力,不是看到熟悉的代码就立刻选答案,而是能够解释:为什么正确?为什么错误?有没有反例?
把这三个习惯练好,判断题就不再只是猜对错,而会成为检验我们是否真正理解 C++ 和算法的好机会!