【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
20、【数学】【信息论】信息量为什么是
−
log
p
-\\log p
−logp:可加性如何锁死对数
背景
上篇 blog 【数学】【基础】幂级数的收敛与欧拉公式:为什么可以这样展开 把幂级数的收敛范围讲清了:收敛半径
R
R
R 划出一条边界,
∣
x
−
a
∣
<
R
|x-a|<R
∣x−a∣<R 内收敛、之外发散,复平面上就是一个收敛圆盘;收敛区间内部绝对收敛,因此允许任意重排与分组,正是这一点担保了欧拉公式里"把
e
i
θ
e^{i\\theta}
eiθ 的级数按奇偶拆开、偶次汇成
cos
θ
\\cos\\theta
cosθ、奇次汇成
i
sin
θ
i\\sin\\theta
isinθ"这一步合法。
到这里,“连续世界的展开"告一段落。本篇换回信息论:第 13 篇 【数学】【信息论】信息量、熵与交叉熵:从
−
log
p
-\\log p
−logp 到 KL 散度 直接写出单个结果的信息量是
I
(
x
)
=
−
log
p
(
x
)
I(x)=-\\log p(x)
I(x)=−logp(x),并把它当作已知;但为什么偏偏是负对数,而不是别的式子,当时只给了一句"独立事件的信息量应当可加”。本篇把这个"为什么"补完——会发现根子在第 10 篇 【数学】【基础】对数与自然对数:从乘法到加法 讲的那条性质:对数把乘法变成加法。
从"惊讶"到信息量
一个事件发生的概率越小,它一旦发生带来的"惊讶"越大。这个直觉人人都有:太阳升起几乎是必然,没人会惊讶;而抽中一张罕见到百万分之一的彩票,才会让人震惊。信息量(self-information)就是把这种"惊讶程度"量化成数字。
先不急着写公式,而是问:一个好的"惊讶度量"
I
(
p
)
I(p)
I(p) 应当满足哪些天然要求?把它当成一个待定的函数
I
I
I,输入概率
p
p
p、输出一个非负的数字,看看能把它逼到什么程度。
三条基本要求
要求一:连续。 概率从
0.5
0.5
0.5 微调到
0.50001
0.50001
0.50001,惊讶程度不应突然跳变。函数
I
(
p
)
I(p)
I(p) 在
(
0
,
1
]
(0,1]
(0,1] 上连续。
要求二:单调递减,且
I
(
1
)
=
0
I(1)=0
I(1)=0。 概率越大越不惊讶;概率为
1
1
1(必然发生)时,信息量为零,因为它的发生没带来任何新信息。反过来,
p
→
0
p\\to0
p→0 时
I
(
p
)
→
+
∞
I(p)\\to+\\infty
I(p)→+∞。
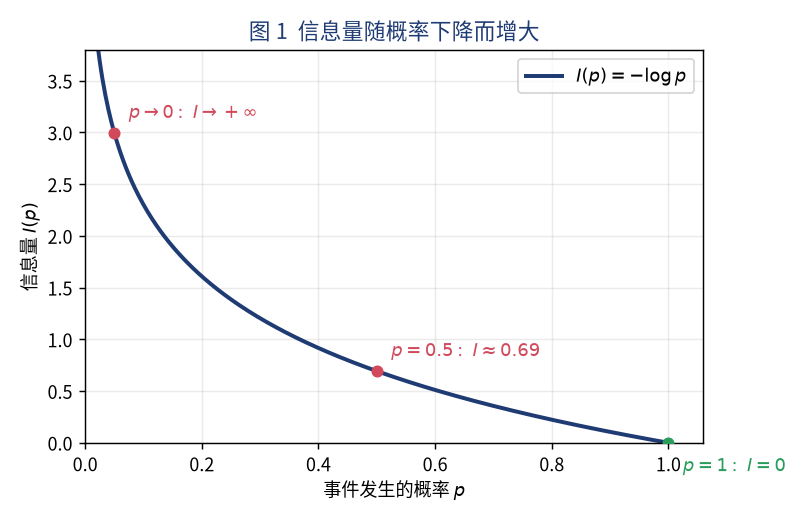
图 1 画出满足前两条要求的曲线形状:
p
=
1
p=1
p=1 处落在
0
0
0,
p
=
0.5
p=0.5
p=0.5 处约
0.69
0.69
0.69,越接近
0
0
0 越陡峭、冲向上方。可是单看这两条,能画出无数条这样的曲线——光有"连续 + 单调",形状是定不下来的。
要求三:独立可加
关键的第三条来了。两个相互独立的事件同时发生,其信息量应当等于各自信息量之和:
I
(
p
1
p
2
)
=
I
(
p
1
)
+
I
(
p
2
)
I(p_1p_2)=I(p_1)+I(p_2)
I(p1p2)=I(p1)+I(p2)
这一条把"同时发生"翻译成信息的累加。它的合理性来自概率的乘法法则:独立事件的联合概率是各自概率之积,而"两件消息一起收到"的惊讶,自然应该是两条消息各自惊讶之和。
用一组数字感受:两个各为
0.5
0.5
0.5 的独立事件,联合概率是
0.5
×
0.5
=
0.25
0.5\\times0.5=0.25
0.5×0.5=0.25。若
I
(
0.5
)
=
0.69
I(0.5)=0.69
I(0.5)=0.69,可加性要求
I
(
0.25
)
I(0.25)
I(0.25) 必须等于
0.69
+
0.69
=
1.39
0.69+0.69=1.39
0.69+0.69=1.39——而
−
ln
0.25
≈
1.39
-\\ln 0.25\\approx1.39
−ln0.25≈1.39,正好吻合。
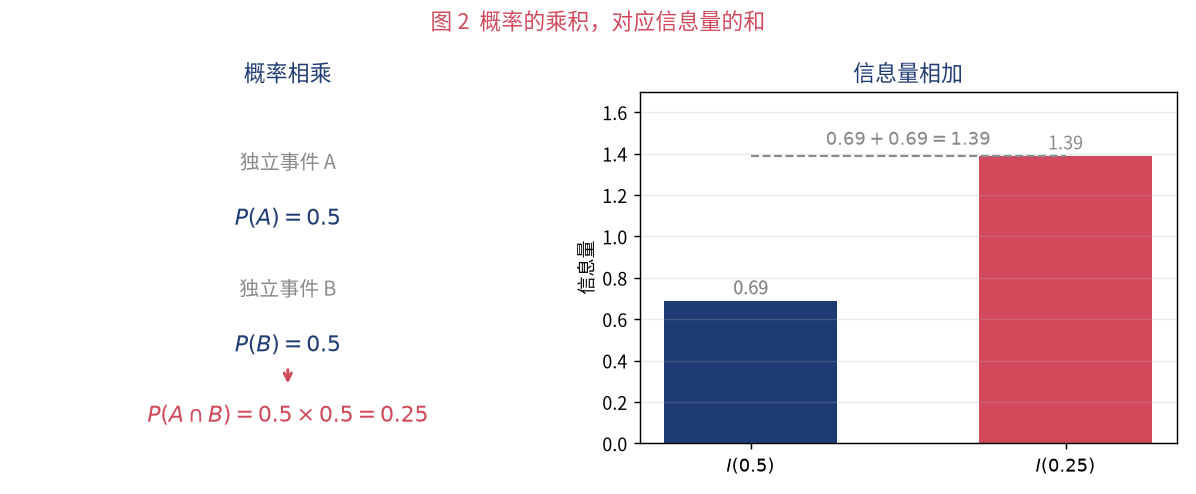
图 2 左边是概率相乘、右边是信息量相加。"相乘"与"相加"之间的这座桥,正是对数。
可加性把对数锁死
现在把第三条要求单独拿出来推。要找一个连续函数
I
(
p
)
I(p)
I(p),满足
I
(
p
1
p
2
)
=
I
(
p
1
)
+
I
(
p
2
)
I(p_1p_2)=I(p_1)+I(p_2)
I(p1p2)=I(p1)+I(p2)
这种"输入相乘、输出相加"的函数方程,叫柯西函数方程(Cauchy functional equation) 的乘法形式。做一步代换就能看出它的解:令
p
=
e
−
t
p=e^{-t}
p=e−t(
t
≥
0
t\\ge0
t≥0),并记
h
(
t
)
=
I
(
e
−
t
)
h(t)=I(e^{-t})
h(t)=I(e−t),则
h
(
t
1
+
t
2
)
=
I
(
e
−
(
t
1
+
t
2
)
)
=
I
(
e
−
t
1
e
−
t
2
)
=
I
(
e
−
t
1
)
+
I
(
e
−
t
2
)
=
h
(
t
1
)
+
h
(
t
2
)
h(t_1+t_2)=I\\big(e^{-(t_1+t_2)}\\big)=I\\big(e^{-t_1}e^{-t_2}\\big)=I(e^{-t_1})+I(e^{-t_2})=h(t_1)+h(t_2)
h(t1+t2)=I(e−(t1+t2))=I(e−t1e−t2)=I(e−t1)+I(e−t2)=h(t1)+h(t2)
代换之后,“相乘变相加"变成了熟悉的加法形式
h
(
t
1
+
t
2
)
=
h
(
t
1
)
+
h
(
t
2
)
h(t_1+t_2)=h(t_1)+h(t_2)
h(t1+t2)=h(t1)+h(t2)。连续的函数满足这种"加法方程”,只有直线:
h
(
t
)
=
k
t
⟹
I
(
p
)
=
h
(
−
ln
p
)
=
−
k
ln
p
h(t)=kt\\quad\\Longrightarrow\\quad I(p)=h(-\\ln p)=-k\\ln p
h(t)=kt⟹I(p)=h(−lnp)=−klnp
“连续 + 可加一定是直线”,这一步可以分三段看:对正整数
n
n
n,反复用可加性得
h
(
n
t
)
=
n
h
(
t
)
h(nt)=nh(t)
h(nt)=nh(t);对有理数
m
n
\\frac{m}{n}
nm,由
h
(
t
)
=
h
(
n
⋅
t
n
)
=
n
h
(
t
n
)
h(t)=h\\big(n\\cdot\\frac{t}{n}\\big)=n\\,h\\big(\\frac{t}{n}\\big)
h(t)=h(n⋅nt)=nh(nt) 得
h
(
m
n
t
)
=
m
n
h
(
t
)
h\\big(\\frac{m}{n}t\\big)=\\frac{m}{n}h(t)
h(nmt)=nmh(t);有理点在实数轴上处处稠密,再借连续性把结论从稠密的点"填满"到全体实数。于是
h
h
h 只能是一条过原点、斜率为
k
k
k 的直线。
再由要求二(单调递减、
I
(
1
)
=
0
I(1)=0
I(1)=0)定出常数:
I
(
1
)
=
0
I(1)=0
I(1)=0 自动成立;要让它随
p
p
p 增大而减小,必须
k
>
0
k>0
k>0。于是只剩下
I
(
p
)
=
−
c
ln
p
,
c
>
0
I(p)=-c\\ln p,\\quad c>0
I(p)=−clnp,c>0
把常数
c
c
c 归一(取
c
=
1
c=1
c=1、底数取
e
e
e),就得到第 13 篇直接给出的式子
I
(
p
)
=
−
ln
p
I(p)=-\\ln p
I(p)=−lnp。至此三条要求把函数形式唯一地锁死成了负对数。
为什么不是别的函数
有人会想:既然要递减,那用
I
(
p
)
=
1
−
p
I(p)=1-p
I(p)=1−p 行不行?它确实递减、也在
p
=
1
p=1
p=1 处归零。但它过不了可加性:取
p
1
=
p
2
=
0.5
p_1=p_2=0.5
p1=p2=0.5,左边
I
(
0.25
)
=
0.75
I(0.25)=0.75
I(0.25)=0.75,右边
I
(
0.5
)
+
I
(
0.5
)
=
1.0
I(0.5)+I(0.5)=1.0
I(0.5)+I(0.5)=1.0,两者不等。同理
I
(
p
)
=
1
p
−
1
I(p)=\\frac{1}{p}-1
I(p)=p1−1、
I
(
p
)
=
(
1
−
p
)
2
I(p)=(1-p)^2
I(p)=(1−p)2 也都不满足
I
(
p
1
p
2
)
=
I
(
p
1
)
+
I
(
p
2
)
I(p_1p_2)=I(p_1)+I(p_2)
I(p1p2)=I(p1)+I(p2)。把几个候选函数并列,失败点一目了然:
|
− log p -\\log p −logp |
✅ | ✅ | ✅ |
|
1 − p 1-p 1−p |
✅ | ✅ | ❌ |
|
( 1 − p ) 2 (1-p)^2 (1−p)2 |
✅ | ✅ | ❌ |
|
1 p − 1 \\dfrac{1}{p}-1 p1−1 |
✅ | ✅ | ❌ |
这就回答了"为什么不是其他公式":
- 连续 + 单调只画出一个形状族,不足以定死;
- 一旦加上独立可加,乘法形式就成了柯西方程,而它的连续解只有对数这一族;
- 其余单调递减函数统统在可加性上失败。
一个补充:如果放弃连续性,柯西方程会出现一堆病态解(借助 Hamel 基构造,图像处处不连续),但它们没有物理意义。保留"连续性"这条最弱也最自然的假设,解就唯一了。
底数与单位:只差一个常数倍
对数的底数可以换。以
a
a
a 为底的信息量与自然对数之间,只差一个常数因子:
I
a
(
p
)
=
−
log
a
p
=
−
ln
p
ln
a
=
1
ln
a
I
e
(
p
)
I_a(p)=-\\log_a p=\\frac{-\\ln p}{\\ln a}=\\frac{1}{\\ln a}\\,I_e(p)
Ia(p)=−logap=lna−lnp=lna1Ie(p)
所以换底不改变曲线的形状,只是整体纵向缩放。两种常用刻度是:
- 以
2
2
2 为底:单位是 bit(比特) ,适合"需要几个是/否问题"的离散视角; - 以
e
e
e 为底:单位是 nat(奈特) ,是连续世界里的自然单位,第 12 篇 【数学】【基础】e 的意义:连续变化世界的自然单位 讲过e
e
e 承载着"连续变化世界的自然单位"这一角色。
同一个
p
=
0.5
p=0.5
p=0.5,以
2
2
2 为底得
1
1
1 bit,以
e
e
e 为底得
0.69
0.69
0.69 nat,两者描述的是同一件事。
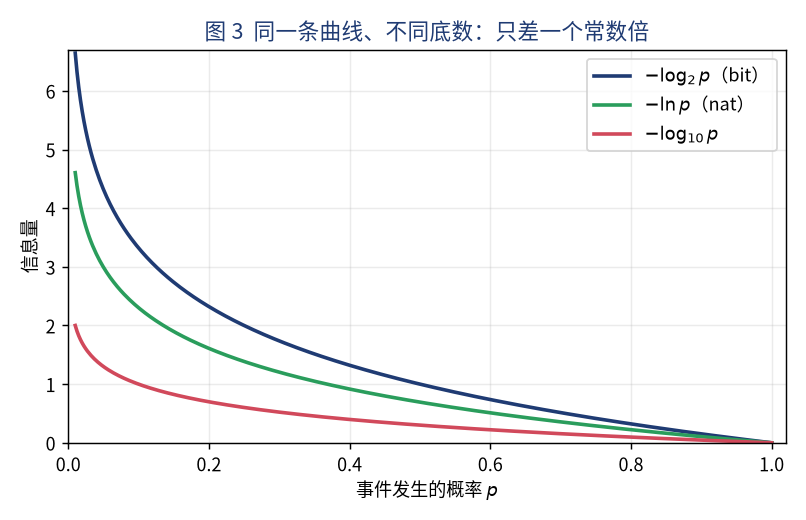
图 3 把三条曲线画在同一张图上:它们形状一致、只是被
1
/
ln
a
1/\\ln a
1/lna 缩放,底数越大曲线越"矮"。
一个具体例子:抛硬币与比特
以
2
2
2 为底时,"信息量"和"要问几个是/否问题才能确定结果"直接对应。看一组例子:
| 1 次公平抛硬币(正/反) |
1 2 \\frac12 21 |
− log 2 1 2 = 1 -\\log_2\\frac12=1 −log221=1 |
| 3 次独立抛硬币(共 8 种) |
1 8 \\frac18 81 |
− log 2 1 8 = 3 -\\log_2\\frac18=3 −log281=3 |
| 1 字节(共 256 种取值) |
1 256 \\frac{1}{256} 2561 |
− log 2 1 256 = 8 -\\log_2\\frac{1}{256}=8 −log22561=8 |
3 次抛硬币一共
8
8
8 种等概率结果,每种概率
1
8
\\frac18
81、信息量
3
3
3 bit;而这正好等于
3
3
3 个"一次抛硬币"的信息量之和(
1
+
1
+
1
1+1+1
1+1+1)——独立可加在这里表现为"独立试验的信息量相加"。1 字节有
256
256
256 种取值,信息量恰好
8
8
8 bit,也就有了"
1
1
1 字节
=
8
=8
=8 比特"这个说法。
两个常见疑问
- “信息量会不会是负数?”:不会。概率
p
p
p 落在(
0
,
1
]
(0,1]
(0,1],−
log
p
≥
0
-\\log p\\ge0
−logp≥0,只可能为0
0
0(当p
=
1
p=1
p=1)或为正。定义域不取p
=
0
p=0
p=0,因为log
0
\\log0
log0 发散——现实中把它当成"不可能事件"、不赋予信息量即可。 - “信息量和概率是反比吗?”:是"反向",但不是"反比"。概率减半,信息量只增加一个固定的
ln
2
\\ln2
ln2,而不是翻倍:p
=
0.5
p=0.5
p=0.5 时0.69
0.69
0.69,p
=
0.25
p=0.25
p=0.25 时1.39
1.39
1.39,p
=
0.125
p=0.125
p=0.125 时2.08
2.08
2.08——每减半一次、加0.69
0.69
0.69。这正是对数曲线的特征,也是它区别于任何线性递减函数的地方。
小结
从"越意外信息量越大"的直觉出发,三条天然要求(连续、单调递减且
I
(
1
)
=
0
I(1)=0
I(1)=0、独立可加)逐步收敛:可加性把问题化为柯西函数方程,而它的连续解只有对数一族,于是
I
(
p
)
=
−
c
ln
p
I(p)=-c\\ln p
I(p)=−clnp 被唯一确定——这就是第 13 篇里
−
log
p
-\\log p
−logp 的来历,根子是第 10 篇"对数把乘法变成加法"。换底只带来一个常数缩放,对应 bit 与 nat 两种单位。单点信息量定了,下一步就能把它按概率加权平均,得到整个分布的不确定性——那就是熵。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!