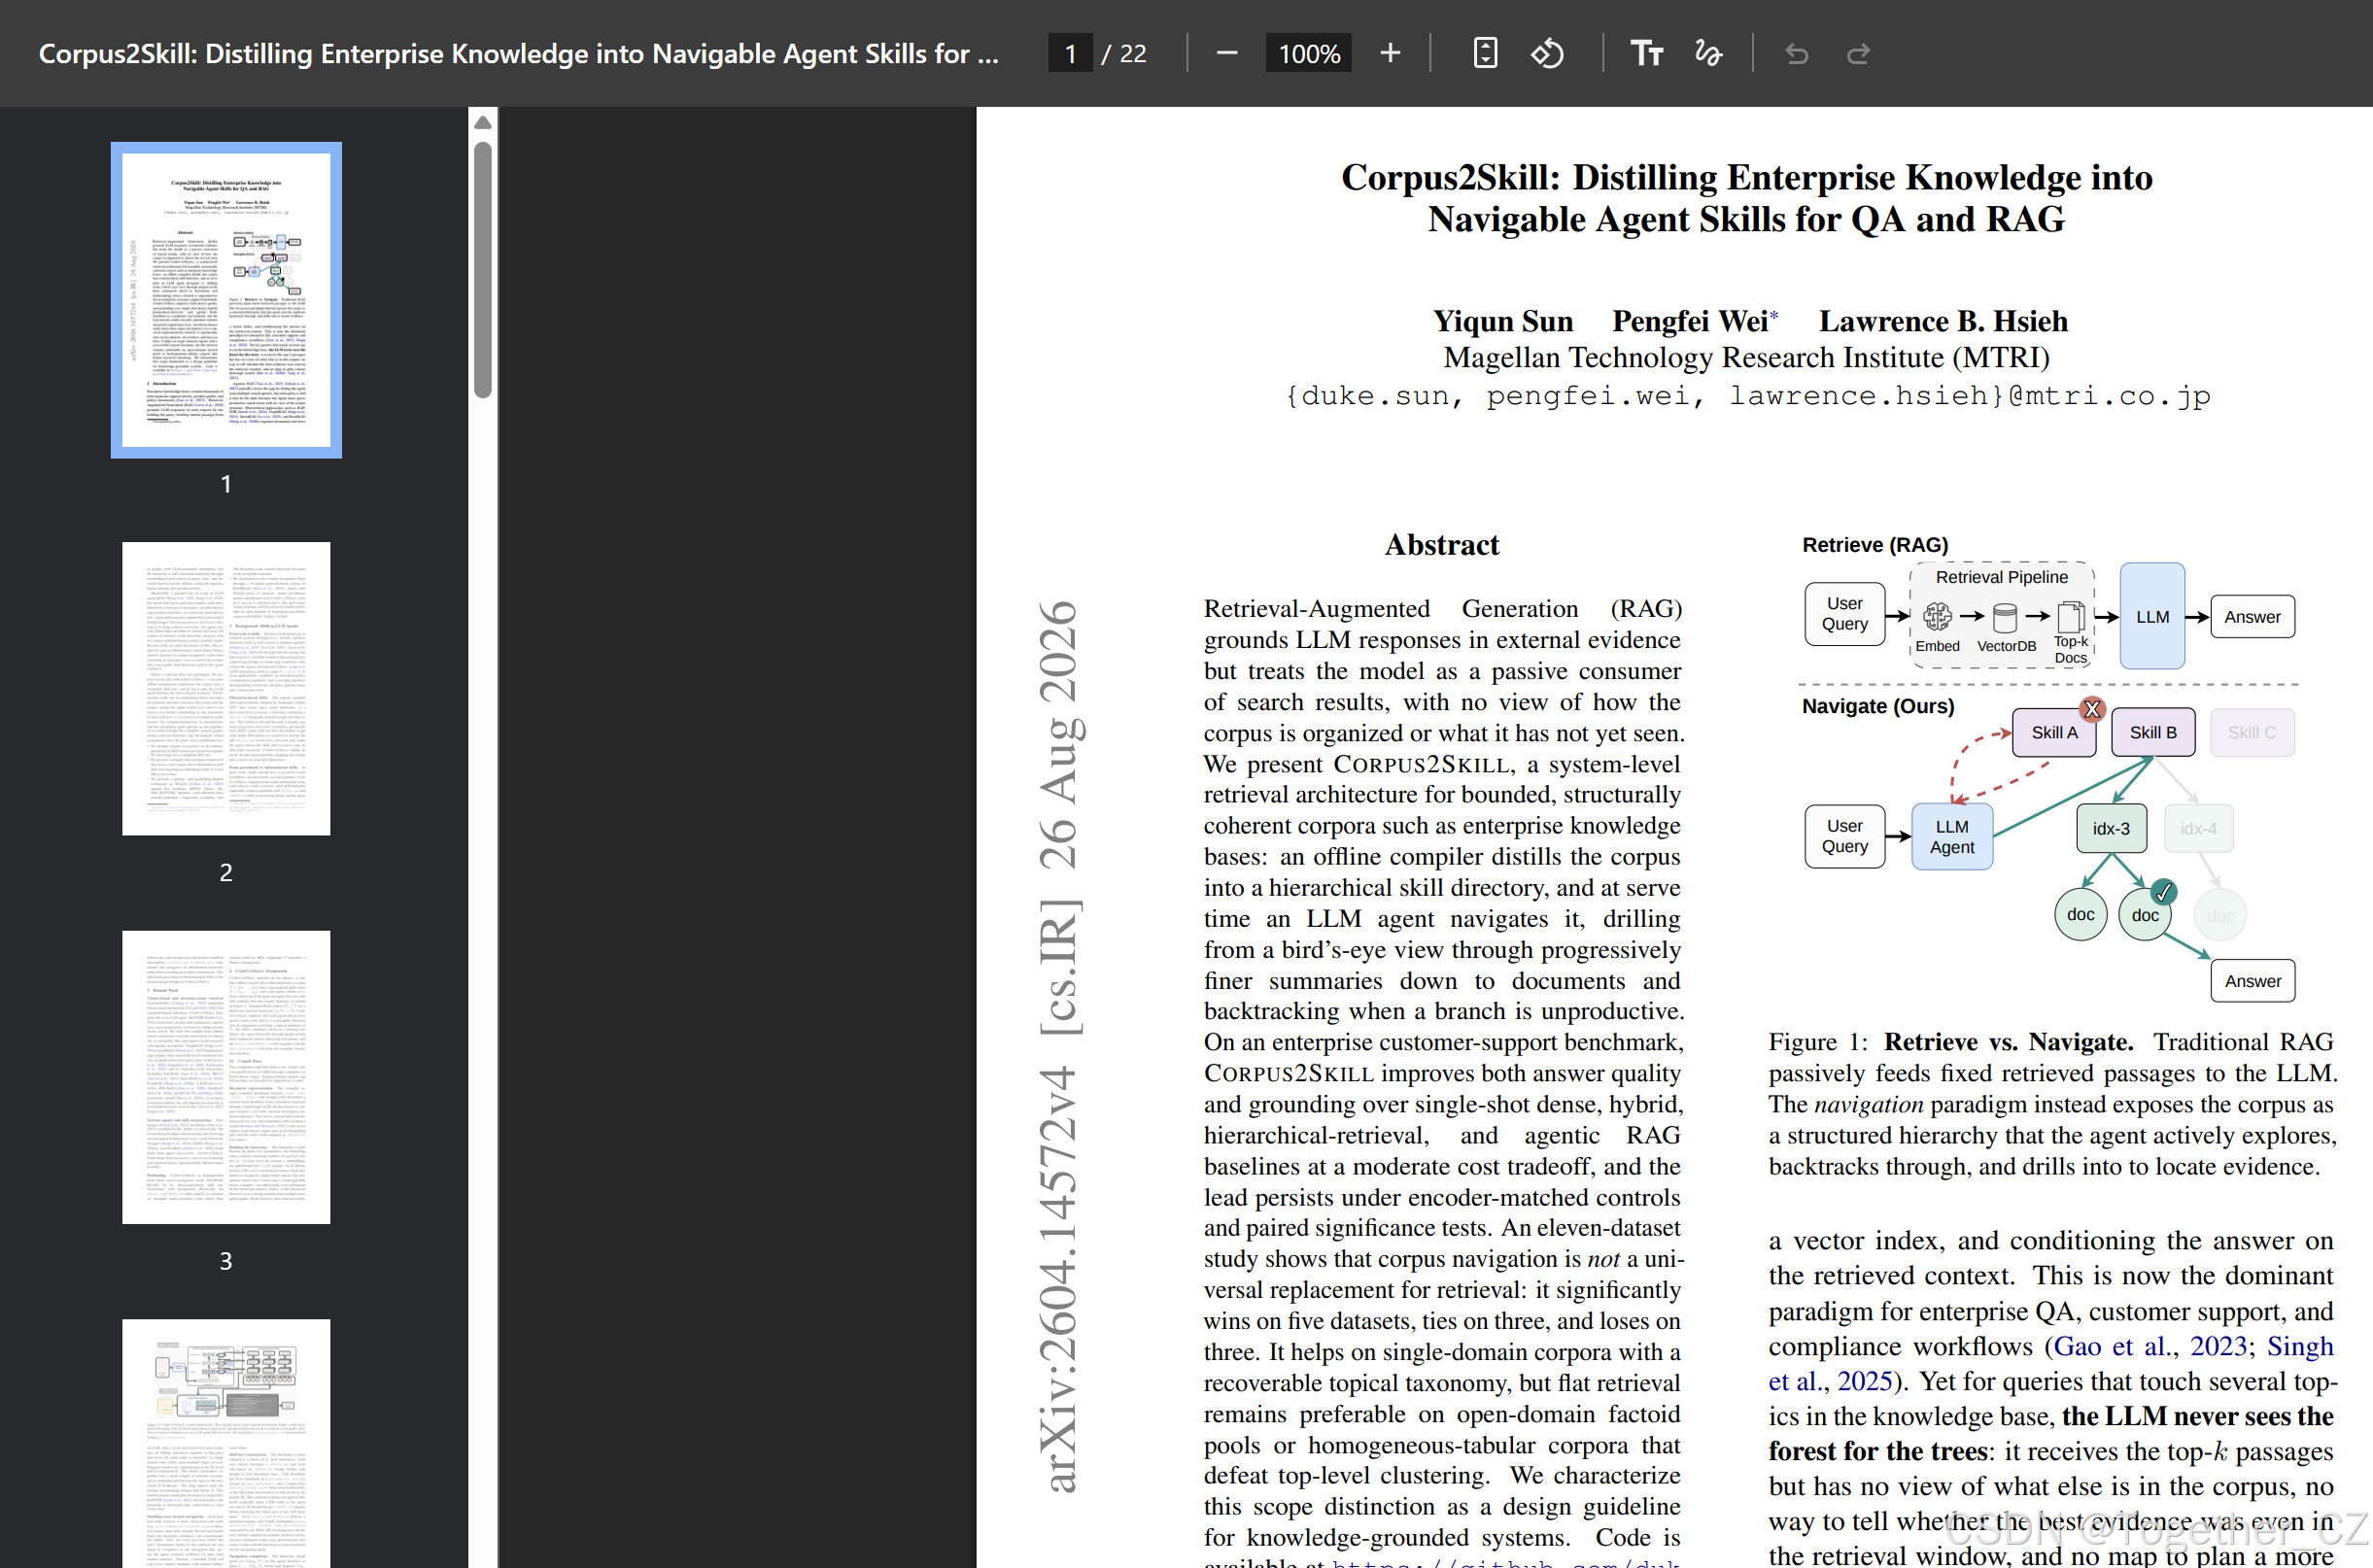
《Corpus2Skill: Distilling Enterprise Knowledge into Navigable Agent Skills for QA and RAG》提出了一种新的系统级检索架构,核心思想是将企业知识库从“被动检索”转变为“主动导航”。以下是对其主要研究内容的全面总结:
一、研究背景与问题
传统RAG(检索增强生成)将LLM视为搜索结果的被动消费者:模型只能看到top-k检索段落,却不知道语料库的整体结构、还有什么内容未被检索到,也无法规划更全面的搜索。这导致:
-
对于涉及多个主题的查询,模型“只见树木不见森林”;
-
智能体式RAG虽可多轮查询,但每次仍是盲猜搜索词;
-
层级式方法(如RAPTOR、GraphRAG)虽组织文档为树或图,但仍通过嵌入检索间接消费层级,模型看不到组织结构本身。
与此同时,LLM智能体技能(Agent Skills)领域表明:结构化、可复用的知识模块能显著提升智能体表现。基于文件系统的技能包支持渐进式披露(progressive disclosure),启动时只加载轻量元数据,按需加载完整内容,天然适合作为语料库导航的载体。
二、核心贡献
论文提出 CORPUS2SKILL,一种“先编译、后导航”的系统级检索架构:
识别“语料库可导航性”为RAG中未被充分探索的维度,将检索重新定义为对编译后技能树的智能体文件浏览。
提出编译-导航框架:离线将原始语料库编译为层级式技能目录,服务时无需嵌入索引或向量数据库。
在WixQA上验证质量与接地性:对比BM25、Dense、Hybrid、RAPTOR、Agentic五个基线,并进行消融、编码器匹配、编译器、50k文档规模等控制实验。
通过11个数据集界定适用范围:语料库导航并非通用替代方案,胜5、平3、负3,分化与语料库结构密切相关。
三、方法框架
1. 编译阶段(离线)
-
文档表示:每个文档经轻量LLM生成摘要卡片(标题、一行描述、特征短语),与截断原文拼接后嵌入。
-
层级构建:自底向上K-Means聚类,分支比p、最大顶层聚类数K;每层聚类由LLM摘要;验证-重分区步骤标记“易混淆”或“混合”聚类并修复。
-
跨分支导航增强:
-
非叶节点赋予文件系统安全标签;
-
每个聚类展示top-k范例文档;
-
批量LLM提取命名实体,构建语料库级entity_index.json;
-
基于实体Jaccard重叠生成## Related skills交叉跳转。
-
-
技能树物化:根聚类→SKILL.md,子聚类→INDEX.md,全文存于documents.json,通过get_document访问。
-
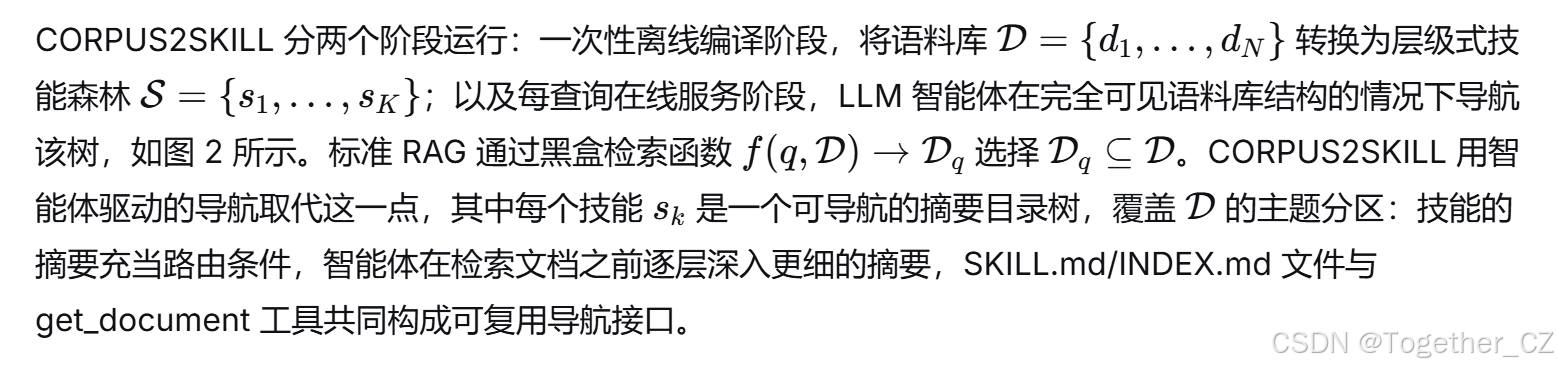
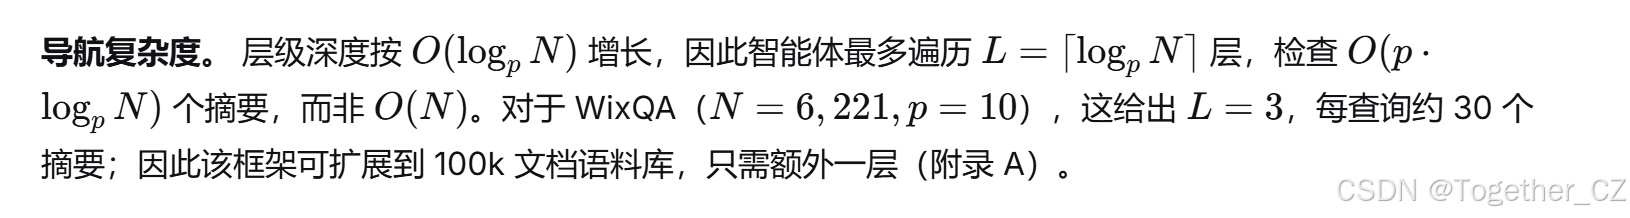
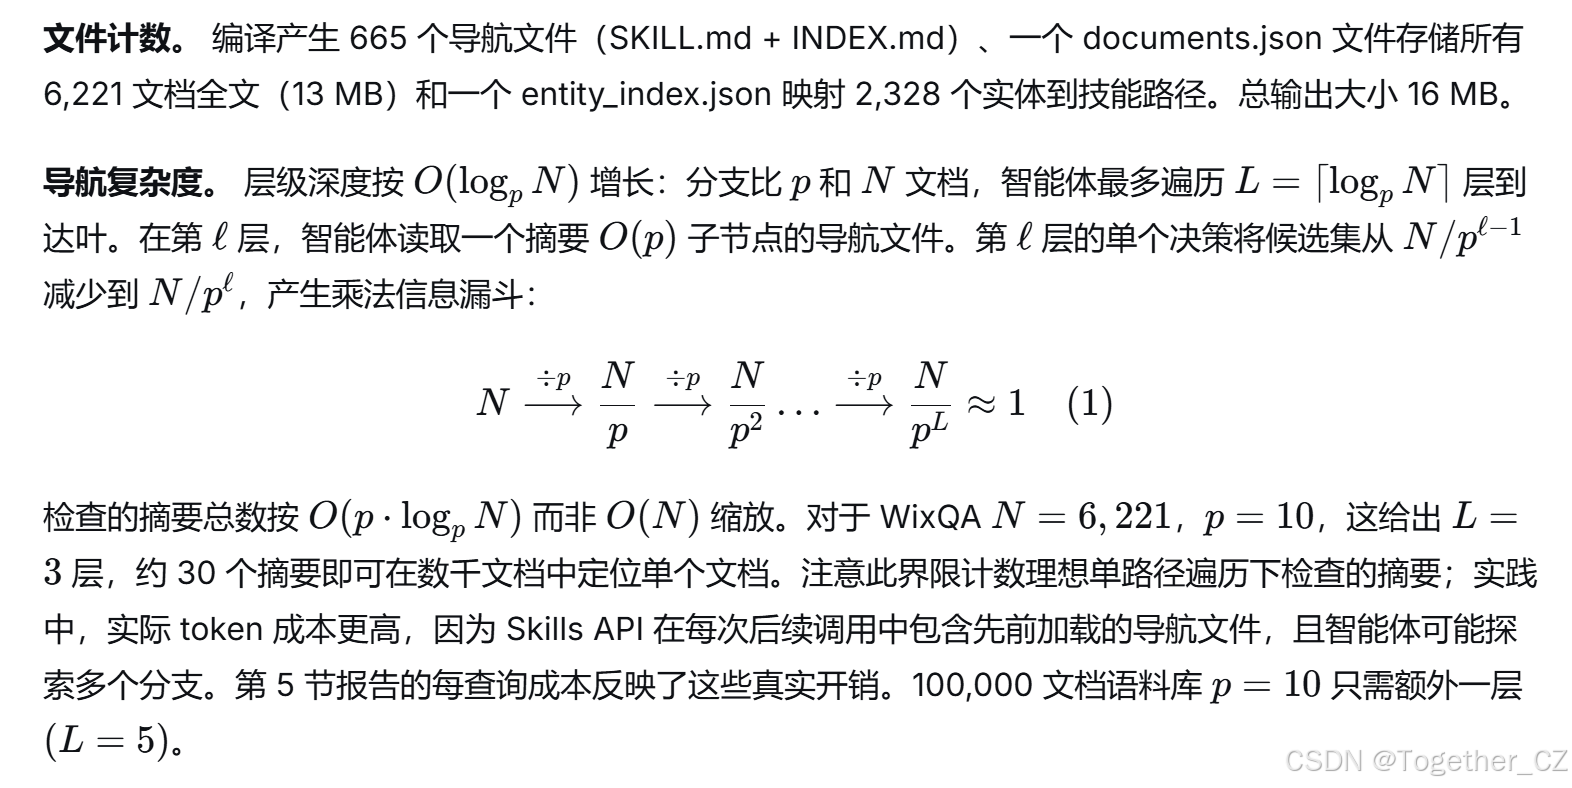
导航复杂度:深度O(log_p N),每查询检查O(p·log_p N)个摘要,而非O(N)。
2. 服务阶段(在线)
-
技能目录上传至Anthropic Skills API,利用渐进式披露:启动时仅加载技能名称和一行描述(约200 token),按需读取完整文件。
-
两个工具:
-
code_execution:通过ls、cat、grep浏览技能层级和实体索引;
-
get_document(doc_id):检索文档全文。
-
-
导航工作流:保持至少两个候选技能→逐层深入→叶级INDEX.md选择doc_id→读取全文→综合答案。
-
系统提示强制:接地规则(每个主张追溯到检索文档)、简洁答案格式、跨分支综合、定向回溯。
四、实验与结果
1. 主实验(WixQA)
-
语料库:6,221篇支持文章,200个专家测试查询。
-
编译配置:p=10,K=10,3层层级,6个顶层技能,665个导航文件,编译19.5分钟。
-
结果:
-
Token F1 0.456(相对Agentic +21%,相对Dense +25%);
-
BERTScore-F1 0.862,Factuality 0.767;
-
CtxR/CtxP 0.708/0.829,显著领先;
-
Hallucination Rate 4.5%,远低于Agentic的50%;
-
成本$0.153/查询,约为Agentic的1.9倍,单次检索器的13-22倍。
-
2. 泛化研究(11个数据集)
-
胜(5个):WixQA、Emanuel、DelucionQA、ExpertQA、ClapNQ——单域、主题连贯语料库。
-
平(3个):CovidQA、TechQA、FinQA——异构或数值表格语料库。
-
负(3个):HAGRID、TatQA、CUAD——开放域事实型或同质表格语料库,顶层聚类坍缩。
-
结论:语料库导航适用于具有可恢复主题分类体系的单域知识库;扁平检索在开放域或同质表格池上仍更可取。
3. 消融研究
-
聚类结构:窄树(p=5)与默认(p=10)相当,宽树(p=20)显著崩溃。
-
探索预算:5/10/20轮对质量影响极小,更大预算主要降低幻觉。
-
服务LLM:Haiku 4.5保留92% F1,成本降39%,但幻觉率是Sonnet的4倍。
-
编译器LLM:Haiku 4.5保留97% F1,成本仅五分之一。
-
编码器:0.6B与8B编码器差异不显著;RAPTOR在两种编码器下均显著落后。
-
组件分解:实体索引、软分配、范例是关键;验证-重分区、摘要卡片、编码器大小影响小。
4. 50k文档扩展
-
CovidQA池扩至50,000文档,仅增加一层层级,符合O(log_p N)预测;
-
所有方法退化,但导航退化最少,CORPUS2SKILL保持最高F1。
五、局限性
成本:导航文件内容包含在每次API调用中,输入token跨轮累积;无缓存时成本翻倍。
路由错误:顶层路由错误占失败的大多数,跨主题文档的主路由仍是瓶颈。
编译与语料库变动:假设语料库基本静态,不支持增量插入/删除/层级修复,频繁变化需反复编译。
语料库范围:三类语料库导航无帮助——长提取型文档(CUAD)、同质表格(TatQA)、开放域池(HAGRID)。
CORPUS2SKILL将文档语料库编译为层级式技能目录,用智能体驱动的导航取代基于嵌入的检索。在WixQA上,它在答案质量和接地性上优于扁平、层级和智能体基线。11数据集研究界定了范围:导航显著胜5、平3、负3。它适用于具有可恢复分类体系的单域集合,而扁平检索在顶层聚类坍缩处仍更可取。由于输出是无需向量数据库的普通技能目录,可直接集成到现有智能体部署中。对于有界、结构连贯的语料库,使语料库可导航补充了使其可搜索。CORPUS2SKILL通过离线编译将企业语料库转化为可导航的层级式技能目录,服务时由LLM智能体主动浏览、回溯和深入,从而在单域知识库上显著提升答案质量与接地性,但在开放域或同质表格语料库上不如扁平检索——它是对检索的补充而非通用替代。这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
项目地址在这里,如下所示:
摘要
检索增强生成(RAG)将 LLM 的响应建立在外部证据之上,但将模型视为搜索结果的被动消费者,无法了解语料库是如何组织的,也不知道自己尚未看到什么。我们提出 CORPUS2SKILL,一种面向有界、结构连贯的语料库(如企业知识库)的系统级检索架构:离线编译器将语料库蒸馏为层级式技能目录,在服务时由 LLM 智能体导航该目录,从鸟瞰视图逐层深入到更细粒度的摘要,直至文档,并在某个分支无产出时回溯。在企业客户支持基准上,CORPUS2SKILL 在答案质量和接地性上均优于单次稠密检索、混合检索、层级检索和智能体式 RAG 基线,代价是适度的成本权衡;在编码器匹配控制和配对显著性检验下,这一领先优势依然存在。一项涵盖 11 个数据集的研究表明,语料库导航并非检索的通用替代方案:它在 5 个数据集上显著胜出,在 3 个上持平,在 3 个上落败。它适用于具有可恢复主题分类体系的单域语料库,而在开放域事实型池或同质表格语料库上,扁平检索仍然更可取,因为顶层聚类在这些场景下会失效。我们将这一范围区分刻画为知识接地系统的设计指南。
1 引言
企业知识库包含数千篇异构的支持文章、产品指南和政策文档(Gao et al., 2023)。检索增强生成(RAG;Lewis et al., 2020)通过嵌入查询、从向量索引中获取相似段落、并基于检索到的上下文生成答案,从而将 LLM 响应建立在这样的语料库之上。这已成为企业问答、客户支持和合规工作流的主流范式(Gao et al., 2023; Singh et al., 2025)。然而,对于涉及知识库中多个主题的查询,LLM 从未见过森林,只见树木:它接收到 top-k 段落,却不知道语料库中还有什么,无法判断最佳证据是否在检索窗口内,也没有地图来规划更彻底的搜索(Sun et al., 2026b; Tang et al., 2025)。
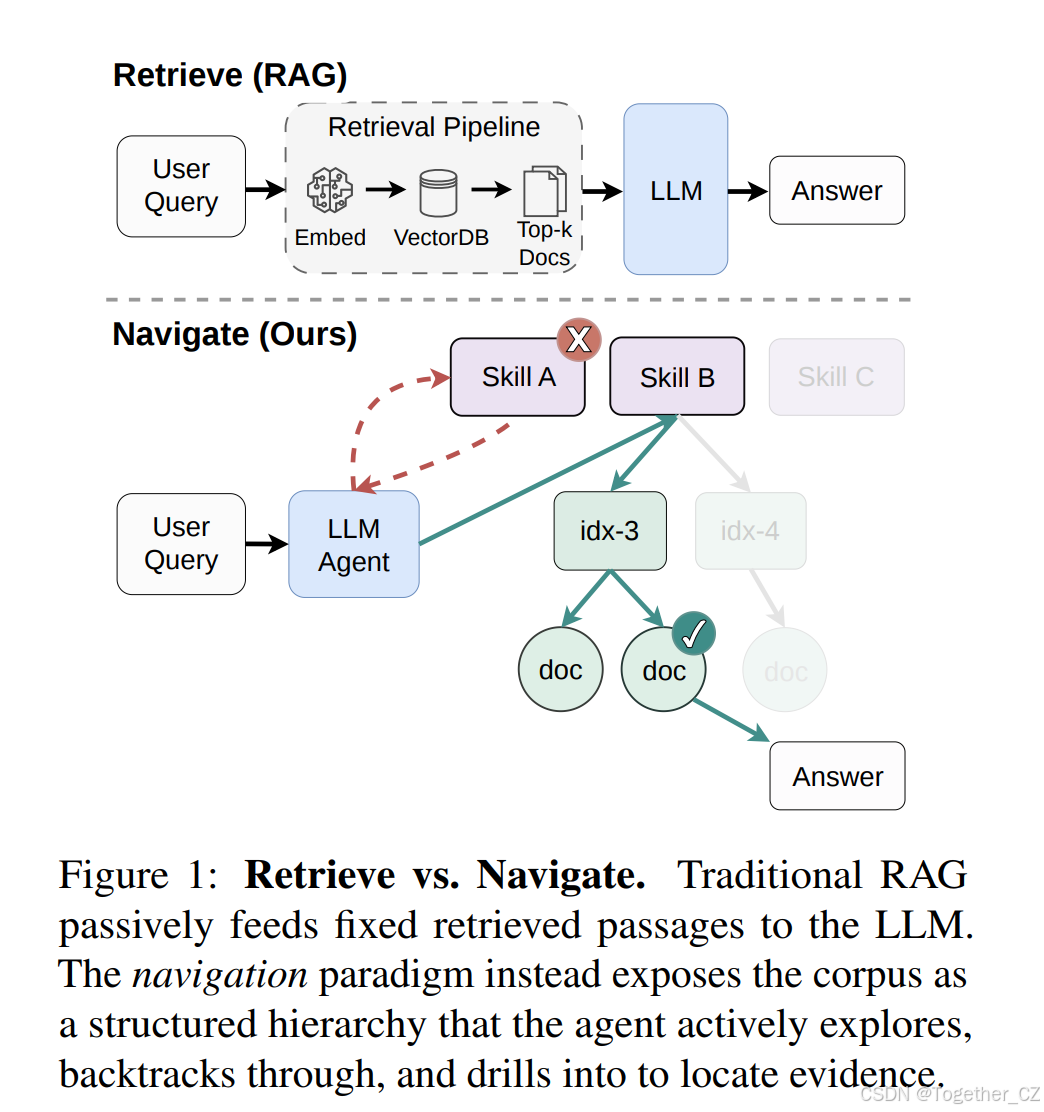
图 1:检索 vs. 导航。 传统 RAG 被动地将固定检索到的段落喂给 LLM。导航范式则相反,将语料库暴露为结构化层级,由智能体主动探索、回溯并深入其中以定位证据。
智能体式 RAG(Yao et al., 2023; Schick et al., 2023)部分弥合了这一差距,允许智能体发出多个搜索查询,但每个查询仍然是盲猜,因为智能体必须猜测有效的搜索词,却看不到语料库结构。层级式方法如 RAPTOR(Sarthi et al., 2024)、GraphRAG(Edge et al., 2024)、StructRAG(Li et al., 2025)和 BookRAG(Wang et al., 2026b)将文档组织成带有 LLM 生成摘要的树或图,但层级仍然是通过查询时的基于嵌入的搜索间接消费的,模型接收结果时看不到产生这些结果的组织结构。
与此同时,关于 LLM 智能体技能(Wang et al., 2024; Jiang et al., 2026)的另一条研究路线表明,当智能体获得结构化、可复用的知识模块,能够选择性地加载并遵循时,它们在复杂任务上表现更佳。智能体平台现在支持基于文件系统的技能包<sup>1</sup>,利用渐进式披露(第 2 节)来保持上下文成本低廉:智能体在启动时只看到轻量级元数据,按需加载完整内容,因此层级可以随语料库增长而不会触及上下文窗口限制。由于技能只是普通文件目录,不需要特殊基础设施,这使它们成为语料库导航的自然基座:与其搜索段落,不如将语料库蒸馏为可导航的技能层级,让智能体探索它。
图 1 对比了这两种范式。我们正是通过 CORPUS2SKILL 提出这一点:一次性离线编译将语料库转换为可导航的技能树,服务时 LLM 智能体浏览该树以定位证据。层级本身,而非嵌入索引,成为模型与语料库之间的主要接口,赋予智能体在承诺任何文档之前就能推理的鸟瞰视图。CORPUS2SKILL 是一种系统级检索架构:编译后的层级、其增强内容以及导航智能体作为一个流水线运行,因此我们既评估完整系统与强检索基线的对比,也分解哪些组件承载了增益。我们的贡献是:
我们识别出语料库可导航性是 RAG 中一个未被充分探索的轴,并将检索重新定义为对编译后技能树的智能体文件浏览。我们提出一种“先编译后导航”框架,将原始语料库转换为层级式技能目录,服务时无需嵌入索引或向量数据库。我们在 WixQA(Cohen et al., 2025)上提供质量与接地性对齐的评估,对比五个基线(BM25、Dense、Hybrid、RAPTOR、Agentic),并通过消融以及编码器匹配、组件、编译器和 50k 文档规模控制,将增益追溯到可导航结构。我们通过 RAGBench(Friel et al., 2024)上的 10 个子集泛化扫描来刻画语料库导航何时有帮助,加上 WixQA 共 11 个数据集:在逐数据集配对显著性检验下,CORPUS2SKILL 在 5 个上胜出,3 个持平,3 个落败。这一分化与语料库结构相关,在开放域或同质表格语料库(HAGRID、TatQA、CUAD)上扁平检索仍然更可取。
2 背景:LLM 智能体中的技能
从工具到技能。 现代 LLM 智能体通过工具在外部系统上行动:原子化、无状态的函数,如网络搜索或数据库查询(Schick et al., 2023; Yao et al., 2023)。智能体技能(Jiang et al., 2026)填补了行动与知道如何行动之间的空白:可复用模块,将程序性知识或多步工作流打包成智能体可以加载并遵循的形式。Jiang et al.(2026)将技能形式化为元组 S=(C,π,T,R),包括适用条件、执行策略、终止条件和可复用接口,将其与一次性计划、情景记忆和原子工具区分开来。
基于文件系统的技能。 当前标准的技能表示,被 Anthropic 的 Skills API<sup>2</sup> 和近期开放智能体平台采用,是基于文件系统的包:一个包含 SKILL.md 以及可选脚本和数据资产的目录。这种格式受到青睐,因为它干净地支持渐进式披露:元数据,特别是每个技能的名称和一行描述(通常少于 100 个 token),在启动时暴露;完整的 SKILL.md 指令仅在智能体选择该技能时读取;资源在被访问前留在磁盘上。CORPUS2SKILL 直接构建在这种表示之上,将语料库映射到此类技能目录的森林。
从程序性技能到信息性技能。 在先前工作中,技能编码如何执行任务:工作流、决策树或代码模式。CORPUS2SKILL 重新利用同一机制来编码语料库包含什么:每个技能目录代表一个主题分区,SKILL.md 和 INDEX.md 文件以递增的细节呈现,智能体遵循相同的渐进式披露工作流(描述 → SKILL.md → INDEX.md → 文档),但导航的是信息层级而非执行程序性指令。这种从程序性技能到信息性技能的转变是 CORPUS2SKILL 的核心设计洞见。
3 相关工作
基于聚类和结构感知的检索。 Scatter/Gather(Cutting et al., 1992)开创了基于聚类的导航(Liu and Croft, 2004),但需要人工选择。CORPUS2SKILL 将此委托给 LLM 智能体。RAPTOR(Sarthi et al., 2024)递归聚类并摘要块为树,通过遍历或折叠树向量搜索检索。我们共享编译时嵌入摘要器循环,但将层级物化为可导航文件,并用智能体导航取代固定遍历。GraphRAG(Edge et al., 2024)和 HiRAG(Huang et al., 2025)构建带社区级摘要的知识图谱,但依赖查询时的图检索。RAG(Lewis et al., 2020; Karpukhin et al., 2020; Santhanam et al., 2022)及其结构感知扩展,包括 Self-RAG(Asai et al., 2024)、IRCoT(Trivedi et al., 2023)、StructRAG(Li et al., 2025)、BookRAG(Wang et al., 2026b)、A-RAG(Du et al., 2026)、SPD-RAG(Akay et al., 2026)、NaviRAG(Dai et al., 2026)和 HCAG(Wu and Deng, 2026),重构、重排(Sun et al., 2026c)或重新查询检索到的证据,但服务时仍依赖检索或搜索基础设施(Gao et al., 2023; Singh et al., 2025)。
工具使用智能体和技能构建。 Toolformer(Schick et al., 2023)和 ReAct(Yao et al., 2023)确立了 LLM 选择工具的能力。我们扩展该范式,加入对静态层级的只读文件浏览和文档查找工具。Voyager(Wang et al., 2024)、SkillX(Wang et al., 2026a)和 EvoSkill(Alzubi et al., 2026)从智能体轨迹构建技能。CORPUS2SKILL 通过聚类和摘要从文档语料库构建技能,这是一种根本不同的输入模态。
定位。 CORPUS2SKILL 与先前主动导航工作(NaviRAG、HCAG)的区别在于其基于文件系统的技能表示,通过 SKILL.md/INDEX.md 文件实现渐进式披露,并依赖标准代码执行工具而非自定义检索 API(附录 F 提供功能对比)。
4 CORPUS2SKILL 框架
4.1 编译阶段
编译流水线通过一系列 LLM 驱动的阶段将原始语料库转换为可导航的技能森林。实现细节和完整提示见附录 A 和 C。
文档表示。 编译器接受标准文档格式(.md、.txt、.json、.jsonl),并为每个文档分配内容哈希标识符。每个文档经过一次轻量级 LLM 调用,返回紧凑的摘要卡片(标题、一行描述、特征短语)。卡片与截断的原始文本拼接,并用句子模型(Reimers and Gurevych, 2019)嵌入,因此向量既反映字面内容,也反映 LLM 蒸馏的要点,同一卡片随后作为 INDEX.md 行条目重现。
构建层级。 层级自底向上构建,有两个参数:分支比 pp 和最大顶层聚类数 K。在每一层,当前 n 个嵌入通过 K-Means(Lloyd, 1982)在 L2 归一化向量上划分为 ⌈n/p⌉ 组。每个文档分配到一个主聚类,但 top-1 与 top-2 余弦差距低于边际 τ 的文档会额外在次优聚类的索引中交叉引用,以便智能体可以从多条导航路径发现交叉内容。每个聚类随后由 LLM 摘要,并有一个验证与重分区步骤检查所有同级摘要,标记覆盖同一主题的配对(易混淆)或明显跨越多个主题的单个聚类(混合)。被标记的聚类在 ID 级别重新分区并重新摘要。聚类摘要连同少量成员摘录一起重新嵌入,成为下一轮 K-Means 的输入。循环重复,直到剩余聚类数低于 K。这种嵌入-聚类-摘要递归受 RAPTOR(Sarthi et al., 2024)启发,但将层级物化为可浏览文件而非扁平向量存储。
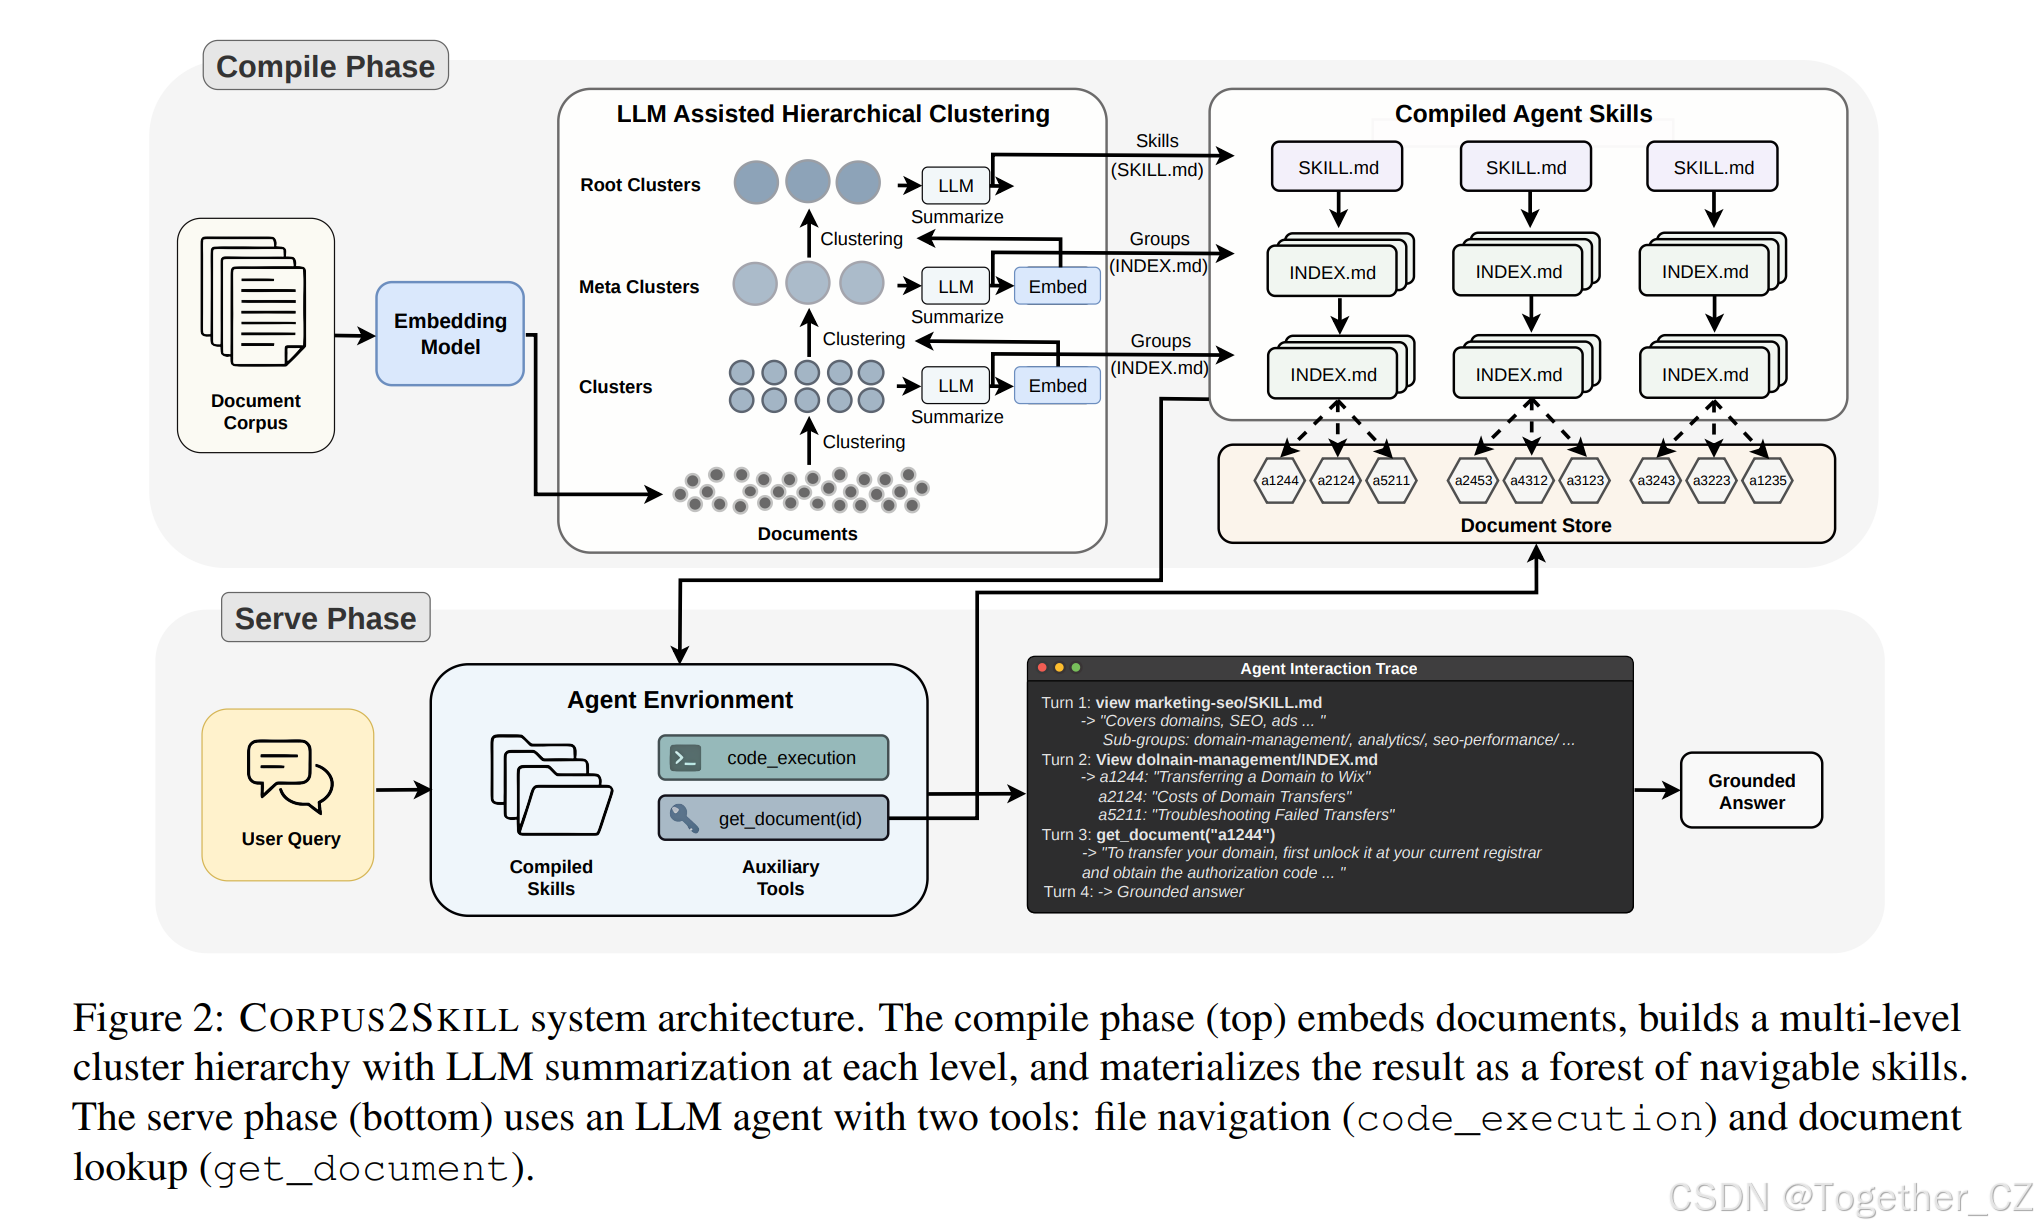
图 2:CORPUS2SKILL 系统架构。 编译阶段(上)嵌入文档,构建多级聚类层级并在每级进行 LLM 摘要,将结果物化为可导航技能森林。服务阶段(下)使用带两个工具的 LLM 智能体:文件导航(code_execution)和文档查找(get_document)。
启用跨分支导航。 每个非叶节点获得一个简短、文件系统安全的标签(例如 wix-commerce-operations),因此目录名本身通常就能标识相关分支。层级稳定后,添加两项增强。第一,对于每个非叶聚类,最接近质心的 top-k 文档作为范例出现在导航文件中,给智能体每个分支包含什么的具体证据。第二,一次批量 LLM 调用为每个聚类摘要打上命名实体和文档类型标签,聚合为语料库范围的 entity_index.json。每个技能的导航文件包含一个 ## Related skills 块,源自实体 Jaccard 重叠,因此智能体可以横向跳转到提及同一实体的任何其他技能。
技能树构建。 层级物化为 K 个技能目录的森林:每个根聚类变成一个 SKILL.md,每个子聚类变成一个 INDEX.md,列出进一步子组或叶文档行。完整文档文本单独存放在 documents.json 中,通过 get_document 访问;语料库级 entity_index.json 将每个命名实体映射到提及它的技能路径(完整布局见附录 B)。这种分离使导航文件保持很小(通常每个小于 2 KB),因此智能体可以在 incurring 任何完整文档的 token 成本之前,廉价地浏览每个 INDEX.md 中的 20 个文档。每个 SKILL.md/INDEX.md 遵循统一模板,带有 YAML frontmatter(name、description、level、num_documents),由 Skills API 消费以实现渐进式披露,编译提示产生面向路由的摘要(主题领域、问题类型、关键术语),使每个文件成为导航智能体的决策点。
4.2 服务阶段
服务时,预编译的技能目录上传到 Anthropic 的 Skills API。该 API 实现渐进式披露:技能名称和一行描述预加载到智能体上下文,但完整文件内容仅在智能体显式读取文件时加载。这一设计对 token 效率至关重要。预加载所有导航文件会用数千 token 的不相关摘要淹没上下文。什么都不加载则会让智能体对语料库一无所知。渐进式披露取得平衡:智能体看到刚好足够的信息(技能名称和描述,总共约 200 token)做出知情的第一决策,然后随着深入逐步加载细节。
工具。 智能体获得两个工具:(1)code_execution,允许通过标准 shell 工具如 ls、cat 和 grep 浏览 SKILL.md 和 INDEX.md 文件(以及语料库级 entity_index.json),使智能体完全可见层级;(2)get_document (doc_id),一个自定义工具,根据标识符从文档存储中检索文档全文。双工具设计反映智能体需要的两类信息:导航性(在哪里找)和证据性(引用什么)。将它们分开意味着智能体可以在承诺读取完整文档的 token 成本之前,廉价地浏览许多文档摘要。
导航工作流。 由于技能描述已预加载,智能体在每个查询开始时就有语料库的鸟瞰视图,知道存在哪些主题以及每个主题大致覆盖多少文档。系统提示指示智能体在承诺路径之前保持至少两个候选技能活跃,当查询引用特定命名实体时查阅 entity_index.json,并在初始分支结果稀薄时通过 ## Related skills 块交叉跳转。典型查询进行 2 到 3 轮:
智能体从预加载描述(以及查询提及特定实体时从 entity_index.json)识别最相关的技能。
智能体导航到最相关子组的 INDEX.md,其中列出文档行,包含标题、一行描述和特征短语。
智能体调用 get_document 检索一个或多个有希望文档的全文,并综合出有根据的答案。
每一步,智能体都依据描述每个分支的摘要做出知情决策。如果某个 SKILL.md 列出十个子组,而智能体只探索了一个,它就知道还剩九个,这是扁平检索无法提供的意识。这种结构可见性支持两种行为:定向回溯(放弃无望分支转向更相关分支)和跨分支综合(结合来自多个子组内或跨技能的证据),后者由相关技能交叉引用和实体索引辅助。系统提示强制执行接地规则(每个主张必须追溯到检索到的文档,而非摘要文件)和简洁答案格式(字数限制,无前言)。见附录 D。
5 实验
5.1 设置
数据集与编译。 我们在 WixQA(Cohen et al., 2025)上评估,这是一个客户支持问答基准,包含 6,221 篇支持文章和 200 个专家编写的测试查询,带金标准答案和金标准文章 ID。我们以分支比 p=10 和最大顶层聚类 K=10 编译 WixQA,产生 3 层层级,包含 6 个顶层技能和 665 个导航文件。编译在 RTX 4090 服务器上耗时 19.5 分钟。
基线。 所有方法使用相同的答案 LLM 和相同的评估协议。我们比较五个基线,跨越三种检索范式:BM25(稀疏关键词检索(Robertson and Zaragoza, 2009))、Dense(Qwen3-Embedding-0.6B(Zhang et al., 2025)加 FAISS 索引(Johnson et al., 2019))、Hybrid(BM25 和 Dense 的 RRF(Cormack et al., 2009))、RAPTOR(层级树检索(Sarthi et al., 2024),使用 UMAP+GMM+BIC 聚类)和 Agentic(一个 LLM 智能体,迭代访问 BM25、Dense 和 Hybrid 工具)。前三个是单次(top-5 段落,一次 LLM 调用)。RAPTOR 使用折叠树检索,使用与我们编译器相同的摘要 LLM(Claude Sonnet 4.6),Agentic 允许最多 10 轮。第 5.4 节还从两个方向控制编译时编码器。完整实现见附录 H。
指标。 我们使用七指标套件。质量:Token F1(针对金标准的 token 精确率/召回率调和平均)、BERTScore-F1(Zhang et al., 2020)和 Factuality(LLM 作为评判者(Zheng et al., 2023)1-5 分 vs. 金标准,归一化到 0-1)。接地性:三个 RAGAS 风格(Es et al., 2024)LLM 评判指标(Faithfulness_grd、Context Recall (CtxR)、Context Precision (CtxP))加上 Hallucination Rate,即 Faithfulness_grd <0.6 的查询比例。我们还报告轮数和每查询 S/q。跨方法公平性细节见附录 I。每个胜/平/负陈述遵循一条规则:如果 CORPUS2SKILL 的 Token F1 在逐查询配对 bootstrap(10,000 次重采样)下以 p<0.05 超过最佳基线,则数据集为胜;反之为负;否则为平;逐数据集增量和 pp 值见附录 K。
5.2 主要结果
表 1:WixQA 主要结果(200 查询)。 CORPUS2SKILL 在 F1、BERT、Fact.、CtxR、CtxP 上胜出,并在多轮方法中拥有最低的 Hallucination Rate;F1 领先在 bootstrap 下显著 (p<0.0001),三次运行的服务时方差 ±0.002(附录 K)。单次检索器在 Faith_grd / Halluc. 上胜出,因为它们总是反馈一个小型接地段落。最佳加粗;↑ 单元格绿色(越深越好),↓ 单元格(Halluc.、S/q)红色(越深越差)。多轮方法使用 Anthropic 临时提示缓存。
| BM25 | 0.345 | 0.830 | 0.472 | 0.831 | 0.406 | 0.549 | 0.005 | 1.00 | 0.007 |
| Dense | 0.364 | 0.833 | 0.537 | 0.889 | 0.448 | 0.659 | 0.000 | 1.00 | 0.007 |
| Hybrid | 0.361 | 0.832 | 0.524 | 0.851 | 0.416 | 0.637 | 0.005 | 1.00 | 0.007 |
| RAPTOR | 0.398 | 0.839 | 0.704 | 0.909 | 0.618 | 0.659 | 0.005 | 1.00 | 0.012 |
| Agentic | 0.378 | 0.843 | 0.705 | 0.528 | 0.452 | 0.649 | 0.500 | 5.06 | 0.082 |
| CORPUS2SKILL | 0.456 | 0.862 | 0.767 | 0.859 | 0.708 | 0.829 | 0.045 | 2.38 | 0.153 |
答案质量。 CORPUS2SKILL 在每个答案质量指标和两个检索覆盖指标上取得最高分(表 1)。Token F1 达到 0.456(相对 Agentic 0.378 提升 21%,相对 Dense 0.364 提升 25%)。三次独立服务通过产生 Token F1 0.458 ± 0.002,运行间噪声约为与最强基线差距的 30×,对 RAPTOR 的领先显著 (p<0.0001;附录 K)。BERTScore-F1 为 0.862,领先 Agentic(0.843)、RAPTOR(0.839)和扁平检索器(0.830-0.833)。Factuality 0.767 超过次优方法 Agentic(0.705)和 RAPTOR(0.704)6 个绝对点。CtxR/CtxP 领先明显(0.708/0.829 vs. RAPTOR 0.618/0.659 和 Agentic 0.452/0.649)。两种层级方法都优于扁平基线,但 CORPUS2SKILL 在 Factuality 上进一步扩展 RAPTOR 的增益 9%,在 CtxR 上 15%:聚类摘要揭示了扁平嵌入遗漏的主题联系(Sun et al., 2026a),让智能体将查询匹配到相关文档组而非段落。
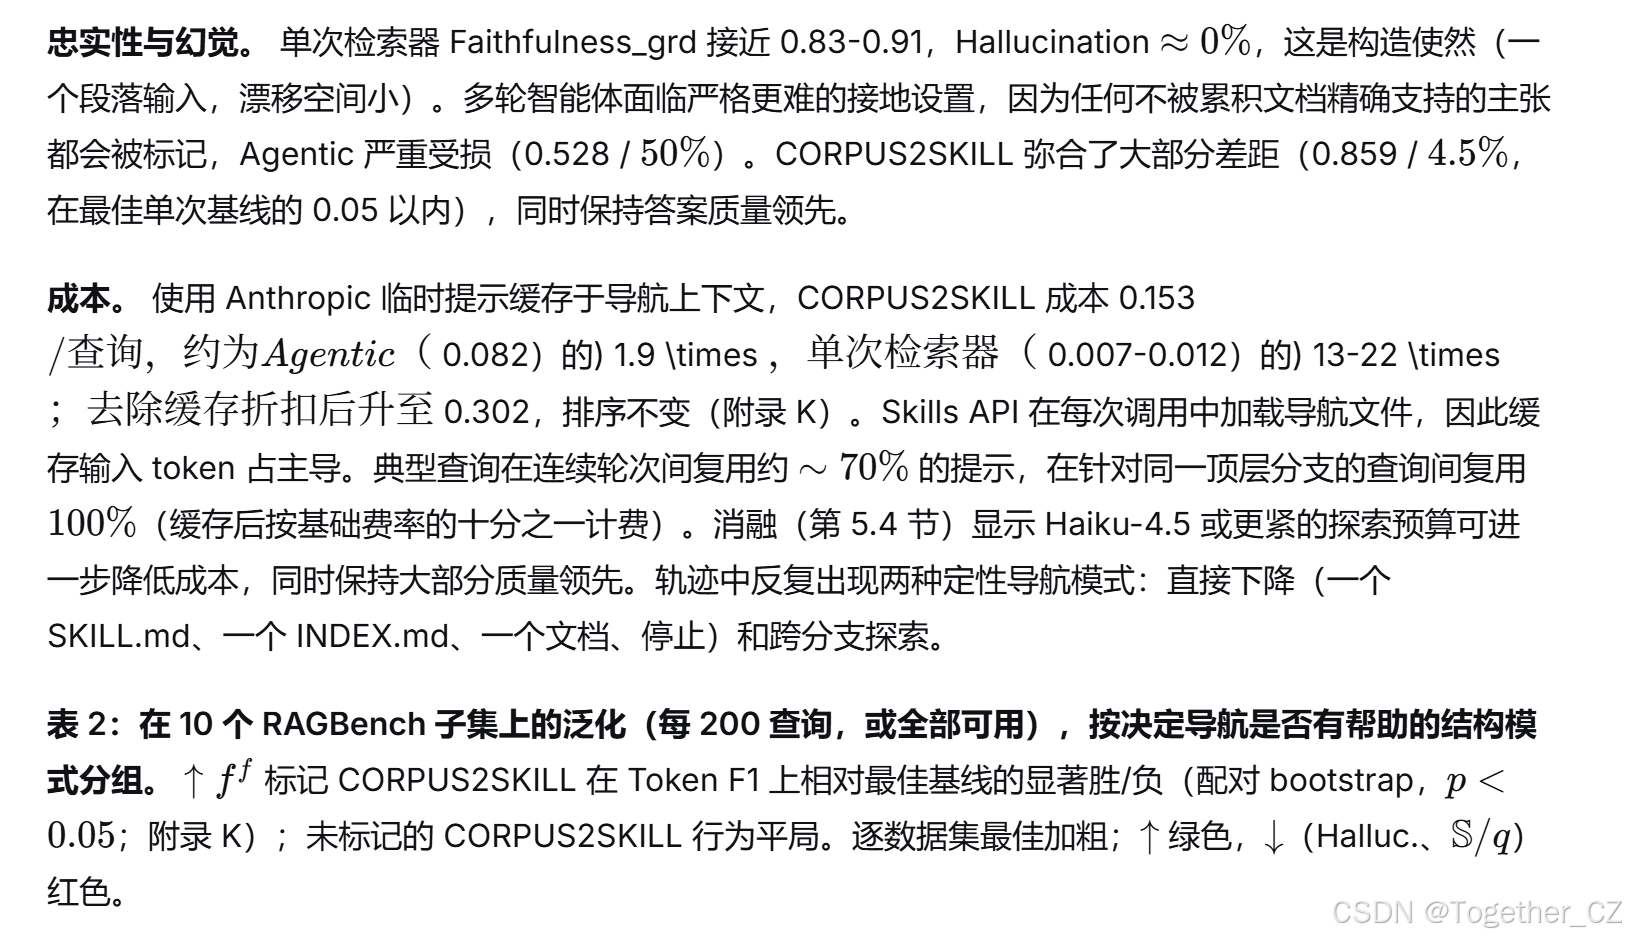
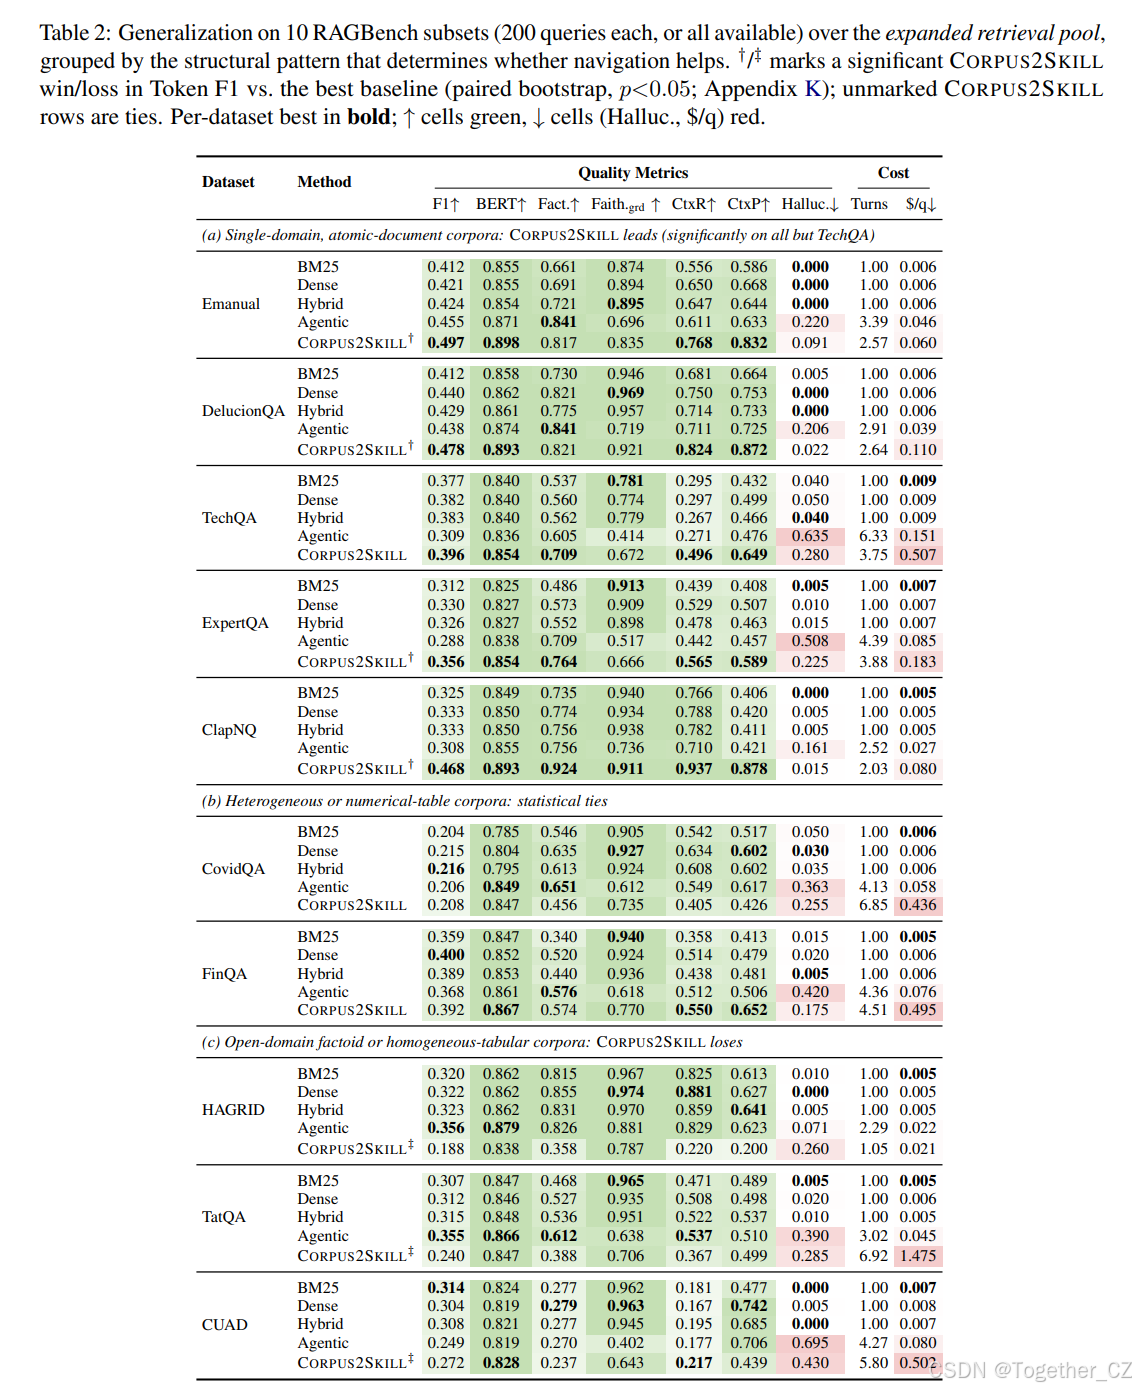
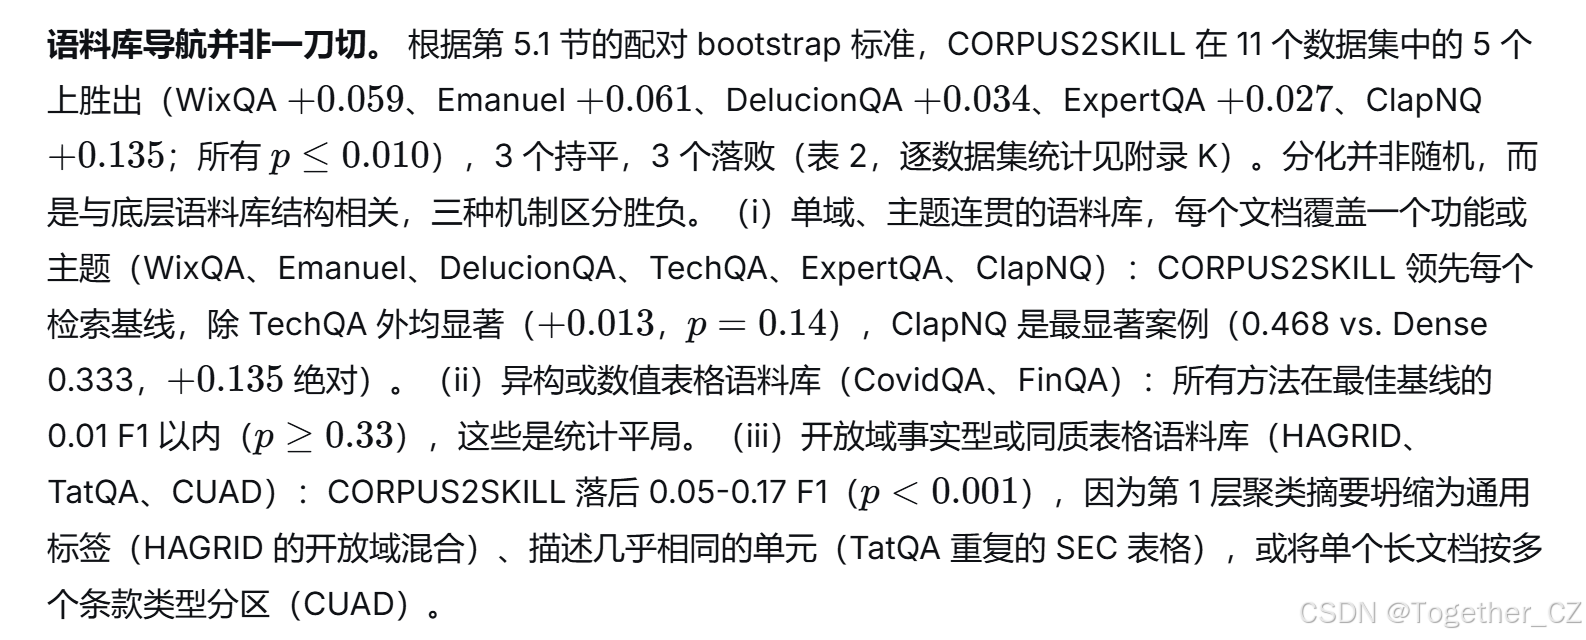
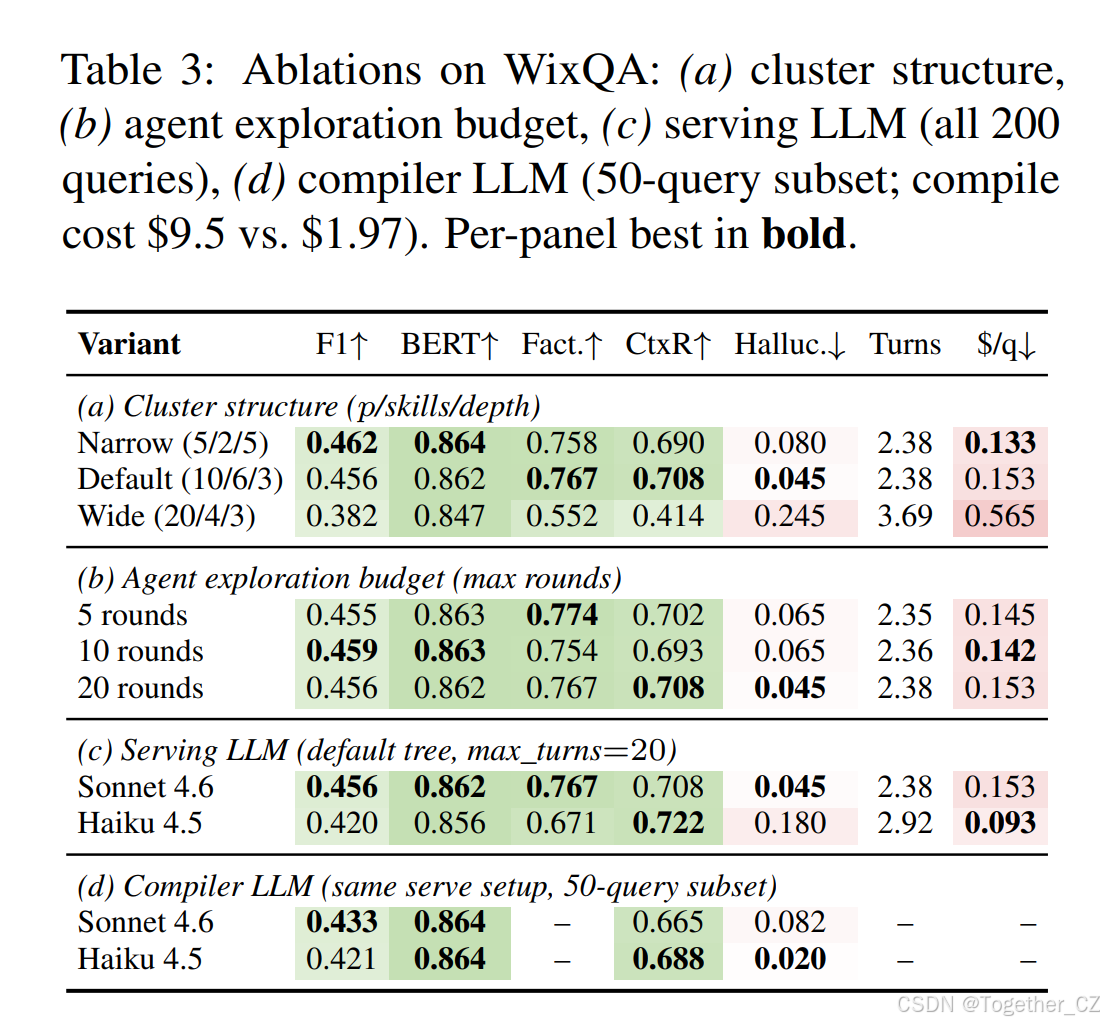
表 4:WixQA 编译增强分解(每变体 200 查询);上组:编译资源组件,下组:导航结构。
| Full | 0.456 | 0.767 | 0.708 | 0.829 |
| – verify-and-repartition | 0.456 | 0.760 | 0.677 | 0.821 |
| – doc summary cards | 0.463 | 0.780 | 0.695 | 0.811 |
| – 8B encoder (use 0.6B) | 0.461 | 0.751 | 0.702 | 0.840 |
| – exemplars | 0.401 | 0.609 | 0.514 | 0.676 |
| – soft assignment | 0.333 | 0.397 | 0.336 | 0.413 |
| – entity index | 0.312 | 0.359 | 0.278 | 0.344 |
接地性与定位。 在接地性上,CORPUS2SKILL 的逐数据集 Faithfulnesspred / Hallucination Rate 介于单次检索器(构造上反馈一个接地段落)和 Agentic 基线之间,一致地将 Agentic 的幻觉率减半,同时在领先 F1 的数据集上与单次接地保持竞争力。因此我们将 CORPUS2SKILL 定位为检索的互补原语而非通用替代:适用于精选的单域知识库(本文部署目标),而扁平检索或 RAPTOR 保留为开放域或同质表格池的默认选择。HAGRID/CUAD/TatQA 的损失是结构性的,并推动了 Limitations 中的后续方向。
5.4 消融研究
我们在 WixQA 上消融编译时和服务时设计选择:聚类结构、探索预算、服务与编译器 LLM(表 3)、编码器选择和编译时增强(表 4)。所有变体共享双工具智能体配置,可直接与表 1 比较。
聚类结构(面板 a)。 在 K=10 下变化 p 产生窄 (p=5)、默认 (p=10) 和宽 (p=20) 树。窄和默认在每个质量指标上相差约 1 F1 点以内(0.462 vs. 0.456),窄略便宜($0.133 vs. $0.153)。宽形状坍缩至 F1 0.382 (−0.07)、CtxR 0.414 (−0.29)、Hallucination 24.5%、3.7 轮 / $0.57 每查询:一旦第 1 层聚类必须摘要数百个主题混合文档,其摘要就变得过于通用而无法路由,微型重现了第 5.3 节的 TatQA 失败模式。
智能体探索预算(面板 b)。 变化最大轮数(5/10/20)对质量影响极小(F1 以内 0.005,平均 2.4 轮,无论预算),因为层级组织良好,智能体很少需要扩展探索。更大预算主要帮助接地性:Hallucination 从 6.5%(预算 5)单调降至 4.5%(预算 20),表明额外轮次用于验证而非研究。
服务 LLM 选择(面板 c)。 将 Sonnet 4.6 换成 Haiku 4.5(相同编译树)将成本从 0.153降至降至 0.093(−39%),同时保留 Sonnet F1 的 92%(0.420)和 Factuality 的 87%(0.671)。CtxR 实际增加(0.708 → 0.722),因为 Haiku 倾向于在回答前多读一个文档。代价是接地性:Haiku 的 Hallucination Rate 是 Sonnet 的 4×,因此 Sonnet 仍是合规敏感部署的正确选择。Haiku 变体是我们测得的最便宜 CORPUS2SKILL 配置,仍在 F1 上以 2-6 绝对点大幅超过每个扁平检索基线,证明编译树而非导航器的复杂性驱动检索性能。
编译器 LLM(面板 d)。 将整个编译 LLM 从 Sonnet 4.6 换成 Haiku 4.5 保留 97% F1,编译成本仅五分之一:流水线两侧都不需要前沿模型。编译时摘要错误也被控制:摘要只路由智能体,而答案接地于检索到的原始文档,因此弱摘要可能损失召回但无法注入不支持内容(参见附录 G)。
编码器选择。 CORPUS2SKILL 用 Qwen3-Embedding-8B 编译;基线用 0.6B 变体索引(附录 H)。2×2 编码器交叉排除了这一不对称:用基线的 0.6B 编码器编译,CORPUS2SKILL 得分 0.461 F1 vs. 8B 编译的 0.458±0.002(p=0.37),而 13× 更大的编码器对基线帮助至多 +0.023 F1。对 RAPTOR,其递归摘要已使用与我们编译器相同的 Sonnet 4.6 摘要器,CORPUS2SKILL 在 0.6B 匹配下领先 +0.064 F1,在 8B 下 +0.035(均 p<0.0001;完整表格见附录 K)。
组件分解。 一次移除一个编译时增强(表 4)清晰分离两组:移除实体索引使 F1 从 0.456 降至 0.312,软分配降至 0.333,范例降至 0.401,而验证与重分区对 F1 中性,移除摘要卡片或 8B 编码器使 F1 变化至多 0.007(不显著)。增益来自可导航结构;编译侧资源贡献很小。
5.5 扩展到 50k 文档
表 5:CovidQA 上 Token F1 随池从 5k → 50,000 文档增长(相同 200 查询和编译器)。 50k 编译成本 S54.1/76min(\\$1.08/1k 文档 vs. 6k 时 S3.33),并增加一层层级。
| CORPUS2SKILL | 0.208 | 0.191 | -0.017 |
| Dense | 0.215 | 0.187 | -0.028 |
| Hybrid | 0.216 | 0.175 | -0.041 |
| BM25 | 0.204 | 0.169 | -0.035 |
将 CovidQA 池增长到 50,000 篇域内 CORD-19 摘要(8× 我们最大语料库,相同编译器和协议)恰好增加一层层级,符合 O(logpN) 预测,编译成本次线性(表 5);所有 200 查询无错误导航更大树,紧凑模式输出符合生产 Skills API 限制。池中有 45,000 同域干扰项时,每种方法都退化;导航退化最少,CORPUS2SKILL 保持最高 F1,与 Dense 持平 (p=0.74),高于 BM25 (p=0.04),因此 CovidQA 在 10× 规模下仍处于平局机制。
6 结论
我们提出 CORPUS2SKILL,一种系统级检索架构,将文档语料库编译为层级式技能目录,并用智能体驱动的导航取代基于嵌入的检索。在 WixQA 上,它优于扁平、层级和智能体基线。一项 11 数据集研究界定了范围:导航在 5 个数据集上显著胜出,3 个持平,3 个落败。它适用于具有可恢复分类体系的单域集合,而在顶层聚类坍缩的地方扁平检索仍然更可取。受控消融将增益追溯到编译树及其增强,这些结论在 50,000 文档下依然成立。由于输出是无需向量数据库的普通技能目录,它直接集成到现有智能体部署中。对于具有可恢复主题结构的有界语料库,使语料库可导航补充了使其可搜索。
局限性
成本。 导航文件内容包含在每次 API 调用中,因此输入 token 跨轮累积。使用 Anthropic 临时提示缓存(我们结果中全程使用),CORPUS2SKILL 成本 0.153/查询,约为Agentic基线的/查询,约为Agentic基线的 1.9\\times ;无缓存时大致翻倍至;无缓存时大致翻倍至 \\ 0.3020.302/查询,但对基线的排序不变(附录 K)。换用 Haiku 4.5 将缓存成本降至 0.093(,同时保留大部分质量领先(第 5.4 节)。因此该方法面向高价值查询,改进的接地性证明成本溢价合理。对于高容量、低风险查询,单次检索仍更具成本效益。
路由错误。 尽管软分配和实体交叉链接(第 4.1 节)让智能体发现交叉内容,我们的失败分析(附录 G)显示顶层路由错误仍占失败的大多数。跨多个主题的文档可以在次分支中交叉引用,但当查询针对不太明显的主题时,主路由决策仍是瓶颈。
编译与语料库变动。 一次性编译对 WixQA(6,221 文档)耗时约 20 分钟挂钟时间,对于处理数千日查询的企业部署可忽略,且每文档成本随语料库规模次线性下降(第 5.5 节)。系统假设语料库基本静态:不支持增量插入、删除和层级修复,因此任何变更都需要重新编译,频繁变化的集合面临反复编译成本。更便宜的 Haiku 4.5 编译器(97% F1,五分之一成本,第 5.4 节)降低了每次重新编译的成本。
语料库范围。 我们的 RAGBench 研究(第 5.3 节)识别了三种导航无帮助的语料库形状:答案是逐字片段的长提取型文档(CUAD)、聚类摘要坍缩为近乎重复标签的同质表格语料库(TatQA),以及稠密检索已能在单次中呈现足够证据的开放域池(HAGRID)。这些是结构性范围限制而非实现问题,并推动导航与检索之间的逐查询混合路由。
附录 A 编译细节
顶层技能标签。 默认配置 (p=10,K=10) 在 WixQA 语料库上产生的 6 个技能见表 6。
表 6:CORPUS2SKILL 在 WixQA 上产生的顶层技能。
| commerce-operations | 1,682 | 商务、POS、支付 |
| platform-overview | 1,770 | 编辑器、CMS、设计 |
| platform-ecosystem | 1,797 | 域名、计费、生命周期 |
| members-community | 256 | 会员、门控访问 |
| bookings-platform | 283 | 预订、日程 |
| media-display | 433 | 画廊、店面 |
嵌入。 文档和聚类摘要使用 Qwen/Qwen3-Embedding-8B 嵌入,这是一个 7.6B 参数句子编码器,产生 4,096 维嵌入。我们使用文档提示模板,批量大小 32,单 GPU。
文档摘要卡片。 嵌入前,每个文档由轻量级摘要卡片 LLM 调用处理(Claude Haiku 4.5,≤250 输出 token,每文档单次 API 调用,异步信号量 20)。卡片是 JSON 对象,字段 title、one_line 和 phrases(最多四个 1-4 词特征短语,如产品名或功能标志)。卡片与(截断的)原始文本拼接为单个字符串,每文档嵌入一个向量;卡片也保留在文档记录上,稍后复用为 INDEX.md 行元数据,因此每文档摘要成本在嵌入、导航和服务中摊销。
聚类摘要。 聚类摘要由 Claude Sonnet 4.6 通过直接 API 调用产生(无智能体循环)。第 1 层摘要压缩最多 15 个文档文本(每 600 字符);更深层摘要压缩最多 20 个子摘要(每 300 字符)。摘要使用异步调用并发执行,信号量 20。内部层聚类通过拼接其摘要与采样成员摘录重新嵌入,然后传递给下一轮 K-Means,因此每个更高层向量既反映抽象摘要也反映表面词汇信号。
软分配。 K-Means 分配使用余弦相似度边际阈值 τ=0.05:top-1 与 top-2 质心相似度差距低于 τ 的项保留主父节点,并额外注册次父节点。次分配不复制为完整文档;次优父节点的 INDEX.md 将它们列为 @see 存根,指回规范位置。在 WixQA 编译中,这产生 2,068 个次存根,分布在 665 个导航文件中。
LLM 验证与重分区。 每层聚类摘要后,验证与重分区 LLM 通过一起检查所有同级聚类摘要(每调用最多 60 个聚类批次),并提出 ID 级重新分配,其中两个摘要覆盖同一主题(易混淆)或一个摘要跨越多个主题(混合)。该通过仅在第 1 和第 2 层操作,每次编译每个聚类最多访问一次;受影响的聚类在重新分配后重新摘要。这为每个受影响同级组增加一次额外 Sonnet 调用,每个重分区聚类增加一次重新摘要调用。
范例。 对于每个非叶聚类,最接近质心的 top-3 文档(按余弦相似度)出现在渲染的 SKILL.md/INDEX.md 的 ## Example documents 部分下。范例携带摘要卡片中的文档标题和一行描述。
实体提取与相关技能。 一旦聚类层级稳定,一次批量 Sonnet 调用集为每个聚类摘要打上最多 12 个命名实体(专有名词、产品名、错误代码、文件格式)和最多 4 个文档类型标签。实体标签聚合为语料库级 entity_index.json,将每个实体映射到提及它的技能路径(按提及次数排序)。对于每个顶层技能,按实体 Jaccard 重叠的 top-3 同级技能记录为 ## Related skills,给智能体明确的交叉跳转目标。在 WixQA 编译中,这产生 entity_index.json 中的 2,328 个不同条目。
文档级摘要提示。 用于最低层摘要原始文档聚类。
聚类级摘要提示。 用于更高层将子聚类摘要组摘要为更广泛概述。
标签提示。 用于从聚类摘要生成文件系统安全目录名。响应后处理:小写、非字母数字替换为连字符、截断到 50 字符。
附录 B 技能结构示例
我们展示 WixQA 编译(默认配置:p=10,K=10)中代表性导航文件的完整内容。这些是智能体导航时读取的文件。
Skill-L.md。 此文件位于 skill-00-wix-commerce-operations 技能目录顶部,是覆盖 1,682 文档、跨 11 子组的最大技能。智能体在一次工具调用中读取此文件,并使用子组摘要决定探索哪个分支。
中层 INDEX.md。 此文件位于根下一层,在 group-04-wix-payments-processing/ 内,覆盖 113 文档、跨 10 个叶组。智能体在决定上述 SKILL.md 中支付相关后读取此文件。
叶级 INDEX.md。 此文件位于层级底部,在 group-06-wix-payments-processing/ 下的支付处理分支内。它列出单个文档 ID 及标题和摘要。智能体读取此文件以选择通过 get_document 检索哪些文档。
附录 C 编译提示
编译流水线使用三个 LLM 提示,每个作为单次 API 调用发出(无智能体循环或工具使用)。
文档级摘要。 用于最低层摘要原始文档聚类。
聚类级摘要。 用于更高层将子聚类摘要组摘要为更广泛概述。
标签。 用于从聚类摘要生成文件系统安全目录名。响应后处理:小写、非字母数字替换为连字符、截断到 50 字符。
文档摘要卡片。 编译开始时每文档发出一次。返回的 JSON 卡片与截断原始文本拼接用于嵌入,并复用为 INDEX.md 行元数据。
验证与重分区。 每层级发出一次(每调用超过 60 个同级聚类则跳过)。要求模型标记易混淆聚类对和混合单个聚类,并返回 ID 级重新分配。更改逐字应用;受影响的聚类重新摘要。
实体和文档类型提取。 层级稳定后每聚类发出一次,并发批量。返回的命名实体聚合到 entity_index.json,并驱动每技能 Related skills 交叉引用。
附录 D 服务系统提示(节选)
在承诺路径之前,扫描至少 2 个候选顶层技能。如果查询提及特定实体,首先 'cat entity_index.json | grep -i <entity>' 找到每个引用它的技能,并读取提及次数最高的 top 2 的 SKILL.md。否则读取 2 个最合理顶层技能的 SKILL.md。对于每个候选,在剪枝前深入一层(读取其第一个相关 INDEX.md)。写下保留哪些候选及原因。3. 在叶节点,使用 'cat … | grep …' 对 INDEX.md 文档行选择最有希望的 doc_ids——行包括文档标题、一行描述和关键短语,通常足以三角定位而无需打开任何内容。4. 如果两个候选路径返回可比证据,从两者检索文档并显式比较。选择最佳答案;不要只取第一个匹配。5. 如果候选技能有 '#' Related skills' 块且初始路径稀薄,在放弃前交叉跳转到相关技能。6. 在回答前至少通过 get_document 读取一个完整文档。
工具。 代码执行:使用 'ls'、'cat'、'cat … | grep …' 导航技能层级和 entity_index.json。get_document (doc_id):根据 ID 检索文档全文。
答案格式。 第一句——直接答案。无前言。事实性问题:1-3 句(最多 80 词)。程序性问题:仅编号步骤(最多 150 词)。纯文本。无粗体、标题或分隔线。仅一种方法。不要呈现替代方案。永远不要添加“联系支持”或结束语。
附录 E 完整导航轨迹
我们展示 WixQA 评估集(200 个专家编写的测试查询,Claude Sonnet 4.6 服务智能体)中四个查询的完整导航轨迹和原始工具调用。
轨迹 1:直接下降(Factuality 1.0,CtxR 1.0)。 查询:“我需要将业务类型从独资企业改为 LLC 以使用 EIN。”
轨迹 2:日历同步(Factuality 1.0,CtxR 1.0)。 查询:“如何将酒店应用与我的日历 iCal 链接同步,以便访客预订可用日期?”
[上下文:智能体看到 6 个技能描述]
第 1 轮 智能体思考:酒店和日历同步属于“wix-commerce-operations”,覆盖酒店运营和预订。
工具:code_execution cat skill-00-wix-commerce-operations/SKILL.md
结果:列出 11 个子组,包括:group-02-wix-hotels-bookings/(109 文档):“Wix Hotels and Bookings:房间配置、定价、日历同步和 OTA 渠道管理”
工具:code_execution cat group-02-wix-hotels-bookings/INDEX.md
结果:8 个叶组。智能体识别 group-07-hotel-channel-manager-setup 覆盖外部日历集成。
工具:code_execution cat group-07-hotel-channel-manager-setup/INDEX.md
结果:列出 17 个文档,包括:- 5f02fc2f8937:“从外部日历导入预订(iCal)”- 741830b917b4:“将 Airbnb iCal 连接到您的站点”
第 2 轮 工具:get_document {"doc_id": "5f02fc2f8937d16a"}
结果:原始 Wix Hotels 的 iCal 导入分步指南。
工具:get_document {"doc_id": "741830b917b47d07"}
结果:Wix Hotels by HotelRunner 的 Airbnb iCal 连接指南。
答案——“对于原始 Wix Hotels:转到 Hotels 标签 > Reservations > iCal,选择房型,粘贴 iCal URL,点击 Save。对于 HotelRunner:转到仪表板,导航到渠道连接,为每个属性添加 Airbnb iCal 链接…”
导航:6221 – 1682 – 109 – 17 – 2
轨迹 3:移动快速操作(Factuality 1.0,CtxR 1.0)。 查询:“我需要暂时从移动视图中移除快速操作按钮。”
第 1 轮 智能体思考:移动站点编辑属于“wix-platform-overview”,覆盖编辑器、CMS 和设计。
工具:code_execution cat skill-01-wix-platform-overview/SKILL.md
结果:14 个子组。智能体选择 group-13-wix-mobile-apps 覆盖移动编辑器功能。
工具:code_execution cat group-13-wix-mobile-apps/INDEX.md
结果:叶组覆盖移动 UI 元素。智能体找到 group-00 含 Quick Action Bar 文档(6 文档)。
工具:code_execution cat group-00-mobile-quick-action-bar/INDEX.md
结果:6 个文档,包括:- bce5e3d829fe:“添加和设置快速操作栏”
第 2 轮 工具:get_document {"doc_id": "bce5e3d829fe6eeb"}
答案——“没有隐藏选项,只有删除。在移动编辑器中右键点击快速操作栏并选择删除。以后要重新添加,转到移动工具并点击添加。”
导航:6221 – 1770 – 60 – 6 – 1
轨迹 4:跨分支探索(Factuality 1.0,CtxR 1.0)。 查询:“我想更改课程的货币。”
[上下文:智能体看到 6 个技能描述]
第 1 轮 智能体思考:“课程”暗示“wix-platform-ecosystem”下的在线课程,
附录 F 与先前工作的定位
表 7:CORPUS2SKILL 相对先前工作的定位。
| 输入 | 文档 | 文本块 | 文档 | 轨迹 | 文档 |
| 组织 | 扁平聚类 | 层级树 | 知识图谱 | 技能库 | 层级技能树 |
| 导航 | 人工用户 | 算法 | 图搜索 | 向量相似度 | LLM 智能体 |
| 服务基础设施 | 聚类索引 | 向量索引 | 图数据库 | 向量数据库 | 仅 LLM |
附录 G 失败分析
顶层路由错误占失败的大多数,其中广泛技能摘要未能区分密切相关的主题。
部分导航(16 查询)。 智能体检索集与金标准部分重叠 (0<Context Recall<0.6)(0<Context Recall<0.6),但包含太多不相关文档,稀释上下文并产生低质量答案。智能体识别了正确的一般主题区域,但从邻近叶组过度检索。
综合错误(5 查询)。 智能体检索到上下文相关文档(Context Recall ≥0.6≥0.6),但产生事实错误答案,通常通过过度概括多篇文章或将条件指令误解为通用。
未检索到文档(5 查询)。 五个查询导致零或接近零检索。包括域外查询(“如何清除浏览器缓存?”、Gmail 密码重置问题、Google Ads 计费),智能体无法定位匹配技能分支,拒绝回答而非幻觉。
要点。 主要瓶颈仍是初始主题路由:45 个失败中 19 个源于智能体选择错误顶层分支。窄树消融(第 5.4 节)产生更细粒度顶层聚类,通过第一步导航提供更锐利的主题分离,部分缓解此问题。
附录 H 基线实现细节
所有基线使用相同 LLM(Claude Sonnet)生成答案和相同评估提示以公平比较。
BM25。 我们使用 rank_bm25 库实现 BM25 稀疏关键词检索(Robertson and Zaragoza, 2009)。文档在全文级别分词和索引。查询时,我们按 BM25 分数检索 top-5 文章,作为上下文传递给单次 LLM 调用。
Dense。 我们使用 Qwen3-Embedding-0.6B(Zhang et al., 2025)编码所有文档,产生 1024 维嵌入存储在 FAISS 扁平索引(Johnson et al., 2019)。我们使用文档提示模板编码文章,查询提示模板编码问题。查询时,我们按余弦相似度检索 top-5 最近邻,作为上下文传递给单次 LLM 调用。
Hybrid。 我们使用倒数排名融合(Cormack et al., 2009)结合 BM25 和 Dense 分数,k=60,等权重 (α=0.5)。融合排名选择 top-5 段落,传递给单次 LLM 调用。
RAPTOR。 我们忠实实现 RAPTOR 算法(Sarthi et al., 2024):UMAP(McInnes et al., 2018)降维,高斯混合模型(GMM)软聚类(McLachlan and Peel, 2000)和基于 BIC 的聚类数选择(Schwarz, 1978),以及聚类递归摘要。递归聚类摘要使用 Claude Sonnet 4.6,与 CORPUS2SKILL 编译器相同的摘要模型,因此两个嵌入-聚类-摘要流水线在摘要器上匹配。我们使用与 Dense 基线相同的嵌入模型(Qwen3-Embedding-0.6B)以保持一致;附录 K 报告编码器控制交叉,其中 CORPUS2SKILL 和基线在任一编码器大小运行。查询时,折叠树检索同时搜索所有层级,返回来自任何层的 top-5 段落。
Agentic。 LLM 智能体获得三个搜索工具(search_bm25、search_dense、search_hybrid),每个返回 top-kk 结果。系统提示指示智能体先搜索,然后基于累积证据回答,选择 BM25 用于精确术语和产品名,稠密用于概念查询,混合作为默认策略。智能体可发出最多 10 轮迭代检索,基于中间结果重构子查询。证据跨所有轮次累积;当智能体停止时,产生结构化 JSON 响应,包含答案和从完整证据池中精选的 top-5 引用。为评估公平,上下文召回在最后 5 个检索文档上计算(匹配单次基线的上下文窗口)。此基线测试传统搜索基础设施上的智能体多轮检索能否匹配基于导航的探索。
附录 I 评估指标
词汇和语义答案质量指标。 Token F1 将预测和金标准答案分词为词 token,计算 token 级精确率和召回率的调和平均。BERTScore-F1(Zhang et al., 2020)使用 RoBERTa-large 编码器(Liu et al., 2019)计算预测和金标准答案之间的上下文嵌入相似度 F1,rescale_with_baseline = False;对释义比 n-gram 重叠指标更稳健。我们每查询计算一次并报告均值。
LLM 评判的答案质量和接地性指标。 Factuality、Faithfulnessgrd、Context Recall、Context Precision 和 Answer Relevance 使用 LLM 评判者(Zheng et al., 2023)遵循 RAGAS 框架(Es et al., 2024),5 分制归一化到 0-1。Factuality 将生成答案与金标准答案比较(独立于检索上下文)。Faithfulnessgrd 根据检索上下文评分每个生成主张,标记幻觉,无论答案是否恰好匹配金标准。Context Recall 询问检索上下文是否覆盖金标准答案主张;Context Precision 询问检索块是否主要相关;Answer Relevance 询问生成答案是否针对查询。我们使用 Claude Sonnet 4.6 作为评判者,贪婪解码和零温度提示,并对每种方法应用相同评判模型和标准化上下文窗口以保持公平。
幻觉率。 我们报告 Hallucination Rate 为 Faithfulnessgrd <0.6 的查询比例(即生成内容未充分接地于检索上下文,遵循 RAGAS 惯例)。此指标越低越好,捕捉部署者关心的操作性问题“系统多久产生一次幻觉?”,而非连续分数的均值。
上下文召回标准化。 一个关键设计决策是跨不同检索范式(单次、多轮和基于导航)标准化 Context Recall 测量。为公平比较,所有方法遵循相同协议:(1)收集方法检索的最后 5 个文档或段落;(2)用分隔符连接;(3)截断到统一 8,000 字符窗口。LLM 评判者接收此标准化上下文。这确保单次基线贡献其 top-5 检索段落,Agentic 贡献其多轮检索的最后 5 个文档,CORPUS2SKILL 贡献通过 get_document 工具调用检索的最后 5 个文档。
成本指标。 输入 token 计数是跨所有轮次发送给 LLM 的总 token 数。每查询成本使用模型发布的每 token 定价(输入和输出 token 合计),包括 Anthropic 临时缓存折扣(缓存读取输入按 0.1× 基础费率,缓存写入按 1.25×)。对于单次方法,成本反映一次 LLM 调用;对于多轮方法(Agentic、CORPUS2SKILL),反映所有轮次包括工具调用推理。
附录 J 数据集许可证、预期用途和文档
许可证。 我们使用两个公开发布的基准数据集。WixQA(Cohen et al., 2025)在 Hugging Face<sup>4</sup> 上以 MIT 许可证分发,允许无限制使用、修改和再分发,需署名。RAGBench(Friel et al., 2024)在 Hugging Face<sup>5</sup> 上以 Creative Commons Attribution 4.0 International (CC-BY-4.0) 许可证分发,允许共享和改编,任何目的,需适当署名。我们自己的代码在 GitHub – dukesun99/Corpus2Skill: Official Findings of EMNLP 2026 implementation of Corpus2Skill: compile a document corpus into a navigable skill hierarchy that LLM agents explore at query time, with document lookup instead of a serving-time vector-search service. · GitHub 以 MIT 许可证发布。
与预期用途的一致性。 两个数据集都是作为评估检索增强生成系统的基准创建的,这正是我们使用它们的方式。WixQA 设计用于评估企业 RAG 流水线在客户支持知识库上的表现;我们使用其 200 个专家编写的测试查询和 6,221 篇文章语料库作为主要评估(第 5 节)。RAGBench 设计为多域 RAG 评估基准;我们使用其 12 个子集中的 10 个进行泛化研究(第 5.3 节)。我们不重新分发任一数据集的修改版本。我们的衍生制品(编译技能层级)是原始语料库的确定性转换,仅用于研究评估。
文档和覆盖范围。 所有实验仅使用英语数据。WixQA 覆盖企业客户支持域(Wix.com 帮助中心文章,涵盖商务、站点设计、计费、SEO 和平台管理),包含 6,221 文档和三个 QA 子集:200 专家编写查询、200 模拟查询和 6,221 合成查询。10 个 RAGBench 子集跨越五个广泛域:医学(CovidQA)、法律(CUAD)、技术支持(TechQA、EManual、DelucionQA)、金融(FinQA、TatQA)和开放域(HAGRID、ExpertQA、ClapNQ),语料库大小每子集 221 到 12,727 文档。两个数据集均不含个人可识别信息;WixQA 由公共帮助中心文章组成,RAGBench 聚合先前发布的学术数据集。我们不对人口代表性做声明,因为两个基准都是主题 QA 数据集而非面向用户的人口研究。语料库统计和评估协议的完整细节见第 5 节和附录 H。
附录 K 统计检验和额外控制
本附录给出每个胜/平/负陈述背后的统计协议,以及第 5.4 和 5.5 节总结的控制完整结果。除非另有说明,表格使用主要设置:WixQA(6,221 支持文章,200 专家编写查询),Claude Sonnet 4.6 作为编译和服务 LLM,Qwen3-Embedding-8B 作为编译编码器,Token F1 对金标准答案作为指标。
配对 bootstrap 协议。 对于每个数据集,我们将 CORPUS2SKILL 的逐查询 Token F1 与最佳基线在匹配查询上配对,并重采样配对差异 10,000 次。如果正均值差异的双侧 pp 值低于 0.05,数据集为胜;反之为负;否则为平。逐指标置信区间在发布代码中,相同程序是表 9 增量的基础。
表 8:WixQA Token F1 编码器交叉(每单元格 200 查询):编码器选择几乎不移动 CORPUS2SKILL,对基线帮助至多 +0.023
| Dense | 0.364 | 0.378 |
| Hybrid | 0.361 | 0.360 |
| RAPTOR | 0.398 | 0.421 |
| CORPUS2SKILL | 0.461 | 0.458 ± 0.002 (3 runs) |
表 9:CORPUS2SKILL – RAPTOR,WixQA 配对 bootstrap(200 查询,10k 重采样),编译资源在任一编码器大小匹配。RAPTOR 在所有行使用相同 Sonnet 4.6 摘要器。
| Token F1 | +0.064 (p<0.0001) | +0.035 (p<0.0001) |
| BERTScore | +0.025 (p<0.0001) | +0.020 (p<0.0001) |
| Context Precision | +0.181 (p<0.0001) | +0.085 (p<0.0001) |
| Context Recall | +0.084 (p=0.007) | -0.036 (p=0.22, tie) |
表 10:逐数据集 Token F1 裁决(配对 bootstrap vs. 每数据集最佳基线)。Δ 是匹配查询上逐查询配对差异均值,可能与列均值差略有不同。
| WixQA | RAPTOR | 0.456 | 0.397 | +0.059 | <0.001 | 胜 |
| Emanuel | Agentic | 0.497 | 0.455 | +0.061 | <0.001 | 胜 |
| DelucionQA | Dense | 0.478 | 0.439 | +0.034 | 0.010 | 胜 |
| ExpertQA | Dense | 0.356 | 0.330 | +0.027 | <0.001 | 胜 |
| ClapNQ | Dense | 0.468 | 0.333 | +0.135 | <0.001 | 胜 |
| CovidQA | Hybrid | 0.208 | 0.216 | -0.009 | 0.33 | 平 |
| TechQA | Hybrid | 0.396 | 0.383 | +0.013 | 0.14 | 平 |
| FinQA | Dense | 0.392 | 0.400 | -0.009 | 0.49 | 平 |
| CUAD | BM25 | 0.272 | 0.314 | -0.052 | <0.001 | 负 |
| HAGRID | Agentic | 0.188 | 0.356 | -0.167 | <0.001 | 负 |
| TatQA | Agentic | 0.240 | 0.355 | -0.116 | <0.001 | 负 |
服务时方差。 对同一编译 WixQA 树的三次独立 200 查询服务通过给出(均值 ± sd)Token F1 0.458±0.002、BERTScore 0.863±0.001、Factuality 0.767±0.008、Context Recall 0.699±0.010 和 Hallucination Rate 0.065±0.018。阈值化幻觉率是变异性最大的指标。
无提示缓存的成本。 从原始 token 日志移除临时缓存折扣,CORPUS2SKILL 从 0.153升至升至 \\ 0.302 每查询 (1.97×),Agentic 从 0.082升至升至 \\ 0.0980.098 (1.19×);排序不变。