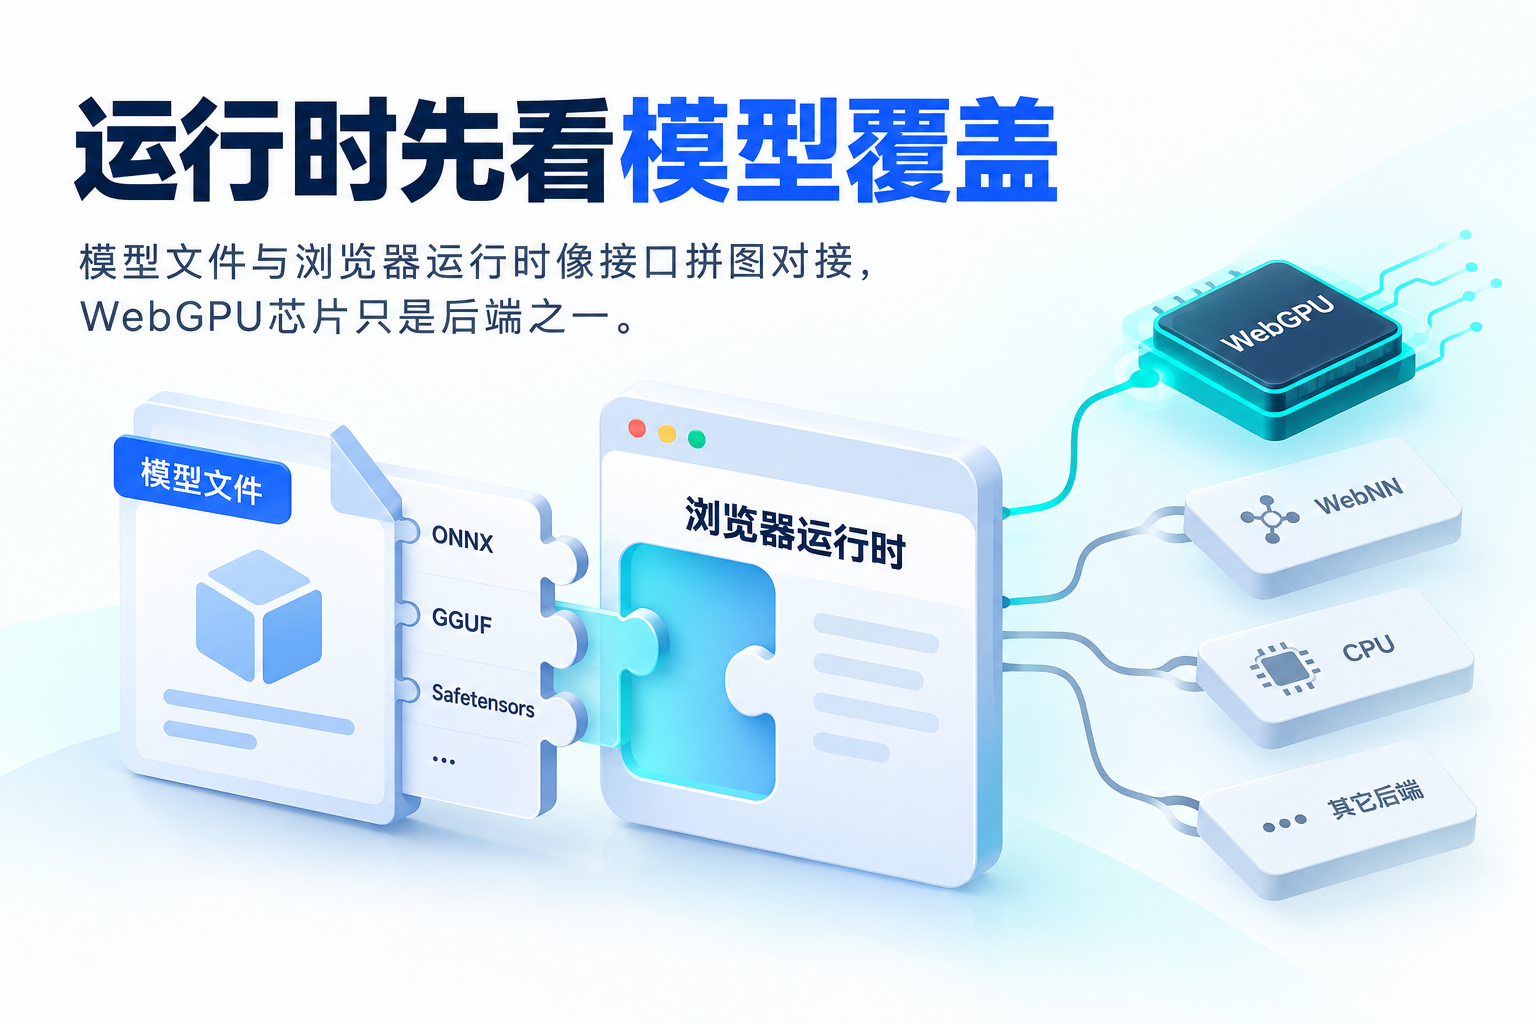
页面能申请 GPUDevice,说明获得了一种计算能力,不代表目标模型已经可运行。模型格式、算子、精度、预处理和资源预算仍可能让推理失败。
2026 年 10 月 19 日,Google 介绍 LiteRT Tensor API:用原生 C++ 逐算子构建图,提供更底层的控制。官方同时建议大多数项目先考虑已有转换路线。它与面向 Web 的 LiteRT.js 所处层次不同,不能把原生 NPU 或图构建能力直接写成一行 JavaScript 的浏览器能力。
选择前先固定任务和模型
先确定输入输出、可接受误差与失败回退,再挑模型。模型文件的下载地址、许可、权重摘要、转换器与预处理版本都应固定。没有这些,比较“运行时 A 比 B 快”可能实际上比较了不同模型或不同精度。
EmbeddingGemma 2 的十月资料可以帮助确定一个嵌入任务候选,但不替任何 Web 运行时保证算子覆盖。遇到不支持的模型,应明确写失败或换路线;不能把模拟输出接进 UI 后宣称兼容。
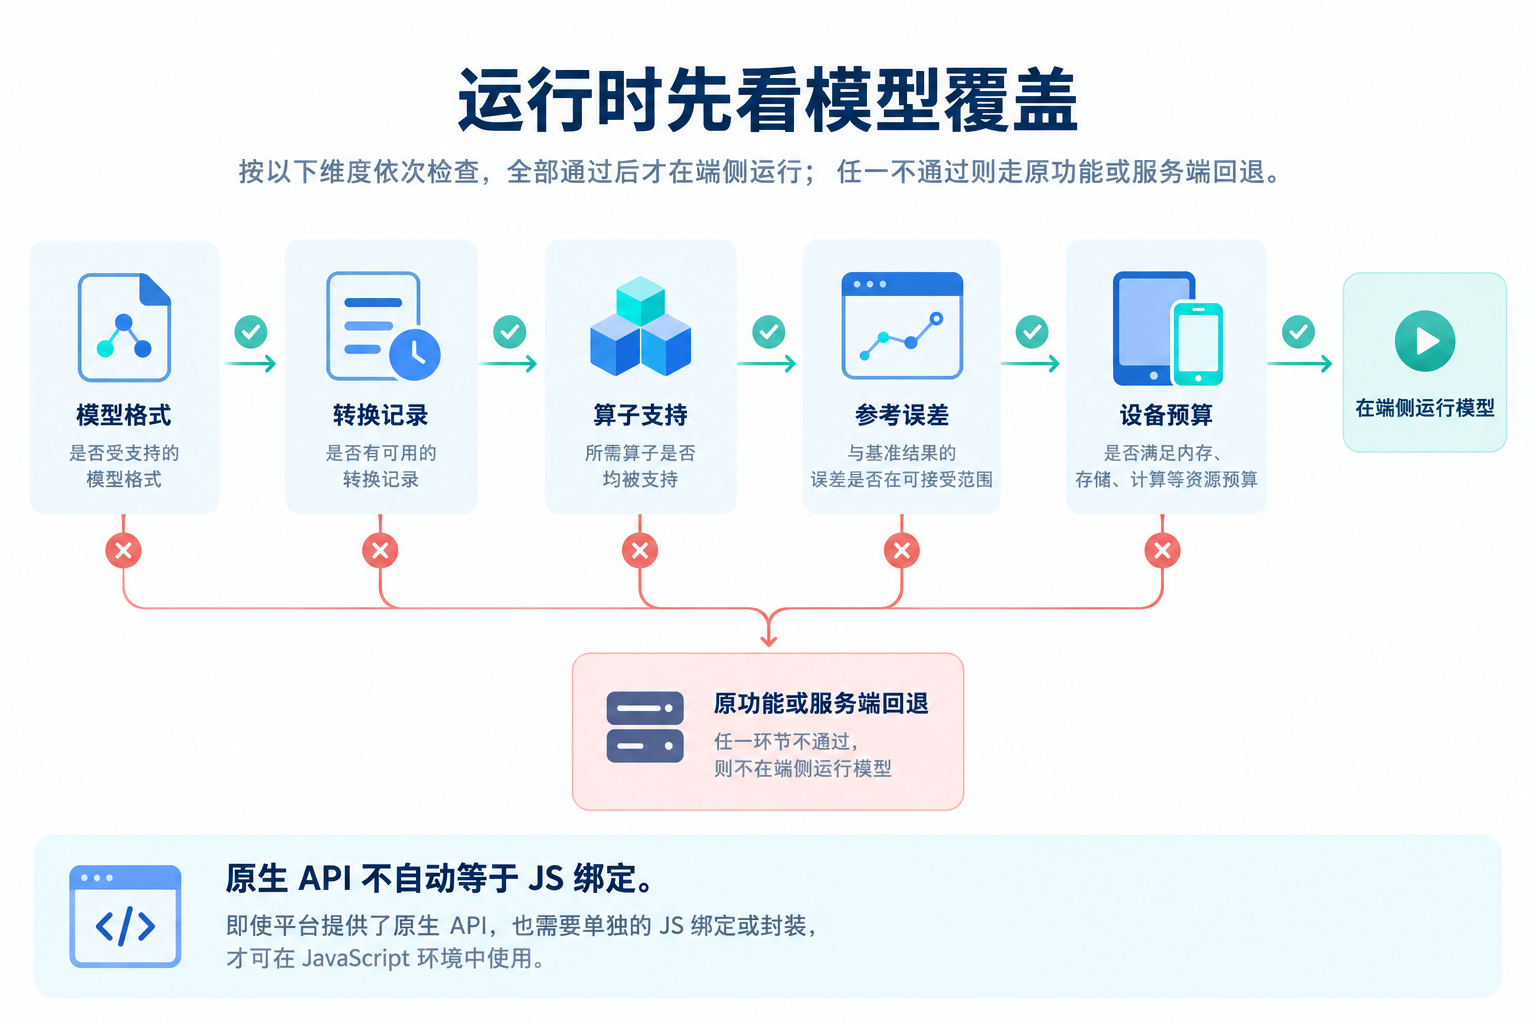
图中的格式名称只表示需要逐项核验的候选,不表示任一运行时都支持这些格式。
把缺失证据与失败分开
以下函数只审核一个自建实验记录,不调用真实运行时。缺证据是 pending,已执行且不支持是 failed,通过全部记录才进入评审。保存为 runtime-evidence.mjs,运行 node runtime-evidence.mjs:
import assert from "node:assert/strict";
function assess(record) {
const missing = [];
for (const key of ["modelDigest", "license", "runtimeVersion", "conversionCommand"])
if (typeof record[key] !== "string" || !record[key].trim()) missing.push(key);
for (const key of ["opsSupported", "referenceMatched", "budgetMet", "fallbackChecked"])
if (typeof record[key] !== "boolean") missing.push(key);
if (missing.length) return { status: "pending", missing };
const failed = ["opsSupported", "referenceMatched", "budgetMet", "fallbackChecked"]
.filter(key => !record[key]);
return { status: failed.length ? "failed" : "ready-for-review", failed };
}
const good = {
modelDigest: "fixture-not-a-real-model", license: "fixture-license",
runtimeVersion: "fixture-runtime", conversionCommand: "fixture command",
opsSupported: true, referenceMatched: true, budgetMet: true, fallbackChecked: true
};
assert.equal(assess({}).status, "pending");
assert.equal(assess(good).status, "ready-for-review");
assert.deepEqual(assess({ …good, opsSupported: false }).failed, ["opsSupported"]);
assert.equal(assess({ …good, referenceMatched: undefined }).status, "pending");
assert.deepEqual(assess({ …good, budgetMet: false, fallbackChecked: false }).failed,
["budgetMet", "fallbackChecked"]);
console.log("evidence-state tests passed; no runtime/model benchmark performed");
这些布尔值必须由可追溯的实验填入,不能让模型自由补全。真实 manifest 还应保存具体设备、输入、输出摘要、容差、运行日志及失败原因。一个 ready-for-review 只是记录完整且满足预设条件,不等于已获上线批准。
三类候选的比较方式
已有 Web 运行时适合模型格式与算子都能覆盖的任务;手写 WebGPU kernel 适合边界清楚、参考实现可得的定制计算;原生图构建适合确有底层控制需求且团队能够维护绑定与构建链的场景。它们不是按“越底层越先进”排队。
对每条路线都测完整成本:运行时与权重下载、初始化、预处理、推理、回读、后处理。CPU 回退可能可用却超出交互预算,不能只写“支持 CPU”就认为体验合格。设备丢失、缓存驱逐、标签页切换也要留下失败路径。
精度检查应先和固定参考实现比较,再看业务质量。数值误差小,不自动保证检索或分类任务没有误伤;反过来,某些误差对任务无影响,也需要任务集证据支持。
回退必须能真正完成原任务
服务端回退需要说明上传数据与网络依赖;原功能回退则可能降低智能程度,但保留可操作的搜索或编辑。自动重试不同模型还可能改变质量、许可与费用,不能只在内部偷偷切换。
本轮已运行 Node v26.3.0 的证据状态测试;未下载、转换或执行模型,未测 WebGPU/NPU,也没有运行时排名。没有支持证据的组合都应留在待验证栏。
参考资料:LiteRT Tensor API,2026-10-19;LiteRT.js,2026-07-09;EmbeddingGemma 2,2026-10-06。采用前重新核对所选模型与绑定的实际支持。

