前言
在掌握了卷积神经网络(CNN)的基本组件(如卷积层、池化层)之后,最好的学习方式就是通过一个完整的项目来巩固知识。本文将带领大家梳理使用 PyTorch 框架,从零开始构建一个卷积神经网络,并在经典的 CIFAR-10 数据集上进行训练和测试,最终完成一个图像分类任务的完整思路。
我们将遵循深度学习项目的标准步骤:
一、 了解 CIFAR-10 数据集
CIFAR-10 是一个广泛用于图像识别研究的小型彩色图像数据集。它包含了 10 个类别 的 32×32 彩色图像,具体信息如下:
- 训练集:50,000 张图像
- 测试集:10,000 张图像
- 类别数:10 个(飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车)
- 图像尺寸:32 x 32 x 3 (高 x 宽 x 通道)
下图展示了 CIFAR-10 数据集中的部分样本:

二、 搭建初始图像分类网络
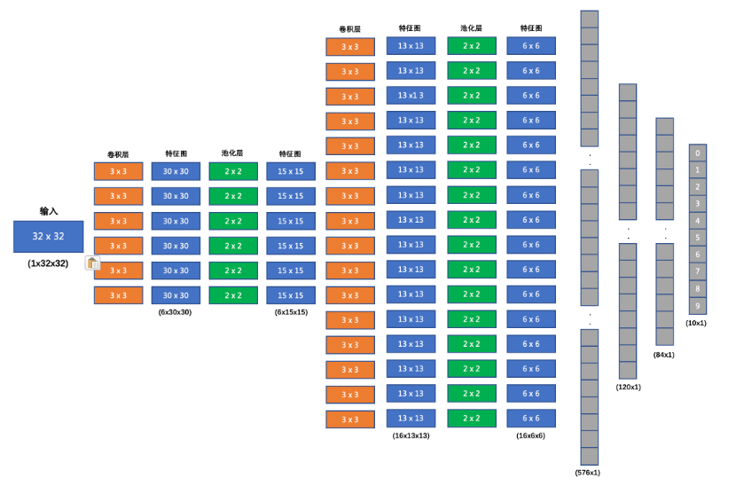
我们首先构思一个相对简单的CNN网络,其结构如下,这个结构也被称为 LeNet-5 的一种变体:
- 输入层:接收 32x32x3 的图像。
- 卷积层 1:输入3通道,输出6通道,卷积核大小 3×3。
- 池化层 1:最大池化,窗口大小 2×2,步长 2。
- 卷积层 2:输入6通道,输出16通道,卷积核大小 3×3。
- 池化层 2:最大池化,窗口大小 2×2,步长 2。
- 全连接层 1:将池化后的特征图拉平,输入 576 维,输出 120 维。
- 全连接层 2:输入 120 维,输出 84 维。
- 输出层:输入 84 维,输出 10 维(对应10个类别)。
在每个卷积层和全连接层之后,我们都使用 ReLU 激活函数来增加网络的非线性表达能力。
网络结构图如下所示:
三、 训练与评估流程
在搭建好网络结构后,我们需要定义清晰的训练和评估流程。
训练流程的核心是一个循环,它会遍历指定轮数(Epochs)。在每一轮中,程序会:
评估流程则用于检验模型在未见过的测试集上的泛化能力:
四、 完整代码实现
下面是实现上述网络、训练和预测的完整 Python 代码。代码注释详细,方便理解每一步的作用。
4.1 准备工作
确保您已经安装了必要的库:
pip install torch torchvision matplotlib torchsummary
4.2 完整代码
"""
案例:
演示CNN的综合案例, 图像分类.
回顾: 深度学习项目的步骤
1. 准备数据集.
这里我们用的时候 计算机视觉模块 torchvision自带的 CIFAR10数据集, 包含6W张 (32,32,3)的图片, 5W张训练集, 1W张测试集, 10个分类, 每个分类6K张图片.
你需要单独安装一下 torchvision包, 即: pip install torchvision
2. 搭建(卷积)神经网络
3. 模型训练.
4. 模型测试.
卷积层:
提取图像的局部特征 -> 特征图(Feature Map), 计算方式: N = (W – F + 2P) // S + 1
每个卷积核都是1个神经元.
池化层:
降维, 有最大池化 和 平均池化.
池化只在HW上做调整, 通道上不改变.
案例的优化思路:
1. 增加卷积核的输出通道数(大白话: 卷积核的数量)
2. 增加全连接层的参数量.
3. 调整学习率
4. 调整优化方法(optimizer…)
5. 调整激活函数…
6. …
"""
# 导包
import torch
import torch.nn as nn
from torchvision.datasets import CIFAR10
from torchvision.transforms import ToTensor # pip install torchvision -i https://mirrors.aliyun.com/pypi/simple/
import torch.optim as optim
from torch.utils.data import DataLoader
import time
import matplotlib.pyplot as plt
from torchsummary import summary
# 每批次样本数
BATCH_SIZE = 8
# 1. 准备数据集.
def create_dataset():
# 1. 获取训练集.
# 参1: 数据集路径. 参2: 是否是训练集. 参3: 数据预处理 -> 张量数据. 参4: 是否联网下载(直接用我给的, 不用下)
train_dataset = CIFAR10(root='./data', train=True, transform=ToTensor(), download=True)
# 2. 获取测试集.
test_dataset = CIFAR10(root='./data', train=False, transform=ToTensor(), download=True)
# 3. 返回数据集.
return train_dataset, test_dataset
# 2. 搭建(卷积)神经网络
class ImageModel(nn.Module):
# 1. 初始化父类成员, 搭建神经网络.
def __init__(self):
# 1.1 初始化父类成员.
super().__init__()
# 1.2 搭建神经网络.
# 第1个卷积层, 输入 3通道, 输出6通道, 卷积核大小3*3, 步长1, 填充0
self.conv1 = nn.Conv2d(3, 6, 3, 1, 0)
# 第1个池化层, 窗口大小 2*2, 步长2, 填充0
self.pool1 = nn.MaxPool2d(2, 2, 0)
# 第2个卷积层, 输入 6通道, 输出16通道, 卷积核大小3*3, 步长1, 填充0
self.conv2 = nn.Conv2d(6, 16, 3, 1, 0)
# 第2个池化层, 窗口大小 2*2, 步长2, 填充0
self.pool2 = nn.MaxPool2d(2, 2, 0)
# 第1个隐藏层(全连接层), 输入: 576, 输出: 120
self.linear1 = nn.Linear(576, 120)
# 第2个隐藏层 (全连接层), 输入: 120, 输出: 84
self.linear2 = nn.Linear(120, 84)
# 第3个隐藏层 (全连接层) -> 输出层, 输入: 84, 输出: 10
self.output = nn.Linear(84, 10)
# 2. 定义前向传播
def forward(self, x):
# 第1层: 卷积层(加权求和) + 激励层(激活函数) + 池化层(降维)
# 分解版.
# x = self.conv1(x) # 卷积层
# x = torch.relu(x) # 激励层
# x = self.pool1(x) # 池化层
# 合并版 池化 + 激活函数 + 卷积
x = self.pool1(torch.relu(self.conv1(x)))
# 第2层: 卷积层(加权求和) + 激励层(激活函数) + 池化层(降维)
x = self.pool2(torch.relu(self.conv2(x)))
# 细节: 全连接层只能处理二维数据, 所以要将数据进行拉平 (8, 16, 6, 6) -> (8, 576)
# 参1: 样本数(行数), 参2: 列数(特征数), -1表示自动计算.
x = x.reshape(x.size(0), –1) # 8行576列
# print(f'x.shape: {x.shape}')
# 第3层: 全连接层(加权求和) + 激励层(激活函数)
x = torch.relu(self.linear1(x))
# 第4层: 全连接层(加权求和) + 激励层(激活函数)
x = torch.relu(self.linear2(x))
# 第5层: 全连接层(加权求和) -> 输出层
return self.output(x) # 后续用 多分类交叉熵损失函数CrossEntropyLoss = softmax()激活函数 + 损失计算.
# 3. 模型训练.
def train(train_dataset):
# 1. 创建数据加载器.
dataloader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True)
# 2. 创建模型对象.
model = ImageModel()
# 3. 创建损失函数对象.
criterion = nn.CrossEntropyLoss() # 多分类交叉熵损失函数 = softmax()激活函数 + 损失计算.
# 4. 创建优化器对象.
optimizer = optim.Adam(model.parameters(), lr=1e-3)
# 5. 循环遍历epoch, 开始 每轮的 训练动作.
# 5.1 定义变量, 记录训练的总轮数.
epochs = 20
# 5.2 遍历, 完成每轮的 所有批次的 训练动作.
for epoch_idx in range(epochs):
# 5.2.1 定义变量, 记录: 总损失, 总样本数据量, 预测正确样本个数, 训练(开始)时间
total_loss, total_samples, total_correct, start = 0.0, 0, 0, time.time()
# 5.2.2 遍历数据加载器, 获取到 每批次的 数据.
for x, y in dataloader:
# 5.2.3 切换训练模式.
model.train()
# 5.2.4 模型预测.
y_pred = model(x)
# 5.2.5 计算损失.
loss = criterion(y_pred, y)
# 5.2.6 梯度清零 + 反向传播 + 参数更新
optimizer.zero_grad()
loss.backward()
optimizer.step()
# 5.2.7 统计预测正确的样本个数.
# print(y_pred) # 批次中, 每张图 每个分类的 预测概率.
# argmax() 返回最大值对应的索引, 充当 -> 该图片的 预测分类.
# tensor([9, 8, 5, 5, 1, 5, 8, 5])
# print(torch.argmax(y_pred, dim=-1)) # -1这里表示行. 预测分类
# print(y) # 真实分类
# print(torch.argmax(y_pred, dim=-1) == y) # 是否预测正确
# print((torch.argmax(y_pred, dim=-1) == y).sum()) # 预测正确的样本个数.
total_correct += (torch.argmax(y_pred, dim=–1) == y).sum()
# 5.2.8 统计当前批次的总损失. 第1批平均损失 * 第1批样本个数
total_loss += loss.item() * len(y) # [第1批总损失 + 第2批总损失 + 第3批总损失 + …]
# 5.2.9 统计当前批次的总样本个数.
total_samples += len(y)
# break 每轮只训练1批, 提高训练效率, 减少训练时长, 只有测试会这么写, 实际开发绝不要这样做.
# 5.2.10 走这里, 说明一轮训练完毕, 打印该轮的训练信息.
print(f'epoch: {epoch_idx + 1}, loss: {total_loss / total_samples:.5f}, acc:{total_correct / total_samples:.2f}, time:{time.time() – start:.2f}s')
# break # 这里写break, 意味着只训练一轮.
# 6. 保存模型.
torch.save(model.state_dict(), './model/image_model.pth')
# 4. 模型测试.
def evaluate(test_dataset):
# 1. 创建测试集 数据加载器.
dataloader = DataLoader(test_dataset, batch_size=BATCH_SIZE, shuffle=False)
# 2. 创建模型对象.
model = ImageModel()
# 3. 加载模型参数.
model.load_state_dict(torch.load('./model/image_model.pth')) # pickle文件
# 4. 定义变量统计 预测正确的样本个数, 总样本个数.
total_correct, total_samples = 0, 0
# 5. 遍历数据加载器, 获取到 每批次 的数据.
for x, y in dataloader:
# 5.1 切换模型模式.
model.eval()
# 5.2 模型预测.
y_pred = model(x)
# 5.3 因为训练的时候用了CrossEntropyLoss, 所以搭建神经网络时没有加softmax()激活函数, 这里要用 argmax()来模拟.
# argmax()函数功能: 返回最大值对应的索引, 充当 -> 该图片的 预测分类.
y_pred = torch.argmax(y_pred, dim=–1) # -1 这里表示行.
# 5.4 统计预测正确的样本个数.
total_correct += (y_pred == y).sum()
# 5.5 统计总样本个数.
total_samples += len(y)
# 6. 打印正确率(预测结果).
print(f'Acc: {total_correct / total_samples:.2f}')
# 5. 测试
if __name__ == '__main__':
# 1. 获取数据集.
train_dataset, test_dataset = create_dataset()
# print(f'训练集: {train_dataset.data.shape}') # (50000, 32, 32, 3)
# print(f'测试集: {test_dataset.data.shape}') # (10000, 32, 32, 3)
# # {'airplane': 0, 'automobile': 1, 'bird': 2, 'cat': 3, 'deer': 4, 'dog': 5, 'frog': 6, 'horse': 7, 'ship': 8, 'truck': 9}
# print(f'数据集类别: {train_dataset.class_to_idx}')
#
# # 图像展示
# plt.figure(figsize=(2, 2))
# plt.imshow(train_dataset.data[1111]) # 索引为1111的图像
# plt.title(train_dataset.targets[1111])
# plt.show()
# 2. 搭建神经网络.
# model = ImageModel()
# 查看模型参数, 参1: 模型, 参2: 输入维度(CHW, 通道, 高, 宽), 参3: 批次大小
# summary(model, (3, 32, 32), batch_size=1)
# 3. 模型训练.
# train(train_dataset)
# 4. 模型测试.
evaluate(test_dataset)
五、 模型优化:解决过拟合问题
在初次训练后,我们可能会发现模型在训练集上的准确率很高,但在测试集上的准确率却不尽人意(例如,可能只有 0.57 左右)。这典型的 过拟合 (Overfitting) 现象,即模型过度学习了训练数据的细节和噪声,导致其在未见过的新数据(测试集)上泛化能力差。
为了提升模型的性能,我们可以从以下几个方面进行优化:
优化后的网络模型
下面是一个优化后的网络结构,它增加了卷积核数量、全连接层维度,并加入了 Dropout 正则化。
class ImageClassification(nn.Module):
def __init__(self):
super(ImageClassification, self).__init__()
self.conv1 = nn.Conv2d(3, 32, stride=1, kernel_size=3)
self.pool1 = nn.MaxPool2d(kernel_size=2, stride=2)
self.conv2 = nn.Conv2d(32, 128, stride=1, kernel_size=3)
self.pool2 = nn.MaxPool2d(kernel_size=2, stride=2)
self.linear1 = nn.Linear(128 * 6 * 6, 2048)
self.linear2 = nn.Linear(2048, 2048)
self.out = nn.Linear(2048, 10)
# Dropout层,p表示神经元被丢弃的概率
self.dropout = nn.Dropout(p=0.5)
def forward(self, x):
x = torch.relu(self.conv1(x))
x = self.pool1(x)
x = torch.relu(self.conv2(x))
x = self.pool2(x)
# 由于最后一个批次可能不够 32,所以需要根据批次数量来 flatten
x = x.reshape(x.size(0), –1)
x = torch.relu(self.linear1(x))
# dropout正则化
# 训练集准确率远远高于测试准确率,模型产生了过拟合
x = self.dropout(x)
x = torch.relu(self.linear2(x))
x = self.dropout(x)
return self.out(x)
六、 总结
通过一系列优化,模型的性能得到了显著提升。在我们的实验中,测试集准确率从最初的 0.57 提升到了 0.93 甚至更高(具体数值取决于训练轮数和超参数微调)。
本文通过一个完整的 CIFAR-10 图像分类案例,展示了如何使用 PyTorch 构建、训练和评估一个卷积神经网络的完整思路。更重要的是,我们演示了如何通过分析模型表现(如过拟合)来针对性地进行优化,这是一个深度学习工程师必备的核心技能。希望这篇文章能帮助你更好地理解和应用CNN。
七、课程推荐与参考 (Reference)
再次强调,本文核心知识点均提炼自 B 站黑马程序员 的精品课程,老师讲得非常详细,大家一定要去支持!
课程名称: AI大模型《神经网络与深度学习》全套视频课程,涵盖Pytorch深度学习框架、BP神经网络、CNN图像分类算法及RNN文本生成算法